计算机视觉
计算机视觉是赋予机器图像、视频感知与分析能力的技术方向,可完成物体计数、数据标注、3D内容生成、视频内容扩展等任务,解决人工处理视觉内容效率低、精度不足的问题,面向行业从业者、内容创作者、算法研发人员等,选型可根据自身需求,关注任务适配性、处理效率与输出质量。

deepdataspace.com
CountAnything是基于计算机视觉技术打造的物体自动计数工具,核心定位是为多行业用户提供替代人工计数的数字化解决方案。其核心功能包括通用物体批量计数、自定义类别计数、计数结果结构化导出,支持识别密集堆叠、形态各异的各类物品。目标用户覆盖工业生产、畜牧养殖、建筑施工、医药流通、零售仓储等领域的从业人员,可用于产线零件清点、畜禽数量统计、建材物料核算、药品批次盘点、库存商品清点等场景,帮助用户降低人工计数的误差与时间成本。
labelyourdata.com
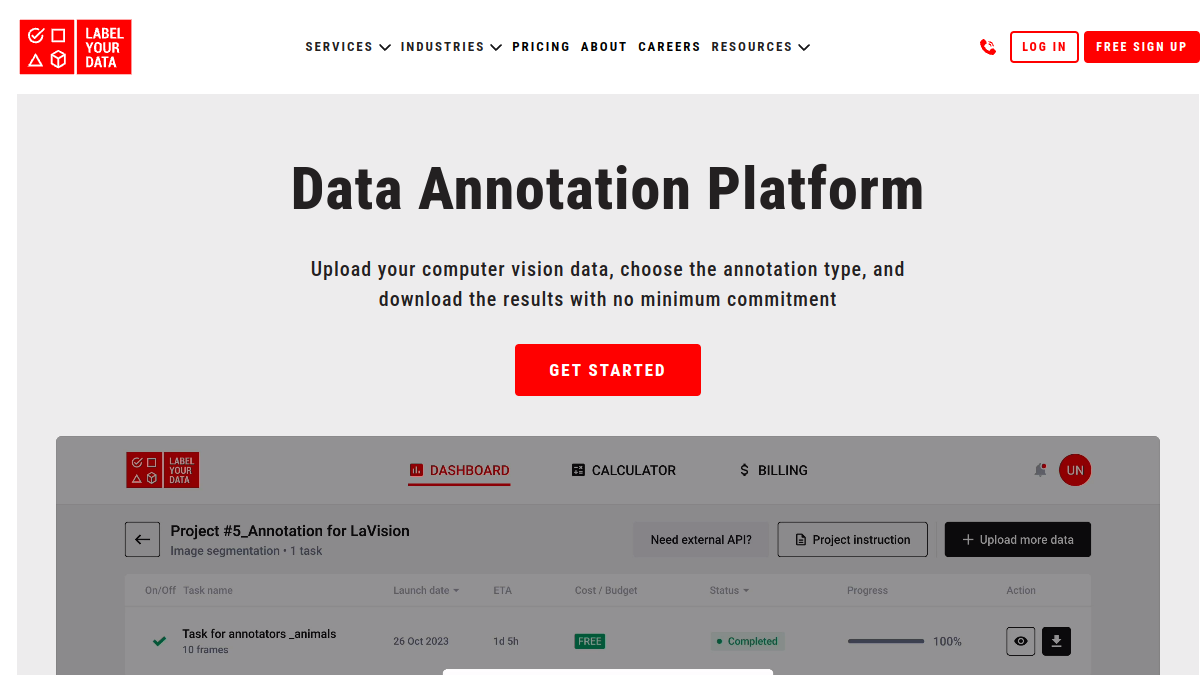
Data Annotation Platform是Label Your Data推出的端到端数据标注解决方案,核心定位是为AI研发相关团队提供标准化、可自定义的数据标注服务。平台支持计算机视觉多类型标注任务,内置成本计算器与标注指令生成工具,可实现标注流程全链路管理。服务对象覆盖AI项目经理、机器学习工程师、AI初创团队、高校科研人员、数据集运营人员、AI算法测试人员等群体,可应用于自动驾驶模型训练数据标注、安防监控图像标注、医疗影像识别数据集构建、零售商品识别数据预处理等多个场景,无需最低合作门槛即可按需使用。

huanngzh.github.io
MV-Adapter是面向多视图图像与3D生成场景的技术方案官网,核心为基于适配器架构的预训练文本到图像模型增强方案。核心功能包括参数高效的预训练模型适配能力,可在不修改原有T2I模型结构的前提下注入3D知识;统一条件编码器支持相机参数、几何信息的无缝整合;兼容Stable Diffusion XL等主流生成模型,可实现768分辨率的多视图内容生成。目标用户覆盖计算机视觉研究人员、AIGC技术开发者、3D内容制作从业者、数字内容创作团队等,可用于学术研究中的3D生成算法迭代、工业场景下的多视图素材批量生产、数字孪生项目的纹理映射制作等场景,无需重新训练完整大模型即可快速构建多视图生成能力。

be-your-outpainter.github.io
MOTIA是专注于视频外延画技术的在线工具平台,基于测试时适应的扩散方法开发,核心面向有视频内容扩展需求的创作者与技术研究人员。平台支持用户上传源视频后自动提取内容与运动特征,通过内在适应和外在渲染两个核心阶段完成视频外延画生成,同时提供参数调整、效果预览、多格式导出等配套功能。可应用于短视频二次创作、影视素材补全、动画内容扩展、学术研究效果验证等多个场景,帮助用户在不额外拍摄素材的前提下,扩展视频的画幅边界与内容长度。

landing.ai
Landing AI是一个面向工业场景的计算机视觉AI开发平台,帮助企业快速构建、部署和管理定制化计算机视觉模型,无需深厚的算法开发基础。平台核心功能包含数据标注工具、模型自动化训练、部署工具包、模型性能优化以及项目团队协作,主要服务于工业制造、质量检测、物流仓储等领域的企业团队,适用于生产环节缺陷检测、零部件分拣计数、仓储货物识别等多种业务场景,可降低AI项目落地的技术门槛,缩短项目开发周期。
visagetechnologies.com
Visage Technologies是一家专注于面部相关计算机视觉与定制化人工智能开发的AI解决方案提供商,面向企业客户提供面部识别、面部动作分析等方向的技术交付。核心功能包含面部关键点检测、面部动作捕捉、人脸识别验证、活体检测、头部姿态追踪等技术模块,支持多平台部署与定制化开发适配。目标用户覆盖互动娱乐开发企业、安防系统集成商、汽车人机交互方案商、零售数字化服务商、医疗康复研究机构等,可应用于游戏交互开发、智能门禁验证、车载驾驶员监测、虚拟试妆营销、面部运动康复评估等多种场景。
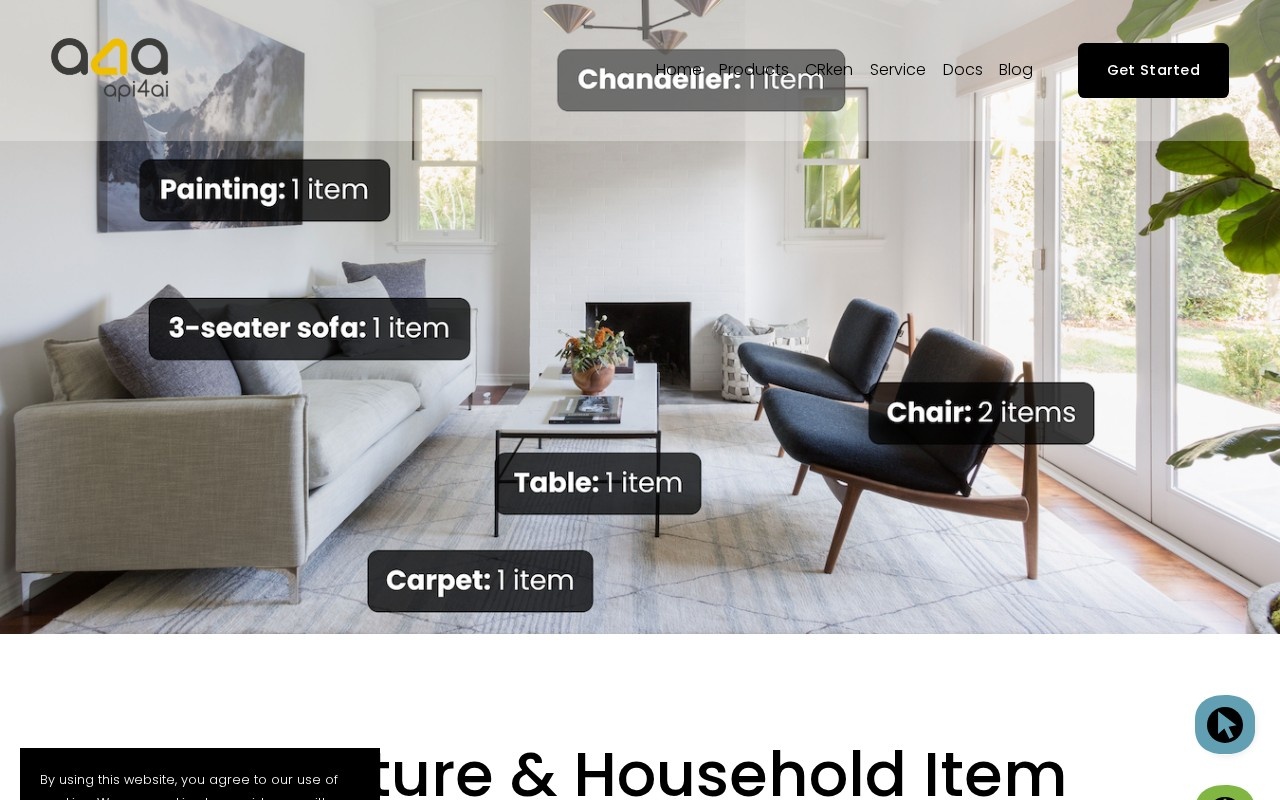
Furniture & Household Item Recognition API是一款基于计算机视觉AI技术的应用程序接口,核心定位为提供图像中家具和家居物品的识别、分类与计数服务。该API可以快速对输入图像中的各类家具和家居用品进行标注和数据统计,开发者可将其集成到自身应用、平台或服务中,也可供研究人员用于计算机视觉相关课题研究。常见使用场景包括家居电商平台商品图像自动标注、室内设计软件空间物品统计、智能家居场景图像识别等。

ai.meta.com
SceneScript是Meta Reality Labs研究团队推出的3D场景重建技术专题页面,核心定位是展示前沿AI驱动的3D场景理解与重建技术研究成果。页面核心功能包括技术原理解析、实验效果展示、研究论文资源下载、应用场景落地说明,面向计算机视觉研究人员、3D内容创作者、AR/VR领域开发者、元宇宙相关从业者,可用于学术研究参考、3D开发技术选型、AR/VR场景构建方案调研等多种场景,帮助相关从业者了解单张图像生成高精度3D模型的技术路径与落地可能性。
hehao13.github.io
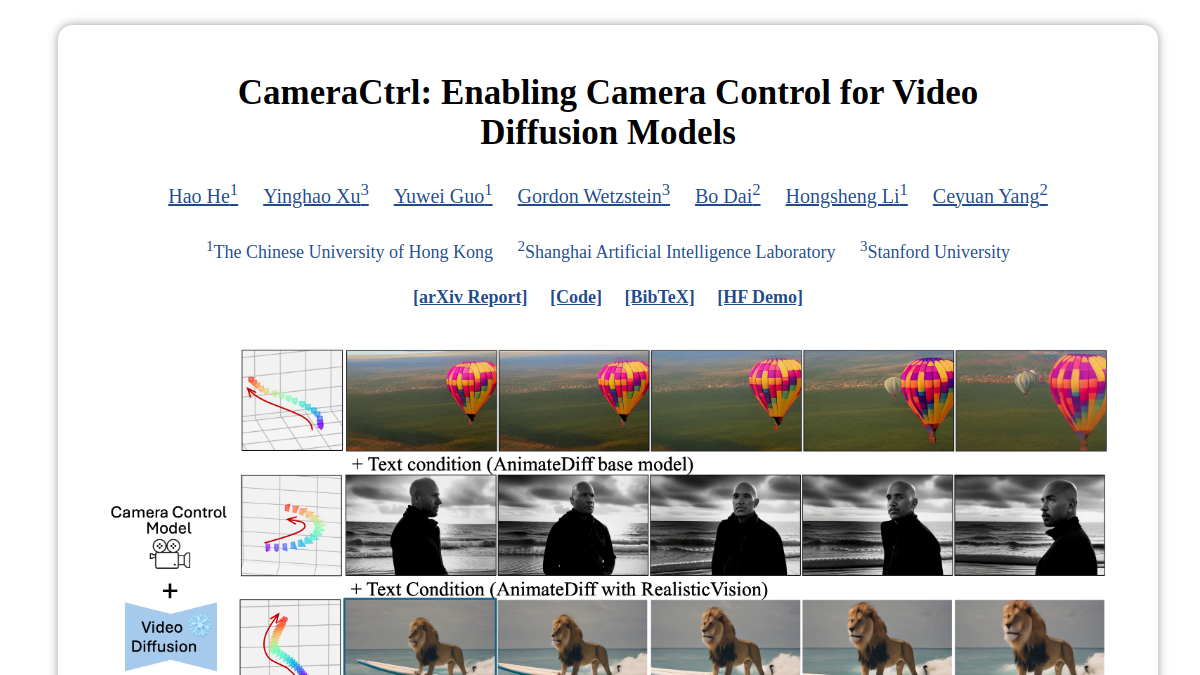
CameraCtrl是一款专注于文本生成视频领域的相机姿态控制技术工具,核心定位为为AI视频生成模型提供可控的相机运动参数支持。核心功能包括参数化相机轨迹生成、跨模型相机控制适配、多场景相机姿态数据集支持,目标用户覆盖AI视频生成研究者、短视频内容创作者、影视动画前期策划人员、计算机视觉相关专业学生等群体,可应用于AI生成故事视频的镜头设计、虚拟场景漫游视频生成、教学演示类视频的镜头调度规划等多个场景,帮助用户在无需手动调整视频后期镜头的前提下,实现符合创作需求的相机运动效果。
caizhongang.github.io
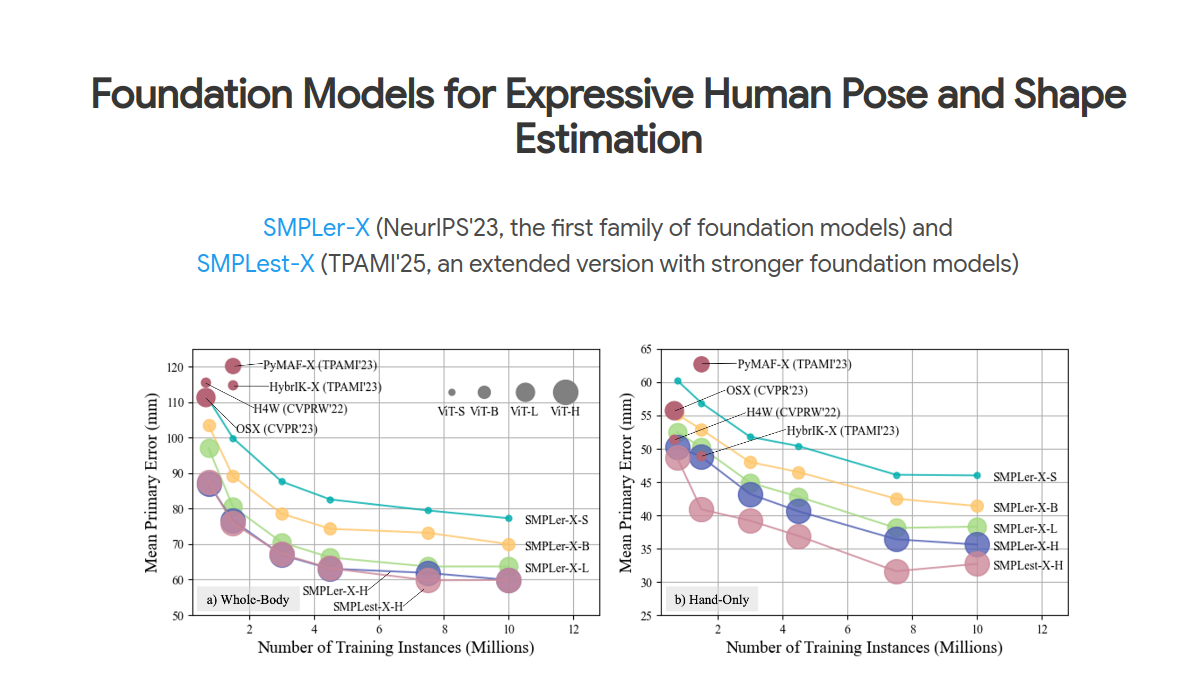
SMPLer-X是面向人体姿态与形状估计领域的开源学术项目站点,核心提供经过大规模数据训练的全身动作捕捉模型方案。站点内置多基准测试结果可视化功能,支持模型部署代码包下载,配套不同场景下的推理Demo运行指南。主要面向计算机视觉领域研究人员、动捕技术开发工程师、数字人内容创作者,可用于学术研究性能对比、动捕工具开发迭代、数字人驱动素材生成等场景,帮助相关从业者降低全身动作捕捉模型的研发与应用门槛。

gen-omnimatte.github.io
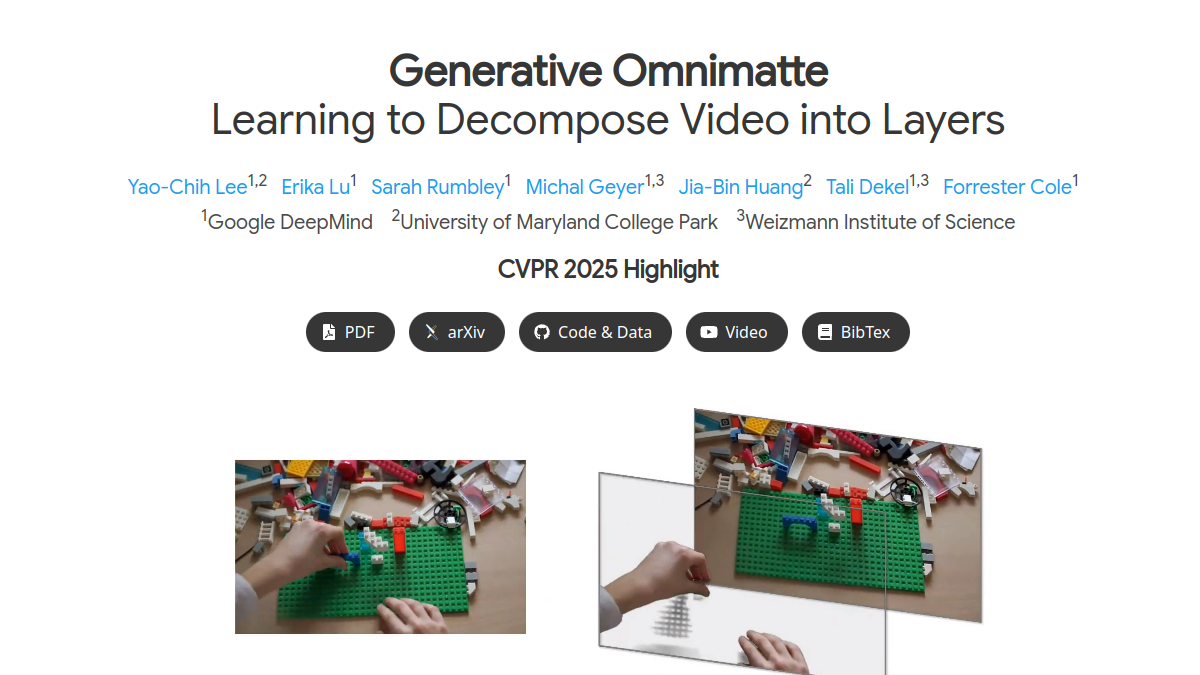
Generative Omnimatte是专注于视频分层处理的学术技术展示站点,核心定位为向公众展示基于生成式AI的视频RGBA分层技术成果。核心功能包括视频对象与关联效果分层提取、分层结果可视化预览、分层素材导出支持,同时提供技术论文与实现原理说明。目标用户覆盖视频创作者、影视后期从业者、计算机视觉研究者、高校相关专业学生。适用场景包括影视特效制作中独立调整对象效果、老视频修复中分层优化特定元素、学术研究中验证视频分层技术效果、短视频二次创作中快速提取素材等。

emu-edit.metademolab.com
Emu Edit是Meta推出的多任务图像编辑模型工具,核心定位为通过自然语言指令完成高精度图像编辑的AI应用。核心功能包括基于文本指令的多类型图像编辑、少样本新任务快速适配、公开基准评测数据集支持。目标用户覆盖图像设计从业者、AI技术研发人员、内容创作者、计算机视觉相关专业学生等。使用场景包括日常内容创作中的图像调整、商业设计中的元素修改、学术研究中的图像编辑模型效果验证、小样本标注下的特定编辑需求落地等。
jerryxu.net
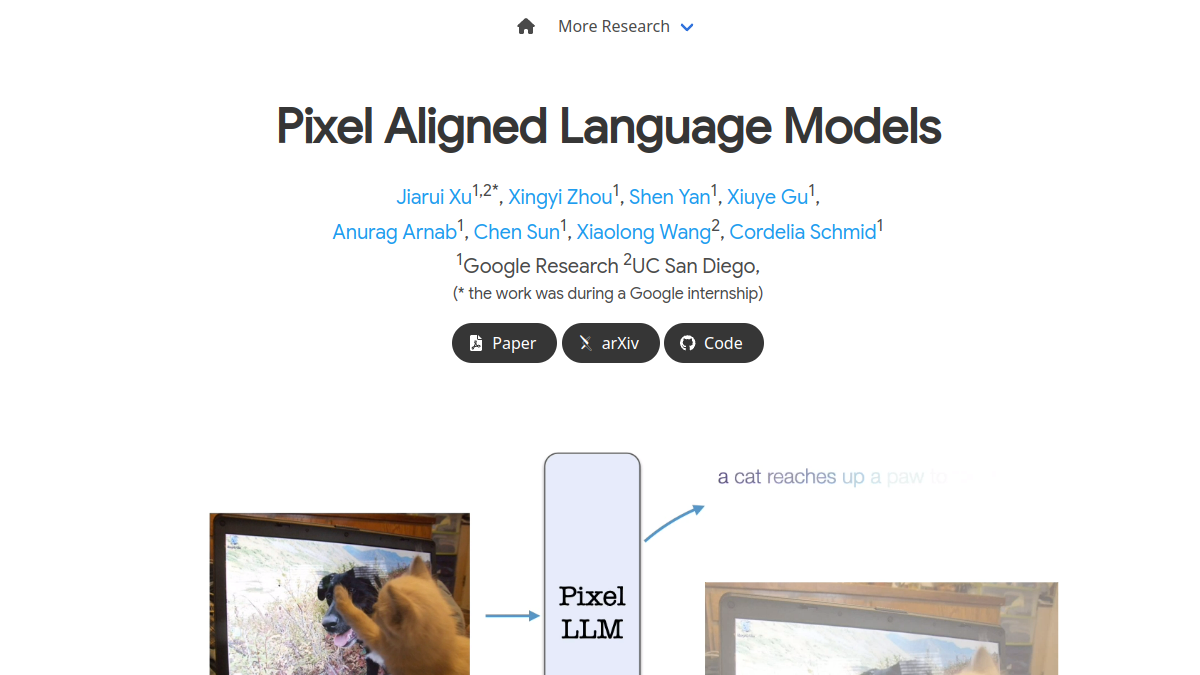
PixelLLM是一个专注于图像定位任务的视觉-语言模型展示站点,核心功能涵盖位置引导的图像描述生成、文本引导的像素坐标定位、多数据集性能结果查询。该站点面向计算机视觉研究者、AI算法开发人员、多模态学习领域学生,可用于学术研究参考、模型效果验证、相关任务技术选型等场景,帮助用户直观了解视觉与像素对齐技术的落地表现。

glee-vision.github.io
GLEE是一个面向图像与视频处理场景的通用对象基础模型服务平台,核心定位是为各类对象感知任务提供统一的技术支持。平台可实现多模态输入的对象定位与识别功能,支持零样本迁移适配不同任务场景,还具备多数据源联合训练的通用对象表示能力。目标用户覆盖计算机视觉领域的科研人员、AI应用开发工程师、内容生产行业的视频处理从业者、安防领域的智能分析从业者等,可应用于视频内容结构化标注、图像对象检测、多场景智能识别、零样本任务迁移等多种场景。

unitlab.ai
Unitlab AI是AI驱动的数据标注服务平台,核心定位是为机器学习项目提供全流程数据标注解决方案。平台支持原始数据自动采集、AI预标注与人工标注协同校验、标注质量多维度核验三大核心功能,面向AI算法开发团队、机器学习科研人员、自动驾驶领域从业者等用户,可应用于计算机视觉模型训练、自然语言处理数据集构建、自动驾驶感知数据标注等多个场景,帮助用户在数据准备环节降低人力投入,提升标注结果的一致性与准确性。
yihua7.github.io
SC-GS是专注于动态3D场景重建与渲染的技术展示与工具网站,核心基于稀疏控制点结合高斯溅射的新型表示方案,可实现动态场景外观与运动的分离建模。核心功能包括动态3D场景的联合重建、可控的3D运动编辑、实时新视图合成渲染,面向计算机视觉研究人员、3D内容开发者、元宇宙场景构建人员、游戏场景设计师、影视特效制作人员、三维重建算法工程师等群体,可用于动态场景数字化存档、3D交互内容制作、算法效果验证、影视虚拟场景渲染、学术研究对比实验等多种场景。

co-tracker.github.io
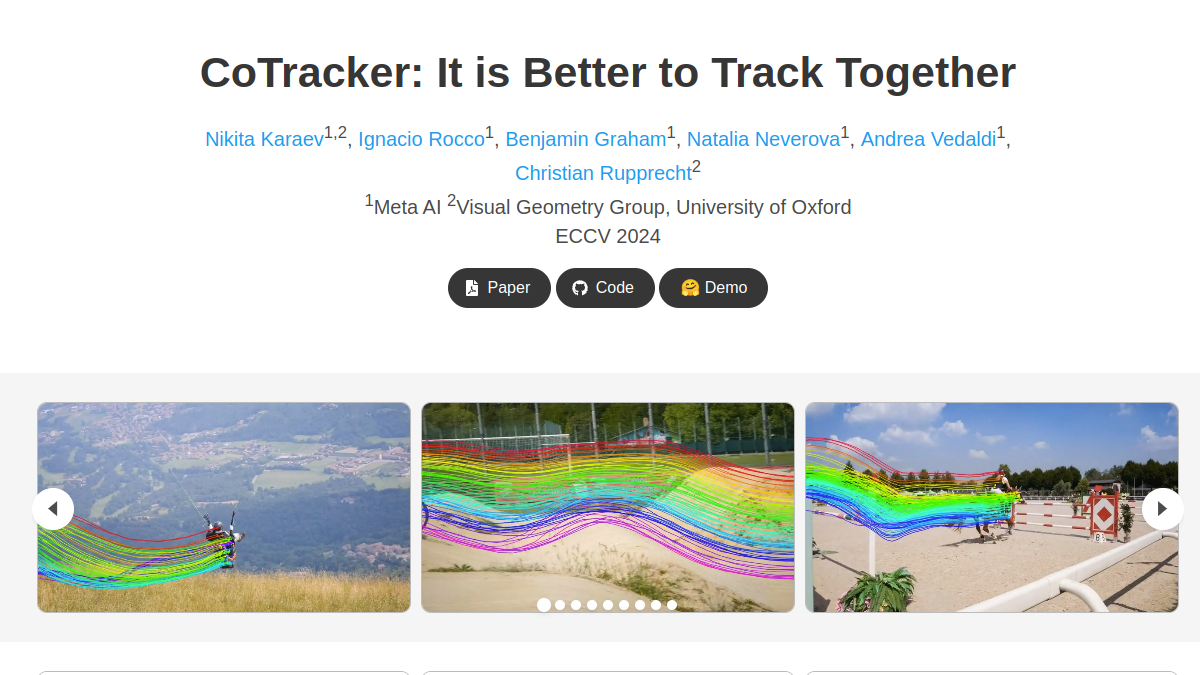
CoTracker是面向视频点跟踪任务的开源Transformer模型官方站点,核心功能为支持视频序列的稠密点联合跟踪、长时遮挡场景下的轨迹预测、可扩展的大规模点跟踪部署,目标用户覆盖计算机视觉研究人员、视频内容开发从业者、机器人导航算法工程师等群体,可应用于视频动作捕捉、三维重建、运动分析、自动驾驶场景感知、视频特效制作等多个领域,区别于传统独立点跟踪方法,该模型通过建模点与点之间的空间关联,提升跟踪的精度与鲁棒性,适配长视频、遮挡场景下的跟踪需求。
uni-fl.github.io
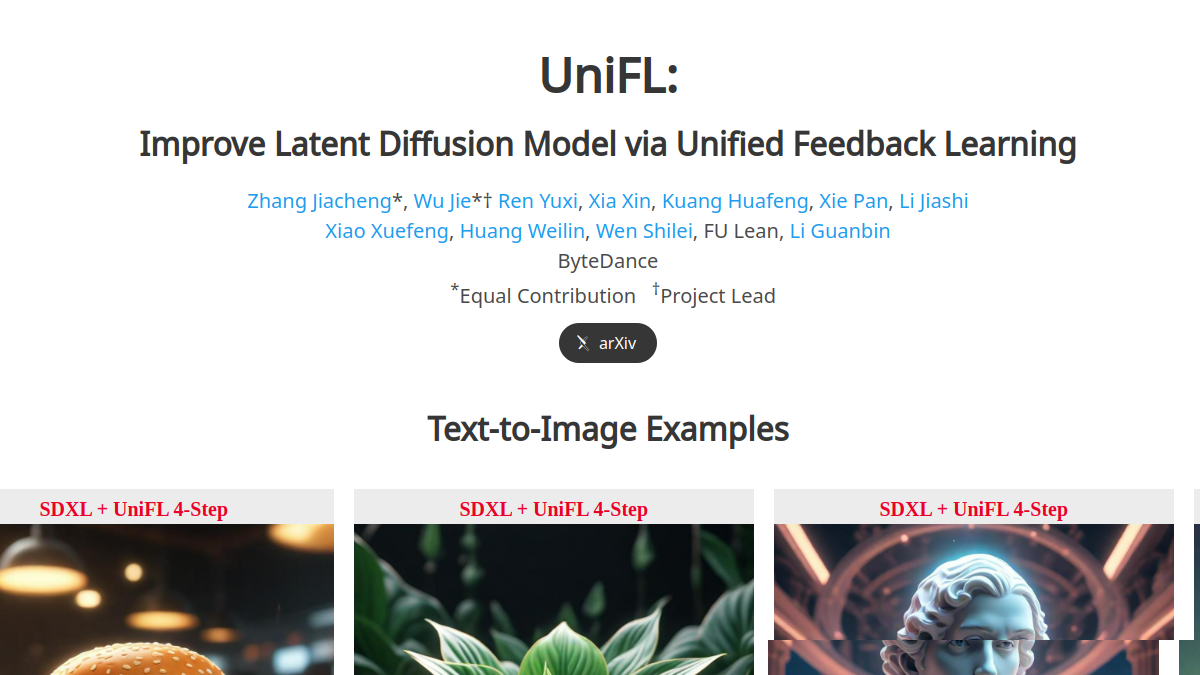
UniFL是一个面向扩散模型优化的技术研究项目,核心定位为通过系统化的反馈学习机制提升生成模型的输出质量与运行效率。项目核心功能包含感知反馈学习模块、解耦反馈学习模块、对抗性反馈学习模块三类,可针对现有扩散模型存在的图像生成精度不足、美学效果不达预期、推理耗时过长等问题进行定向优化。目标用户覆盖AI生成模型研究者、AIGC应用开发人员、计算机视觉方向高校师生等群体,可用于扩散模型性能迭代、文生图应用效果优化、生成模型学术研究实验等多个场景。

langsplat.github.io
LangSplat是面向3D场景语言查询的学术开源项目,核心定位是构建高效的3D语言场,支持开放词汇的3D场景语义检索。其核心功能包括将CLIP语言嵌入映射到3D高斯分布实现语义建模、规避NeRF类方法的高成本渲染流程提升运算效率、生成无需后处理的高精度对象边界语义特征。目标用户覆盖计算机视觉研究者、3D内容开发人员、机器人导航算法工程师等群体,可应用于3D场景语义标注、机器人环境理解、AR内容语义交互、三维重建后语义分析等场景,为3D场景的语言交互需求提供高效的技术实现方案。
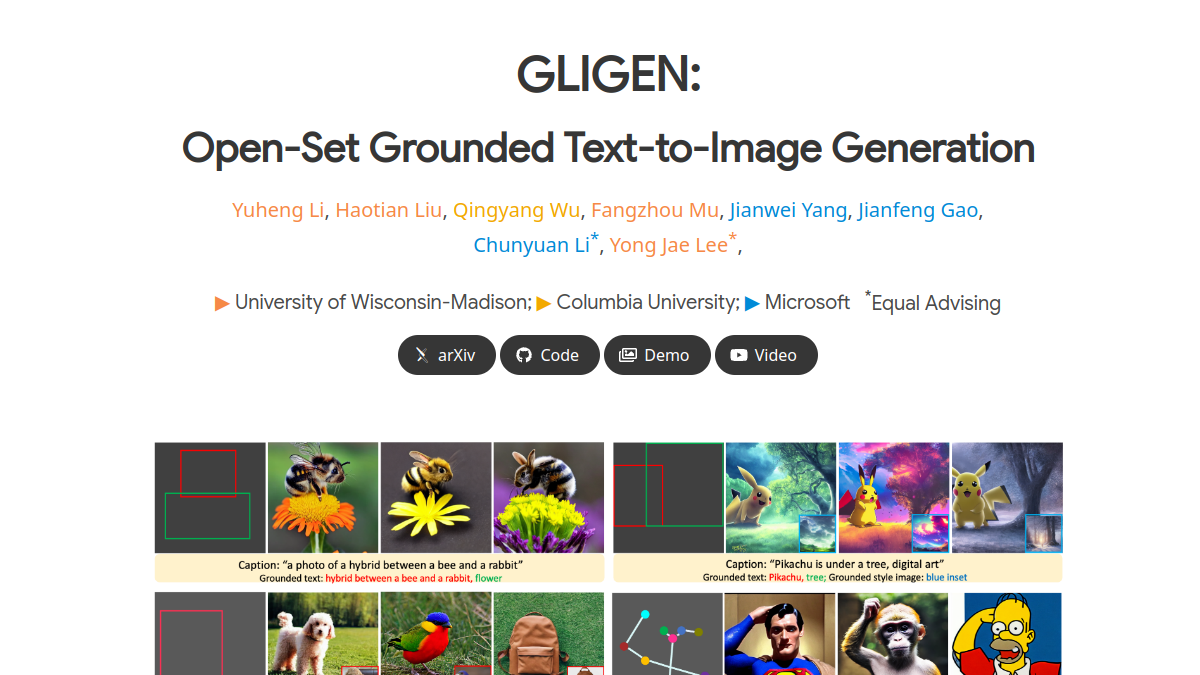

gligen.github.io
GLIGEN是一款开放式的条件式图像生成学术项目站点,核心为基于扩散模型的可控图像生成技术。用户可结合文本描述与空间边界框、参考图像等条件,生成符合指定布局与内容要求的图像;模型采用模块化训练设计,保留预训练扩散模型的基础生成能力的同时,扩展了空间控制属性。该站点面向AI图像生成研究者、计算机视觉从业者、内容创作人员、设计人员等群体,可用于学术研究验证、可控图像内容创作、多模态模型效果测试、概念设计初稿生成等场景,帮助用户在图像生成过程中实现更精准的内容与布局控制。

token-verse.github.io
TokenVerse是面向个性化图像生成领域的技术展示与方案介绍站点,核心围绕基于文本到图像扩散模型的多概念解耦与组合生成技术展开。站点核心功能包括技术原理解析、生成效果案例展示、应用场景说明,以及相关研究成果的公开分享。目标用户覆盖AI图像生成领域的研究人员、创意设计从业者、AI工具开发者,以及对个性化图像生成有需求的内容创作者。用户可通过站点了解该技术从单张图像中解耦物体、配饰、材质、姿势、光照等多类视觉元素的实现逻辑,查看不同概念组合生成的效果案例,参考该技术在创意设计、内容生产等场景的落地路径。
virtualhumans.mpi-inf.mpg.de
InterTrack是马克斯·普朗克信息学研究所发布的人体与物体交互4D跟踪技术项目站点,核心面向计算机视觉、三维重建领域的研究人员与开发者,提供单目RGB视频下的人体、物体联合跟踪解决方案。核心功能包括无需实体对象模板的泛化跟踪,支持遮挡场景下的交互行为连续捕获,以及4D姿态与形状的分步优化输出。站点可满足学术研究验证、交互行为分析、动效制作素材采集等场景的使用需求,帮助用户降低多视角采集、预扫描对象模板的硬件与流程成本。
finetunefast.com
FinetuneFast是面向机器学习开发人员与AI研究人员的AI模型快速微调和部署服务平台,提供标准化的机器学习项目模板,帮助用户缩短模型微调与上线的开发周期。核心功能包含预置主流模型模板、一键云端训练、自动化部署配置、训练过程监控、自定义参数调整等服务,支持自然语言处理、计算机视觉等多个领域的模型开发需求,适合需要快速迭代AI模型原型、完成项目开发验证的场景使用。
eyegestures.com
EyeGestures是一款基于网络摄像头实现开源凝视追踪的技术平台,面向无障碍辅助开发、眼动追踪学术研究等方向提供技术支持。平台核心功能包含浏览器端实时眼动追踪、开源代码获取、自定义交互界面开发、眼动数据导出,支持非接触式的视线交互开发与研究。该平台可帮助开发者搭建无障碍交互系统,也可支持科研人员开展眼动相关实验研究,适用于无障碍产品开发实验室、高校认知科学研究课题组、交互设计工作室等不同场景。
notebook-digitizer.com
Notebook Digitizer是一款依托人工智能与计算机视觉技术,连接纸质手写笔记与数字文档的在线工具,核心功能包含单页笔记提取、整册笔记本扫描整理、手写文字识别转码、笔迹增强优化、多格式导出存储,能够帮助用户将手写记录转化为可编辑、可检索的数字内容,目标用户覆盖学生、职场办公人员、手绘创作者、学术研究者等需要整理纸质笔记的群体,适用于课堂笔记数字化归档、会议手写记录整理、手绘草图数字化存储、备考笔记检索整理等多种使用场景。
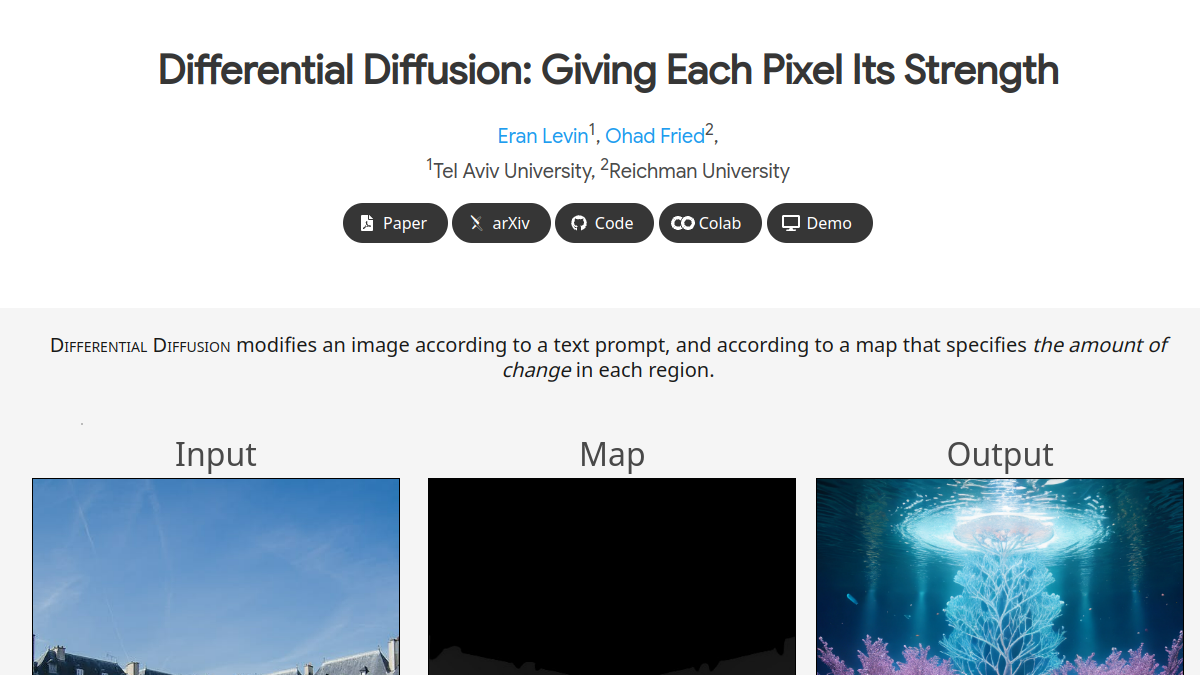

differential-diffusion.github.io
Differential Diffusion是专注于细粒度可控图像生成与编辑的学术展示平台,核心基于差分扩散技术框架,支持区域自定义修改强度控制、渐变空间变化编辑、图像补全无缝融合三类核心功能,主要面向AI图像研究人员、数字内容创作者、交互设计开发者、计算机视觉专业学生等群体,可用于学术研究效果验证、创意图像处理、特定区域精细修图、图像补全实验等多种场景,平台无需用户额外训练模型,仅通过推理阶段即可完成所有编辑操作,支持与主流开源扩散模型集成使用。

supergradients.com
YOLO-NAS Pose 是依托 SuperGradients 平台推出的开源 PyTorch 计算机视觉模型训练库,核心定位为降低计算机视觉模型开发与落地的技术门槛。平台内置经过验证的预训练模型、标准化训练脚本与开箱即用的任务示例,支持人体关键点检测、图像分类、目标检测、语义分割等多类视觉任务开发,用户可便捷加载预训练权重并结合自有数据集完成微调,无需从零搭建训练框架。该工具面向计算机视觉算法工程师、AI 应用开发者、高校科研人员、深度学习学习者等群体,适用于工业级视觉应用落地、学术研究模型复现、课程实训项目开发、小样本模型快速迭代等场景,可帮助用户减少训练框架搭建工作量,降低模型调参的不确定性。
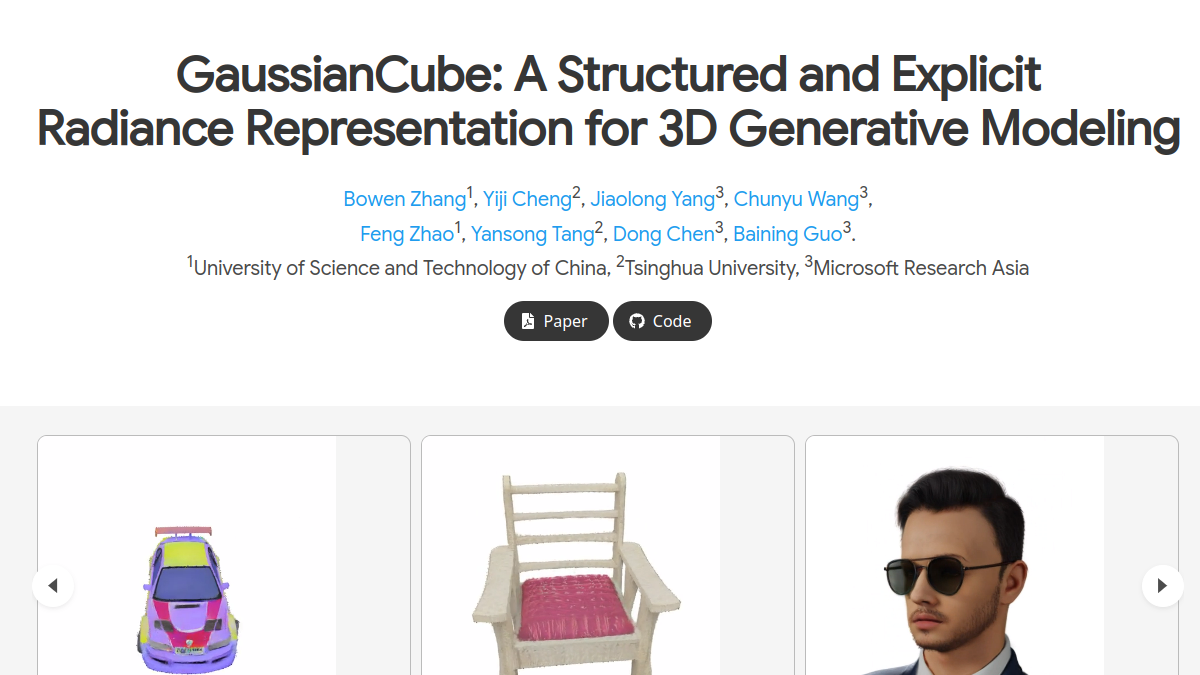

gaussiancube.github.io
GaussianCube是一个专注于3D辐射表示技术的学术项目网站,核心定位是展示结构化显式3D辐射表示的相关研究成果与应用资源。核心功能包括提供结构化高斯表示技术的完整技术文档、开源算法代码包下载、3D重建与生成效果演示案例、相关研究论文与实验数据下载、开发者使用教程与常见问题解答。目标用户覆盖计算机视觉领域研究人员、3D内容开发工程师、图形学方向高校师生、元宇宙内容创作者、3D建模从业者。适用场景包括3D内容生成模型研发、高精度3D场景重建、游戏与影视3D资产制作、AR/VR场景内容构建、3D测量与数字孪生建模等多个领域,帮助相关从业者降低3D生成建模的开发门槛,提升3D内容的制作效率与呈现质量。

egolife-ai.github.io
EgoLife是聚焦长期多模态日常生活场景的AI研究项目平台,核心定位是为长期上下文理解、多视角行为分析等AI方向的研究提供真实数据集与技术框架支撑。平台收录六名志愿者一周共享生活的50小时标注数据,涵盖日常起居、协作办公、休闲社交等多类真实场景,内置EgoRAG检索增强生成框架,支持多模态数据的长期关联查询与上下文推理。目标用户包括AI领域研究人员、计算机视觉方向开发者、人机交互研究学者,可用于日常行为预测模型训练、具身智能系统开发、多模态大模型性能测试等多种研究场景。
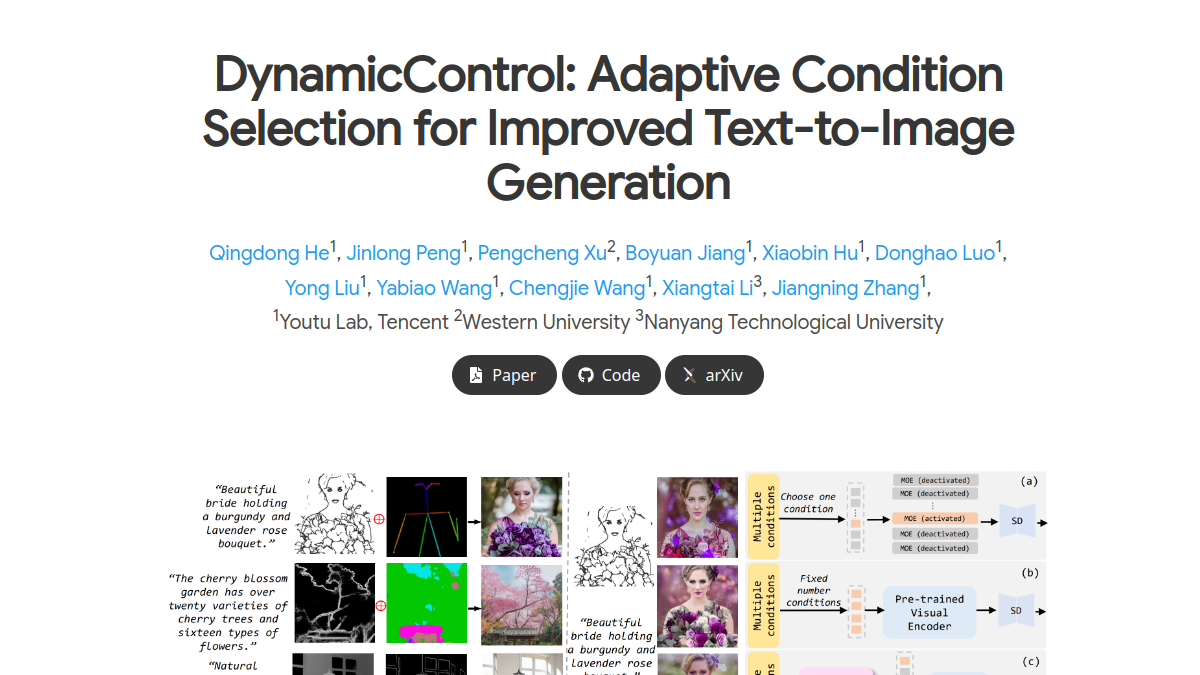

hithqd.github.io
DynamicControl是专注于提升文本到图像扩散模型生成控制力的开源技术框架,核心定位是解决多控制信号组合下图像生成一致性不足的问题。其核心功能包括双循环控制器初始条件排序、多模态大语言模型条件评估优化、并行多控制适配器特征整合三大模块,支持用户灵活组合不同类型、数量的控制条件,实现更符合预期的图像生成效果。该框架面向AI图像生成领域的研究人员、算法工程师、AIGC应用开发者,可应用于可控图像生成算法研究、专业AI绘图工具开发、定制化图像生成系统搭建等场景,帮助使用者降低多条件控制下的图像生成偏差,提升生成结果与输入需求的匹配度。

illuminerf.github.io
IllumiNeRF是专注于3D重光照与新视角渲染的技术服务站点,核心基于神经辐射场(NeRF)与图像扩散模型的组合方案,解决传统逆向渲染方法计算成本高、优化过程不稳定的问题。核心功能包括未知光照下的3D场景重建、指定目标光照的新视角渲染、多视角输入图像的自动重光照预处理、重光照效果基准测试对比等。服务于计算机视觉研究人员、3D内容创作者、影视动画制作人员、AR/VR开发人员等群体,可用于3D资产制作、虚拟场景光照调整、数字孪生场景还原、影视道具渲染等多种场景,无需提前获取拍摄环境的光照参数,仅通过普通拍摄的多视角图像即可完成3D内容的光照可控渲染。

ggg0919.github.io
Cantor是面向多模态链式思维推理研究的开源技术框架,核心定位是结合视觉感知与大语言模型逻辑推理能力,解决复杂视觉推理任务。核心功能包括视觉上下文感知对齐、多模态链式思维生成、推理性能自动评估、零样本推理适配、实验结果可视化。目标用户覆盖人工智能研究者、计算机视觉方向学生、多模态大模型开发人员、AI应用落地工程师、算法竞赛参与者。使用场景包括多模态推理算法性能测试、学术研究中基线模型对比、零样本视觉推理任务开发、大语言模型多模态能力验证、相关教学课程实验演示。
mini-gemini.github.io
MiniGemini是开源多模态视觉语言模型项目站点,核心提供不同参数规模的视觉语言模型资源与相关技术文档。站点支持多版本模型下载、技术框架说明、基准测试结果展示三大核心功能,面向AI科研人员、多模态应用开发者、计算机专业学生、算法工程师等群体,可应用于多模态模型性能验证、视觉理解应用开发、学术研究对比、模型技术学习等多种场景,帮助用户快速获取MiniGemini模型相关技术细节与使用资源。
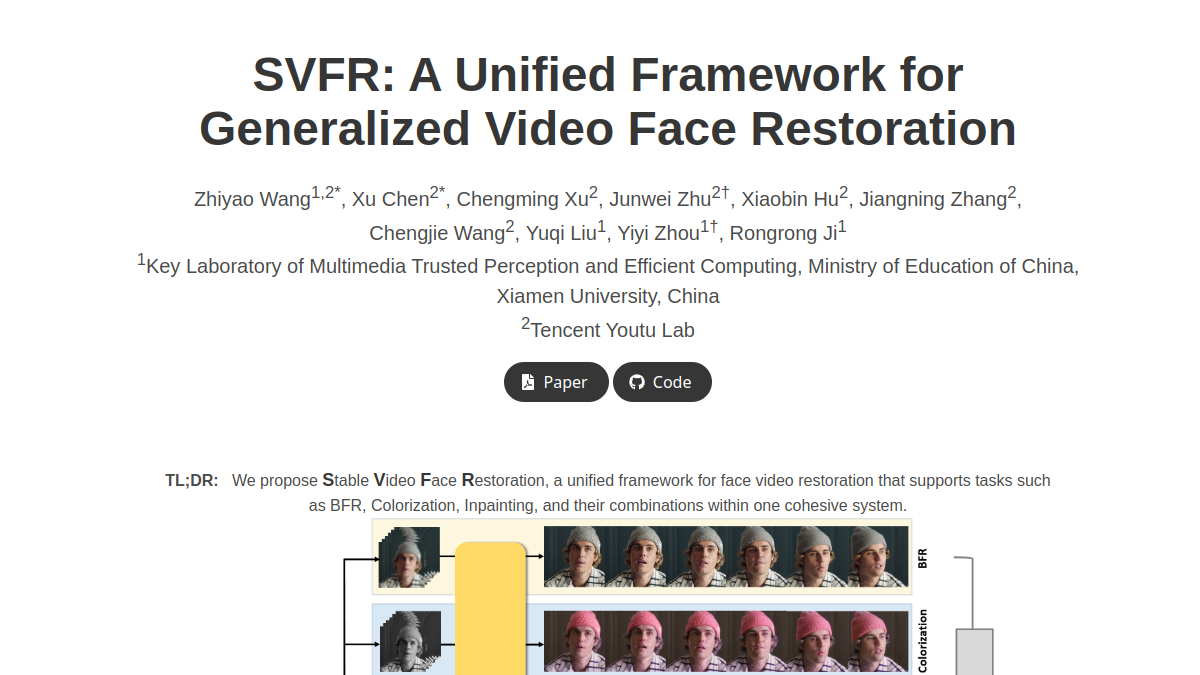

wangzhiyaoo.github.io
SVFR是基于Stable Video Diffusion技术搭建的视频人脸修复在线工具,核心定位为广义视频人脸修复统一处理平台,可同时支持人脸修复、着色、修复三类视频人脸处理任务。平台引入可学习任务嵌入模块与统一潜在正则化技术,能兼顾处理质量与时间连贯性,面向计算机视觉研究人员、视频内容创作者、影像修复从业者等群体,可应用于老旧影像人脸修复、低质视频人脸画质增强、受损视频人脸补全等多种场景,帮助用户在无需本地部署复杂模型的前提下完成专业级视频人脸修复处理。

snap-research.github.io
Snap Video是由Snap Research团队推出的视频生成研究项目网站,核心定位为展示前沿的视频优先生成模型技术成果。网站提供该模型的核心论文解读、生成效果演示Demo、训练技术框架说明三大核心功能,主要面向AI生成技术研究人员、视频内容创作者、高校计算机专业学生、AI产品开发从业者,可用于学术研究参考、视频创作效率提升、相关技术学习、产品技术选型等场景。
instructvideo.github.io
InstructVideo是基于人类反馈奖励微调机制的文本生成视频技术研究展示平台,核心定位为公开文本到视频扩散模型的优化方案及相关技术成果。平台提供技术论文原文查阅、核心算法原理演示、生成效果对比样例查看三大核心功能,面向AI视频生成领域的研究人员、算法开发工程师、相关专业高校学生,以及AI内容创作从业者,支持技术学习、算法参考、效果验证、研究选题参考等多种场景使用。
关于 计算机视觉 的常见问题
适合做工业零件计数的计算机视觉工具有哪些?
你可以尝试CountAnything,它是基于计算机视觉技术打造的物体自动计数工具,核心定位是为多行业用户提供替代人工计数的数字化解决方案,无需复杂部署,就能快速完成批量物体的自动计数,可替代人工统计,降低人工计数的误差与工作量,适配工业计数这类场景需求。
做3D内容生成相关的计算机视觉开发有可用工具吗?
目前有不少适配不同场景的相关工具。如果你做多视图图像到3D内容的生成,可以试试LucidFusion,它是专注于3D高斯生成的端到端前馈框架,能帮助用户基于多视图图像快速完成3D内容产出;如果你需要增强文本到3D生成的效果,也可以参考MV-Adapter的技术方案。
做计算机视觉算法训练,在哪里找数据标注工具?
你可以了解Label Your Data推出的Data Annotation Platform,它是面向计算机视觉训练的端到端数据标注解决方案,可以覆盖图像、视频等多类视觉数据的标注需求,支持不同项目规模的标注流程管理,能帮算法研发团队统一管理标注任务,提升标注数据的产出效率与质量,适配算法训练的数据准备需求。