开源技术
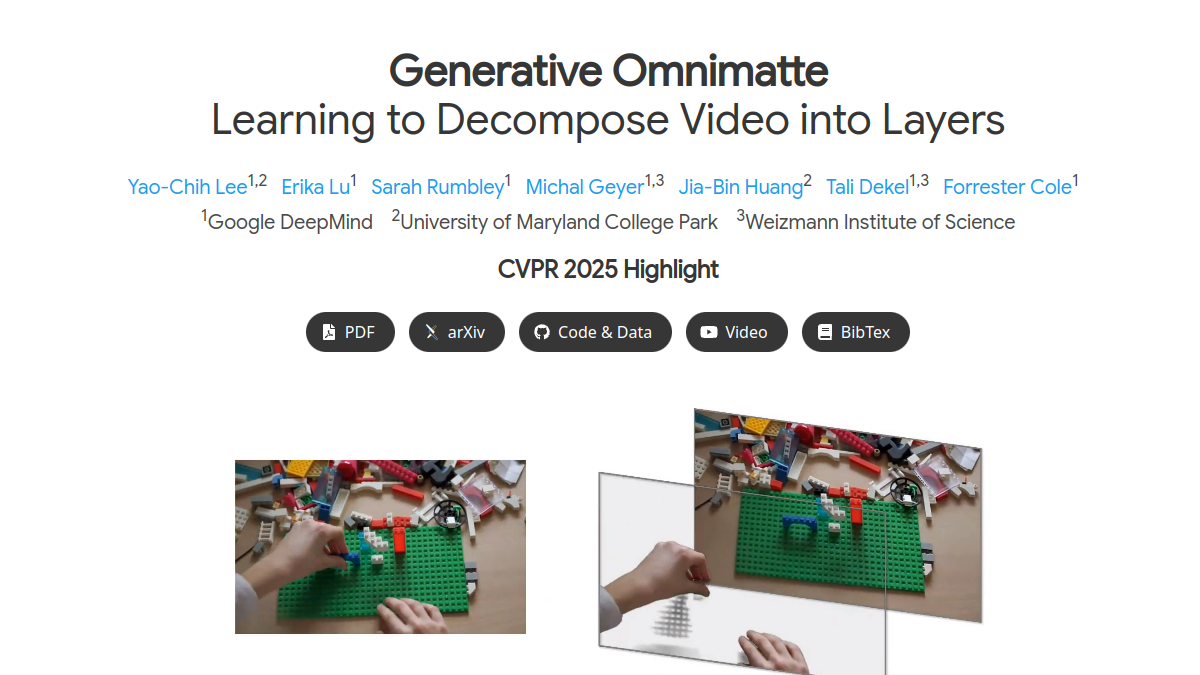

gen-omnimatte.github.io
Generative Omnimatte是专注于视频分层处理的学术技术展示站点,核心定位为向公众展示基于生成式AI的视频RGBA分层技术成果。核心功能包括视频对象与关联效果分层提取、分层结果可视化预览、分层素材导出支持,同时提供技术论文与实现原理说明。目标用户覆盖视频创作者、影视后期从业者、计算机视觉研究者、高校相关专业学生。适用场景包括影视特效制作中独立调整对象效果、老视频修复中分层优化特定元素、学术研究中验证视频分层技术效果、短视频二次创作中快速提取素材等。
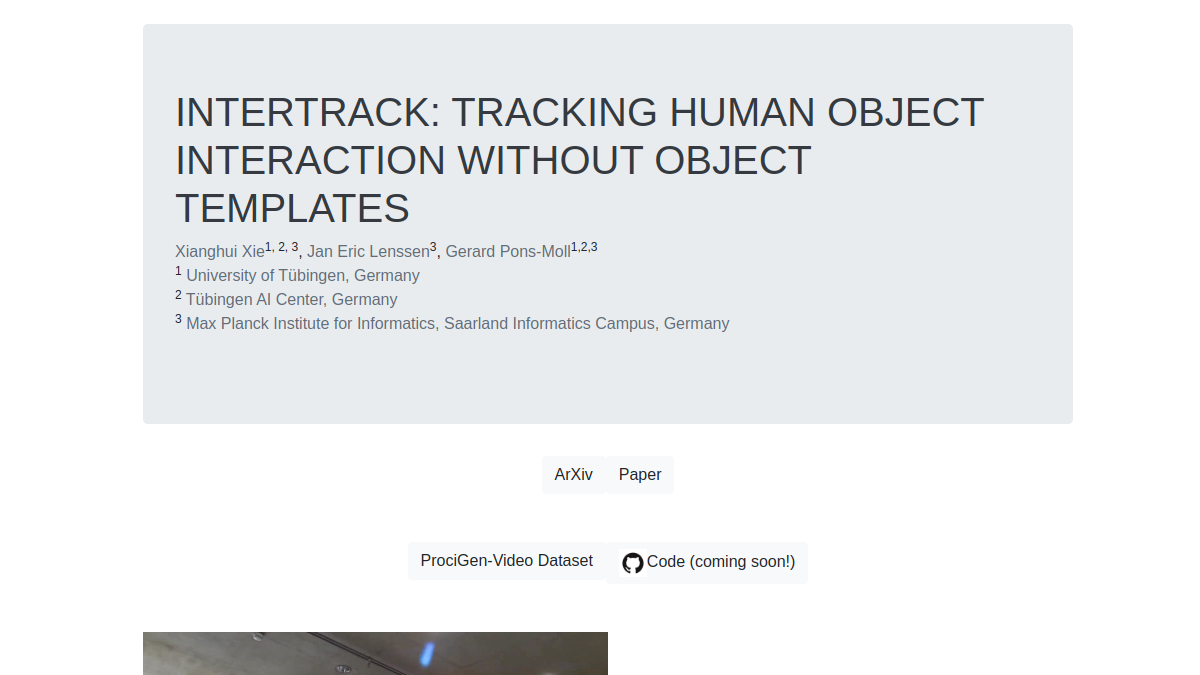
virtualhumans.mpi-inf.mpg.de
InterTrack是马克斯·普朗克信息学研究所发布的人体与物体交互4D跟踪技术项目站点,核心面向计算机视觉、三维重建领域的研究人员与开发者,提供单目RGB视频下的人体、物体联合跟踪解决方案。核心功能包括无需实体对象模板的泛化跟踪,支持遮挡场景下的交互行为连续捕获,以及4D姿态与形状的分步优化输出。站点可满足学术研究验证、交互行为分析、动效制作素材采集等场景的使用需求,帮助用户降低多视角采集、预扫描对象模板的硬件与流程成本。
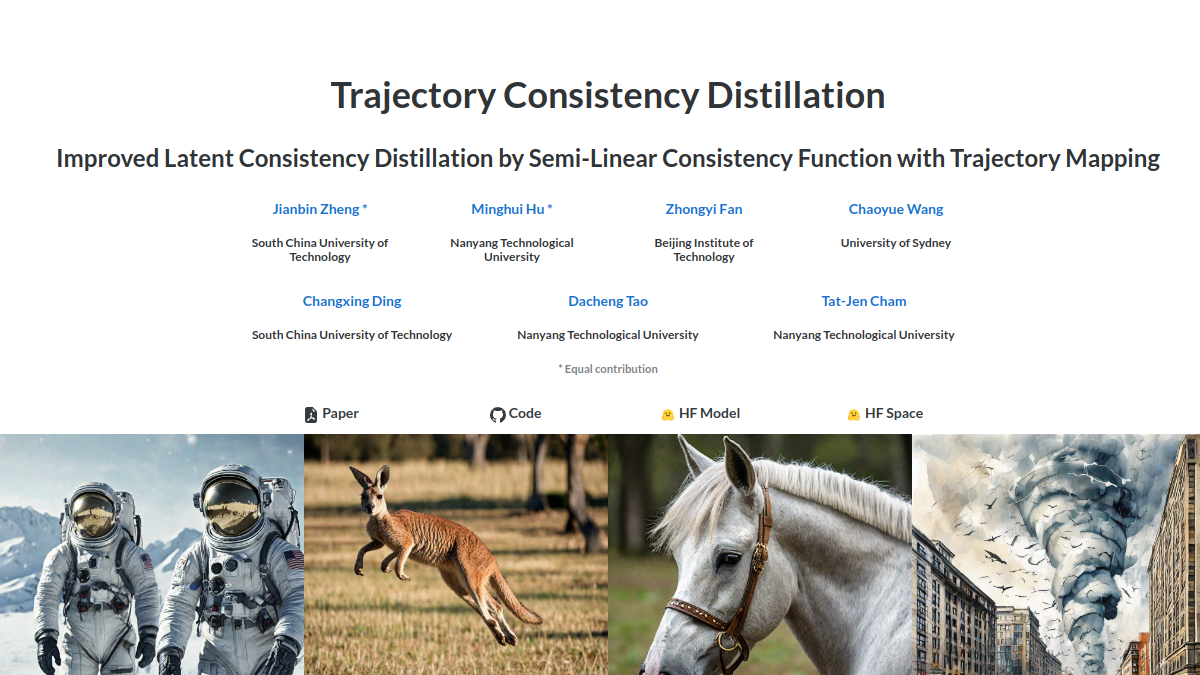
mhh0318.github.io
Trajectory Consistency Distillation(简称TCD)是专注于文本到图像合成领域的一致性蒸馏技术展示站点,核心定位是为AI图像生成领域的研究者、开发者提供新型蒸馏技术的原理说明、效果演示与相关资源下载服务。站点核心功能包括TCD技术原理的系统拆解、不同参数下的生成效果对比展示、相关论文与开源代码的获取渠道汇总,以及不同基准模型的消融实验数据呈现。目标用户覆盖AI生成模型研发人员、高校计算机视觉方向师生、AIGC应用开发从业者,可用于学术研究参考、模型性能优化、技术选型评估等多个场景,帮助相关人员快速了解该蒸馏技术在减少图像合成错误、提升低推理步数下生成质量方面的实际表现。
penghtyx.github.io
PSHuman是专注于单张图像3D人体重建的技术框架展示站点,核心基于多视图扩散模型与显式重构技术,可从普通单张人像照片生成高还原度的3D人体模型。站点核心功能包含单图3D人体重建演示、重建效果可视化对比、技术论文与开源代码资源下载,主要面向计算机视觉领域研究者、3D内容创作者、游戏动画开发人员等群体,可应用于数字人制作、影视角色建模、人体姿态分析等多个场景,无需多视角拍摄设备即可完成人体3D数据的快速生成,降低3D人体资源制作的前期采集成本。
latent-consistency-models.github.io
Latent Consistency Models(简称LCMs)是面向AI图像生成领域的开源技术项目网站,核心定位是提供低推理成本的高分辨率图像生成技术方案。其核心功能包括预训练稳定扩散模型适配能力,可从现有成熟的稳定扩散模型中快速衍生出LCMs版本;支持少步推理生成高保真图像,无需多轮迭代即可输出清晰画面;提供Latent Consistency Fine-tuning(LCF)自定义微调方法,适配个性化图像生成需求。目标用户覆盖AI算法研发人员、图像生成工具开发者、内容创作从业者等,可应用于AI图像工具研发、批量图像内容生产、个性化图像模型训练等场景。
cnnlstm.github.io
DiffusionMat是基于扩散模型的图像抠图技术框架官方站点,核心定位是为图像抠图领域的技术展示与成果分享平台。核心功能包括扩散模型抠图原理展示、基准测试结果对比、校正模块技术说明。目标用户覆盖计算机视觉领域研究人员、图像编辑工具开发者、专业图像处理从业者、数字内容创作者。使用场景包括学术研究中抠图算法对比、图像工具开发时的算法参考、专业后期制作中的抠图效果优化等,可帮助相关人员了解新型抠图技术的落地应用。
zeriuxlabs.com
Zeriux Labs是一家以人工智能为驱动的非营利研究机构,核心定位是通过伦理框架下的技术创新,探索并尝试解决全球范围内的公共挑战。机构聚焦于人工智能伦理规范建设、前沿技术公益应用开发、全球公共问题技术方案研究等方向,核心功能涵盖AI伦理框架研究、开源技术项目开发、全球挑战数据采集分析、跨学科研究合作对接、公益技术成果推广。目标用户包括人工智能研究人员、公益技术开发者、全球公共问题研究学者、非营利公益组织、政策制定机构以及关注全球公共议题的社会群体。适用场景包括AI技术伦理规范探讨、公益领域技术工具开发、全球气候变化、公共卫生等挑战的技术解决方案研究、跨领域科研合作对接等。
jefftan969.github.io
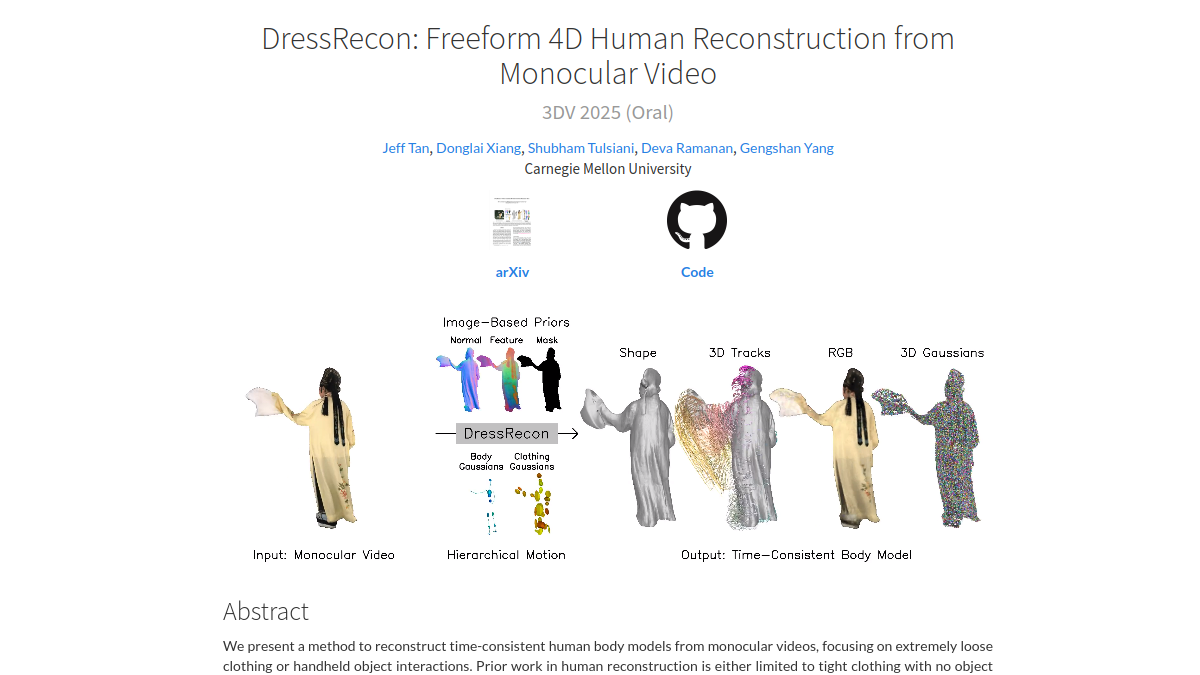
DressRecon是专注于单目视频4D人体模型重建的技术项目站点,核心定位是解决宽松服装、手持物体交互等复杂场景下的人体动态重建难题。核心功能包括时间一致的4D人体模型生成、身体与服装变形分离建模、高保真3D几何细节捕捉,支持重建结果导出为网格或3D高斯格式。目标用户覆盖计算机视觉研究人员、三维动画制作人员、虚拟数字人开发人员、动作捕捉技术从业者。使用场景包含复杂服装的动态效果研究、虚拟人物的动作数据采集、影视动画的角色动作还原、人体交互行为的三维分析等。

foundationvision.github.io
UniTok是面向计算机视觉领域的视觉分词技术展示与资源平台,核心定位是为相关从业者提供统一视觉分词技术的落地参考与技术资料。平台支持UniTok技术原理的详细解读、ImageNet等公开数据集测试结果展示、多码本量化技术实现细节说明,同时提供可复用的代码实现示例与技术适配指南。目标用户涵盖计算机视觉领域研究人员、AI算法开发工程师、多模态应用开发团队、高校相关专业师生,可应用于图像生成模型优化、视觉理解任务研发、多模态大模型底层模块开发、学术研究复现等多种场景。
rf-inversion.github.io
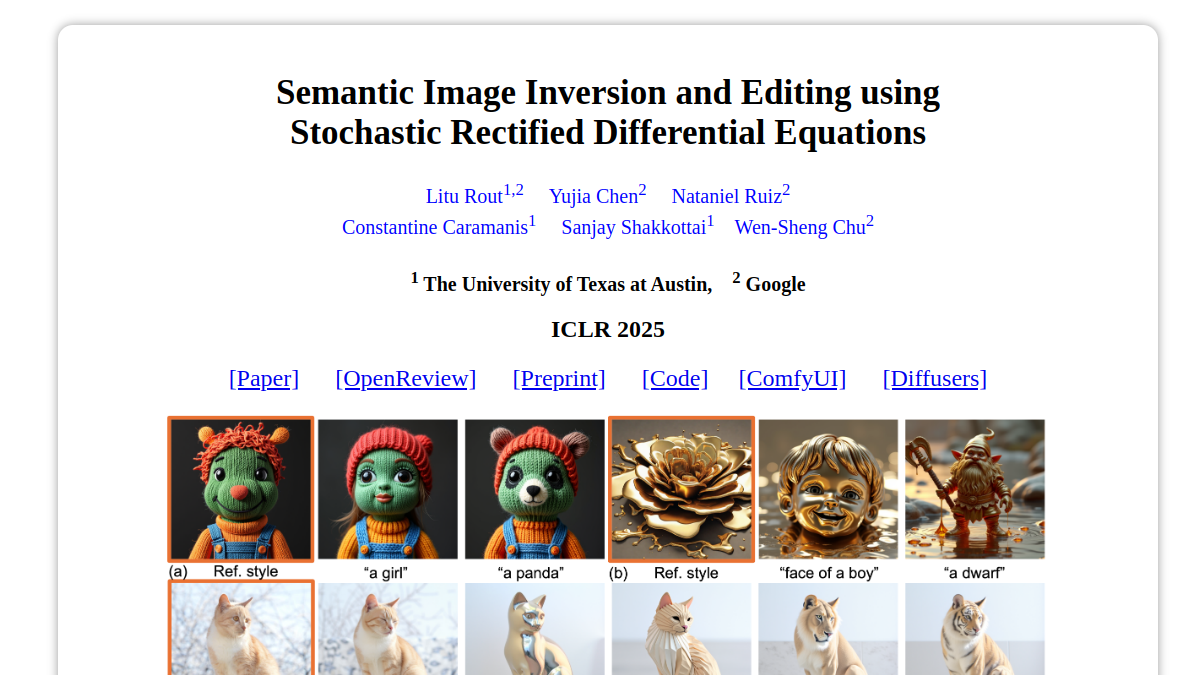
RF-Inversion是由德克萨斯大学奥斯汀分校与谷歌研究人员联合开发的图像生成与编辑技术展示平台,核心基于随机微分方程(SDE)实现图像反转与编辑操作,无需额外模型训练、潜在空间优化、提示词调整或复杂注意力处理器即可完成相关任务。平台核心功能包括零样本图像反转、笔画转图像合成、语义图像编辑三类,主要面向计算机视觉研究人员、AI图像技术开发者、数字内容创作者、高校图像处理相关专业学生等群体,可应用于学术研究效果复现、创意图像内容生成、图像属性定向调整、手绘内容数字化转换等多种场景。
dachunkai.github.io
EvTexture是基于事件视觉驱动的视频超分辨率技术演示站点,核心定位为面向计算机视觉领域研究者、开发者提供事件驱动视频超分辨率技术的体验、效果验证与技术参考平台。站点支持上传普通视频与对应事件信号数据进行超分辨率处理,可直观对比不同算法的纹理恢复效果,同时提供完整的技术论文、数据集测试结果查阅功能。目标用户涵盖计算机视觉研究人员、视频处理开发工程师、高校相关专业师生、影视后期制作人员、安防监控技术人员、VR内容创作者,可应用于学术研究验证、老旧视频修复、监控画面增强、影视内容画质升级、VR视频清晰度优化等多种场景。