扩散模型

be-your-outpainter.github.io
MOTIA是专注于视频外延画技术的在线工具平台,基于测试时适应的扩散方法开发,核心面向有视频内容扩展需求的创作者与技术研究人员。平台支持用户上传源视频后自动提取内容与运动特征,通过内在适应和外在渲染两个核心阶段完成视频外延画生成,同时提供参数调整、效果预览、多格式导出等配套功能。可应用于短视频二次创作、影视素材补全、动画内容扩展、学术研究效果验证等多个场景,帮助用户在不额外拍摄素材的前提下,扩展视频的画幅边界与内容长度。

matankleiner.github.io
Slicedit是一个基于零样本技术的在线视频编辑工具,核心依托文本生成图像扩散模型与时空切片算法,可在保留原始视频结构与运动逻辑的前提下,实现基于文本指令的视频内容编辑。其核心功能包括文本驱动视频内容修改、时序一致性自动优化、原始视频结构保留、多风格编辑适配及编辑效果实时预览,主要面向视频创作者、AI技术研究者、内容运营人员、多媒体设计人员等群体,适用于短视频创意修改、影视素材二次创作、学术实验验证、内容物料快速调整等多个场景,无需大量训练数据即可完成各类视频的编辑需求。
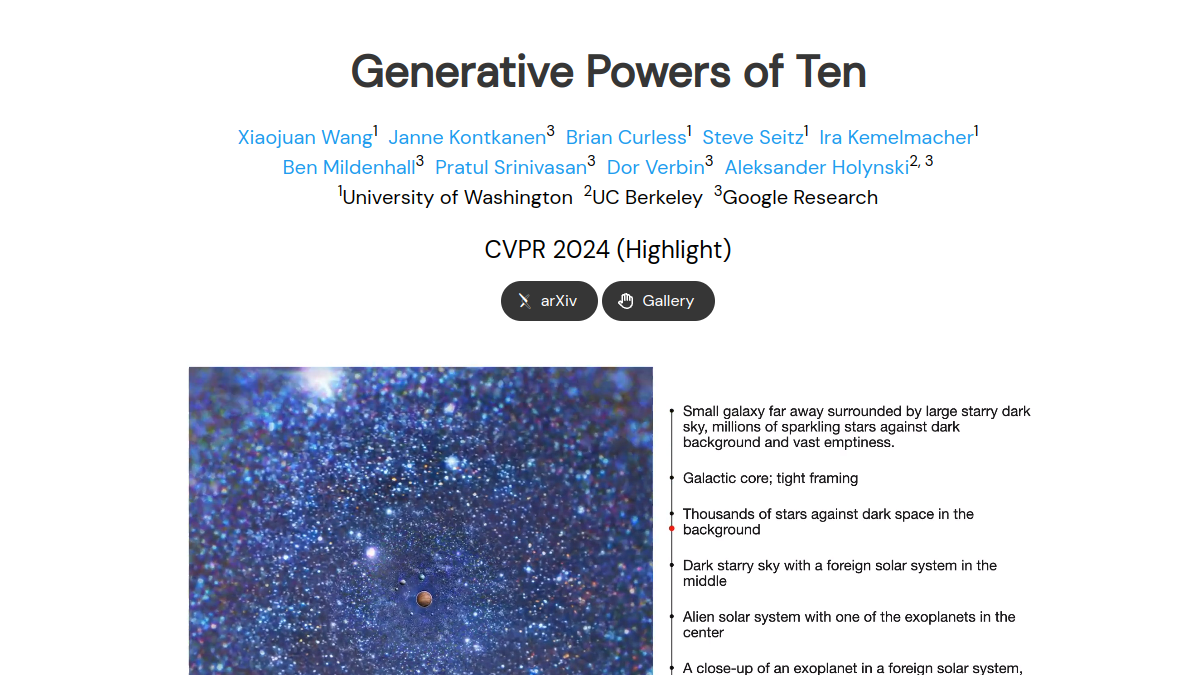
powers-of-10.github.io
Generative Powers of Ten是专注于多尺度一致图像生成的在线演示平台,核心基于文本驱动的多尺度扩散采样技术,可实现跨尺度的场景语义缩放生成。平台支持连续缩放视频渲染、交互式多尺度场景探索两大核心功能,同时提供生成结果与传统超分方案的对比展示。目标用户覆盖计算机视觉研究人员、数字内容创作者、教育科普工作者、交互设计从业者等群体,可用于图像生成技术研究参考、创意视觉内容制作、多尺度成像原理科普演示等多种场景,帮助用户直观理解文本驱动的跨尺度图像生成逻辑与效果差异。
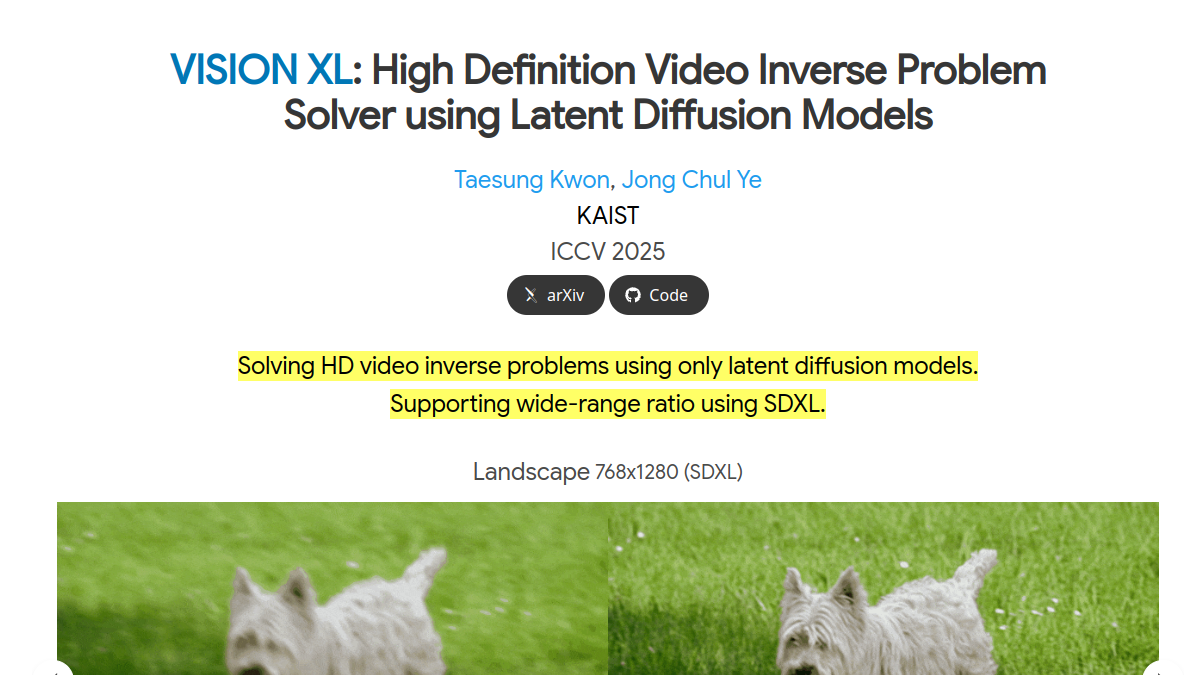

vision-xl.github.io
VISION XL是基于潜在扩散模型打造的高清视频逆问题处理框架,核心定位是为视频修复与画质提升场景提供技术解决方案。核心功能包括多比例高分辨率视频重建、伪批量一致性采样优化、批量一致性反演计算,能够适配去模糊、超分辨率、视频修复等多种场景。目标用户覆盖计算机视觉研究人员、视频制作从业者、AI算法开发工程师等群体,可应用于学术研究实验、老旧视频画质修复、专业影视内容后期处理、监控视频内容增强等多个场景,依托开源SDXL模型的技术底座,实现稳定的视频重建效果。
nv-sana.mit.edu
Sana-1.6B是由NVIDIA实验室联合麻省理工学院开发的高分辨率图像合成模型官方演示站点,核心基于线性扩散变换器与DC-AE技术,主打高效的高分辨率图像生成能力。站点提供文本生成图像的在线演示通道,支持用户上传参考图进行风格迁移生成,同时开放模型技术文档与开源代码获取入口。目标用户覆盖AI图像生成研究者、创意设计从业者、高校计算机相关专业师生,可用于学术研究验证、设计素材生成、多模态模型效果测试等场景。
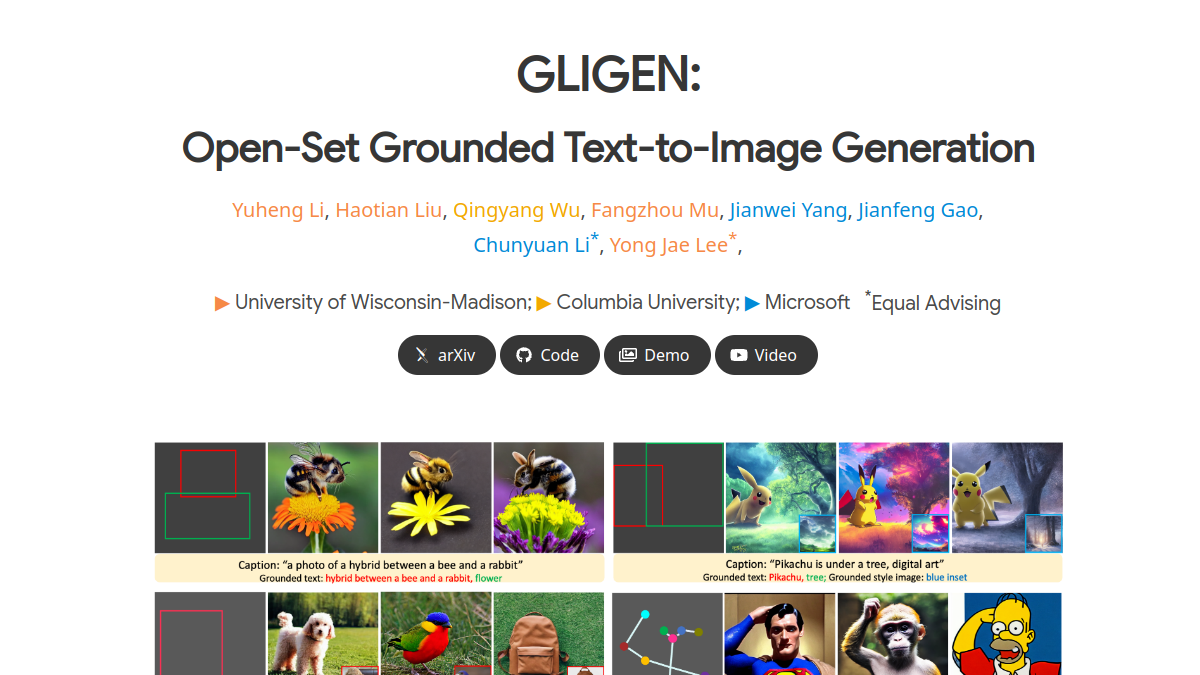

gligen.github.io
GLIGEN是一款开放式的条件式图像生成学术项目站点,核心为基于扩散模型的可控图像生成技术。用户可结合文本描述与空间边界框、参考图像等条件,生成符合指定布局与内容要求的图像;模型采用模块化训练设计,保留预训练扩散模型的基础生成能力的同时,扩展了空间控制属性。该站点面向AI图像生成研究者、计算机视觉从业者、内容创作人员、设计人员等群体,可用于学术研究验证、可控图像内容创作、多模态模型效果测试、概念设计初稿生成等场景,帮助用户在图像生成过程中实现更精准的内容与布局控制。

iceclear.github.io
SeedVR是专注于视频修复任务的扩散变换器模型演示站点,核心定位是为视频处理相关从业者提供前沿AI视频修复能力的在线体验与技术参考。站点支持任意长度、任意分辨率的受损视频序列修复,搭载移位窗口注意力机制,同时结合因果视频自编码器、混合图像视频训练等技术优化生成效果。目标用户涵盖视频内容创作者、后期制作人员、AI技术研究者、影视资料修复从业者等,可应用于老影视资料画质修复、损坏视频素材修复、低清拍摄视频画质增强、AI视频生成瑕疵修正等多种场景,帮助用户提升视频素材的整体视觉质量。

token-verse.github.io
TokenVerse是面向个性化图像生成领域的技术展示与方案介绍站点,核心围绕基于文本到图像扩散模型的多概念解耦与组合生成技术展开。站点核心功能包括技术原理解析、生成效果案例展示、应用场景说明,以及相关研究成果的公开分享。目标用户覆盖AI图像生成领域的研究人员、创意设计从业者、AI工具开发者,以及对个性化图像生成有需求的内容创作者。用户可通过站点了解该技术从单张图像中解耦物体、配饰、材质、姿势、光照等多类视觉元素的实现逻辑,查看不同概念组合生成的效果案例,参考该技术在创意设计、内容生产等场景的落地路径。

x-dyna.github.io
X-Dyna是专注于零样本人类图像动画生成的技术展示与试用平台,核心依托扩散模型实现静态人像的动态效果生成。平台支持用户上传单张人像图片与驱动视频,即可将视频中的面部表情、肢体动作迁移到静态人像上,生成连贯的动态视频;内置Dynamics-Adapter模块可保留人像原有外观特征,同时实现动作的自然迁移;支持表情局部精准控制,可单独调整面部表情参数。平台面向AI生成内容创作者、数字媒体设计师、动画制作从业者、学术研究人员等群体,适用于数字人内容制作、短视频特效创作、虚拟形象动态化、学术技术验证等多种场景。

seedance2pro.io
Seedance 2.0是专注于AI视频生成与增强的创作平台,依托扩散模型技术支持创作者生成符合影视创作标准的视频内容,同时提供AI驱动的视频增强、视频风格迁移、分辨率提升、镜头衔接优化等核心功能。平台面向影视创作从业者、独立内容创作者、新媒体内容生产者、商业广告制作团队等不同用户群体,可用于影视前期概念片制作、短视频内容创作、旧视频修复、广告片快速生成、自媒体内容二次创作等多种创作场景,帮助创作者降低视频内容制作的时间与人力成本。
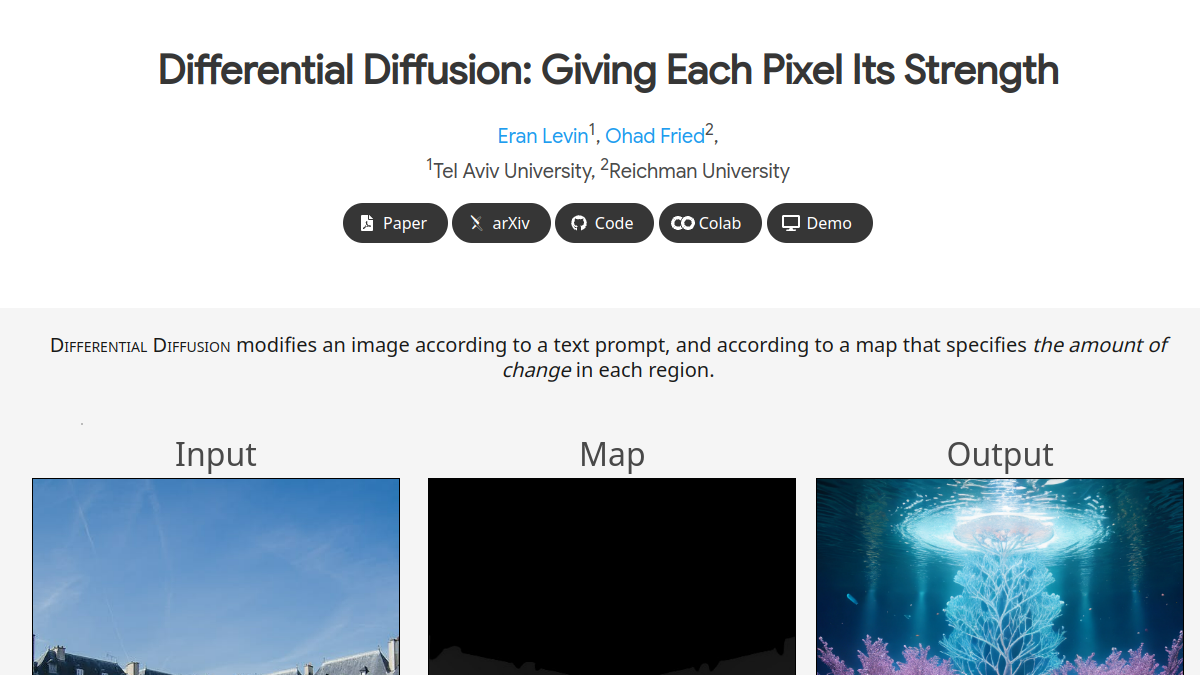

differential-diffusion.github.io
Differential Diffusion是专注于细粒度可控图像生成与编辑的学术展示平台,核心基于差分扩散技术框架,支持区域自定义修改强度控制、渐变空间变化编辑、图像补全无缝融合三类核心功能,主要面向AI图像研究人员、数字内容创作者、交互设计开发者、计算机视觉专业学生等群体,可用于学术研究效果验证、创意图像处理、特定区域精细修图、图像补全实验等多种场景,平台无需用户额外训练模型,仅通过推理阶段即可完成所有编辑操作,支持与主流开源扩散模型集成使用。
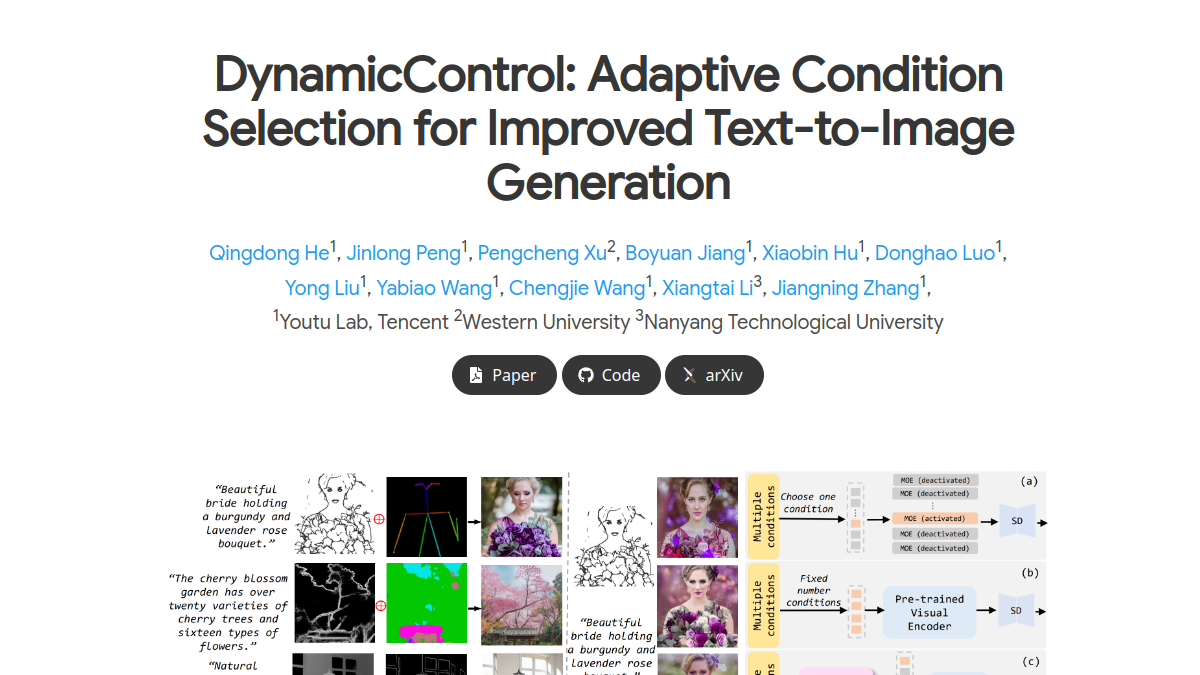

hithqd.github.io
DynamicControl是专注于提升文本到图像扩散模型生成控制力的开源技术框架,核心定位是解决多控制信号组合下图像生成一致性不足的问题。其核心功能包括双循环控制器初始条件排序、多模态大语言模型条件评估优化、并行多控制适配器特征整合三大模块,支持用户灵活组合不同类型、数量的控制条件,实现更符合预期的图像生成效果。该框架面向AI图像生成领域的研究人员、算法工程师、AIGC应用开发者,可应用于可控图像生成算法研究、专业AI绘图工具开发、定制化图像生成系统搭建等场景,帮助使用者降低多条件控制下的图像生成偏差,提升生成结果与输入需求的匹配度。
gojasper.github.io
Flash Diffusion是专注于快速图像生成的AI模型演示平台,核心定位为低算力需求下的高效图像生成技术展示站点。平台支持文本生成图像、图像超分辨率、局部内容修复三类核心功能,可展示模型在少步骤推理下的图像输出效果。目标用户覆盖AI图像算法研发人员、高校计算机相关专业学生、创意设计从业者、AI技术爱好者等群体,可用于算法效果验证、技术学习参考、创意素材快速生成、模型性能对比测试等场景。

knightyxp.github.io
VideoGrain是基于扩散模型的视频编辑技术展示平台,核心定位是为内容创作者、技术研究者提供可交互的多粒度视频编辑技术演示与参考。平台支持文本驱动的指定区域视频编辑,可实现跨帧语义一致的内容修改,同时保留原有视频的运动逻辑与画面风格;支持不同编辑粒度的调节,用户可选择从局部物体替换到整体场景风格调整的不同编辑强度;还提供多组对比案例,直观呈现技术效果与传统编辑方法的差异。平台目标用户包括视频后期从业者、AI视频技术研究者、广告内容制作人员、高校计算机相关专业师生等,可用于影视后期片段修改、广告创意内容快速迭代、视频编辑技术研发参考、学术研究效果验证等场景。
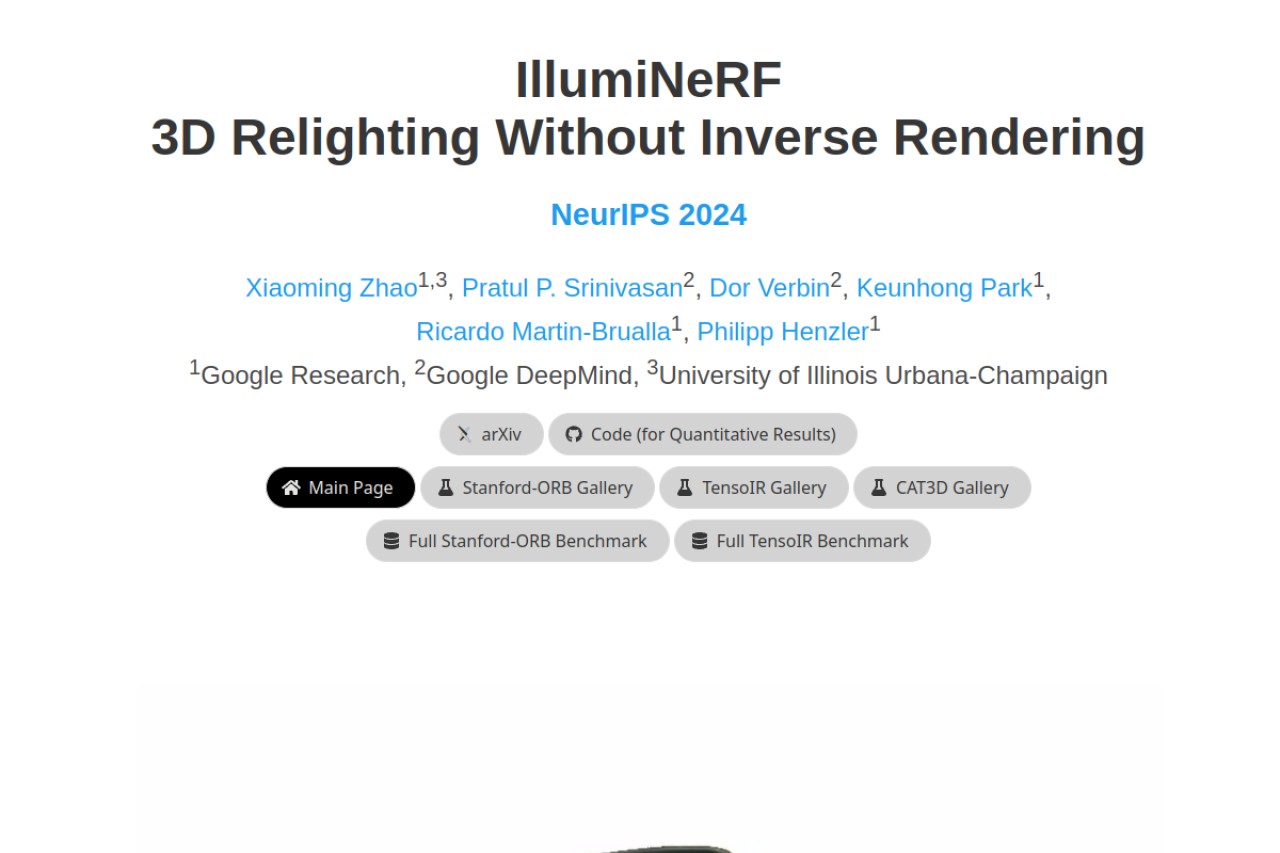

illuminerf.github.io
IllumiNeRF是专注于3D重光照与新视角渲染的技术服务站点,核心基于神经辐射场(NeRF)与图像扩散模型的组合方案,解决传统逆向渲染方法计算成本高、优化过程不稳定的问题。核心功能包括未知光照下的3D场景重建、指定目标光照的新视角渲染、多视角输入图像的自动重光照预处理、重光照效果基准测试对比等。服务于计算机视觉研究人员、3D内容创作者、影视动画制作人员、AR/VR开发人员等群体,可用于3D资产制作、虚拟场景光照调整、数字孪生场景还原、影视道具渲染等多种场景,无需提前获取拍摄环境的光照参数,仅通过普通拍摄的多视角图像即可完成3D内容的光照可控渲染。
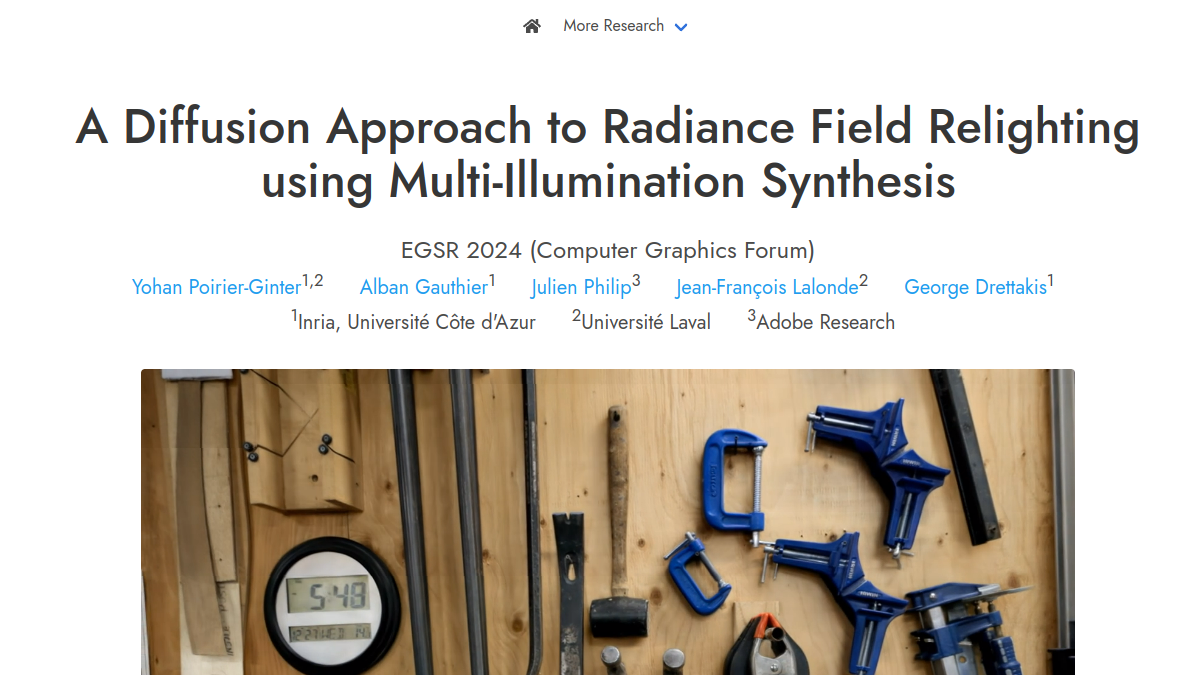
该网站是法国国家信息与自动化研究所(INRIA)发布的辐射场重照明技术研究项目展示平台,核心定位为呈现基于扩散模型的多光照合成辐射场重照明方案。核心功能包含完整技术原理说明、方法效果可视化对比、相关研究论文与实验数据集下载。目标用户覆盖计算机图形学领域研究人员、3D内容开发从业者、AR/VR场景开发工程师、高校图形学方向师生。使用场景包括学术研究中辐射场相关技术的参考借鉴、3D内容制作过程中场景重照明效果的生成、AR/VR应用中真实感光照交互方案的研发等,为相关领域从业者提供前沿技术的参考与实践依据。
instructvideo.github.io
InstructVideo是基于人类反馈奖励微调机制的文本生成视频技术研究展示平台,核心定位为公开文本到视频扩散模型的优化方案及相关技术成果。平台提供技术论文原文查阅、核心算法原理演示、生成效果对比样例查看三大核心功能,面向AI视频生成领域的研究人员、算法开发工程师、相关专业高校学生,以及AI内容创作从业者,支持技术学习、算法参考、效果验证、研究选题参考等多种场景使用。
fudan-generative-vision.github.io
Hallo2是复旦大学生成视觉团队研发的人像图像动画技术演示站点,核心基于优化后的潜在扩散生成模型,可实现音频驱动的静态人像动效生成。核心功能包括音频驱动长时人像视频生成、4K分辨率视频输出、文本提示辅助表情控制三类,面向AI视频创作者、数字内容制作从业者、高校相关领域研究人员开放,可应用于虚拟数字人内容制作、老照片人像动态化还原、短视频个性化动效创作、学术技术效果验证等多个场景。

follow-your-emoji.github.io
Follow-Your-Emoji是一个基于扩散模型的人像表情迁移动画工具,核心定位是将指定表情序列迁移到参考人像上,生成连贯的动画内容。它支持多种类型人像的表情迁移,支持生成长期稳定的动画内容,同时保持人像身份特征不发生变化。该工具面向动画制作从业者、内容创作者、AI技术研究者等用户群体,可应用于短视频表情演绎、虚拟角色动画制作、人像表情复刻等场景,帮助用户降低人像动画的制作成本,提升表情动画的还原精度。

cangcz.github.io
AnchorCrafter是一款基于扩散模型的2D定制视频生成工具,核心定位是实现包含指定人物与定制化对象的交互式视频创作。其核心功能包括人-物交互逻辑注入、多视角对象外观识别、人物与物体特征独立可控生成,可在生成视频中维持人物外观、运动轨迹与物体形态的一致性。目标用户覆盖影视内容创作者、电商运营人员、广告设计团队、AI视频技术研究者等群体,适用于电商产品展示视频制作、创意广告内容生成、虚拟场景交互演示、AI视频技术研发测试等多个场景。
latent-consistency-models.github.io
Latent Consistency Models(简称LCMs)是面向AI图像生成领域的开源技术项目网站,核心定位是提供低推理成本的高分辨率图像生成技术方案。其核心功能包括预训练稳定扩散模型适配能力,可从现有成熟的稳定扩散模型中快速衍生出LCMs版本;支持少步推理生成高保真图像,无需多轮迭代即可输出清晰画面;提供Latent Consistency Fine-tuning(LCF)自定义微调方法,适配个性化图像生成需求。目标用户覆盖AI算法研发人员、图像生成工具开发者、内容创作从业者等,可应用于AI图像工具研发、批量图像内容生产、个性化图像模型训练等场景。

kebii.github.io
MikuDance是一款基于扩散模型的角色艺术动画生成工具,核心定位为风格化角色动画制作管道,可将静态角色艺术作品转化为具备连贯动态的动画内容。核心功能包括混合运动动态建模、混合控制扩散调节、场景运动跟踪适配,能够解决高动态运动适配、参考引导错位、角色体型尺度对齐等行业常见问题。目标用户覆盖动画制作从业者、独立创作者、二次元内容制作者、游戏开发人员等群体,适用场景包括短视频角色动画制作、游戏角色动效设计、同人内容创作、虚拟偶像动作演示、实验性动画项目开发等,可帮助用户降低角色动画的制作门槛,提升动画生成的动态表现力。