开源AI模型
01-ai.github.io
Yi-Coder是零一万物推出的开源代码大模型系列,核心定位为低参数规模下的高性能代码生成解决方案,当前包含1.5B和9B两种参数规格,均提供基础版本与聊天版本。核心功能包括多场景代码生成、长上下文仓库级理解、多任务编程能力支持,可覆盖从基础代码补全到竞技编程的多样需求。目标用户涵盖AI研发人员、开源项目贡献者、企业技术团队、独立开发者等,可应用于本地代码编辑器插件开发、私有代码仓库智能辅助工具搭建、轻量化代码推理服务部署、编程教育辅助工具研发等多个场景。

ai.google.dev
Google AI for Developers是谷歌面向开发者推出的AI开发资源聚合平台,核心定位是为全球开发者提供谷歌旗下AI模型的接入能力、开发工具与技术支持,帮助开发者快速将AI能力集成到各类应用中。平台核心功能包括Gemini系列API调用入口、Gemma开源模型资源库、Google AI Studio在线开发调试工具,同时配套多语言SDK、开发文档与社区支持。目标用户覆盖应用开发者、AI算法工程师、移动端开发人员、学生开发者等群体,可应用于应用AI功能迭代、AI原型项目开发、学术研究实验、跨端AI应用落地、企业AI服务搭建等多种场景。
si.inc
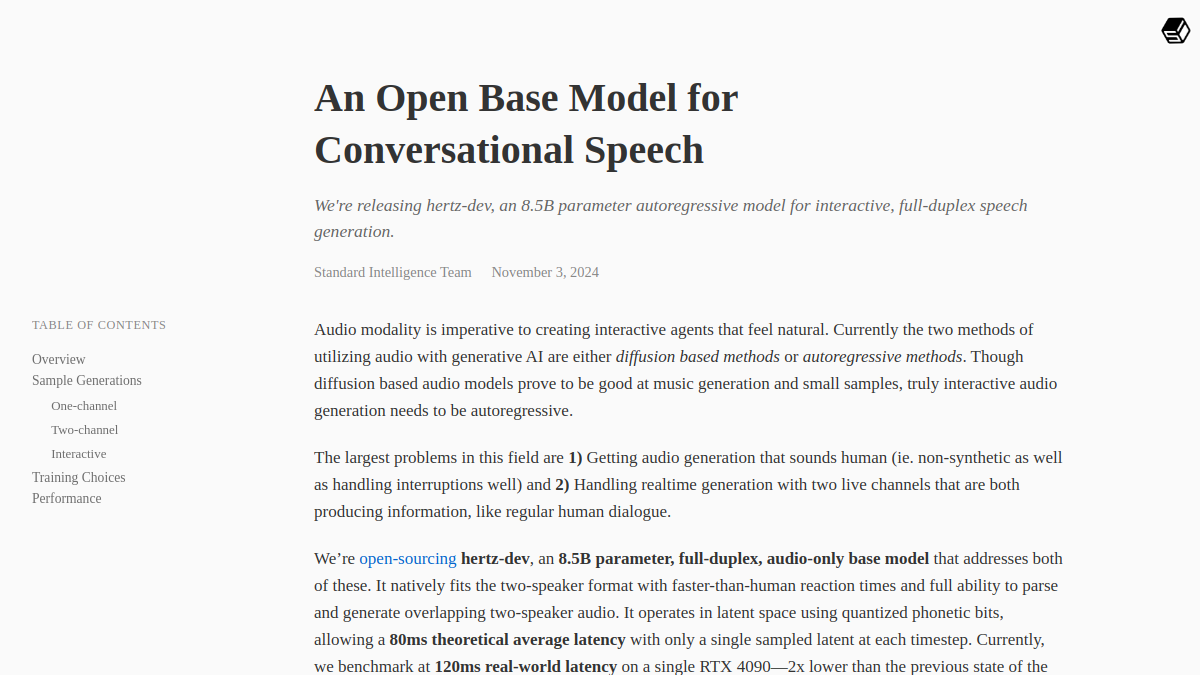
hertz-dev是Standard Intelligence推出的开源音频变换器基础模型站点,核心定位为面向音频处理领域的开源技术研究平台,提供85亿参数规模的全双工仅音频变换器模型能力。核心功能包括音频编码转换服务,可将16kHz单声道语音转换为8Hz低比特率潜在表示;支持模型微调工具集,方便研究人员基于现有模型适配特定场景;提供完整的技术文档与开源协作社区,助力跨模态音频学习技术落地。目标用户覆盖AI音频领域研究人员、语音技术开发工程师、跨模态学习相关科研团队,适用于低带宽语音传输场景开发、音频特征提取研究、多模态大模型音频模块搭建等多元场景。

metamotivo.metademolab.com
Meta Motivo是Meta FAIR推出的早期行为基础模型演示站点,核心定位是为相关领域研究者、开发者提供无监督强化学习训练的虚拟人形代理模型功能演示与资源获取入口。站点支持模型能力在线交互测试、预训练模型及训练代码下载、零样本任务效果展示三类核心功能,面向人工智能领域研究者、强化学习开发者、机器人研发从业者、高校相关专业师生等群体,可用于行为基础模型技术验证、人形机器人控制逻辑参考、相关技术研究复现、学术课题实验支撑等场景,帮助用户直观理解该模型在复杂全身任务控制上的技术特性。

tencent.github.io
MimicMotion是腾讯与上海交通大学联合研发的人体动作视频生成模型工具站点,核心功能覆盖在线动作驱动、长视频时序生成、姿势序列自定义三个核心模块,面向AI内容创作者、影视动画从业者、计算机视觉研究人员等群体提供动作驱动的视频生成服务。用户可上传参考人物图像和对应的姿势序列文件,即可生成符合姿势引导的人物动作视频,可应用于动画素材制作、动作迁移实验、虚拟数字人内容创作等场景,满足不同场景下的动作视频生成需求。

chat.mithrilsecurity.io
BlindChat是专注隐私保护的AI对话服务平台,核心定位是在端到端加密环境下为用户提供安全的AI交互服务。平台内置Xenova/LaMini-Flan-T5-783M开源模型,支持常规问题解答、知识科普、内容创作辅助等功能,同时所有对话数据全程加密不会被第三方获取。平台面向重视数据隐私的办公人员、学生、内容创作者等群体,适用于日常问题查询、私密内容梳理、个人学习辅助等场景,目前处于Beta测试阶段,用户可免费申请体验相关服务。
falconllm.tii.ae
Falcon 180B是由技术创新研究院(TII)推出的生成式大型语言模型官方站点,核心定位为面向全球开发者、研究机构及企业提供大模型技术支持与资源服务。站点提供不同参数规模的Falcon系列模型下载与使用文档,配套REFINEDWEB高质量训练数据集获取渠道,同时展示模型在各行业的落地应用案例。目标用户覆盖AI研究人员、企业技术开发团队、高校人工智能专业师生等群体,可支持自然语言处理研究、行业大模型微调、智能应用开发等多种场景使用。

hyperllm.org
HyperLLM是一个专注于小型语言模型开发与微调和训练的开放平台,核心定位是为语言模型研究者和开发者提供低成本的轻量型模型训练与微调服务。平台支持开发者快速完成小型语言模型的即时微调,支持自定义数据集导入,提供开源模型参数下载渠道,支持本地部署适配。该平台面向AI研究人员、NLP开发者、创业团队、学生研究者等用户,可用于快速原型验证、垂直领域模型定制、学术研究实验、小型项目部署等场景。

co-tracker.github.io
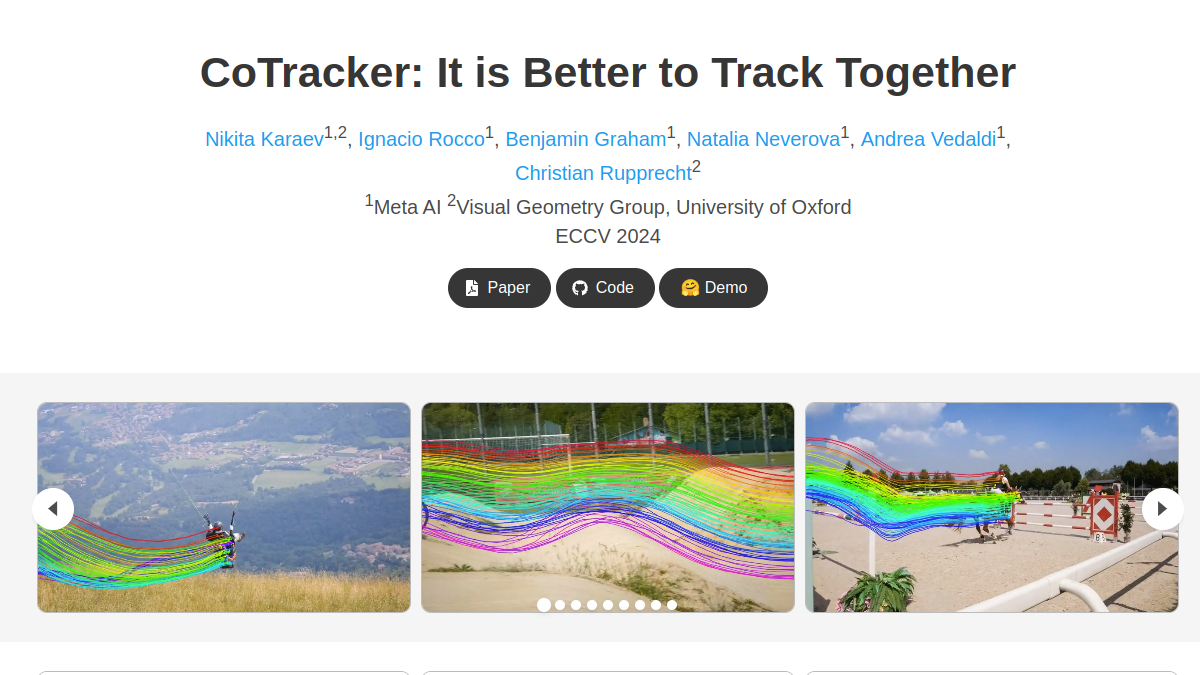
CoTracker是面向视频点跟踪任务的开源Transformer模型官方站点,核心功能为支持视频序列的稠密点联合跟踪、长时遮挡场景下的轨迹预测、可扩展的大规模点跟踪部署,目标用户覆盖计算机视觉研究人员、视频内容开发从业者、机器人导航算法工程师等群体,可应用于视频动作捕捉、三维重建、运动分析、自动驾驶场景感知、视频特效制作等多个领域,区别于传统独立点跟踪方法,该模型通过建模点与点之间的空间关联,提升跟踪的精度与鲁棒性,适配长视频、遮挡场景下的跟踪需求。
wan22.io
Wan 2.2 AI是一个专注于AI视频生成的开源技术平台,核心采用MoE混合专家模型架构,主打高可控性的专业视频创作能力。平台支持文本生成视频、图像生成视频、视频风格转换、镜头运动控制、视觉参数精细化调节等核心功能,面向视频创作者、影视制作人员、AI技术研发者、内容运营从业者等群体,可满足商业广告制作、影视样片产出、短视频内容创作、AI视频技术研究、创意内容演示等多场景使用需求,用户无需复杂的本地部署即可在线体验模型生成能力,也可获取开源代码进行二次开发。
nv-sana.mit.edu
Sana-1.6B是由NVIDIA实验室联合麻省理工学院开发的高分辨率图像合成模型官方演示站点,核心基于线性扩散变换器与DC-AE技术,主打高效的高分辨率图像生成能力。站点提供文本生成图像的在线演示通道,支持用户上传参考图进行风格迁移生成,同时开放模型技术文档与开源代码获取入口。目标用户覆盖AI图像生成研究者、创意设计从业者、高校计算机相关专业师生,可用于学术研究验证、设计素材生成、多模态模型效果测试等场景。
ACE是由阿里通义实验室推出的基于扩散Transformer架构的多模态视觉生成与编辑工具,核心定位为支持多任务联合处理的全能创意内容生成平台。核心功能包括支持长上下文指令理解的统一条件输入、多场景图像生成与编辑能力、多模态指令自动生成服务。目标用户覆盖AI图像研发人员、内容创作者、产品设计师、高校计算机专业师生等群体,适用于多模态视觉模型研发测试、创意海报设计、图像内容二次编辑、AI生成应用原型搭建等多种场景,能够帮助用户简化视觉内容处理流程,提升生成任务的处理效率。
gojasper.github.io
Flash Diffusion是专注于快速图像生成的AI模型演示平台,核心定位为低算力需求下的高效图像生成技术展示站点。平台支持文本生成图像、图像超分辨率、局部内容修复三类核心功能,可展示模型在少步骤推理下的图像输出效果。目标用户覆盖AI图像算法研发人员、高校计算机相关专业学生、创意设计从业者、AI技术爱好者等群体,可用于算法效果验证、技术学习参考、创意素材快速生成、模型性能对比测试等场景。

stablehorde.net
Stable Horde是一个众包分布式AI生成平台,依托全球自愿贡献算力的工作者节点集群,为用户提供无需自建本地算力的图像与文本生成服务。平台核心功能包括多模型图像生成、自定义参数文本创作、算力贡献兑换生成额度机制,覆盖从普通内容创作者到AI技术爱好者的多类用户群体,可应用于创意设计草图输出、文案初稿撰写、AI艺术创作探索、批量内容生成等多种场景,用户无需部署复杂的本地运行环境,通过网页端或API即可调用分布式算力完成生成任务。

snap-research.github.io
Snap Video是由Snap Research团队推出的视频生成研究项目网站,核心定位为展示前沿的视频优先生成模型技术成果。网站提供该模型的核心论文解读、生成效果演示Demo、训练技术框架说明三大核心功能,主要面向AI生成技术研究人员、视频内容创作者、高校计算机专业学生、AI产品开发从业者,可用于学术研究参考、视频创作效率提升、相关技术学习、产品技术选型等场景。
hkunlp.github.io
Dream 7B是由香港大学NLP组与华为诺亚方舟实验室联合研发的扩散大语言模型官方介绍站点,核心定位为向学术研究者、AI开发人员及相关行业从业者公开模型技术细节、性能数据与应用落地方向。站点提供模型技术框架解析、多场景测试数据集、推理能力基准测试结果、开源部署指引与合作申请通道等核心内容,适合自然语言处理领域学者做技术对比、AI开发者选型大模型底座、企业技术团队评估落地可行性等场景使用,可帮助用户全面了解该模型在复杂推理、长期规划、上下文连贯性上的技术特性与应用边界。

trellis3d.github.io
TRELLIS是一款基于统一结构化潜在表示与修正流变换器架构的原生3D生成模型服务平台,核心面向3D内容创作相关从业者与研究人员,提供多条件驱动的3D资产生成、多格式导出、局部编辑等功能。用户可通过文本描述或参考图像快速生成符合需求的3D模型,支持游戏开发、元宇宙场景搭建、工业设计原型制作、影视内容创作等多个场景的3D内容生产需求,降低3D资产制作的技术门槛,缩短创作周期。
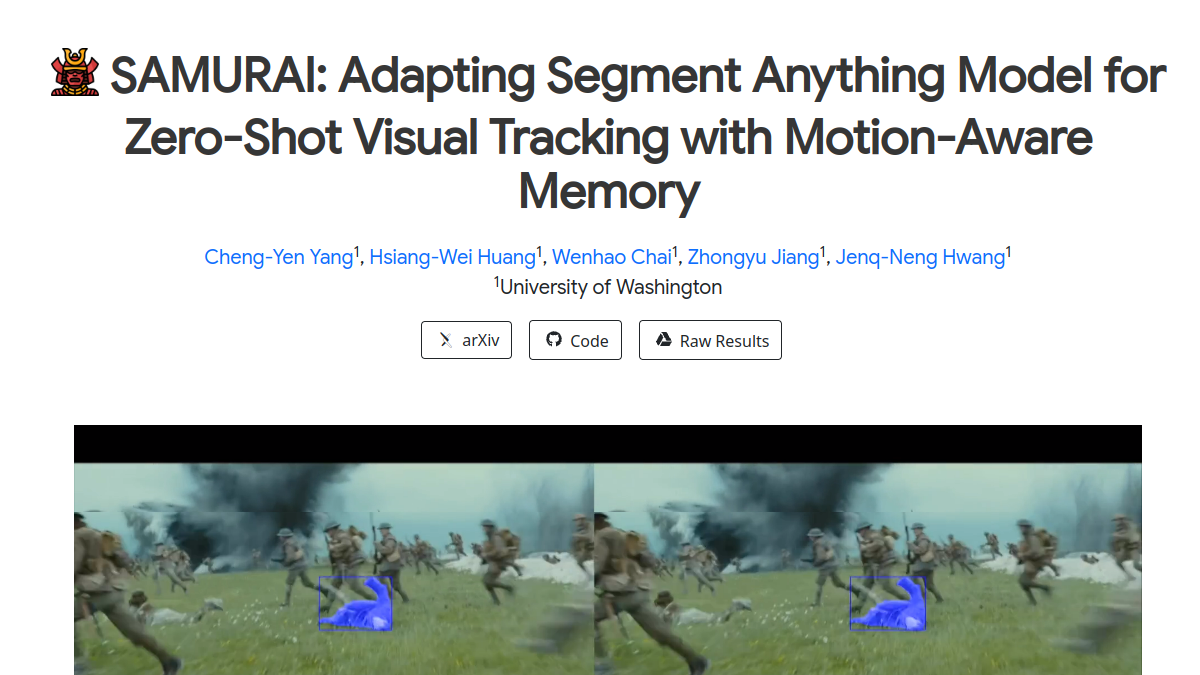

yangchris11.github.io
SAMURAI是基于Segment Anything Model 2(SAM 2)开发的视觉对象跟踪模型项目官网,核心定位是为视觉跟踪领域提供无需微调的零样本目标跟踪解决方案。核心功能包括运动感知记忆选择机制、时间运动线索融合、多基准数据集效果验证等,支持用户快速了解模型架构、复现跟踪效果、下载相关测试资源。目标用户覆盖计算机视觉领域研究人员、AI算法开发工程师、智能监控系统开发者、自动驾驶感知模块研发人员等,可用于学术研究对比、工业级视觉跟踪系统搭建、复杂动态场景跟踪方案选型等场景,帮助用户降低视觉跟踪模型的开发和适配成本。
stability.ai
Stable Zero123是Stability AI推出的视图条件3D生成模型官方介绍页面,核心定位为面向研究与非商业场景的3D生成技术落地载体。核心功能包括技术原理详解、开源获取路径指引、训练效率对比呈现,目标用户覆盖3D内容创作者、AI研究人员、计算机视觉领域开发者、文创行业从业者,可用于单视图生成多视角3D对象、学术研究技术复现、文创项目3D素材快速生成等场景,帮助用户降低3D内容生产的技术门槛,提升3D生成模型的训练与落地效率。

video-prediction-policy.github.io
Video Prediction Policy(简称VPP)是专注于机器人视觉预测策略研究的学术展示平台,核心展示基于视频扩散模型的机器人操控技术方案。平台提供完整的VPP技术原理讲解、实验基准测试数据、预训练模型开源资源,以及相关论文成果和数据集获取渠道。目标用户覆盖机器人学研究者、计算机视觉方向科研人员、机器人开发工程师、人工智能领域高校师生、具身智能项目研发团队、工业自动化方案设计人员。可用于机器人操控算法性能对比参考、具身智能视觉预测模块开发、相关学术研究的实验基线搭建、视频扩散模型跨领域应用探索等场景。

tangoflux.github.io
TangoFlux是开源的文本到音频(TTA)生成模型平台,核心定位是为音频生成领域的研究者、开发者提供高效、对齐能力强的音频生成技术方案。核心功能包括基于CRPO框架的高对齐度文本转音频生成、30秒44.1kHz高音质音频快速生成、全开源的模型与代码资源开放。目标用户覆盖音频领域研究者、AI应用开发者、内容创作者、高校计算机相关专业学生等,可用于学术研究验证、音视频内容音频素材生成、AI音频应用原型开发、课程实践项目搭建等场景。
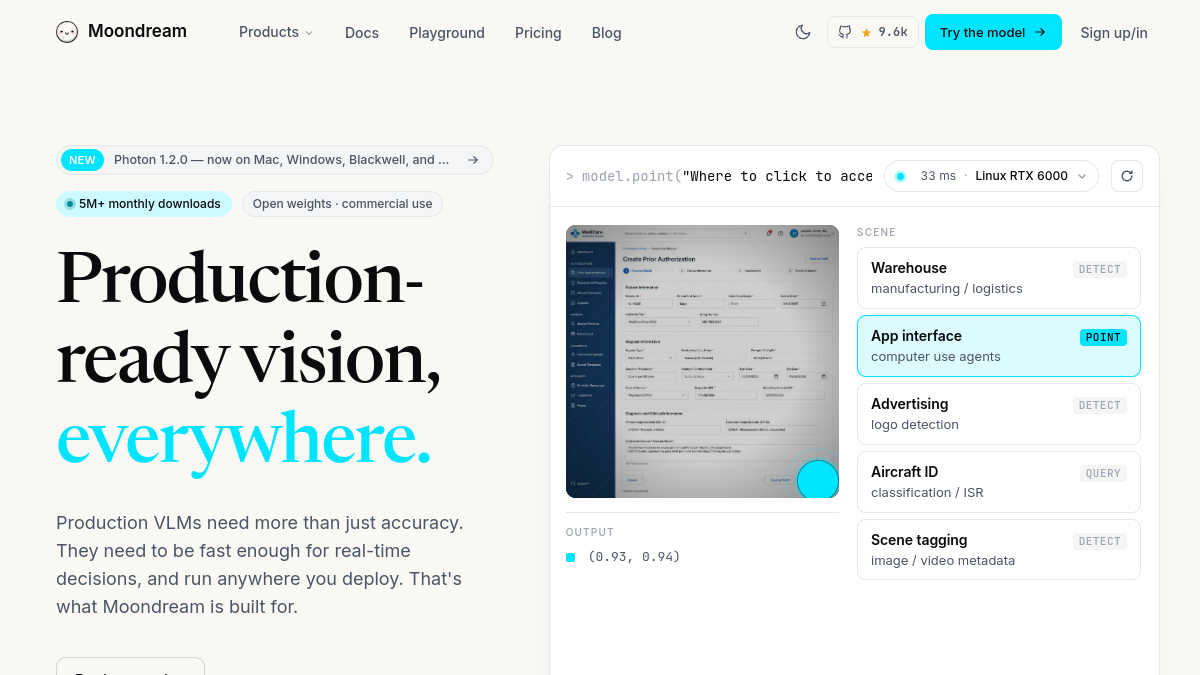

moondream.ai
Moondream AI是专注于开源视觉语言模型研发与落地的技术服务平台,核心定位是为开发者提供轻量高效的多模态AI能力支持。平台提供多格式量化模型下载服务,支持fp16、int8、int4等多种精度版本,适配服务器、PC、移动设备等不同硬件环境;提供开箱即用的推理部署工具包,包含GPU/CPU双端优化方案,降低部署门槛;还提供模型二次开发文档与社区支持,方便开发者根据业务需求调整模型参数。服务目标人群覆盖AI应用开发者、嵌入式设备研发人员、科研机构研究人员等,可应用于端侧智能图像识别、离线多模态交互、行业定制视觉问答等多种业务场景。

fireredteam.github.io
FireRedASR是开源工业级普通话自动语音识别工具,依托Encoder-Decoder与LLM集成架构开发,提供两种适配不同需求的模型变体,可实现多场景下的语音内容转文字处理。核心功能包含多语言语音识别、离线推理支持、批量音频处理、自定义热词优化、低资源音频适配,目标用户覆盖AI应用开发者、音视频内容创作者、企业技术研发人员、高校科研团队等,可用于智能助手语音交互、长视频字幕批量生成、会议录音内容转写、方言语音内容存档、客服通话质检分析等多类场景,满足工业级应用的集成与二次开发需求。

imagebind.metademolab.com
ImageBind是Meta推出的多模态AI模型演示平台,核心定位是展示跨六种感官模态关联能力的AI技术成果。平台支持图像、音频、文本三类模态的交互查询演示,可实现不同模态内容的相似性匹配,还能生成跨模态的关联结果。目标用户覆盖AI研究人员、多模态应用开发者、高校计算机相关专业学生以及对AI前沿技术感兴趣的爱好者。使用场景包括学术研究参考、多模态产品原型验证、技术科普演示、跨模态应用功能构思等,帮助用户直观理解多模态AI的技术逻辑与应用潜力。

ai.meta.com
Seamless Communication是Meta AI推出的跨语言交流技术研究平台,核心定位是通过生成式AI技术打破不同语言间的沟通壁垒。平台拥有保留情感韵律的表达型翻译、低延迟流式翻译、多模态多语言统一翻译三类核心功能,面向语言服务从业者、跨境内容创作者、国际交流参与者、AI技术研发人员等群体,可应用于跨国会议实时传译、多语言内容本地化、跨境商务沟通、小语种内容翻译等多个场景,帮助用户实现更贴近原生表达的跨语言交流。
ericguo5513.github.io
MoMask是面向3D人体运动生成领域的学术开源项目平台,核心定位是提供文本驱动的3D人体运动生成技术方案与相关资源。平台可实现文本到高保真3D人体运动序列生成,支持文本引导的运动序列局部修复,还可输出分层离散化的运动令牌数据。该项目目标用户包括计算机视觉方向研究人员、3D动画制作从业者、游戏开发人员、数字人开发工程师等,可应用于学术研究对比、动画内容快速制作、数字人动作生成、运动数据预处理等多个场景。
speechbot.github.io
Spirit LM是由研究团队推出的基础多模态语言模型,核心定位是实现文本与语音模态的自由混合交互。核心功能包括文本语音统一令牌流处理、少样本跨模态任务适配,以及两种不同特性的版本选择适配不同需求。目标用户涵盖自然语言处理研究人员、语音技术开发人员、多模态应用开发者、AI模型研究学习者等群体。使用场景包括语音识别模型优化、语音合成方案研发、多模态对话系统搭建、语音情感分析项目开发、跨模态任务迁移研究等多个方向,可帮助用户探索文本与语音模态融合的技术落地路径。
flux-1.ai
Flux 1 AI是一个专注于AI图像生成的在线创作平台,依托开源大模型为用户提供云端AI图像创作服务。平台核心功能包含文本生成图像、图像风格转换、自定义参数调整、高清导出以及创意灵感库参考等,支持用户根据自身创作需求灵活调整生成参数,获得符合预期的图像结果。目标用户覆盖内容创作者、平面设计师、艺术爱好者、自媒体运营者、电商美工、学生等群体,可应用于社交媒体配图制作、商业设计初稿产出、艺术概念草图创作、个人创意练习、电商商品图设计等多种创作场景,用户无需在本地部署大模型,即可在线调用开源模型的创作能力。

ai-s2-lab.github.io
EmoPP是面向语音合成领域的情绪感知韵律分析开源项目,核心定位是通过深度学习技术挖掘语音中的情感与韵律关联,提升端到端语音合成系统的情绪表达效果。项目支持语音情感线索提取、韵律停顿位置预测、模型效果对比验证三类核心功能,目标用户覆盖语音合成算法研发人员、自然语言处理研究者、语音交互产品开发团队等,可用于多情绪语音合成模型训练、智能语音助手交互优化、有声读物情绪配音开发等场景。
causvid.github.io
CausVid是一款基于双向扩散变换器适配因果变换器架构的视频生成模型站点,核心面向视频创作、AI技术研究等领域用户提供低延迟视频生成能力。站点核心支持文本输入生成对应视频、单张图像输入扩展生成连贯视频两种核心生成模式,依托单GPU即可达到9.4FPS的交互式生成帧率,可应用于内容创作者快速生成视频素材、技术研发人员测试视频生成效果、教育领域制作教学演示视频等多类场景,帮助用户降低视频生成的等待成本,提升视频内容制作效率。

jclinic.mit.edu
Boltz-1是麻省理工学院Jameel Clinic团队开发的开源生物分子结构预测模型站点,核心定位是为全球科研群体提供可自由使用的高精度生物分子结构预测工具。站点核心功能包括公开完整的Boltz-1模型权重与调用接口,提供分子结构预测结果的可视化展示模块,同时开放模型训练所用的部分数据集与技术文档。目标用户覆盖高校结构生物学研究人员、生物制药企业研发人员、计算生物学方向学生等群体,可应用于蛋白质结构解析、药物靶点筛选、分子互作机制研究等多种科研与产业场景,支持非学术场景的商业开发需求。

stablevideo.work
Stable Video是一个基于Stability AI开源模型搭建的在线AI视频生成平台,核心定位为通过自然语言文本输入或静态图像输入生成自定义时长的动态视频内容。平台支持文本转视频、图像转视频两种核心生成模式,还提供分辨率调整、生成步数设置、种子参数自定义等创作调节功能,无需本地部署复杂模型环境,打开浏览器即可使用。目标用户包括内容创作者、自媒体运营人员、设计从业者、视频制作爱好者、学生和数字艺术创作者,适用于社交媒体短视频创作、产品概念视频演示、艺术概念动态可视化、教学演示素材制作、创意内容原型快速产出等场景。

wanxai.com
Wan是阿里巴巴通义实验室推出的视觉生成服务平台,核心搭载Wan2.1系列开源视频生成模型,面向有视频内容创作需求的用户提供AI生成服务。平台支持文本生成视频、图像生成视频、参考内容编辑等多种生成模式,可输出不同分辨率、风格的动态视频内容,适配商业宣传、内容创作、影视前期概念设计等多个场景。平台降低了AI视频生成技术的使用门槛,普通用户无需部署复杂的本地模型环境,即可在线调用成熟的视频生成能力,创作者也可基于开源模型进行二次开发,适配个性化的业务需求。

aixblock.org
AIxBlock是一个去中心化的AI开发协作平台,面向全球AI开发者、研究人员和项目团队,聚合分布式计算资源、开源AI模型与人类验证服务,支持开发者开展低成本模型训练、数据集标注和模型验证工作,适合小型AI创业项目、学术研究实验以及开源AI协作开发场景使用。平台依托分布式网络架构,打破传统中心化开发平台的资源限制,连接全球范围内的算力提供者、模型开发者和数据标注人员,构建开放的AI开发生态。

glyph-byt5.github.io
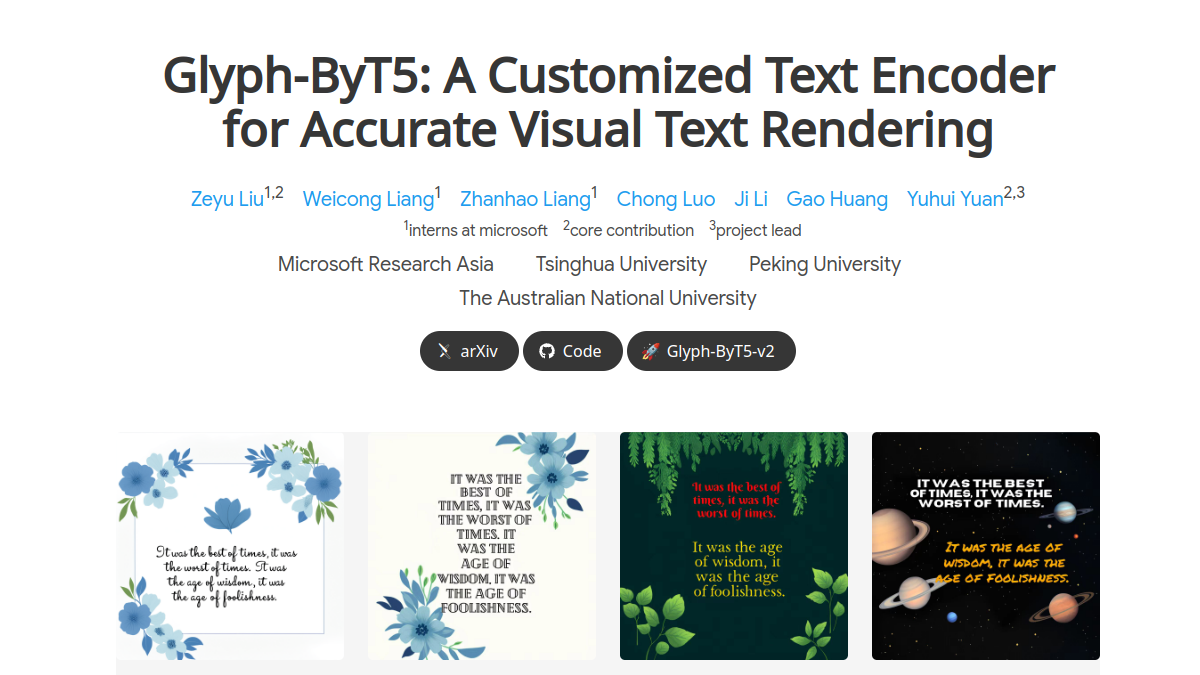
Glyph-ByT5是专注于提升文生图模型视觉文本渲染准确性的定制文本编码器项目官网。核心功能包括字符感知型文本编码优化、SDXL模型集成适配、段落文本自动布局渲染,主要面向AIGC研发人员、平面设计从业者、内容创作者等群体,可应用于海报生成、广告图制作、场景文本合成、多语种图文创作等场景,帮助解决传统文生图模型中文字拼写错误、排版混乱、渲染不清晰等常见问题。
ltx-2ai.com
LTX-2 AI是面向AI视频生成领域的开源项目官网,核心定位是提供支持原生音画同步、可本地部署的开源4K AI视频生成模型。网站主要发布项目更新、模型文档、安装教程与技术交流内容,核心功能包含提供开源模型下载、部署指南文档、技术交流社区入口以及模型效果演示视频。目标用户覆盖AI开发人员、视频内容创作者、开源技术爱好者,适用场景包括在本地搭建个性化AI视频生成环境、研究音画同步AI生成技术、定制化开发视频生成工具等,为开源生态中AI视频生成方向的研究者和实践者提供技术支撑。
together.ai
Together AI是面向开发者的开源生成式AI云平台,核心提供大语言模型与图像生成模型的训练、推理、部署全流程服务。平台支持低延迟的AI模型推理调用、自定义开源模型微调训练、高可用模型生产级部署三大核心功能,主要服务AI应用开发者、算法研究人员、企业技术团队,可应用于AI聊天应用开发、垂直领域模型定制、生成式AI产品落地等场景,帮助使用者降低开源AI模型的落地门槛,提升开发与部署效率。
mask-cond-video-diffusion.github.io
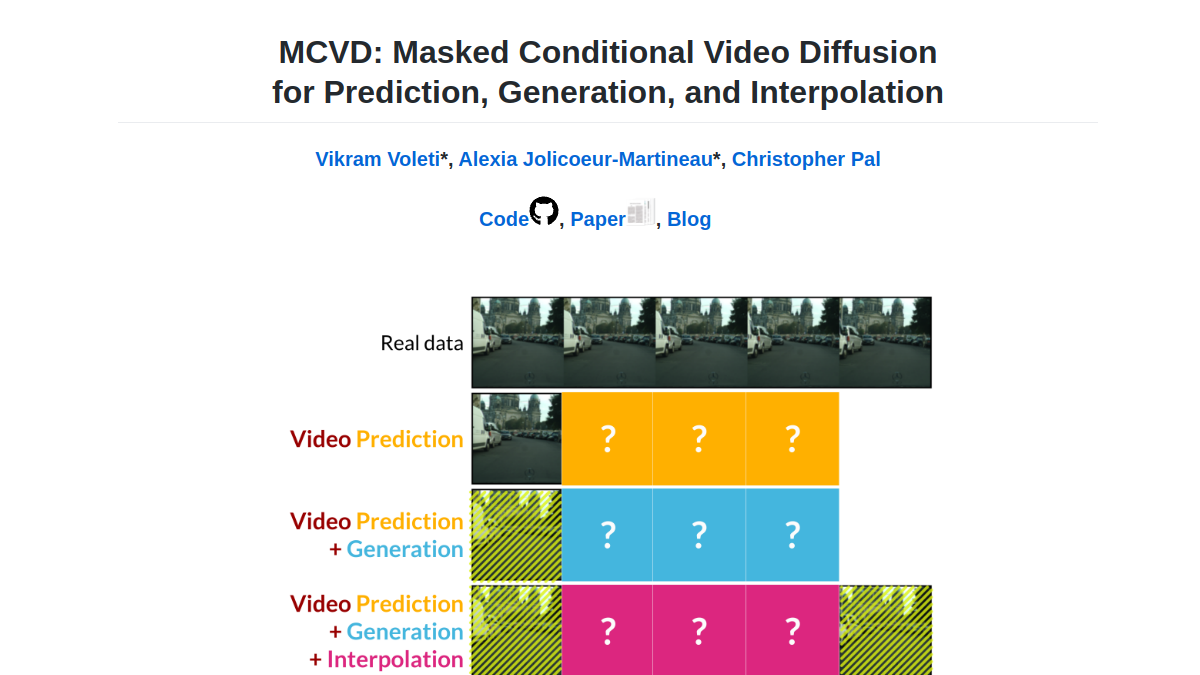
MCVD是专注于视频生成领域的通用扩散模型官方项目站点,核心围绕条件视频扩散技术展开相关研究成果展示与技术说明。站点核心功能包括提供完整的MCVD模型技术原理说明,公开模型训练与推理的代码资源,以及不同场景下的视频生成效果演示样本。该站点面向计算机视觉领域研究人员、视频生成方向开发者、AI生成内容相关从业者,可用于学术研究参考、模型二次开发、视频生成技术落地验证等多种场景,帮助相关从业者深入了解视频扩散模型的技术实现路径与应用效果。
ai.meta.com
SAM 2(Segment Anything Model 2)是Meta推出的视觉分割领域模型项目页面,核心定位为面向全球开发者、研究者的实时图像与视频对象分割技术资源平台。其核心功能包括提供SAM 2模型的完整技术文档、开源代码下载入口,以及配套的SA-V大规模视频分割数据集。目标用户覆盖计算机视觉研究者、AI应用开发者、多媒体内容创作人员等群体,可应用于视频内容智能剪辑、自动驾驶感知模块训练、医疗影像病灶标注、工业缺陷视觉检测等多个场景。页面采用开放科学的发布模式,所有相关资源均在开源许可下开放,无需额外申请即可获取核心技术资料。

genwarp-nvs.github.io
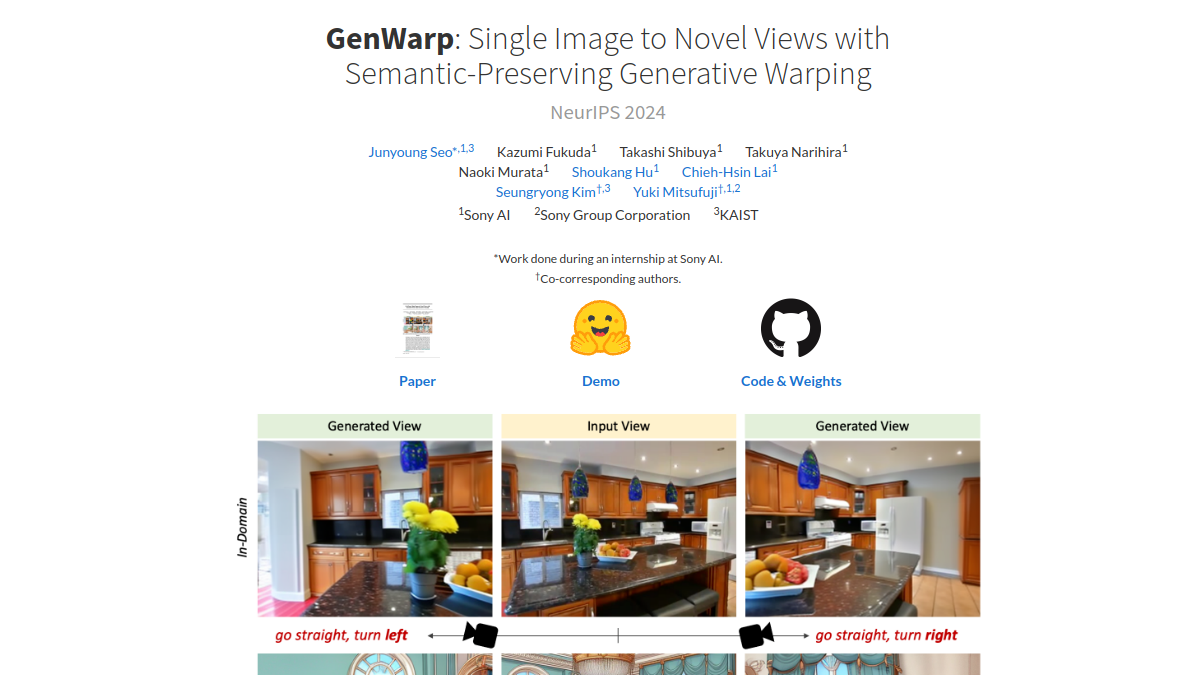
GenWarp是专注于单张图像新视角生成的开源研究项目站点,核心为语义保持的生成变形AI模型,可基于单张输入图像生成不同视角下的合理视觉内容。其核心功能包括单图多视角生成、语义一致性约束、跨领域场景适配三类,支持计算机视觉研究人员、3D内容创作者、AI算法开发者等群体使用,适用于3D建模素材生成、AR/VR内容制作、视图合成算法研究、影视场景补全等多个工作场景,为单视图到多视图的转换需求提供可落地的技术参考与实现方案。
nvlm-project.github.io
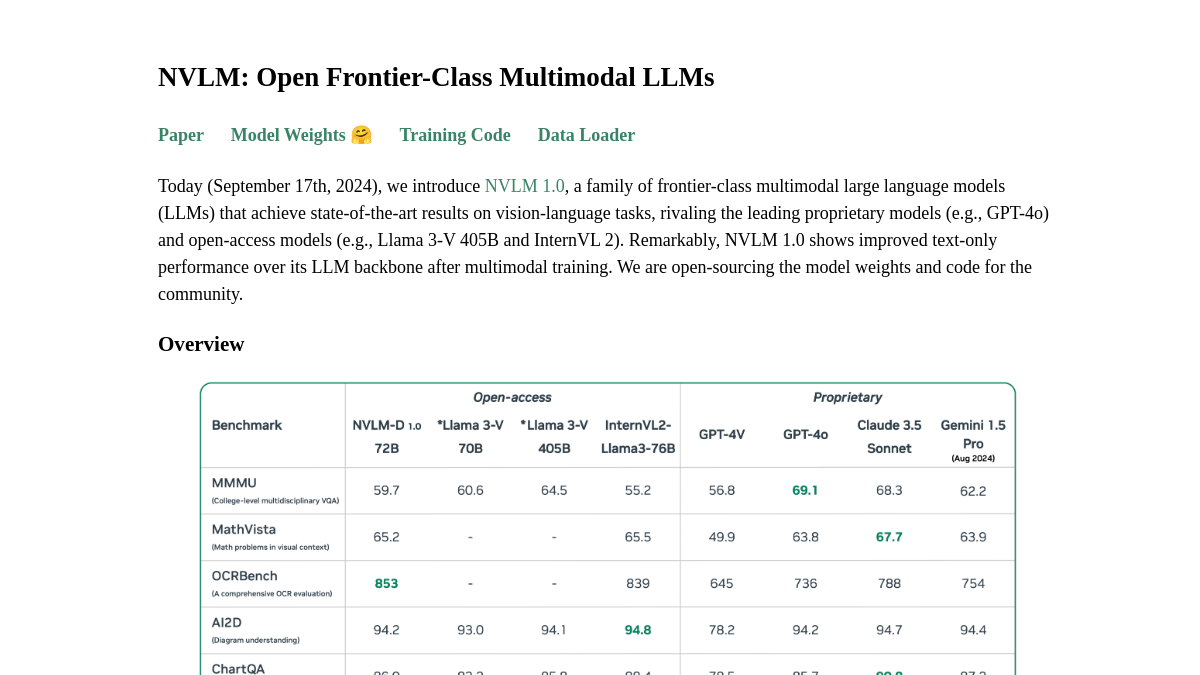
NVLM是一个开源多模态大型语言模型项目站点,核心定位为向学术研究与产业开发群体提供高性能的视觉-语言融合模型资源。项目核心功能包含多模态模型权重开源下载、训练推理代码仓库访问、模型性能基准测试结果公开,同时配套模型适配与二次开发指导文档。目标用户覆盖AI领域研究人员、应用开发工程师、高校相关专业师生等群体,可应用于多模态任务性能对比、定制化视觉理解应用搭建、多模态模型技术原理研究等多个场景,为多模态大模型技术落地与学术探索提供可复用的基础资源。
idkiro.github.io
SDXS是专注于高速图像生成的轻量化扩散模型演示站点,核心定位是为开发者、AI图像从业者提供低延迟扩散模型的在线体验与效果验证服务。核心功能包括实时图像生成演示、不同分辨率模型效果对比、图像到图像翻译效果测试。目标用户覆盖AI算法研发人员、计算机视觉相关专业学生、移动端AI应用开发者等,可用于模型效果验证、技术选型参考、学术研究对比等场景,帮助用户直观了解轻量化扩散模型的运行效率与生成质量平衡能力。

animeart.studio
AnimeArt.Studio是聚焦动漫内容创作的AI生成平台,核心定位为面向动漫创作相关人群的开源模型创作工具。平台搭载大量经过风格预训练的开源AI动漫模型,支持图文生成、多模型并行测试、音视频动漫化创作三类核心功能。目标用户覆盖动漫创作者、同人爱好者、游戏美术人员、内容运营者、学生创作者、动画制作团队等群体,可满足原创动漫角色设计、同人插画产出、动画短视频制作、游戏立绘初稿生成、有声动漫内容制作等多场景使用需求,所有公开模型支持个人及商业项目使用。
ailab-cvc.github.io
VideoCrafter2是由香港中文大学CVC实验室开发的开源视频生成AI模型展示平台,核心定位为文本驱动的高保真视频生成工具。平台支持文本生成照片级视频、精细运动参数控制、多概念组合生成三类核心功能,面向内容创作者、动画从业者、广告设计人员、AI研究人员等群体,可应用于短视频内容制作、动画分镜生成、广告创意预览、AI视频技术研究等多个场景,用户仅需输入文本提示词即可获得对应的动态视频内容。
opencodeinterpreter.github.io
OpenCodeInterpreter是面向开发者群体的开源代码生成系统,核心定位是实现代码生成、执行、迭代优化的全流程闭环处理。系统依托含6.8万段交互的Code-Feedback数据集训练,支持根据代码执行输出、人工反馈动态调整代码逻辑,在HumanEval、MBPP等行业通用代码测试基准上表现优异。该工具面向算法开发人员、普通软件开发者、计算机专业学生等群体,可用于日常功能代码快速生成、代码问题调试修复、算法逻辑验证等场景,帮助使用者降低代码编写的重复工作量,同时为开源代码生成技术的研究和落地提供可参考的实现方案。
ai.meta.com
quantized Llama是Meta官方推出的轻量化大语言模型技术介绍站点,核心围绕Llama系列模型的量化优化方案展开,向开发者展示量化技术如何在保留模型输出质量与安全特性的前提下,降低模型运行的硬件门槛。站点提供量化模型的技术原理说明、不同量化精度的性能对比数据,以及边缘设备部署的参考案例,面向AI应用开发者、嵌入式设备研发人员、移动应用开发者等群体,可在资源受限设备AI应用开发、边缘侧AI功能落地、低功耗AI方案选型等场景下作为技术参考资料使用。
maskgct.github.io
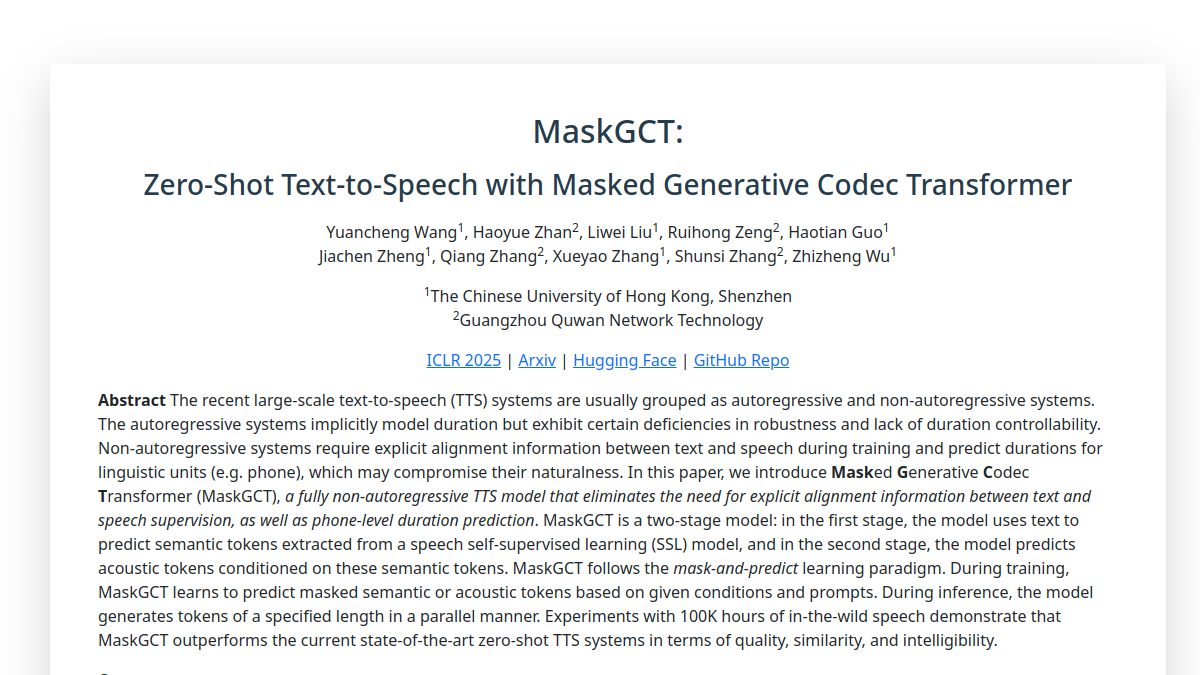
MaskGCT是专注于零样本文本到语音转换的开源技术站点,核心是同名零样本TTS模型的成果展示与技术落地内容。站点提供完整的模型技术原理讲解、官方演示Demo体验、论文研究成果查阅、开源代码仓库跳转等核心功能,面向语音技术研发人员、AI应用开发者、语音内容创作从业者等群体,可用于模型技术调研、语音合成效果验证、相关项目开发参考等场景,帮助使用者快速了解零样本TTS领域的前沿技术路径与实际应用表现。
homebrew.ltd
Llama3-s v0.2是由Homebrew Computer Company开发的多模态模型检查点,核心定位为专注语音理解能力优化的开源模型版本。该模型采用语义标记早期融合技术,可实现更稳定的语音特征提取,同时支持用户通过页面内置的实时演示功能直接上传音频测试识别效果,还提供完整的模型迭代日志与技术原理说明。目标用户覆盖AI语音技术开发者、多模态模型研究人员、语音应用产品经理、相关专业高校学生等群体,可用于语音识别效果验证、多模态模型结构调研、语音应用原型开发测试等多个场景。
outeai.com
OuteTTS-0.1-350M是OuteAI推出的基于纯语言模型的文本转语音合成模型产品页,核心定位为展示低参数轻量型TTS模型的技术方案与应用价值。该模型以LLaMa架构为基础,仅用350M参数即可实现高质量语音输出,支持语音克隆、多格式适配等核心功能,面向AI技术开发者、语音应用开发者、语音技术研究人员、内容创作从业者等群体,可用于语音类产品原型开发、语音技术研究实验、有声内容批量制作、轻量设备语音功能部署等场景,帮助用户降低TTS技术落地的资源门槛。