开源AI项目
modelcontextprotocol.io
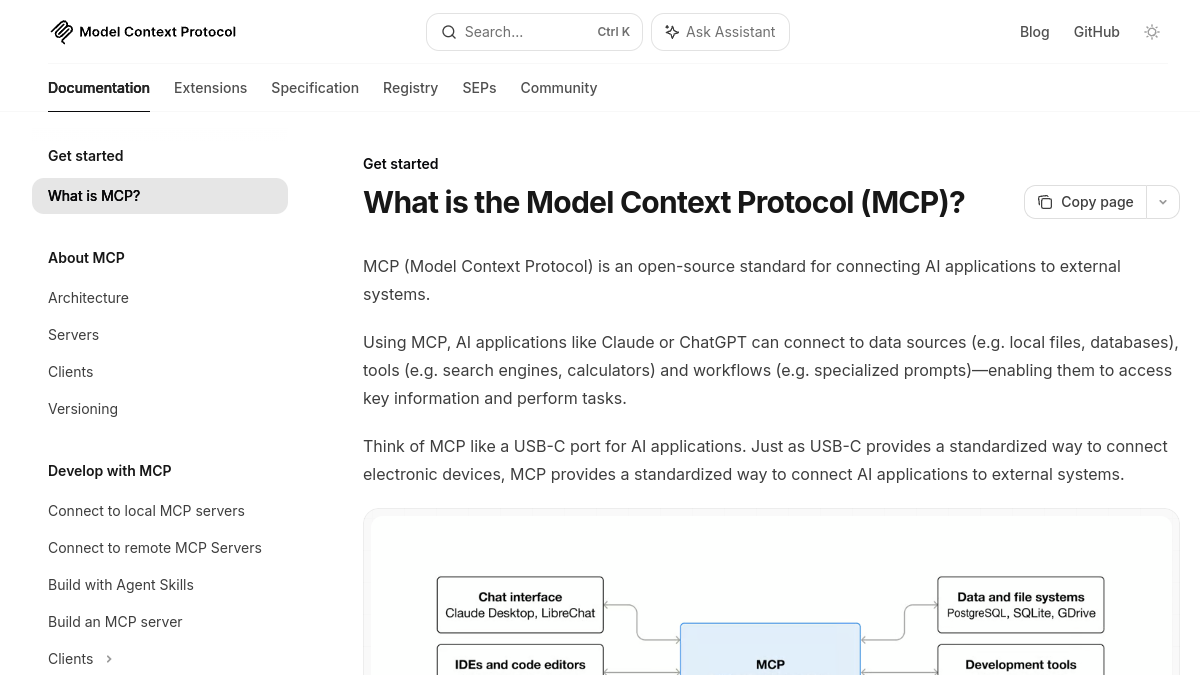
Model Context Protocol(简称MCP)是面向AI开发者的开放协议平台,核心定位为大语言模型与外部资源的标准化连接中间层。平台支持多数据源统一接入能力,提供工具调用标准化接口,内置适配多种主流LLM框架的开发套件。目标用户覆盖AI应用开发工程师、IDE工具开发者、企业AI架构师等群体,可应用于AI驱动IDE开发、智能聊天机器人增强、自定义AI工作流搭建、多数据源LLM上下文注入等场景,帮助开发者降低LLM与外部资源的集成成本,提升AI应用的上下文处理能力。
lijiaman.github.io
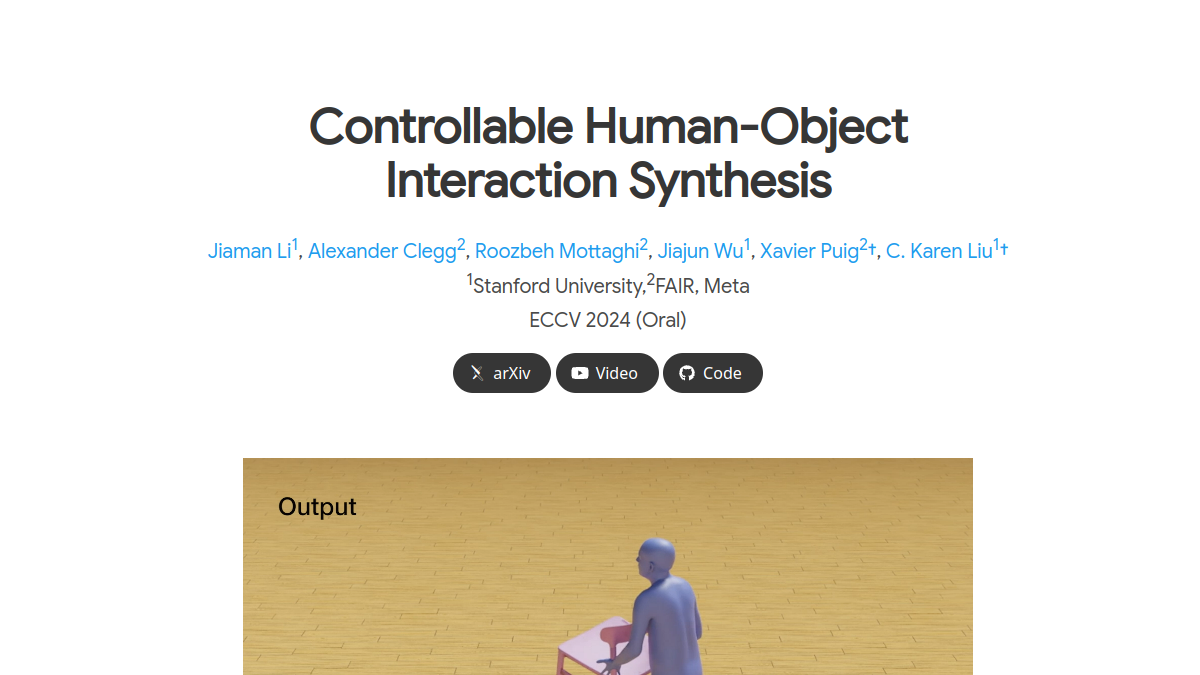
CHOIS全称为Controllable Human-Object Interaction Synthesis,是面向人机交互动作生成领域的开源技术项目,核心定位是可控的人与物体交互动作合成工具。核心功能包括根据自然语言描述生成对应的人与物体协同运动序列、结合初始状态与稀疏路径点约束输出符合物理规则的交互动作、通过接触约束保障手物交互与地面支撑的合理性。目标用户覆盖计算机图形学研究者、游戏动画开发人员、虚拟场景制作从业者、机器人运动规划研发人员等,可应用于3D动画内容制作、虚拟数字人交互动作开发、机器人行为模拟训练、元宇宙场景交互内容搭建等场景,帮助用户降低复杂交互动作的制作与研发成本。
julian-parker.github.io
StemGen是由Julian Parker开发的端到端音乐生成模型演示站点,核心定位为面向音乐创作从业者、AI音频研究者的音乐生成技术展示与体验平台。核心功能包括多场景音乐生成效果演示、不同输入提示下的模型输出对比、技术论文相关资料入口。目标用户覆盖音乐制作人、音频算法工程师、高校音视频研究方向学生、独立音乐人、AI生成内容爱好者、数字媒体创作者。适合用于音乐创作灵感参考、AI音频技术效果验证、学术研究案例参考、内容创作素材试生成等场景,用户可直接在线浏览不同输入条件下的模型生成结果,直观了解该模型的实际表现。

videogigagan.github.io
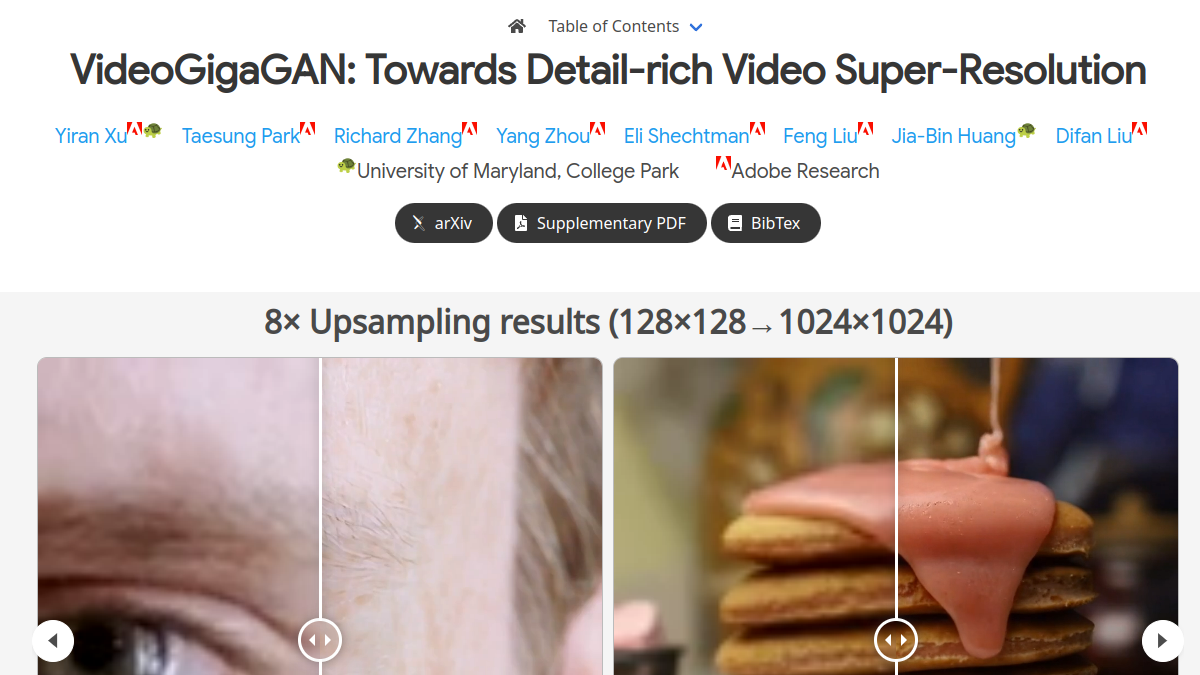
VideoGigaGAN是基于大规模图像上采样器GigaGAN开发的视频超分辨率技术展示平台,核心定位为学术研究成果的可视化演示站点,面向视频处理相关从业者、学术研究人员及内容创作者提供8倍视频超分辨率效果展示与技术原理说明。平台核心功能包括8倍视频超分辨率效果对比展示、技术架构原理可视化讲解、公开数据集基准测试结果查询三个模块,用户可在线查看不同场景下模型处理前后的视频画质差异,了解时间注意力层、特征传播模块等组件的设计逻辑,也可通过基准测试数据对比该模型与同类视频超分辨率方案的性能差异,适合视频修复、影视内容画质提升、旧视频数字化等场景的相关人员参考使用。
chattts.site
ChatTTS是面向开发者与内容创作者的开源文本转语音项目,专注于生成符合真实对话场景的自然语音内容。核心功能包括中英双语语音生成、自定义语音音色调整、批量文本处理,同时开放完整模型源码供开发者进行二次开发。目标用户涵盖内容创作者、AI产品开发者、有声读物制作人、短视频运营者、课程开发者以及学术研究人员,适用于短视频配音、有声书制作、对话式AI产品语音输出、课程音频生成、多角色语音对话制作等多种使用场景,可满足不同用户对自然对话语音生成的多样化需求。
uni-fl.github.io
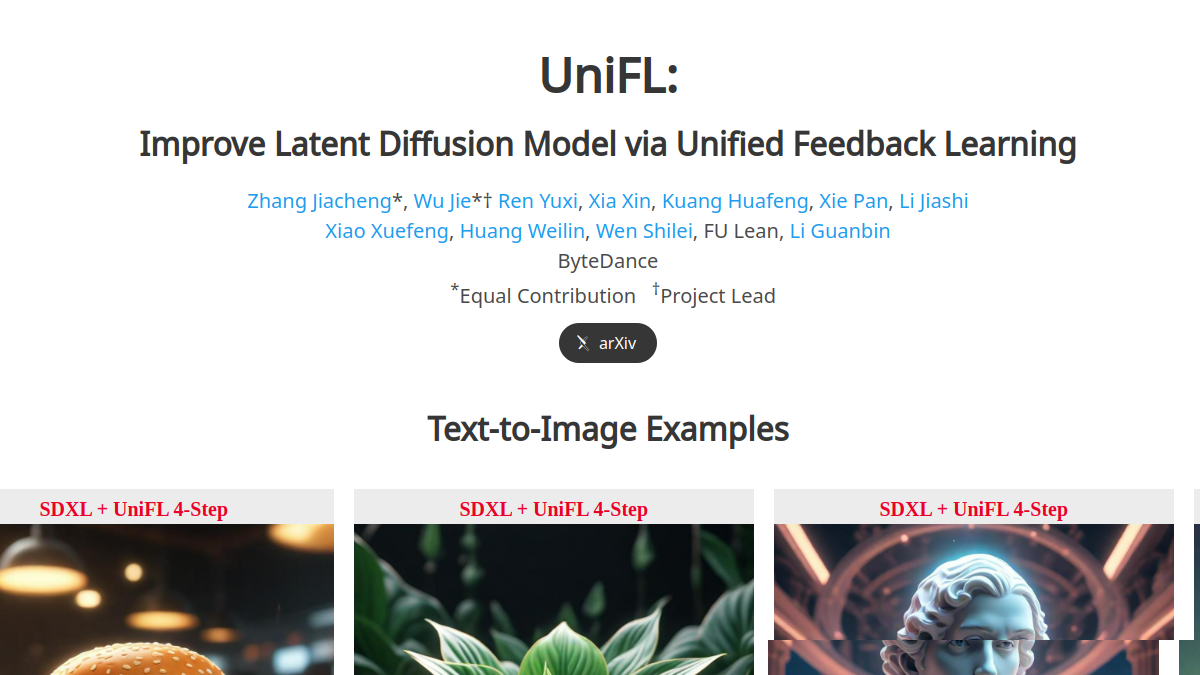
UniFL是一个面向扩散模型优化的技术研究项目,核心定位为通过系统化的反馈学习机制提升生成模型的输出质量与运行效率。项目核心功能包含感知反馈学习模块、解耦反馈学习模块、对抗性反馈学习模块三类,可针对现有扩散模型存在的图像生成精度不足、美学效果不达预期、推理耗时过长等问题进行定向优化。目标用户覆盖AI生成模型研究者、AIGC应用开发人员、计算机视觉方向高校师生等群体,可用于扩散模型性能迭代、文生图应用效果优化、生成模型学术研究实验等多个场景。

gligen.github.io
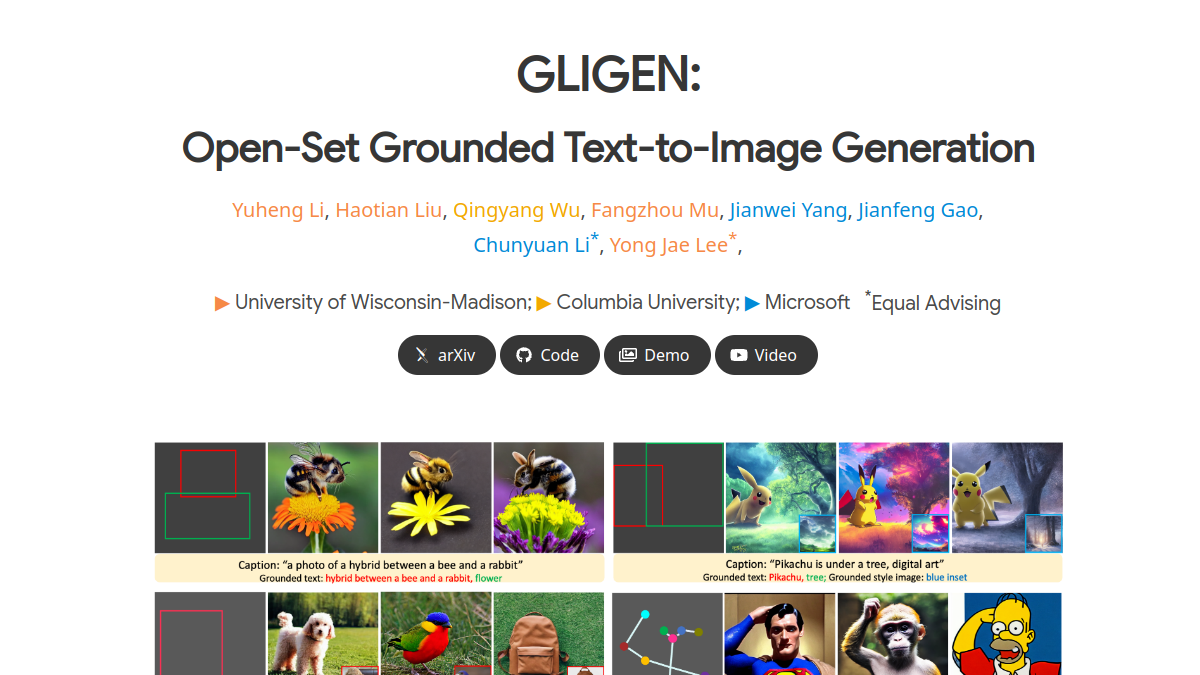
GLIGEN是一款开放式的条件式图像生成学术项目站点,核心为基于扩散模型的可控图像生成技术。用户可结合文本描述与空间边界框、参考图像等条件,生成符合指定布局与内容要求的图像;模型采用模块化训练设计,保留预训练扩散模型的基础生成能力的同时,扩展了空间控制属性。该站点面向AI图像生成研究者、计算机视觉从业者、内容创作人员、设计人员等群体,可用于学术研究验证、可控图像内容创作、多模态模型效果测试、概念设计初稿生成等场景,帮助用户在图像生成过程中实现更精准的内容与布局控制。

iceclear.github.io
SeedVR是专注于视频修复任务的扩散变换器模型演示站点,核心定位是为视频处理相关从业者提供前沿AI视频修复能力的在线体验与技术参考。站点支持任意长度、任意分辨率的受损视频序列修复,搭载移位窗口注意力机制,同时结合因果视频自编码器、混合图像视频训练等技术优化生成效果。目标用户涵盖视频内容创作者、后期制作人员、AI技术研究者、影视资料修复从业者等,可应用于老影视资料画质修复、损坏视频素材修复、低清拍摄视频画质增强、AI视频生成瑕疵修正等多种场景,帮助用户提升视频素材的整体视觉质量。
ella-diffusion.github.io
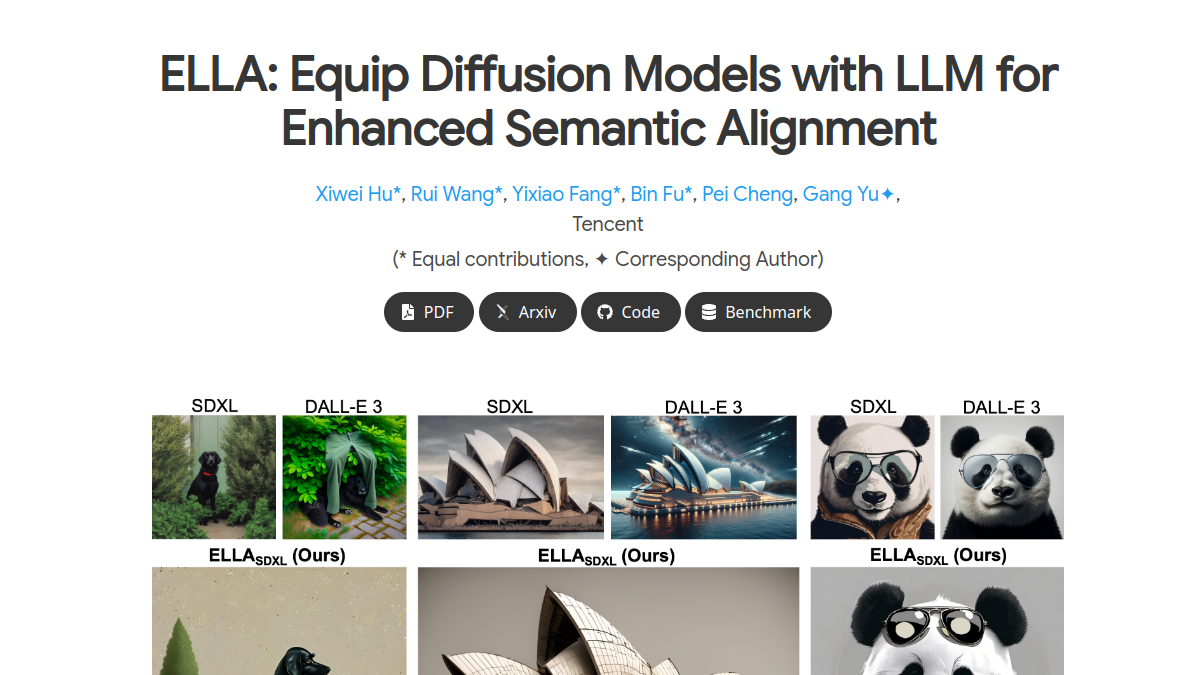
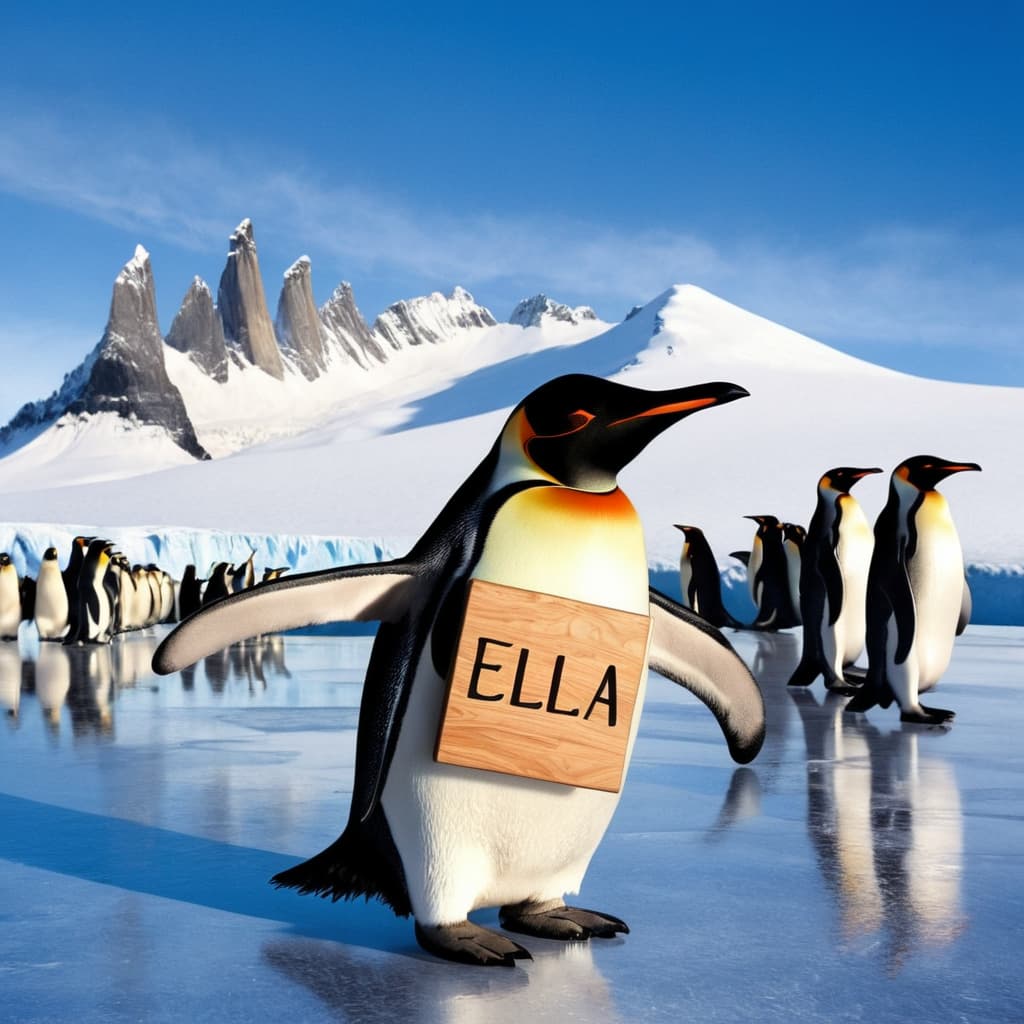
ELLA(Efficient Large Language Model Adapter)是面向文本生成图像领域的技术适配工具,核心定位为轻量级的大语言模型适配组件,可对接现有基于CLIP的扩散模型,为其赋予大语言模型的语义理解能力。核心功能包含时间感知语义连接器(TSC)模块,可根据采样时间步动态调整语义特征输出,同时支持长文本提示解析,能够处理包含多对象、多属性、复杂关系的提示内容,还可实现对原有扩散模型U-Net结构的冻结适配,无需重新训练基础模型。该工具面向AIGC算法研发人员、文本生成图像模型开发者、AI艺术创作者、学术研究人员等群体,适用于优化现有文生图模型的提示跟随效果、提升长文本提示的图像生成准确率、开展文生图语义对齐相关的学术研究等场景。
comosvc.github.io
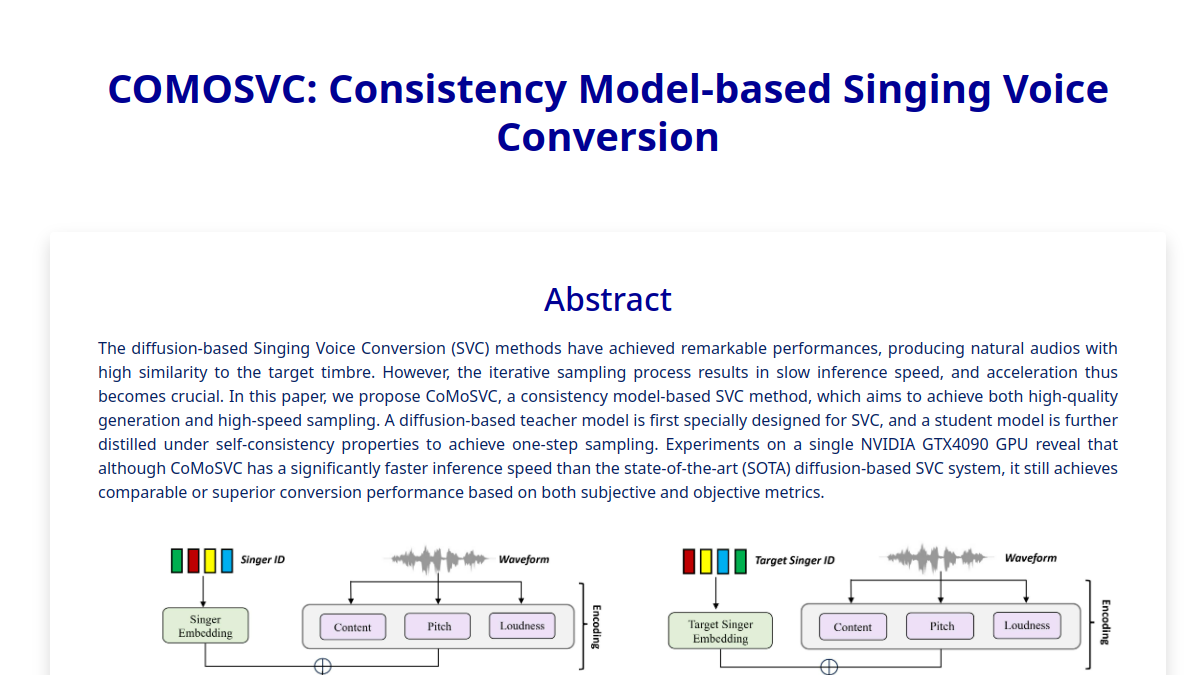
COMOSVC是专注于歌唱音高转换的技术展示与应用站点,核心基于一致性模型相关技术打造,可实现音频的音高转换处理。平台核心功能包括高质量歌唱音高转换、单步快速推理、开源技术方案开放,目标用户覆盖音频技术研究人员、音乐创作从业者、AI音频爱好者、学生开发者等群体,可用于音乐demo制作、翻唱作品调整、语音技术实验、AI音频项目开发等多种场景,帮助用户便捷完成歌唱音频的音高修改与风格适配相关处理。

yu-shaonian.github.io
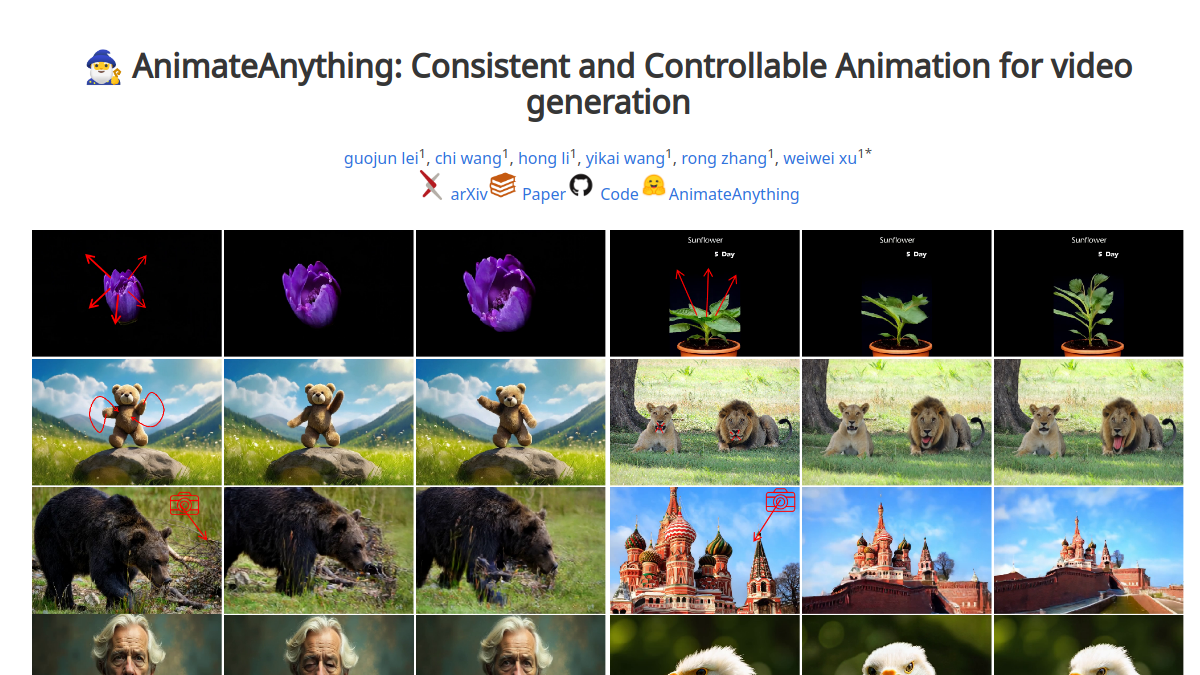
AnimateAnything是聚焦可控视频生成技术的开源项目站点,核心定位是为各类创作场景提供可精准控制的视频生成与编辑技术方案。核心功能包括多条件驱动视频生成、视频运动稳定优化、自定义运动轨迹适配,支持用户根据相机轨迹、文本描述、动作标注等不同维度的输入,生成符合预期的动态视频内容。目标用户覆盖AI视频技术研发人员、影视动画创作者、多媒体设计从业者、计算机视觉方向学生等,可应用于学术研究验证、动画小样快速制作、短视频创意生成、数字人动作生成、3D场景动态化等多个场景,帮助用户实现对视频内容运动逻辑的精细化把控。
felixtaubner.github.io
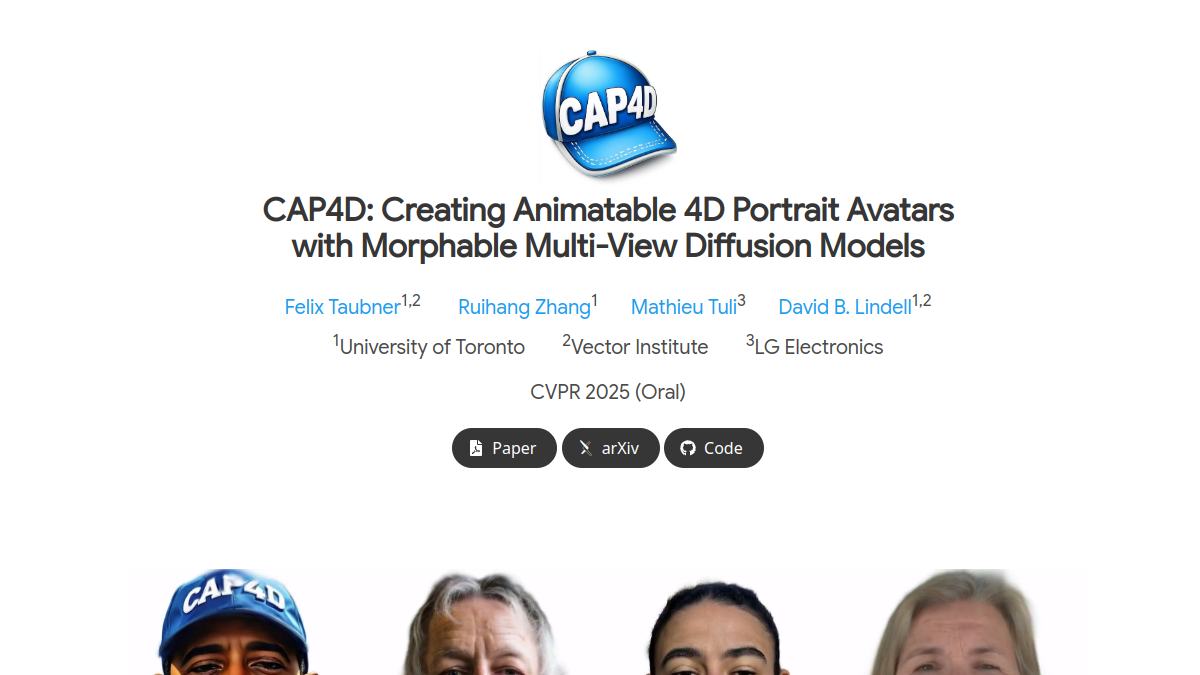
CAP4D是基于可变形多视图扩散模型打造的4D人像化身生成技术平台,核心面向数字内容创作、3D建模相关从业者与研究人员。平台支持多参考图像输入生成不同视角、表情的人像画面,可将生成内容适配为可控4D化身,同时提供开源代码供技术研究与二次开发。用户可在游戏角色制作、虚拟主播形象定制、VR场景数字人搭建等场景中使用该技术,降低4D数字人创作的技术门槛,提升数字人建模的还原度与渲染效率。

map-yue.github.io
YuE是由香港科技大学联合多模态艺术投影团队开发的开源音乐生成平台,核心定位为歌词到完整歌曲的AI生成工具。平台支持上传或输入歌词内容,一键生成最长5分钟包含人声、伴奏的完整音乐作品,适配多种语言与主流音乐风格,同时提供参数调节功能满足个性化创作需求。目标用户覆盖独立音乐人、内容创作者、音乐爱好者以及教育领域从业者,可应用于原创歌曲Demo制作、短视频配乐生成、音乐教学演示、个人兴趣创作等多种场景,所有核心能力基于开源模型搭建,支持开发者二次扩展适配更多定制化需求。
misya11p.github.io
AMT-APC是一个基于自动音乐转录技术的钢琴封面生成项目站点,核心定位是为音乐相关从业者和爱好者提供学术成果落地的音乐转换工具。站点核心功能包括在线钢琴封面生成、模型训练原理展示、数据集与研究资料下载,目标用户覆盖音乐创作者、编曲从业者、音乐学术研究者、AI音乐技术开发者、钢琴学习者等群体,可用于音乐创作过程中的钢琴版本改编参考、学术研究中的模型效果验证、AI音乐技术开发的基础框架参考、钢琴学习时的演奏版本参考等场景。

chenguolin.github.io
DiffSplat是面向3D内容创作领域的技术展示与资源平台,核心展示基于扩散模型与3D高斯溅射结合的3D生成技术,支持从文本提示、单视图图像生成符合3D空间一致性的高斯点云模型。平台提供完整的技术论文、生成效果演示、代码部署指引与训练数据集参考,核心功能包含3D生成效果交互预览、技术原理可视化解析、开源代码对接说明、生成参数调整演示、多场景效果样例展示。目标用户覆盖计算机视觉研究人员、3D内容开发工程师、游戏建模从业者、动画制作人员、XR内容创作者等,可用于学术研究中的3D生成技术实验、小型3D资产快速原型制作、元宇宙场景批量3D元素生成、游戏道具快速初稿建模、动画场景辅助素材制作等多种场景。

finityalpha.com
OpenVoiceChat是基于Apache-2.0许可的开源语音对话平台,核心定位是成为封闭商业语音AI产品的开源替代方案,支持用户通过自然语音与各类大型语言模型实现实时交互。平台支持接入Whisper等多种语音识别模型、ElevenLabs等多类文本转语音模型,以及GPT系列、 Llama系列等主流大语言模型,支持自定义模型参数配置。目标用户包含AI开发人员、语音交互产品爱好者、个人学习者、小团队开发者、教育技术从业者等,可用于快速搭建语音AI对话系统、开发语音交互原型、语音AI相关学习实践、离线语音交互方案部署等场景。
liming-ai.github.io
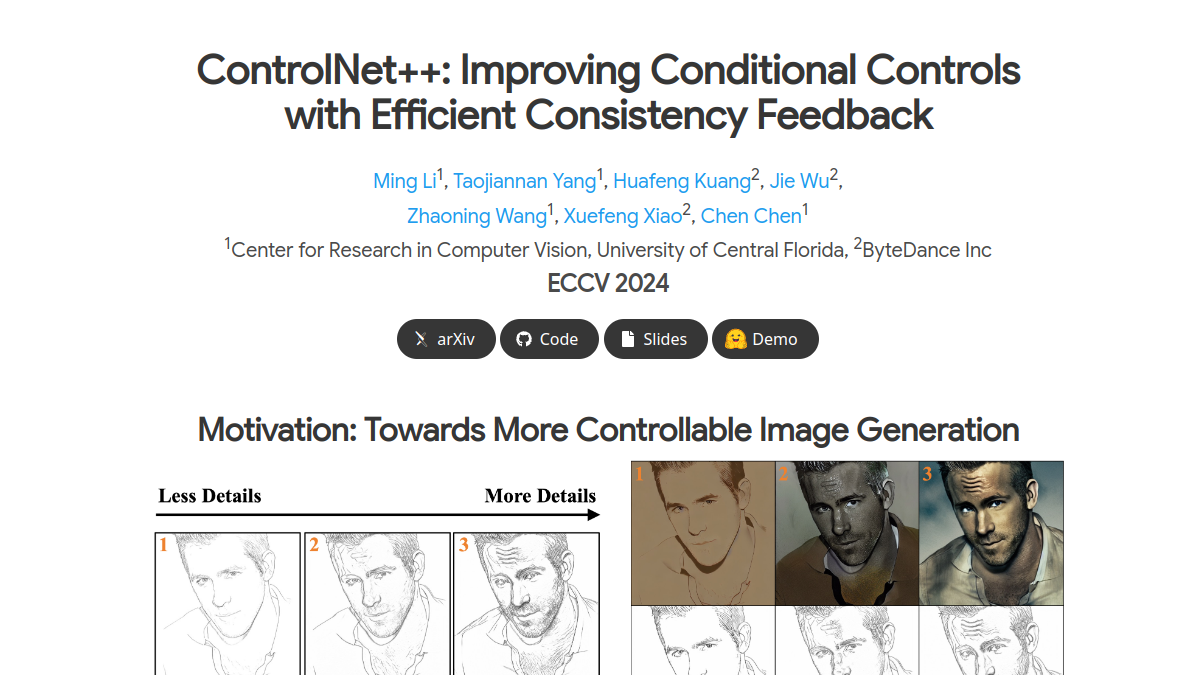
ControlNet++是基于扩散模型开发的条件图像生成研究项目官网,核心定位是提升文本生成图像过程中的条件控制精准度。项目核心功能包括像素级循环一致性优化机制,可缩小生成图像与输入控制条件的偏差;支持单步去噪奖励微调策略,降低模型训练过程中的资源消耗;适配多种常见图像控制条件,覆盖姿态、深度、边缘等不同控制维度。目标用户为AI图像生成领域的研究人员、算法开发工程师、AIGC应用开发者,可用于学术研究中对比可控生成效果、工业场景下优化图像生成模型的控制精度、定制化AI绘图工具的底层能力迭代等场景。

boximator.github.io
Boximator是由Jiawei Wang、Yuchen Zhang等开发者推出的智能视频合成工具,核心定位是为用户提供可控性更强的AI视频生成服务。核心功能包括盒子约束运动控制、文本提示视频生成、自定义运动轨迹调整三类,支持用户通过划定物体框选范围、搭配文本描述的方式,精准控制视频内物体的运动路径、呈现形态。目标用户覆盖视频创作者、AI技术研究者、动画设计人员、内容运营从业者等群体,适用场景包括短视频内容制作、动画概念demo输出、AI生成视频技术实验、创意广告素材产出等,能够帮助用户降低视频创作的操作门槛,提升运动控制的精准度。
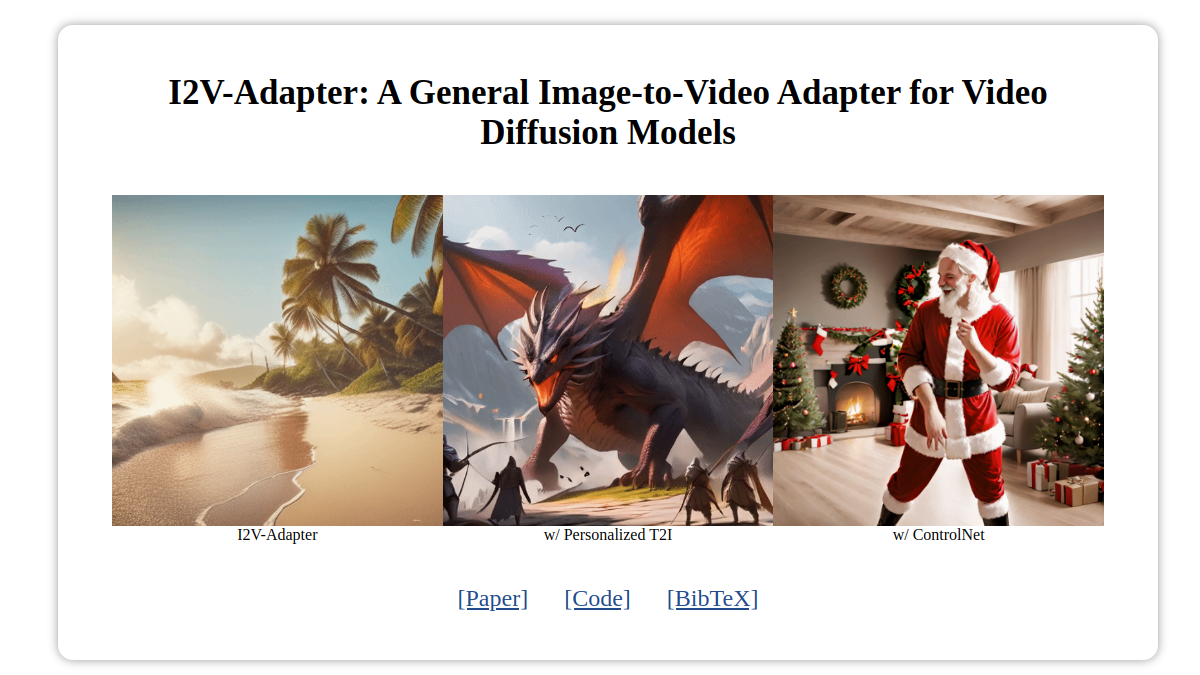
i2v-adapter.github.io
I2V-Adapter是一款专注于静态图像转动态视频的AI技术演示与应用工具站点,核心定位为图像到视频转换的轻量化适配解决方案。站点核心功能包括:提供基于适配器架构的图像转视频生成服务,支持保留原图像空间细节的高保真视频输出,兼容现有主流文本生成图像模型及控制工具。目标用户覆盖AI内容创作者、视频制作从业者、计算机视觉研究人员、数字艺术创作者等,可应用于创意短视频制作、静态插画动态化、影视前期概念演示、学术研究效果验证等多类场景,无需改动原有T2I模型结构即可实现视频生成能力拓展。

spright-t2i.github.io
SPRIGHT是聚焦空间关系的视觉语言数据集与模型项目网站,核心为解决AI图像生成中空间关系表达偏差的行业问题。平台提供覆盖600万张图像的公开数据集下载入口,支持空间一致性生成效果的在线演示对比,还开放微调后的模型推理接口。目标用户涵盖计算机视觉领域研究人员、AI图像生成算法开发者、多模态大模型训练从业者,可用于学术研究数据支撑、图像生成模型空间能力优化、多模态模型训练数据集补充等场景。


embodied-generalist.github.io
LEO是基于大型语言模型开发的多模态多任务具身智能代理项目官网,核心定位为面向3D环境交互的通用AI研究成果展示平台。平台支持3D视觉语言对齐技术演示、3D具身任务效果展示、相关训练数据集信息查询三类核心功能,主要面向AI研究人员、机器人开发从业者、高校计算机相关专业师生三类用户,可用于3D具身智能技术调研、多模态AI模型性能参考、机器人任务规划方案设计等场景。项目公开了两阶段训练框架的技术细节,以及在3D字幕生成、3D场景问答、具身导航、机器人操作等多个任务中的实验结果,为相关领域的技术研发提供参考依据。
miso-one.com
Miso One是一个提供开源8B参数AI文本转语音模型的平台,专注于生成富有表现力的英文语音内容。平台核心功能包括在线语音生成体验、模型参数查看下载、自定义语音设置、多风格语音预览以及开源项目社区交流,面向AI开发者、内容创作者、语音交互研究者等用户,可用于生成英文播客配音、语音读物音频、AI助手语音训练数据、视频旁白等不同场景的语音内容,支持用户在线体验模型效果,也可获取模型文件进行本地部署开发。
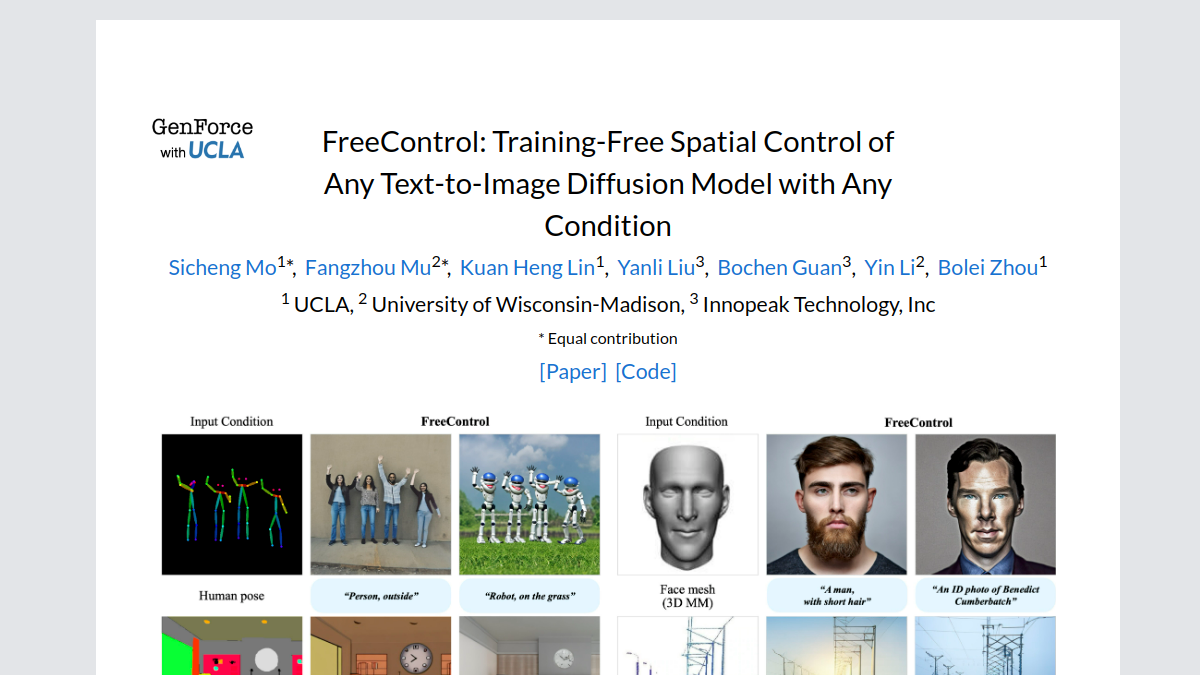
genforce.github.io
FreeControl是由GenForce团队推出的文本到图像生成控制工具,核心定位为无需额外训练即可实现多维度图像生成管控的技术方案。核心功能包括结构引导对齐,可参考指定图像的空间布局、物体位置关系生成符合描述的新图像;外观共享功能,使用相同种子生成的不同内容图像可保持一致的纹理、色彩风格;同时支持适配多种主流文生图模型架构与预训练权重。目标用户覆盖AI图像创作者、计算机视觉研究人员、设计从业者等群体,可用于批量生成风格统一的设计素材、调整文生图输出的构图合理性、开展文生图控制机制相关的学术实验等场景。
diffusekrona.github.io
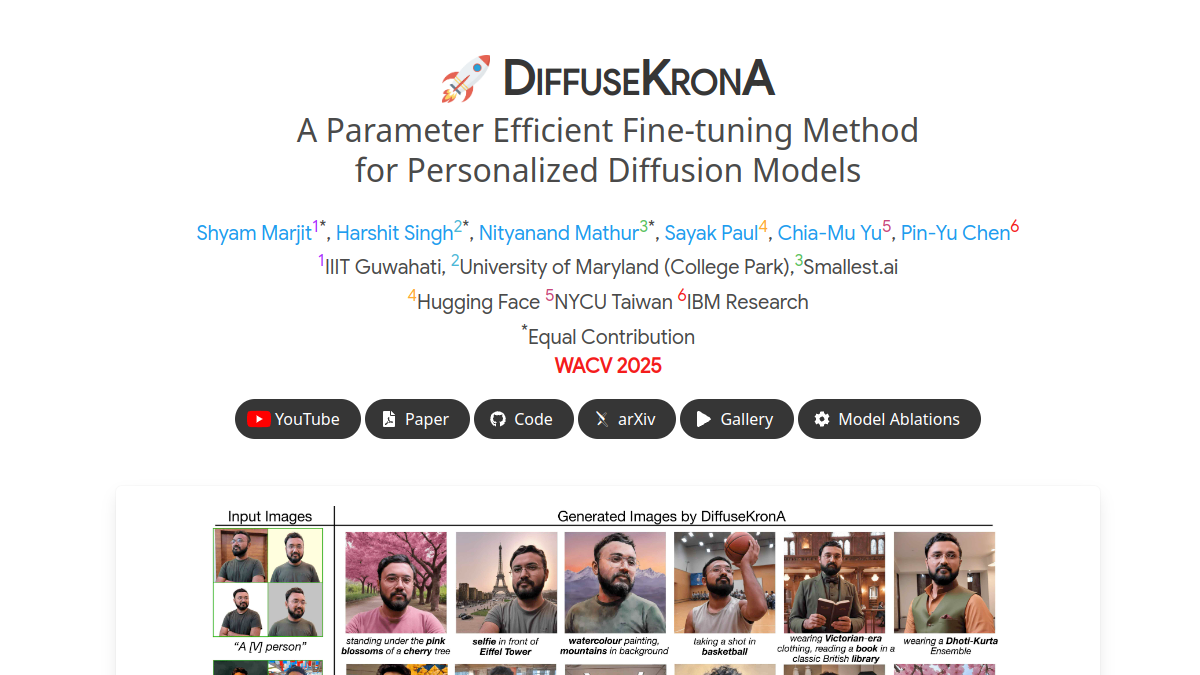
DiffuseKronA是聚焦参数高效微调技术的学术项目站点,核心定位为个性化扩散模型微调方案的成果展示与资源分发平台。站点提供完整的算法原理详解、可运行的代码仓库入口、多场景实验对比数据,支持研究人员快速复现文本到图像生成的微调效果。目标用户覆盖AI生成图像领域的学术研究者、算法开发工程师、高校计算机相关专业师生,可用于学术论文实验验证、扩散模型落地项目优化、课程实践作业开发等场景,帮助用户在有限计算资源下完成扩散模型的个性化适配,同时保障图像合成的输出质量。
pixart-alpha.github.io
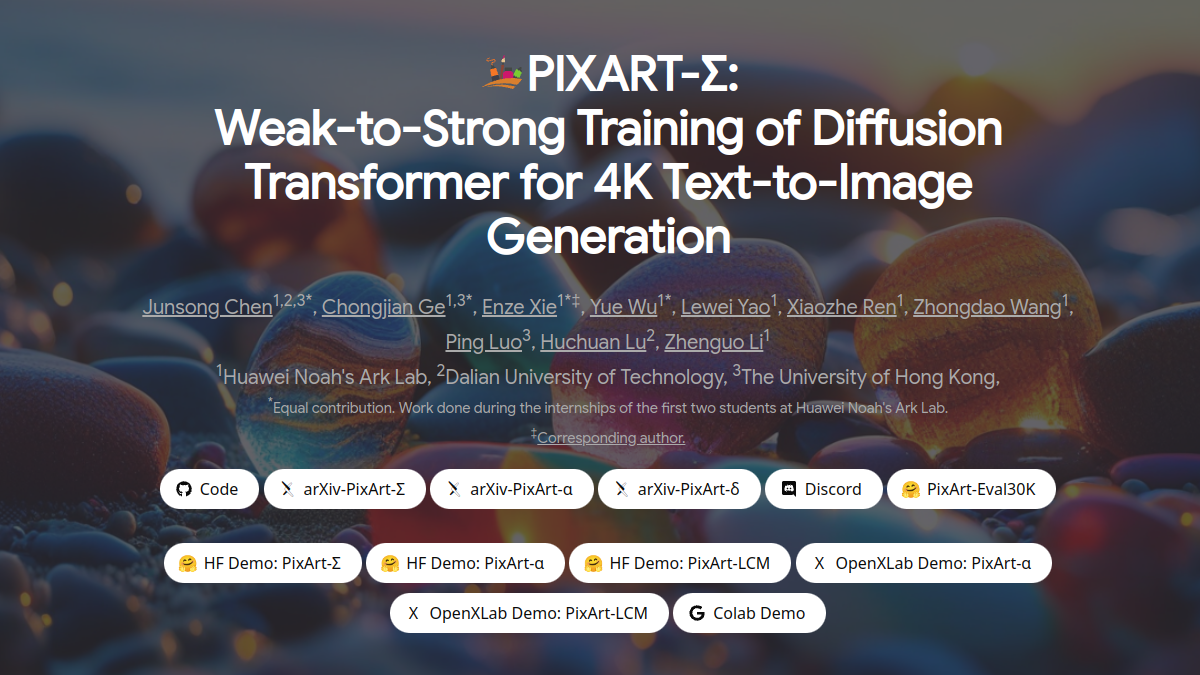
PIXART是面向文本到图像生成领域的开源项目站点,核心展示并提供PIXART-Σ扩散变换器模型的相关资源。该模型主打4K分辨率图像生成能力,支持用户通过输入自然语言描述生成对应视觉内容,同时提供完整的模型部署教程、预训练权重下载及效果演示案例。站点目标用户涵盖AI图像生成研究者、计算机视觉方向开发者、数字内容创作者等群体,可用于学术研究验证、创意图像产出、模型二次开发等多个场景,为文本到图像生成技术的落地与迭代提供开源技术支撑。
enriccorona.github.io
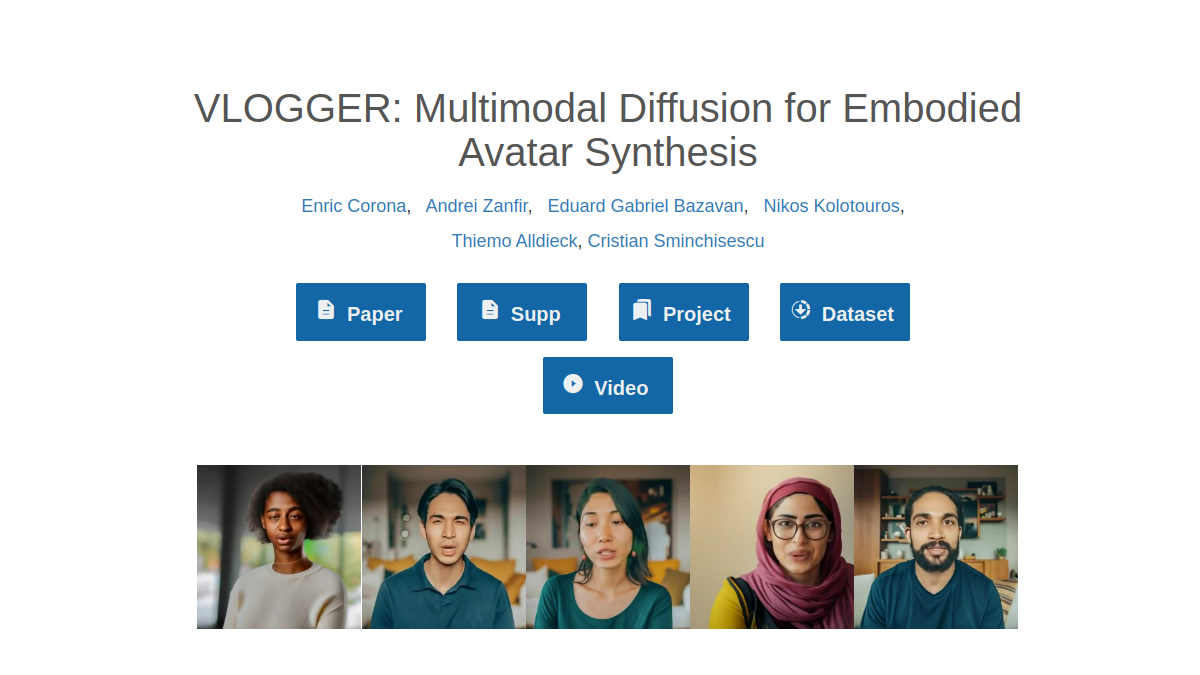
VLOGGER是基于扩散模型的AI人物视频生成工具,核心定位是通过单张人物图像结合文本、音频驱动,生成可控的人物讲话视频。核心功能包括单图驱动的3D人体运动生成、时序可控的视频扩散渲染、面部与肢体动作联合调控三个模块。目标用户覆盖视频创作者、多媒体内容开发者、数字人从业者、高校AI研究人员等群体,可用于短视频内容生产、数字人直播素材制作、学术研究效果验证、虚拟形象内容产出等场景,无需针对单个人物单独训练模型,即可输出包含完整人体姿态的长时长生成视频。
boheumd.github.io
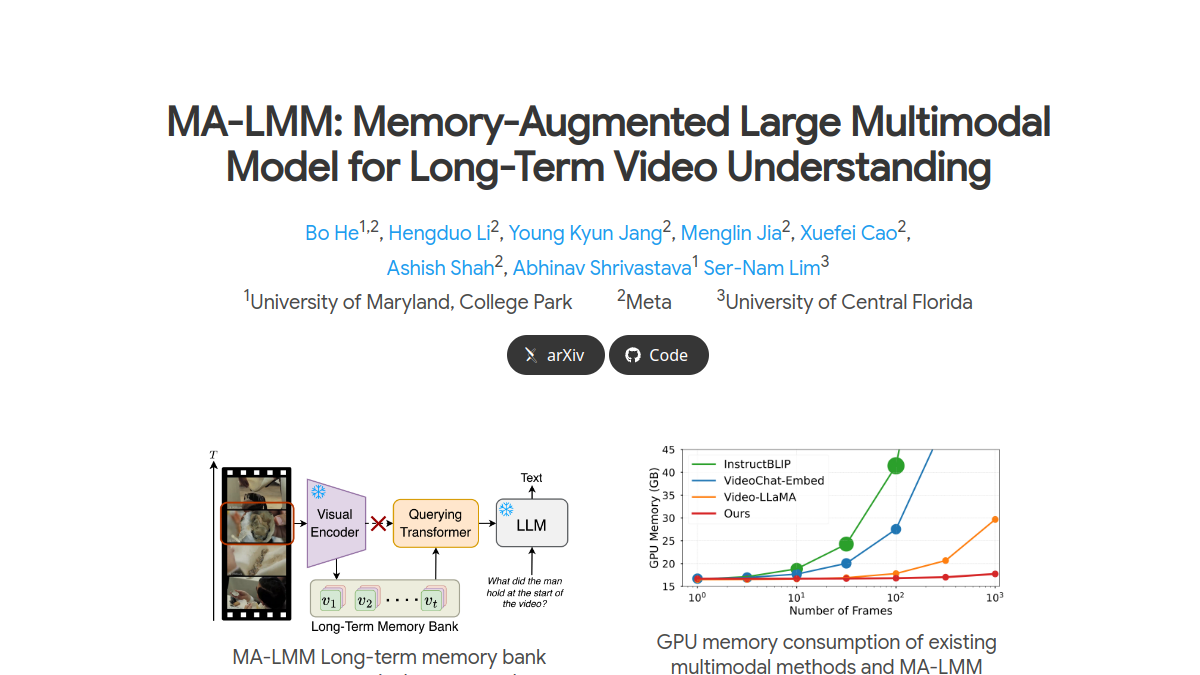
MA-LMM是面向长期视频理解场景的大规模多模态模型项目官网,核心定位为突破大语言模型上下文与GPU内存限制,实现长时序视频的高效分析处理。核心功能包括在线流式视频处理、跨时长记忆库调度、现有多模态大模型无缝适配三类,支持用户在长视频问答、智能字幕生成、视频内容检索等任务中调用相关能力。目标用户覆盖计算机视觉研究人员、视频平台技术开发人员、AI应用开发者等群体,可满足学术实验验证、工业级视频分析功能落地、多模态应用功能迭代等多场景使用需求。
bosch-ai.com
Bosch Center for Artificial Intelligence是博世集团旗下的人工智能研究与应用平台,聚焦人工智能技术在工业、汽车、物联网、能源等多个领域的基础研究与落地应用开发。平台核心功能包括前沿研究成果公开分享、开源AI项目代码发布、行业合作需求对接、AI人才招聘信息披露、技术白皮书与报告下载等,面向人工智能领域研究者、工业场景开发者、科技行业从业者、高校相关专业学生以及博世业务合作伙伴开放,可用于获取全球AI产学研融合动向、下载工业级AI开源工具、对接跨领域技术合作项目、了解AI技术在实体产业的落地实践路径。

openplugin.io
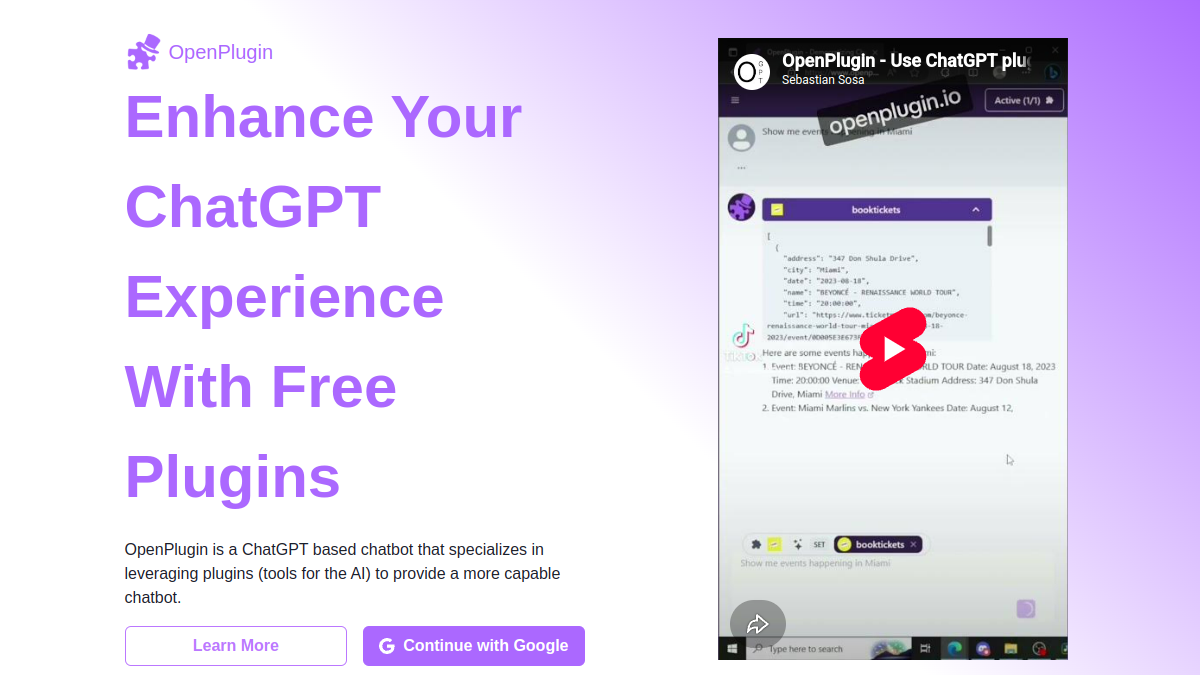
OpenPlugin是专注于大语言模型插件生态的开源服务平台,核心定位是降低ChatGPT等大语言模型插件的开发与使用门槛,帮助用户拓展AI工具的应用边界。平台提供插件集市检索、一键接入适配、开发文档支持、插件效果测试、跨模型兼容调度五大核心功能,面向大语言模型使用者、AI应用开发者、企业技术团队等群体,可满足个人用户拓展AI对话能力、开发者快速迭代插件产品、企业搭建专属AI工具矩阵等多场景需求。
llava-vl.github.io
LLaVA-Video是专注于视频领域的大型多模态模型项目,核心定位为通过指令调优提升视频理解与推理能力。核心功能包括构建高质量视频指令调优数据集LLaVA-Video-178K,覆盖多类视频理解任务;支持开放式问答、多项选择问答、细粒度视频描述等多场景推理;提供模型基准测试结果与训练方案参考。目标用户覆盖AI研究人员、多模态模型开发者、视频内容分析从业者等,可用于学术研究实验、视频分析工具开发、多模态模型迭代优化等场景,为视频方向的多模态技术落地提供数据与模型参考。
oahzxl.github.io
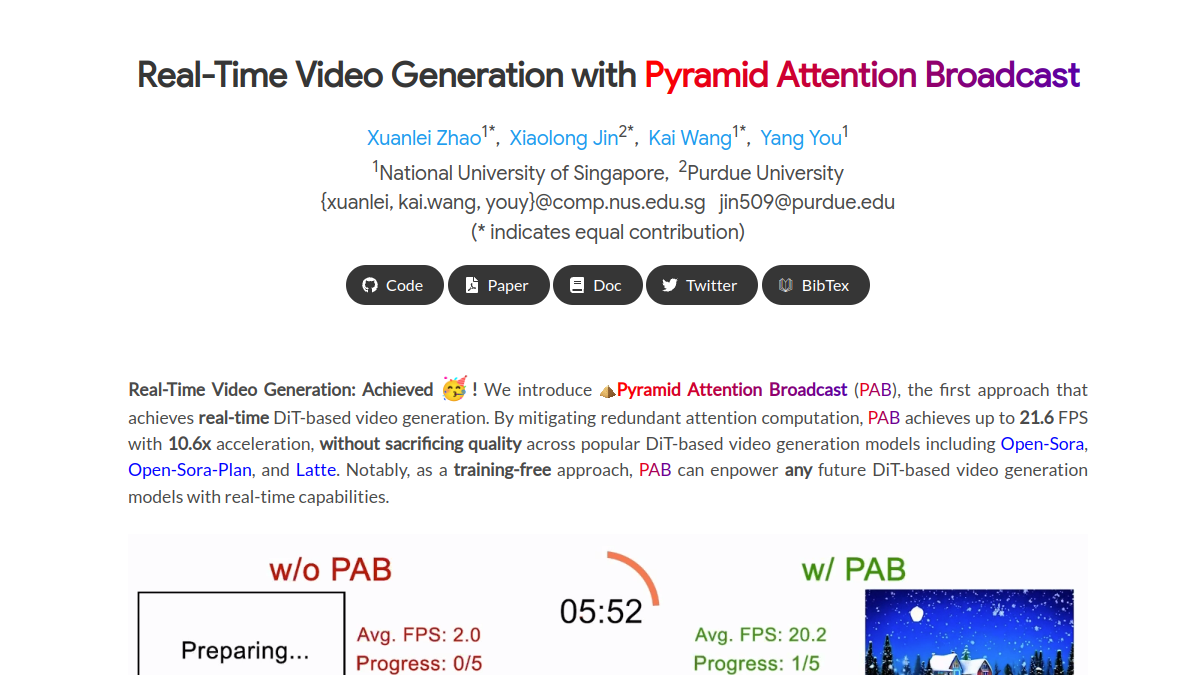
PAB是基于Pyramid Attention Broadcast技术打造的实时视频生成加速工具站点,核心面向视频生成领域的开发者与研究人员提供高效的视频生成加速解决方案。站点核心功能包括核心技术原理展示、在线效果演示、开源代码获取通道,可帮助用户快速理解金字塔注意力广播机制的运行逻辑,直观对比传统视频生成方案与PAB加速方案的生成效率与画质差异,直接获取可部署的实现代码。适用于AI视频生成模型研发、实时视频应用落地、视频生成技术学术研究等场景,能够降低实时视频生成的算力消耗,提升生成帧率,同时保障输出视频的内容质量。
eccv2024tcan.github.io
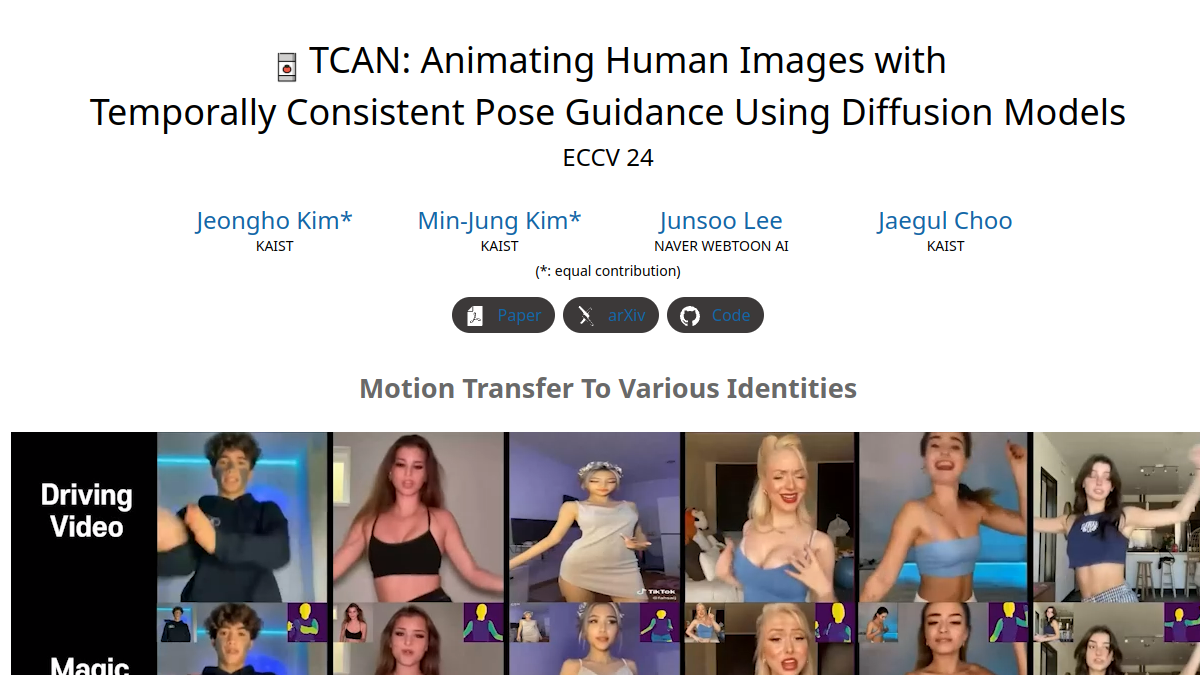
TCAN是ECCV 2024收录的基于扩散模型的人像动画学术项目官网,核心定位是面向研究人员和开发者的时间一致性人像动画技术展示与资源平台。核心功能包括框架技术细节公开、效果演示视频展示、论文源码与预训练模型下载。目标用户覆盖计算机视觉领域研究人员、AI动画开发工程师、数字内容创作者、高校相关专业师生。可用于人像动效生成研究、虚拟数字人驱动开发、短视频内容二次创作、学术复现实验等多种场景,帮助用户了解该框架在跨域人像动画生成中的时间一致性保持能力,获取完整的技术落地参考资源。
jnjaby.github.io
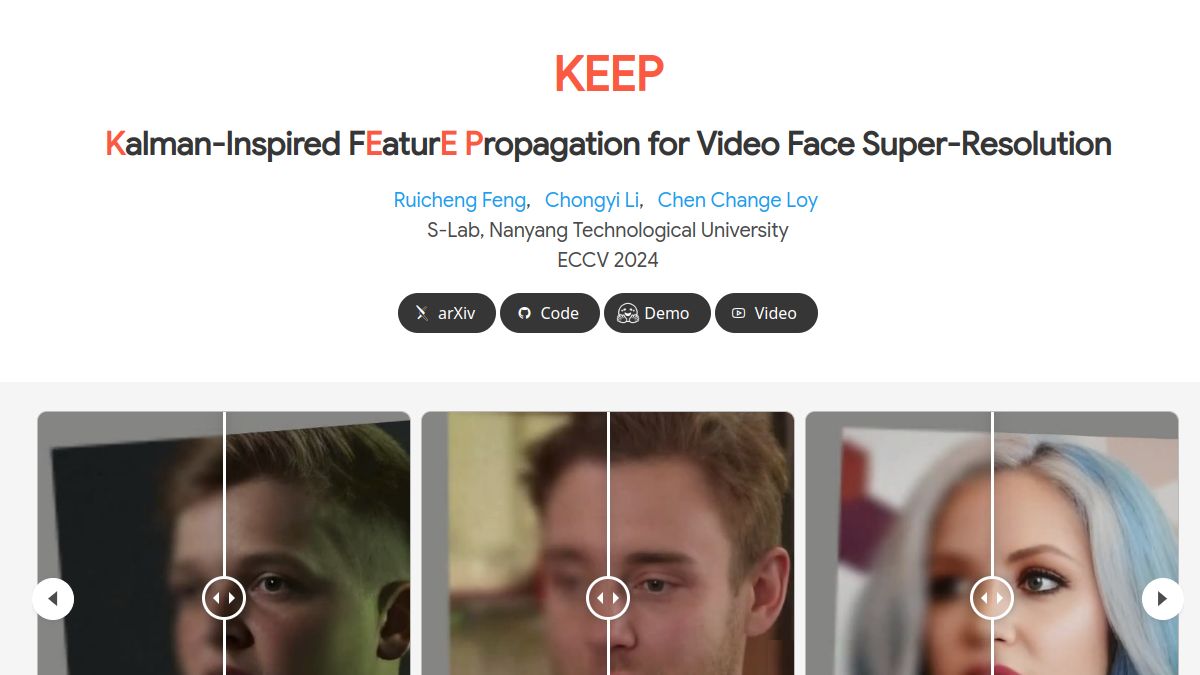
KEEP是基于卡尔曼滤波原理的视频人脸超分辨率框架项目网站,核心定位是为计算机视觉领域研究者提供稳定的视频人脸超分辨率实现方案。核心功能包括基于特征传播的时间稳定人脸先验保持、多帧人脸信息融合的高分辨率人脸重建、可复现的模型训练与推理 demo 演示。目标用户覆盖人工智能研究者、视频修复开发者、数字媒体处理从业者,可用于监控视频人脸增强、老视频人脸画质修复、影视素材人脸细节优化等场景。
zhongshsh.github.io
CLoT是一款聚焦大型语言模型创意能力探索的交互工具,核心定位为帮助用户直观感知大语言模型的创意输出边界。其核心功能包括幽默内容定向生成、发散性创意任务响应、交互过程可追溯记录三类,用户可通过简单的prompt输入触发对应输出。主要面向AI技术爱好者、内容创作者、高校AI相关专业学生、产品研发人员等群体,可用于日常创意灵感收集、大模型能力测试实验、教学演示场景互动、创意类内容辅助生产等多个场景,无需复杂的技术配置即可快速上手体验。
lmsys.org
Vicuna是由LMSYS(Large Model Systems Organization)团队开发的开源大语言对话模型,基于LLaMA架构在用户共享的真实对话数据上微调训练而成。核心功能包括可本地部署的开源对话交互能力、多轮对话上下文理解能力、轻量化微调适配能力。目标用户覆盖AI研究人员、大模型应用开发者、开源技术爱好者、高校科研团队等。使用场景包括学术研究中的大模型效果对比、轻量化对话应用原型开发、本地化隐私友好型聊天工具搭建、大模型微调技术教学实践等,所有代码、模型权重及在线演示支持非商业场景使用。

pmrf-ml.github.io
Posterior-Mean Rectified Flow(简称PMRF)是面向计算机视觉领域的图像恢复算法项目官方网站,核心定位为学术研究与技术应用落地的展示载体。平台围绕后验均值整流流图像恢复算法,搭建了系统化的内容与资源体系,不仅提供完整的算法原理说明、论文原文下载、开源代码资源,还上线了多场景测试数据集、直观的效果对比演示工具,以及工业场景部署参考方案。平台既支持计算机视觉领域的研究人员快速复现实验结果、开展后续相关研究,也可为工程技术人员的算法落地应用提供参考,打通学术研究成果与产业实际需求的对接路径。
jdh-algo.github.io
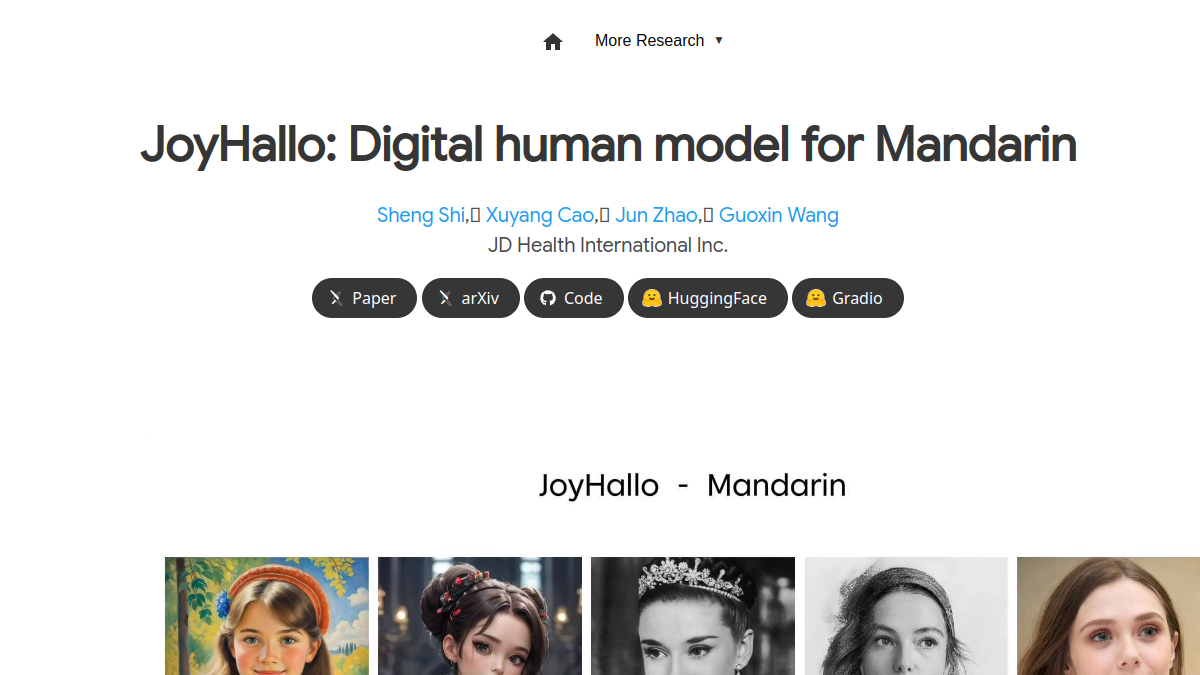
JoyHallo是专注于数字人视频生成的技术项目,核心定位为面向多场景的普通话数字人生成解决方案。项目基于29小时真实场景普通话视频数据集训练,可实现音频驱动的唇部动作同步生成,支持医疗等垂直领域话术的数字人内容输出,同时具备跨语言视频生成能力。目标用户覆盖内容创作者、医疗科普机构、在线教育从业者、企业宣传部门等群体,可应用于科普视频制作、在线课程录制、品牌宣传内容产出、多语言跨境内容制作等多个场景。
junzhan2000.github.io
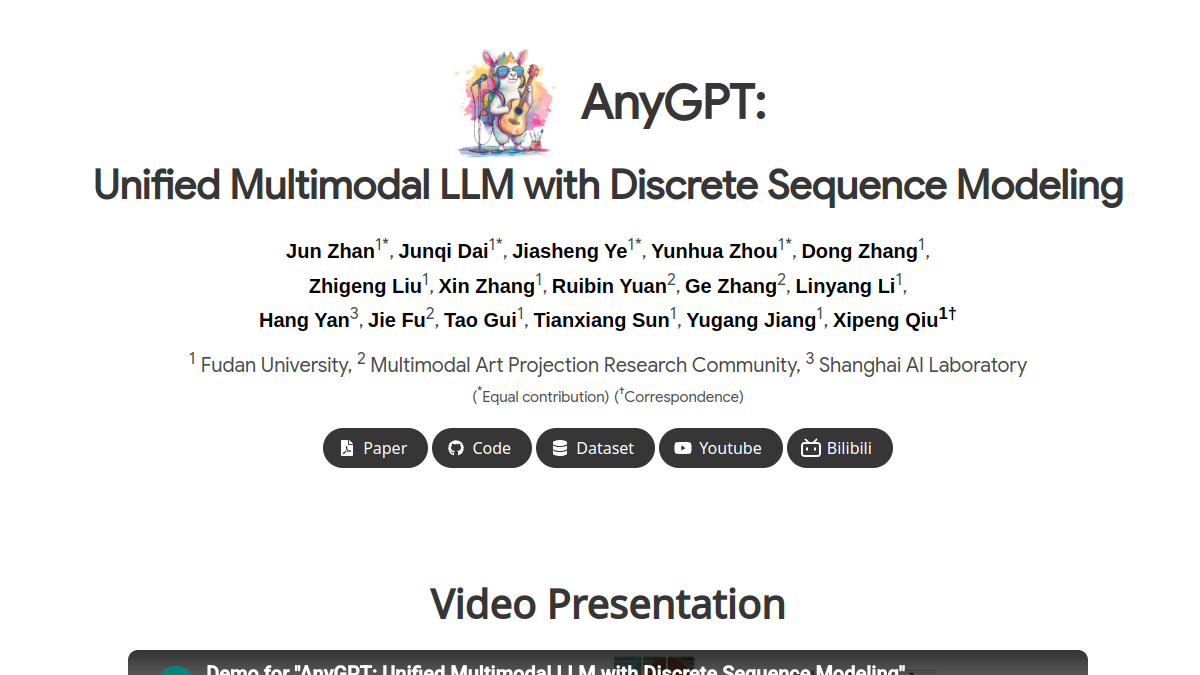
AnyGPT是一款面向多模态交互需求的统一大语言模型工具站,核心定位是通过离散表示技术实现语音、文本、图像、音乐等多模态的统一处理,无需改动现有大语言模型架构与训练范式即可完成稳定训练。核心功能包含多模态任意组合交互、多模态指令数据集支持、新模态无缝接入能力。目标用户覆盖AI研究人员、多模态应用开发者、内容创作者、高校计算机专业师生等群体,可用于多模态对话系统开发、跨模态内容生成、多模态模型学术研究、多模态交互产品原型测试等场景,为不同模态的统一处理提供可落地的技术方案。
craftjarvis.github.io
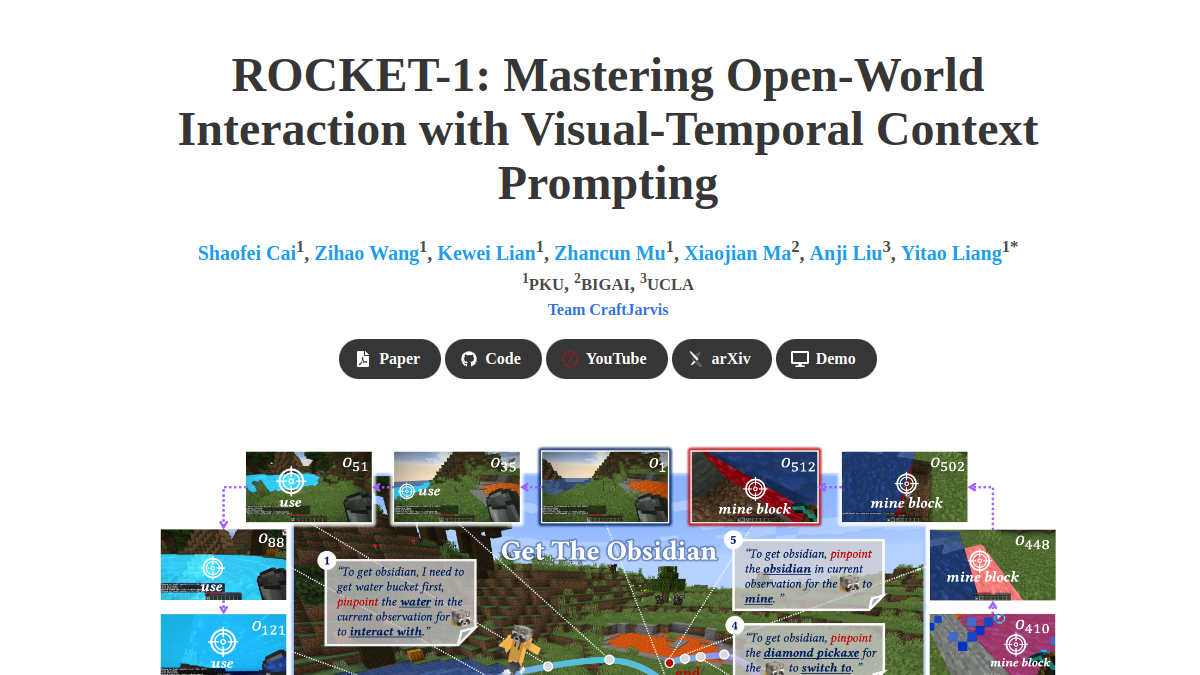
ROCKET-1是专注于开放世界具身决策场景的视觉-语言模型,核心定位是打通视觉语言大模型与具身策略模型的通信链路,提升智能体在开放交互环境中的任务完成能力。核心功能包括视觉-时间上下文提示协议构建、多帧观测对象分割引导、长序列复杂任务推理调度三类,主要面向人工智能研究人员、具身智能开发人员、开放世界游戏AI开发人员等群体,可应用于虚拟世界智能体训练、机器人具身决策算法验证、复杂开放环境任务推理研究等场景,为具身智能领域的视觉语言融合方案提供可参考的实现路径。