

VLOGGER
VLOGGER是基于扩散模型的AI人物视频生成工具,核心定位是通过单张人物图像结合文本、音频驱动,生成可控的人物讲话视频。核心功能包括单图驱动的3D人体运动生成、时序可控的视频扩散渲染、面部与肢体动作联合调控三个模块。目标用户覆盖视频创作者、多媒体内容开发者、数字人从业者、高校AI研究人员等群体,可用于短视频内容生产、数字人直播素材制作、学术研究效果验证、虚拟形象内容产出等场景,无需针对单个人物单独训练模型,即可输出包含完整人体姿态的长时长生成视频。
- 付费
- 网页
编辑评分3.5 / 5分类排名第 59 / 590 名
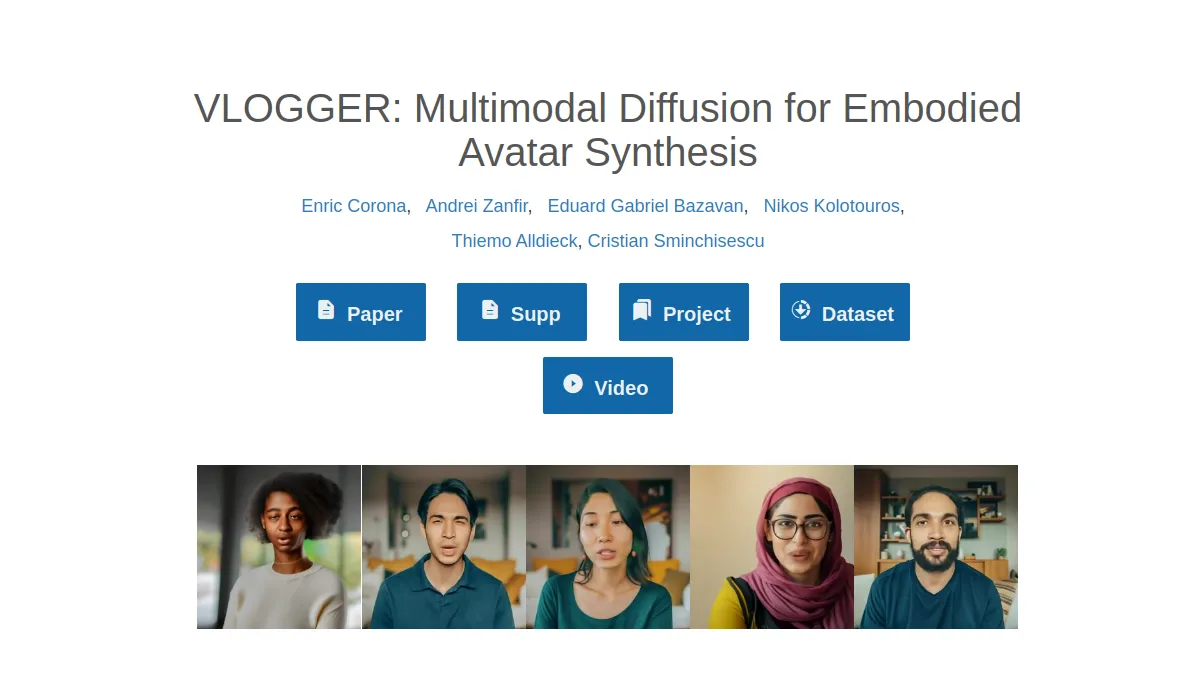
VLOGGER是什么
VLOGGER是基于扩散模型的AI人物视频生成工具,核心逻辑是上传单张人物图像,搭配文本或音频信号作为驱动源,生成符合指令的人物讲话类视频。它解决了传统数字人视频制作需要多轮3D建模、逐帧调整动作的繁琐流程,普通用户无需掌握专业动画制作技能,就能快速产出人物动态视频。工具依托预设的三个核心模块完成运算,不需要用户手动调整复杂的渲染参数,降低了人物动态视频的制作门槛。
它的能力覆盖单图生成3D人体运动视频、时序可控的扩散渲染、面部与肢体动作联合调整,仅针对上传的单张人物素材生成连贯动态,不支持多人物复杂交互场景的视频创作。适合短视频创作者快速产出口播素材、数字人从业者制作直播前置片段,或是AI相关方向的研究人员做扩散视频生成的效果验证。
核心能力
单图驱动的3D人体运动生成是其核心能力之一,运作时依赖单张人物图像作为初始输入,通过扩散模型生成匹配文本与音频内容的人物肢体、头部运动轨迹,能生成符合基础动作逻辑的人物动作序列,但无法实现复杂的非人类肢体交互动作。时序可控的视频扩散渲染能力,可基于输入的文本指令调整视频各帧的渲染节奏,保证动作与音频的时序同步,但对极长视频的时序衔接控制存在局限。面部与肢体动作联合调控能力,能同步调整人物的面部表情与肢体动作,使两者匹配输入的文本语义,但无法实现与第三方工具的动作数据对接。
- 单图驱动3D运动
- 上传单张静态人物图像,自动生成连贯自然的3D人体动态视频,省去手动建模调整步骤
- 时序可控渲染
- 可按生成需求调整视频帧序列的推进逻辑,让输出内容的时间线匹配预设的内容节奏
- 面肢联合调控
- 同步调整人物面部微表情与肢体动作的匹配度,避免出现动作和表情脱节的违和问题
- 音频驱动动效
- 上传对应音频素材,工具会自动匹配口型与肢体微动,生成和音频节奏适配的人物讲话视频
快速上手
- 打开VLOGGER的官方web页面,阅读功能说明后进入工具的操作主界面
- 上传准备好的单张清晰人物图像,确认图像主体无遮挡后完成素材导入
- 选择文本或音频作为驱动源,输入对应指令内容或上传音频文件,调整动作相关参数
- 提交生成请求,等待运算完成后预览生成的人物视频,确认效果后导出使用
定价
VLOGGER目前属于学术研究开源项目,无官方商用付费版本,所有代码和模型权重公开供非商业用途使用,非商业使用无需支付费用。商业使用需联系项目开发团队获取授权,目前暂无公开的商业版定价。个人用户可自行基于开源代码部署使用,部署过程需要具备一定的深度学习环境配置基础,适合有技术能力的用户测试使用,商用需求建议提前与开发团队沟通授权细节。
定价说明
以上信息整理自官网公示与站内档案核验,当前标注为「付费」;实际价格与免费额度以官网最新公示为准。
适用边界
该工具不适合无单张人物图像的用户、需要复杂肢体交互动作的任务,以及时长超过特定范围的视频制作。已知局限为无法实现与第三方动作数据工具的对接,对极长视频的时序衔接控制存在不足。需要绕开的坑是输入的音频与文本内容的语义偏差会影响生成视频的动作匹配度,替代方案可选择同类支持多动作数据导入的AI视频工具。关于定价,需查询官网定价页,具体费用以官网公示为准;关于数据隐私,需查看官网隐私政策,建议用户仅上传可公开的人物图像与音频内容。
适合谁用
- 短视频创作者,快速制作低成本口播类人物视频素材
- 数字人从业者,批量产出直播所需的虚拟人物动态片段
- 高校AI研究人员,验证扩散模型在人物视频生成方向的效果
- 多媒体内容开发者,快速产出虚拟形象的相关动态内容
优缺点
- 做得好的地方
- 依托扩散模型实现单图生成人物动态,无需额外准备多帧素材
- 支持音频联动调整口型与肢体动作,生成内容的适配度较高
- 面向学术研究场景开放相关能力,方便研究人员做效果验证
- 注意点
- 仅支持生成单人动态视频,无法处理多人物同框的创作需求
- 部分复杂肢体动作的生成效果存在轻微失真,需手动微调
常见问题
没有动画制作基础能上手吗
可以直接上手操作,工具不需要用户掌握3D建模、逐帧渲染的专业技能,所有核心运算由后台扩散模型完成,仅需上传素材并输入简单指令,操作路径简洁,新手也能快速完成首次生成
工具的费用结构是怎样的
该工具属于付费类型,不同的生成时长、导出分辨率对应不同的计费规则,具体收费标准、套餐权益可以前往官网的定价公示页面查看,使用前建议先确认对应权益是否匹配自身的使用需求
上传的人物图像数据会被留存吗
工具的数据处理规则以官网隐私政策为准,生成过程的临时运算数据不会长期留存,用户上传的原始人物素材不会被用于其他无关场景,可前往官网帮助中心查看完整的数据处理说明
能生成多人物交互的复杂视频吗
不能,该工具的核心定位是基于单张人物图像生成单人的讲话动态视频,不支持多人物同框互动的复杂场景创作,这类需求需要搭配其他专业视频制作工具完成
使用场景
短视频创作者在制作口播类短视频时,可上传自身静态肖像照,搭配口播文本与音频,生成无需实时拍摄的人物讲话视频,产出的视频可直接用于平台发布。多媒体内容开发者在制作数字人演示内容时,可通过单张人物参考图生成匹配演示脚本的数字人讲话视频,产出的视频可嵌入产品演示页面。高校AI研究人员可借助该工具的核心功能开展扩散模型在视频生成领域的相关研究,产出的实验数据可用于学术分析。
编辑点评
VLOGGER的核心功能围绕单图驱动的可控人物视频生成展开,能降低口播类视频的拍摄门槛,但存在动作交互局限、长视频控制不足等问题,定价与功能细节以官网为准。
相关工具

通义万相AI视频生成
通义万相AI视频生成是阿里云推出的AI视频创作工具,核心定位为依托大模型技术实现文本、图像到视频的智能转换,降低视频内容生产的技术门槛。核心功能包括文生视频、图生视频、视频风格化,
Zhipu Qingying
Zhipu Qingying是智谱AI推出的AI内容生成服务平台,核心定位为面向多场景的智能内容创作与交互服务平台。平台搭载自研大模型底座,支持智能对话交互、AI视频生成、多模态内
Vidu 国际版
Vidu是国内专注于AI视频生成的服务平台,核心基于自研视频生成模型打造,可支持长时长、高一致性、高动态效果的视频产出。平台核心功能包括文生视频、图生视频、视频风格转化,目标用户覆

可灵AI
Kling AI是快手推出的AI视频生成平台,核心支持文生视频、图生视频两大核心生成能力,同时具备视频时长扩展、风格自定义、多模态素材匹配等辅助功能,可满足不同类型的视频创作需求。

可灵 AI
可灵 AI是快手推出的集成AI图像与视频创作能力的创意生产力平台,核心功能包含文生图、文生视频、图生视频、视频风格迁移、智能高清修复等,可满足不同创意内容的制作需求。平台面向内容创

MiniMax
MiniMax是搭载海螺AI(Hailuo)技术底座的AI视频生成平台,核心支持文生视频、图生视频两大核心创作模式,同时支持视频时长与风格自定义,可为不同需求的视频创作者、内容运营
OpenAI Sora
OpenAI Sora是OpenAI开发的文本生成视频AI模型服务平台,核心能力是根据用户输入的文本描述生成时长最长一分钟的高清视频内容。平台支持用户输入详细的场景、动作、风格描述
Wan
Wan是阿里巴巴通义实验室推出的视觉生成服务平台,核心搭载Wan2.1系列开源视频生成模型,面向有视频内容创作需求的用户提供AI生成服务。平台支持文本生成视频、图像生成视频、参考内

Stable
Stable Video Diffusion是Stability AI开发的AI视频生成服务平台,核心定位是为用户提供静态图像转动态视频的AI创作能力。平台支持单张图片输入生成多秒
DrawThink
DrawThink是百度旗下的AI视频创作服务平台,核心定位是为视频创作者提供全流程的创意辅助与制作支持。平台内置灵感推荐功能,可根据用户输入的创作方向、视频类型等标签,匹配同赛道
海螺视频
海螺视频是基于AI技术的视频创作服务平台,核心定位是为用户提供从内容生成到剪辑优化的全流程视频制作支持。平台核心功能包括AI智能生成短视频、AI素材自动匹配、多风格视频模板适配,无
Vidu Studio AI
Vidu Studio AI是专注于AI视频生成的创作平台,核心功能为文本生成视频、图像转视频、模板化视频创作,面向内容创作者、市场运营人员、自媒体从业者、企业宣传人员等群体,可应
数据与说明
本档案由 Toolifai 编辑部整理并持续核验,功能与定价信息以 enriccorona.github.io 官网公示为准;发现资料过期或有误,欢迎通过纠错通道反馈。
- 官网 enriccorona.github.io
- 编辑标准与核验方法收录 2026-06-14
- 收录证明核验记录与可嵌入的收录徽章
- 开发者认领VLOGGER 官方团队可认领并维护本页
- 资料纠错纠错后通常 1-2 个工作日内核验更新
大家对 VLOGGER 的点评
加载中…
近 7 日新增点评 0 条 · 浏览量 6