学术研究工具
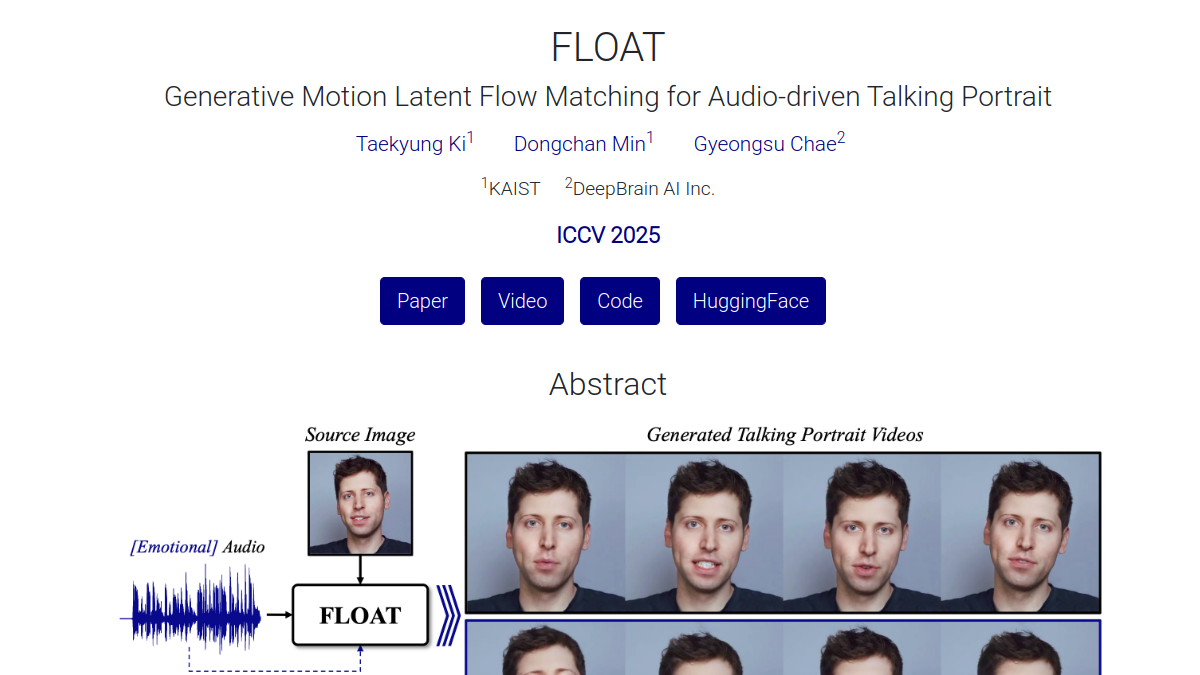

deepbrainai-research.github.io
FLOAT是由深度脑AI研究团队推出的音频驱动人像视频生成技术演示站点,核心定位为基于流匹配生成模型的专业说话人视频生成工具。站点核心功能包括音频驱动的人像视频生成、情感增强运动渲染、多风格运动模式适配,可实现时间一致性的人脸运动合成。目标用户覆盖AI视频研发人员、数字内容创作者、虚拟人开发从业者等,适用于虚拟人直播内容生成、短视频口播素材制作、数字人互动场景开发、学术研究效果验证等多种场景,帮助用户降低说话人视频的制作门槛,提升动态内容生成效率。

jgwlbq.org.cn
甲骨文AI协同平台是聚焦甲骨文研究与文化传播的数字化服务平台,核心定位为甲骨文领域的学术研究辅助与文化普及载体。核心功能包括甲骨文全信息著录库检索、AI辅助甲骨文释读、甲骨文相关数字工具集合。平台面向古文字研究人员、历史学科师生、文博从业者、传统文化爱好者等群体,可满足学术研究中甲骨文资料查阅、残片缀合辅助、文化科普内容制作、教学素材整理等多场景需求,助力甲骨文化的研究与传承工作。
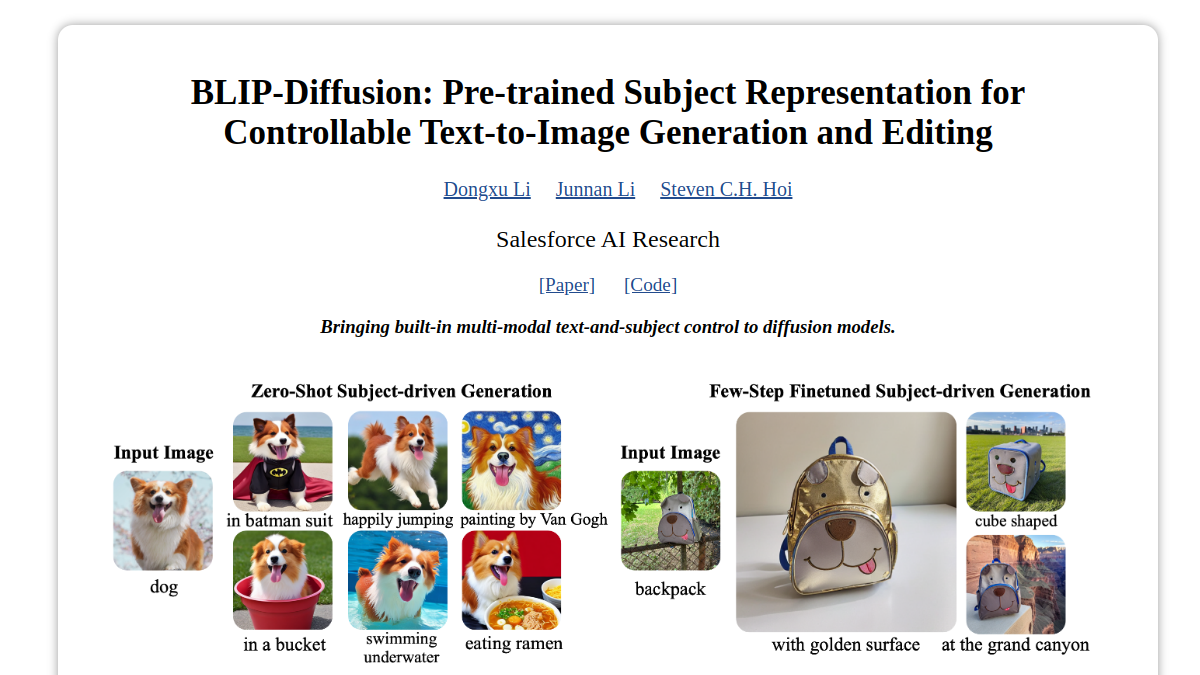

dxli94.github.io
BLIP-Diffusion是一个支持多模态控制的主题驱动图像生成模型站点,核心定位为降低主题定制图像生成的技术门槛。站点提供零样本主题生成能力,用户无需大量训练即可基于单张参考图生成同主题衍生内容;支持高效微调功能,少量样本即可实现个性化主题的定向优化;还兼容ControlNet、prompt-to-prompt等主流生成工具,扩展更多创作可能性。主要面向AI图像研究者、数字内容创作者、设计从业者等用户,适用于产品概念设计、IP形象衍生、艺术创作实验、学术研究验证等多个场景。
notehub.ai
Notehub.ai是专注于Jupyter笔记本共享与协作的在线平台,核心定位为数据相关从业者的笔记协作工具。其核心功能包括Jupyter笔记本快速分享、实时协同编辑、精细化权限管理。平台支持用户上传.ipynb格式文件,可生成专属分享链接,还内置Markdown编辑器支持笔记内容二次编辑。目标用户覆盖学术研究人员、数据科学家、程序员、数据分析从业者、高校理工科师生等,适用于团队协作完成数据分析项目、学术成果共享讨论、编程教学案例分发、个人实验记录云端存储等多个场景。
caizhongang.github.io
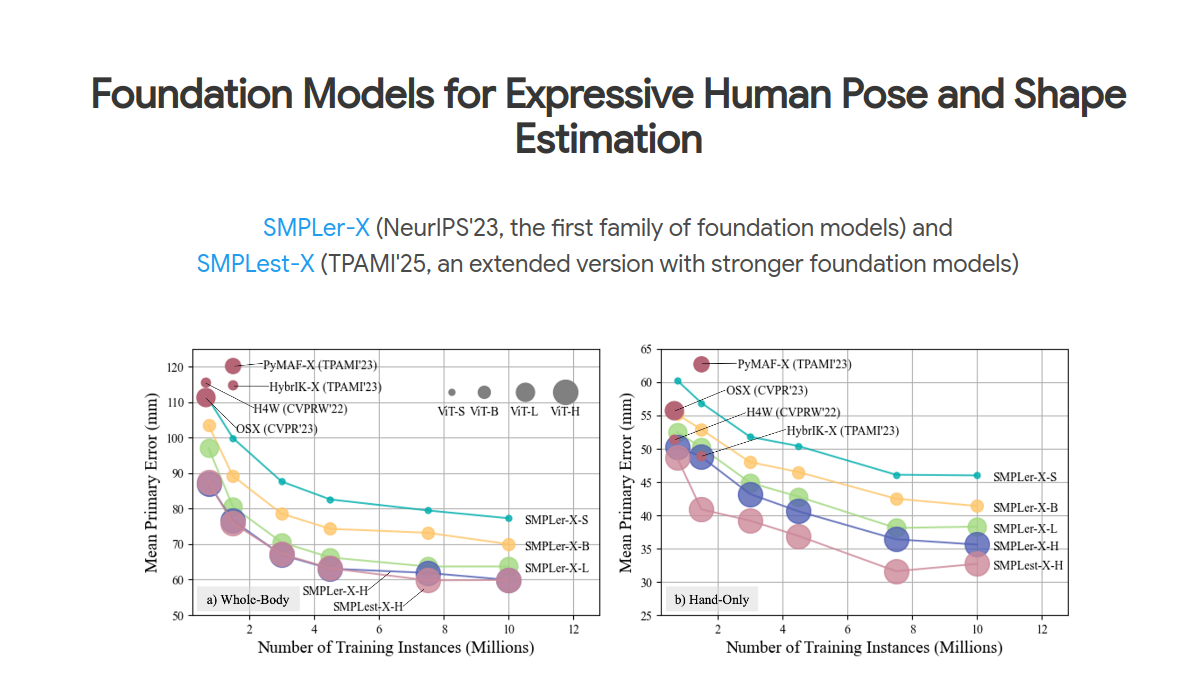
SMPLer-X是面向人体姿态与形状估计领域的开源学术项目站点,核心提供经过大规模数据训练的全身动作捕捉模型方案。站点内置多基准测试结果可视化功能,支持模型部署代码包下载,配套不同场景下的推理Demo运行指南。主要面向计算机视觉领域研究人员、动捕技术开发工程师、数字人内容创作者,可用于学术研究性能对比、动捕工具开发迭代、数字人驱动素材生成等场景,帮助相关从业者降低全身动作捕捉模型的研发与应用门槛。
jerryxu.net
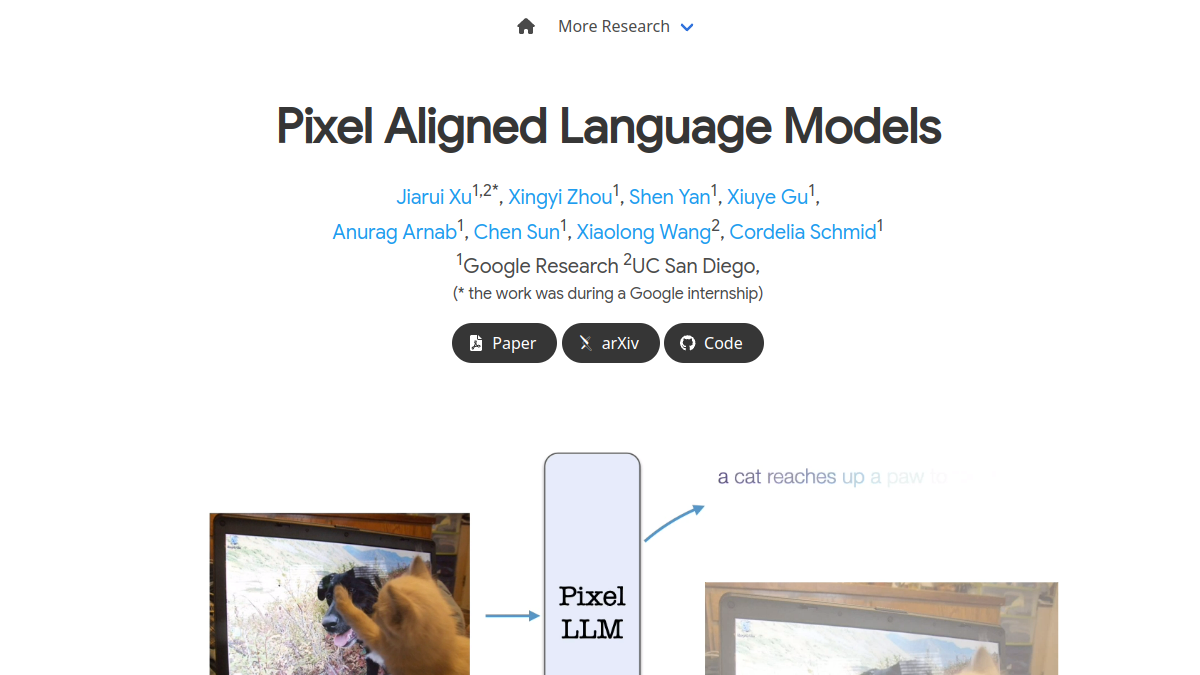
PixelLLM是一个专注于图像定位任务的视觉-语言模型展示站点,核心功能涵盖位置引导的图像描述生成、文本引导的像素坐标定位、多数据集性能结果查询。该站点面向计算机视觉研究者、AI算法开发人员、多模态学习领域学生,可用于学术研究参考、模型效果验证、相关任务技术选型等场景,帮助用户直观了解视觉与像素对齐技术的落地表现。

gligen.github.io
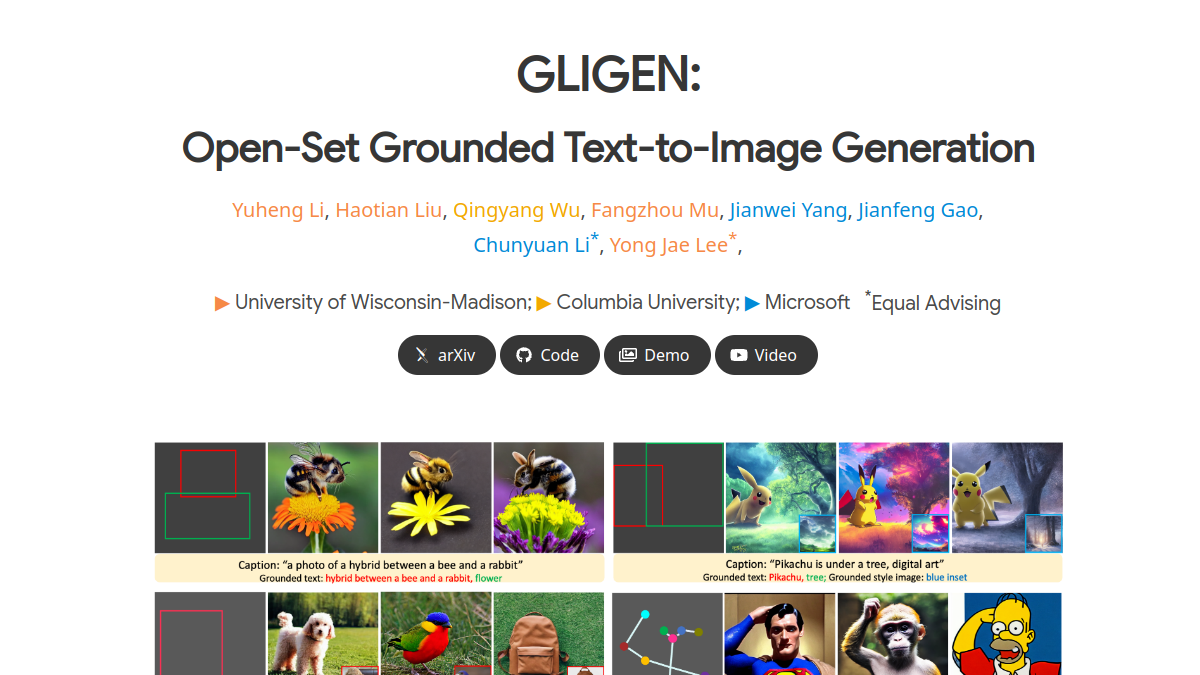
GLIGEN是一款开放式的条件式图像生成学术项目站点,核心为基于扩散模型的可控图像生成技术。用户可结合文本描述与空间边界框、参考图像等条件,生成符合指定布局与内容要求的图像;模型采用模块化训练设计,保留预训练扩散模型的基础生成能力的同时,扩展了空间控制属性。该站点面向AI图像生成研究者、计算机视觉从业者、内容创作人员、设计人员等群体,可用于学术研究验证、可控图像内容创作、多模态模型效果测试、概念设计初稿生成等场景,帮助用户在图像生成过程中实现更精准的内容与布局控制。

crayon-shinchan.github.io
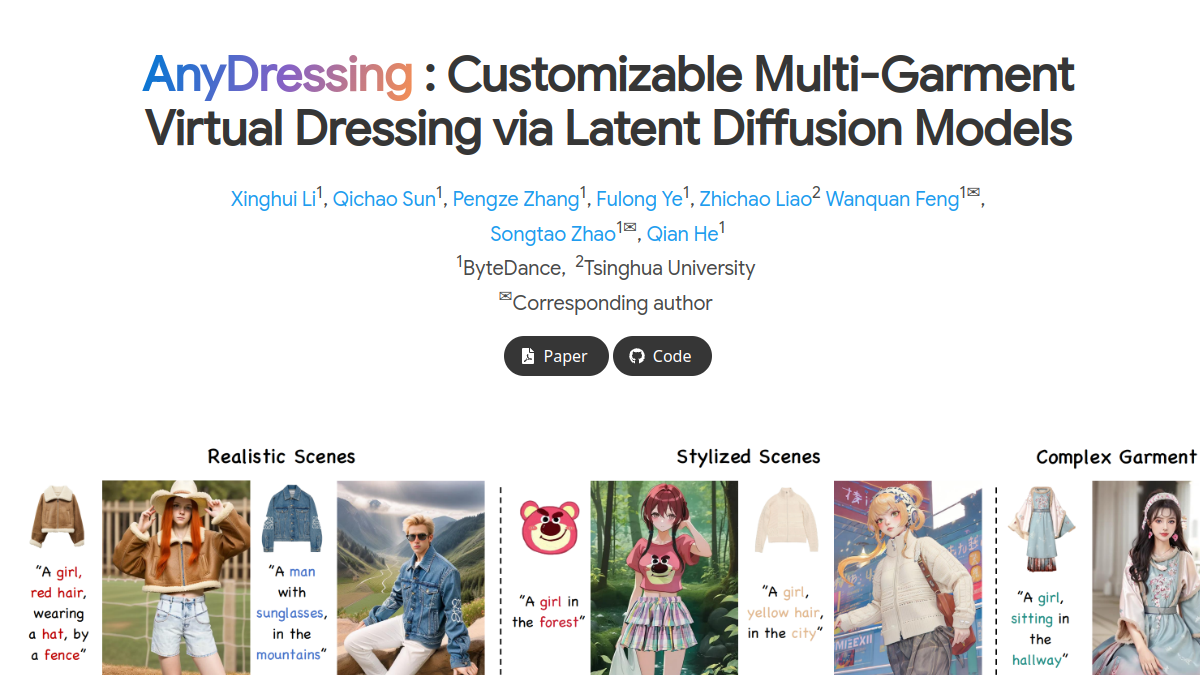
AnyDressing是由字节跳动与清华大学研究团队联合开发的虚拟试穿技术展示平台,核心基于潜在扩散模型实现多服装的定制化试穿效果生成。平台支持用户上传多件服装素材、输入个性化文本提示,即可输出高还原度的虚拟试穿图像,可保留服装原始纹理细节、适配不同身形与场景需求。当前该项目处于研究展示阶段,主要面向学术研究人员、电商服饰从业者、数字内容创作者等群体,可用于技术研发参考、服饰效果预演、虚拟人物穿搭设计等场景。
instruct-nerf2nerf.github.io
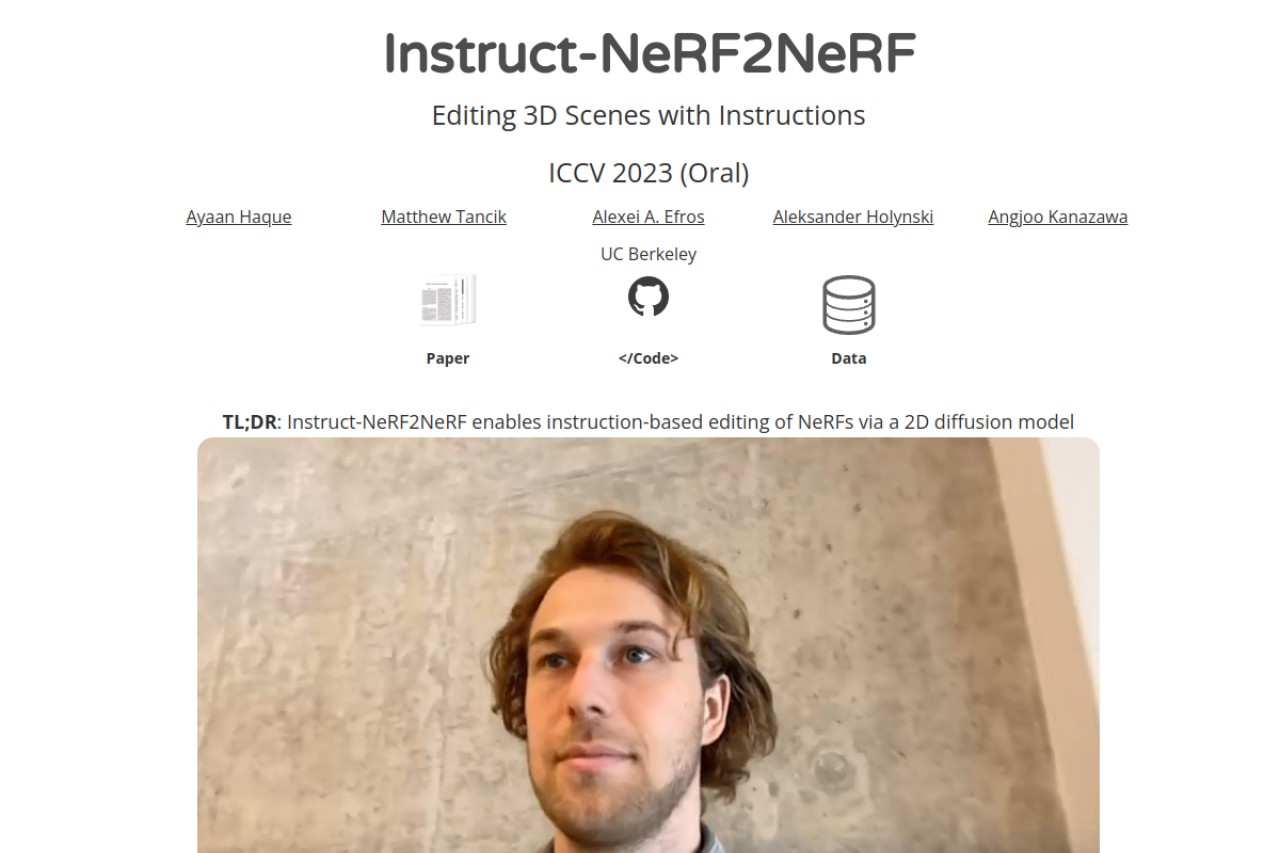
Instruct-NeRF2NeRF是专注于3D NeRF场景指令式编辑的学术项目网站,核心定位为通过文本指令实现NeRF场景的可控编辑。核心功能包括文本指令驱动的3D场景修改、多视角一致性编辑优化、真实世界大规模场景适配。目标用户覆盖计算机图形学研究人员、3D内容开发者、VR/AR内容创作者、影视特效制作人员、高校相关专业学生等。适用于3D场景风格转换、场景元素替换、场景属性调整、数字孪生场景迭代等多种工作场景,无需手动逐帧调整3D资产,即可输出符合指令要求的一致性3D编辑结果。

sagipolaczek.github.io
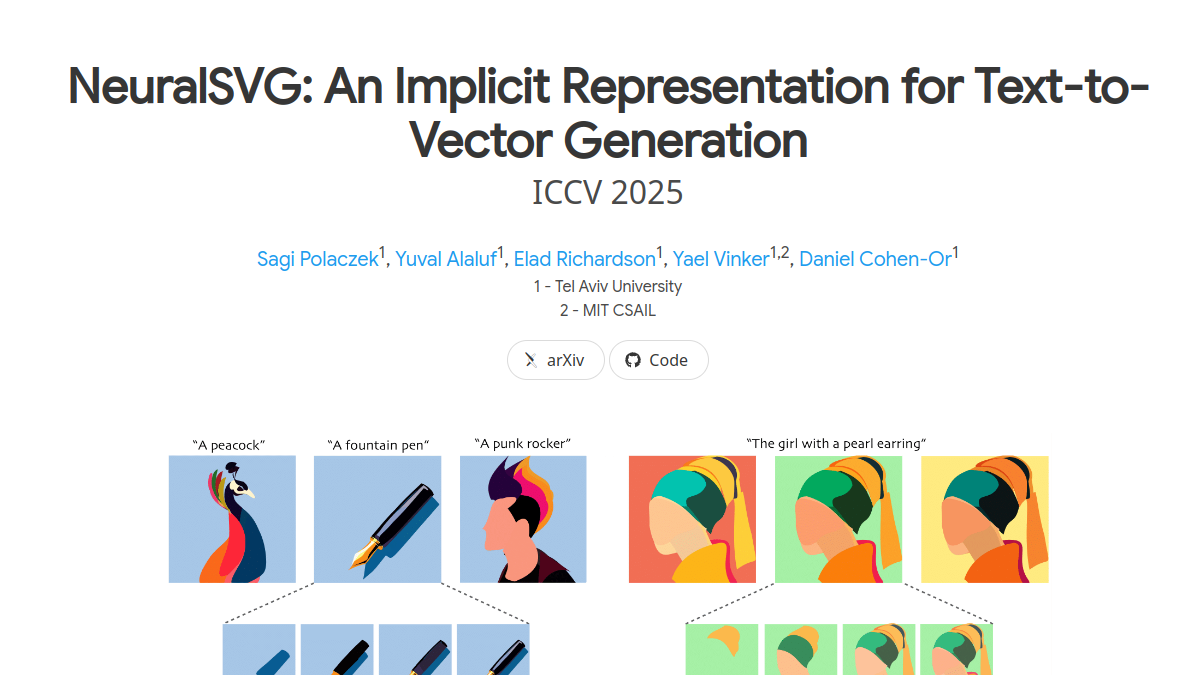
NeuralSVG是由特拉维夫大学与MIT CSAIL研究团队联合开发的矢量图形生成研究工具,核心定位是基于隐式神经表示技术实现文本提示到SVG矢量图的转化。该工具参考神经辐射场(NeRFs)技术逻辑,将场景信息编码到小型多层感知器(MLP)网络权重中,支持分数蒸馏采样(SDS)优化生成过程,同时提供生成后参数动态调整能力。目标用户覆盖设计领域从业者、人工智能研究人员、计算机图形学学习者、前端开发人员、文创内容创作者等群体,可用于学术研究验证、设计素材初稿生成、矢量图形特性探索、教学演示等多个场景。
virtualhumans.mpi-inf.mpg.de
InterTrack是马克斯·普朗克信息学研究所发布的人体与物体交互4D跟踪技术项目站点,核心面向计算机视觉、三维重建领域的研究人员与开发者,提供单目RGB视频下的人体、物体联合跟踪解决方案。核心功能包括无需实体对象模板的泛化跟踪,支持遮挡场景下的交互行为连续捕获,以及4D姿态与形状的分步优化输出。站点可满足学术研究验证、交互行为分析、动效制作素材采集等场景的使用需求,帮助用户降低多视角采集、预扫描对象模板的硬件与流程成本。
prodream.ai
ProDream是面向学术领域的AI写作辅助平台,核心定位为学术写作一站式AI解决方案,由具备数十年学术经验的专家团队打造,经Harvard Innovation Lab与Microsoft Founders Hub孵化。平台核心功能包含AI学术写作辅助、文献引用格式化、原创性合规检测,能够覆盖论文撰写、课程作业完成、学术投稿准备等多个场景,目标用户为高校学生、科研人员、教师等学术相关群体,可帮助用户理顺写作逻辑、规范学术格式、降低内容合规风险,提升学术内容产出的效率与规范性。
chatwithpdf.ai
ChatWithPDF.AI | Paperguide是一款依托大语言模型搭建的AI文档交互研究平台,核心定位为帮助用户通过对话方式处理PDF文档,提炼核心信息。平台支持文档内容总结、关键信息提取、内容问答、文献整理等功能,还可针对专业学术文献进行解读分析。目标用户涵盖科研工作者、学生、职场办公人员等有PDF文档处理需求的群体,适合在文献调研、论文撰写、报告整理、快速读阅长文档等场景使用,帮助用户提升文档处理效率,降低信息梳理成本。

sliderspace.baulab.info
SliderSpace是由BAU实验室推出的扩散模型能力分析与交互工具,核心定位是为AI生成图像研究人员、开发者提供可视化的扩散模型内部机制解析途径。其核心功能包括通过可调节滑块拆解扩散模型不同视觉生成维度的权重、实时预览参数调整后的图像生成效果、导出模型不同层的激活特征数据。目标用户覆盖AI生成图像研究人员、计算机视觉方向学生、扩散模型开发者、AI艺术创作者等群体,可应用于扩散模型可解释性研究、生成参数调优、AI生成内容可控性实验、模型能力对比测试等多种场景。

oldenglishtranslator.app
Old English Translator是一个由AI驱动的历史语言翻译平台,核心定位为提供现代英语与古英语等多种历史语言之间的双向翻译服务,支持莎士比亚英语、古诺斯语等不同时期古代语言的转换。平台核心功能包含古英语双向翻译、莎士比亚英语转换、古诺斯语翻译、历史语言语料查询、古代语言发音参考等,覆盖历史语言学研究者、英国文学专业师生、中世纪文化爱好者、英文内容创作者、语言专业学习者、奇幻文化创作者等多类目标用户,可满足学术研究文献翻译、古文学作品研读、中世纪文化内容创作、古代语言学习练习等多种场景需求。
zerobench.github.io
ZeroBench是聚焦多模态大模型视觉理解能力的专业基准测试平台,核心定位为多模态模型研发领域的评估工具。平台搭载经学术团队严格校验的高难度测试数据集,支持完整的模型性能分层评估,同时提供推理过程拆解分析功能。目标用户覆盖人工智能领域研究人员、多模态模型开发团队、高校计算机相关专业师生,可应用于模型迭代效果验证、学术论文实验支撑、多模态技术路线对比等场景,帮助使用者清晰识别不同模型在复杂视觉理解任务上的能力差异。

egolife-ai.github.io
EgoLife是聚焦长期多模态日常生活场景的AI研究项目平台,核心定位是为长期上下文理解、多视角行为分析等AI方向的研究提供真实数据集与技术框架支撑。平台收录六名志愿者一周共享生活的50小时标注数据,涵盖日常起居、协作办公、休闲社交等多类真实场景,内置EgoRAG检索增强生成框架,支持多模态数据的长期关联查询与上下文推理。目标用户包括AI领域研究人员、计算机视觉方向开发者、人机交互研究学者,可用于日常行为预测模型训练、具身智能系统开发、多模态大模型性能测试等多种研究场景。
kaist-viclab.github.io
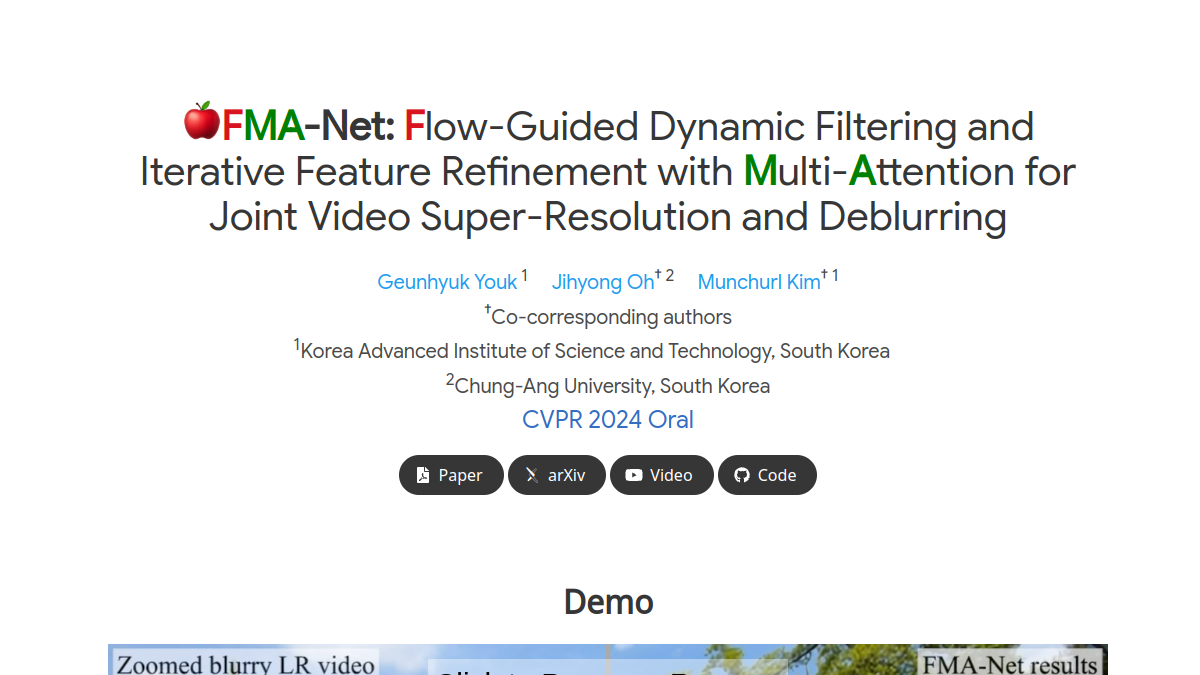
FMA-Net是由韩国科学技术院VIC实验室推出的视频超分辨率与去模糊深度学习模型站点,核心为实现低分辨率模糊视频的高质量清晰化修复。站点搭载流引导动态过滤、多注意力迭代特征精炼两大核心技术,可应对视频中的大幅度动作场景,实现超分辨率与去模糊任务的联合处理。目标用户覆盖计算机视觉研究人员、视频内容创作者、视频修复从业者、多媒体开发工程师等群体,可用于老旧影像修复、监控视频画质增强、自媒体素材画质提升、学术研究算法对比等多类场景。
zhipeixu.github.io
FakeShield是专注于图像篡改检测与定位的多模态技术框架站点,核心目标是解决图像伪造检测领域算法黑箱不透明、跨篡改类型泛化能力弱的行业痛点。站点核心功能包括多模态篡改描述数据集MMTD-Set的公开访问、可解释篡改检测模块DTE-FDM的效果演示、文本引导的篡改定位模块MFLM的测试入口。站点面向AI安全研究人员、数字取证从业者、内容审核平台技术开发人员、学术领域相关方向研究者开放,可用于图像伪造检测算法研发、数字内容真实性核验、伪造证据溯源分析、学术研究效果对比等场景。
atlasworkspace.ai
Atlas是面向科研领域的可视化可验证工作空间,核心定位为科研文献理解与协作平台。平台支持科研文献结构化解析、多人协同标注、研究结论溯源验证三大核心功能,主要服务于高校科研人员、期刊审稿人、硕博研究生、企业研发人员、科研机构从业者等用户群体,可应用于文献调研、论文撰写、实验结果交叉验证、团队科研项目协作、学术成果复盘等多个场景,帮助用户降低科研文献阅读门槛,提升学术研究过程的透明度与协作效率。
brainypdf.com
BrainyPDF是一款基于大语言模型的PDF文档交互处理平台,核心定位为帮助用户快速与PDF文档内容交互,提取关键信息、解答文档疑问。平台支持直接上传本地PDF文档,也可导入公开可访问的在线PDF链接,通过自然对话的方式提取文档内容,生成内容总结、解答专业问题。核心功能包括PDF内容问答、文档自动总结、引用来源标注、多格式文档支持、对话历史保存,适合科研人员、学生、职场办公人员处理文献、报告、电子书等不同类型的PDF文档,在文献调研、论文整理、报告研读等场景使用。
sizhean.github.io
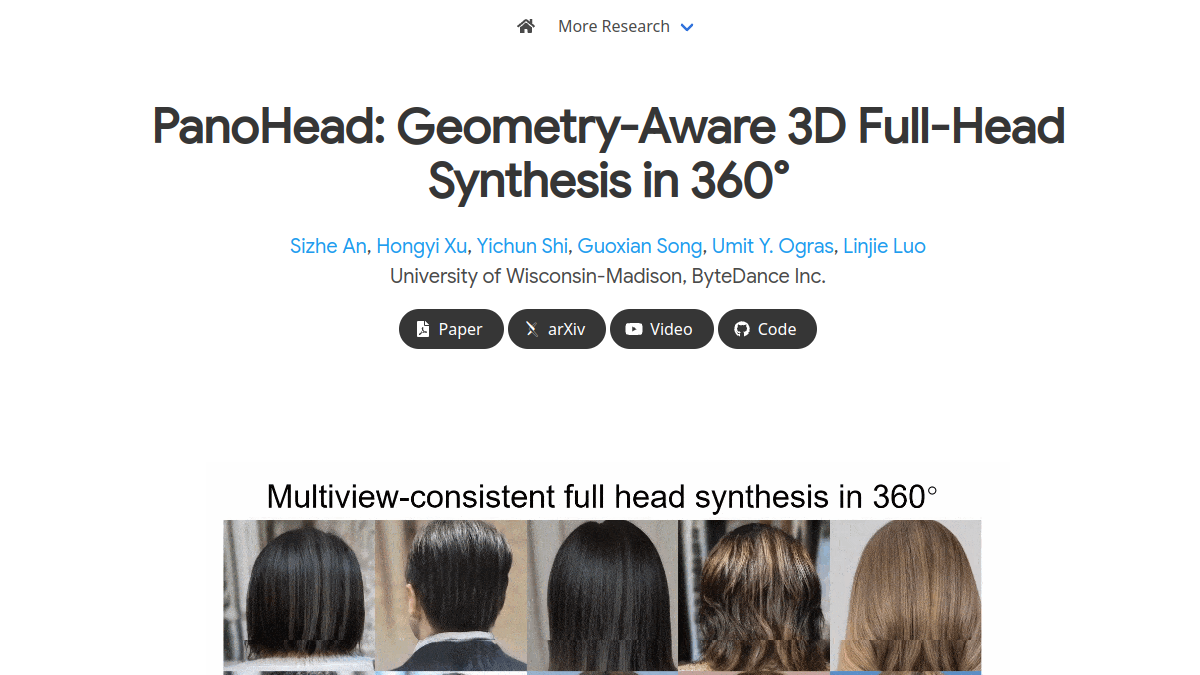
PanoHead是专注于360°全头部3D合成的学术研究项目站点,核心定位为面向计算机视觉领域的3D人头生成技术展示与资源输出平台。核心功能包括360°几何感知的全头合成技术演示、非结构化图像训练方案说明、视图一致的3D头部生成效果展示。目标用户覆盖计算机视觉研究人员、3D内容开发者、数字人制作从业者、高校图形学相关专业师生。可应用于数字人模型快速生成、影视虚拟角色原型制作、VR/AR虚拟头像定制、人脸相关算法研究验证等场景,帮助用户降低3D头部模型的制作门槛,提升生成内容的视角一致性与几何细节精度。
uncensorgpt.com
UncensorGPT.com是主打无内容审查的大语言模型对话服务平台,核心定位是为用户提供不受通用AI平台内容规则限制的AI交互体验。平台接入多个主流大语言模型底层能力,支持无过滤开放式对话、自定义模型参数调节、多轮连续上下文记忆、对话内容本地导出、无需注册匿名访问等功能。目标用户包含需要讨论特定研究议题的学术研究人员、需要突破常规内容限制进行创意发散的内容创作者、想要进行不受约束的观点交流的用户群体,可应用于学术敏感议题调研、非常规创意内容生成、跨边界观点碰撞交流、特殊场景信息查询等场景。

lukashoel.github.io
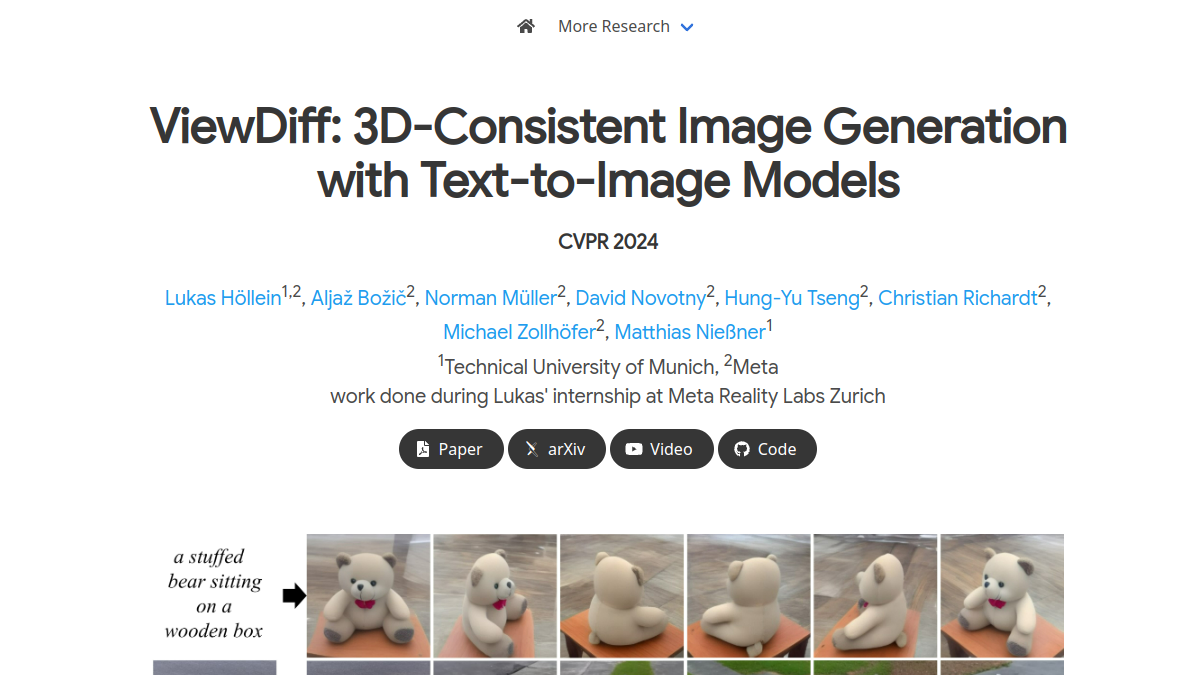
ViewDiff是一个面向3D内容创作、计算机视觉研究领域的在线多视角一致图像生成工具,基于预训练文本到图像模型作为技术基础,结合3D体积渲染与跨帧注意力机制实现3D一致性内容生成。核心功能包括单图生成多视角一致图像、文本引导3D视角内容编辑、自定义相机参数视角渲染三类,目标用户覆盖计算机视觉研究人员、3D建模师、游戏内容创作者、动画制作人员等,可用于快速生成3D资产多视角参考图、小体量3D内容原型制作、学术研究中的3D生成效果对比等场景,帮助用户降低多视角3D内容的制作门槛。
stetos.co
Stetos.co是一款依托AI技术,专注于大规模定性访谈执行与结果汇总的协作平台,面向有定性内容处理需求的各类用户,提供AI智能访谈执行、结果自动结构化汇总、主题编码分析、多渠道访谈同步、数据隐私保护等核心功能。可应用于大规模用户调研、学术质性研究、产品需求挖掘、消费者行为分析等多种需要处理大量定性访谈内容的场景,帮助用户处理多轮访谈信息,降低人工整理成本,提升定性研究的执行效率。
sound-of-pixels.csail.mit.edu
PixelPlayer是由麻省理工学院CSAIL实验室开发的音视觉联合分析系统,核心定位是通过无标注视频训练,实现图像区域声源定位与多源音频分离。核心功能包括音视频同步学习、像素级声源定位、多类别音频分离三个模块,无需人工标注数据即可完成模型训练。面向计算机视觉研究人员、音频处理从业者、多媒体内容创作者、高校相关专业学生等群体,适用于音视频分离实验、老旧音轨修复、多乐器演奏内容拆分、视频声源定位分析、多模态学习研究等场景,可帮助用户将单声道音频按不同声源类型拆分,同时定位视频中每个发声区域对应的音频波形。

jy-joy.github.io
InstantIR是由北京大学、InstantX团队和香港中文大学联合研发的盲图像恢复工具,依托扩散模型技术实现未知退化图像的修复处理。核心功能包括极端退化图像细节还原、基于文本提示的个性化恢复效果调节、推理阶段动态生成参考图像提升输出稳定性。目标用户覆盖计算机视觉研究人员、图像修复从业者、旧照片修复爱好者、平面设计人员等群体,可应用于老旧模糊照片修复、低质监控画面增强、受损扫描文档画质优化、艺术创作素材画质调整等多个场景,无需提前预设图像退化类型即可完成修复操作。
follow-your-click.github.io
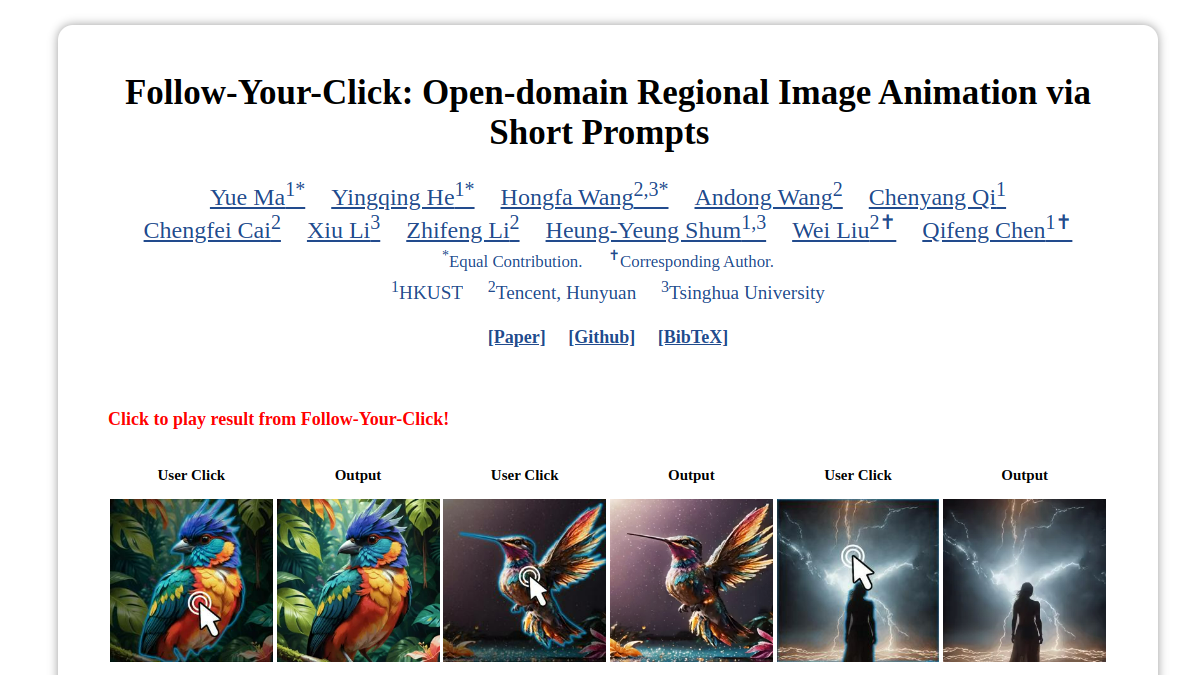
Follow-Your-Click是专注于开放领域区域图像动画生成的在线实验工具,核心定位是让用户通过简单交互即可实现静态图像局部动态效果生成。核心功能包括点击驱动的局部动画生成、多方法效果横向对比、运动强度参数自定义调节。目标用户覆盖计算机视觉研究人员、动画设计爱好者、内容创作者、学术相关学习者,适用于快速验证图像动画创意、对比不同动画生成算法效果、学习图像动态化相关技术原理等场景。
enriccorona.github.io
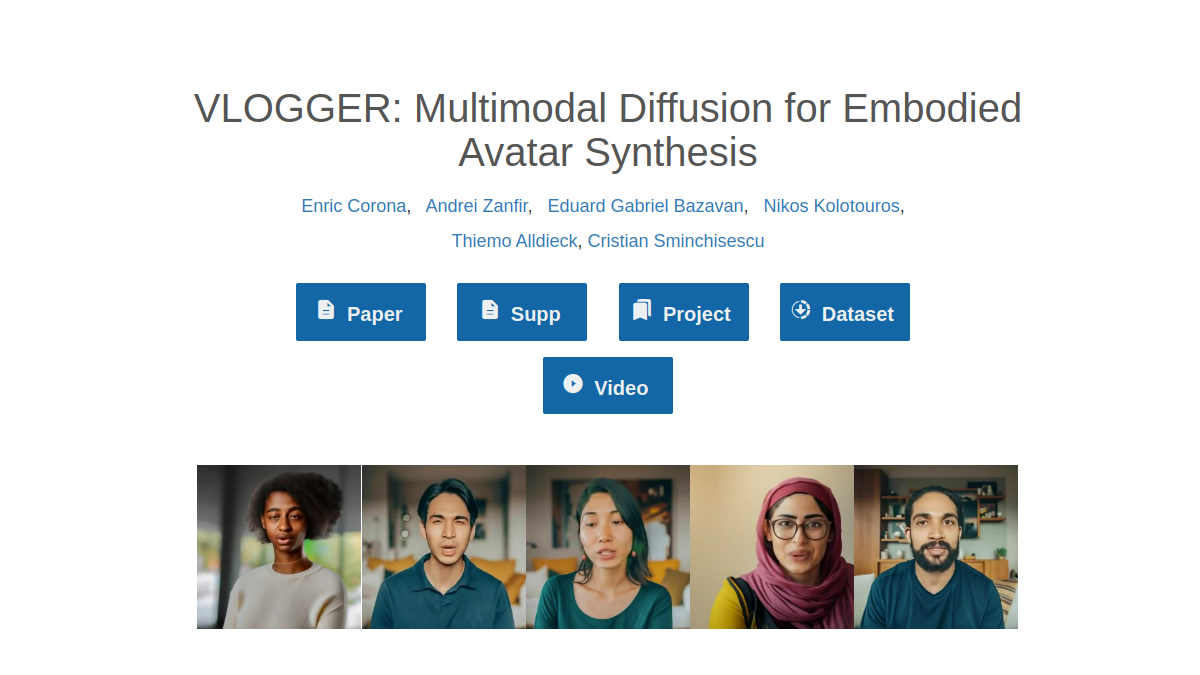
VLOGGER是基于扩散模型的AI人物视频生成工具,核心定位是通过单张人物图像结合文本、音频驱动,生成可控的人物讲话视频。核心功能包括单图驱动的3D人体运动生成、时序可控的视频扩散渲染、面部与肢体动作联合调控三个模块。目标用户覆盖视频创作者、多媒体内容开发者、数字人从业者、高校AI研究人员等群体,可用于短视频内容生产、数字人直播素材制作、学术研究效果验证、虚拟形象内容产出等场景,无需针对单个人物单独训练模型,即可输出包含完整人体姿态的长时长生成视频。

shivangi-aneja.github.io
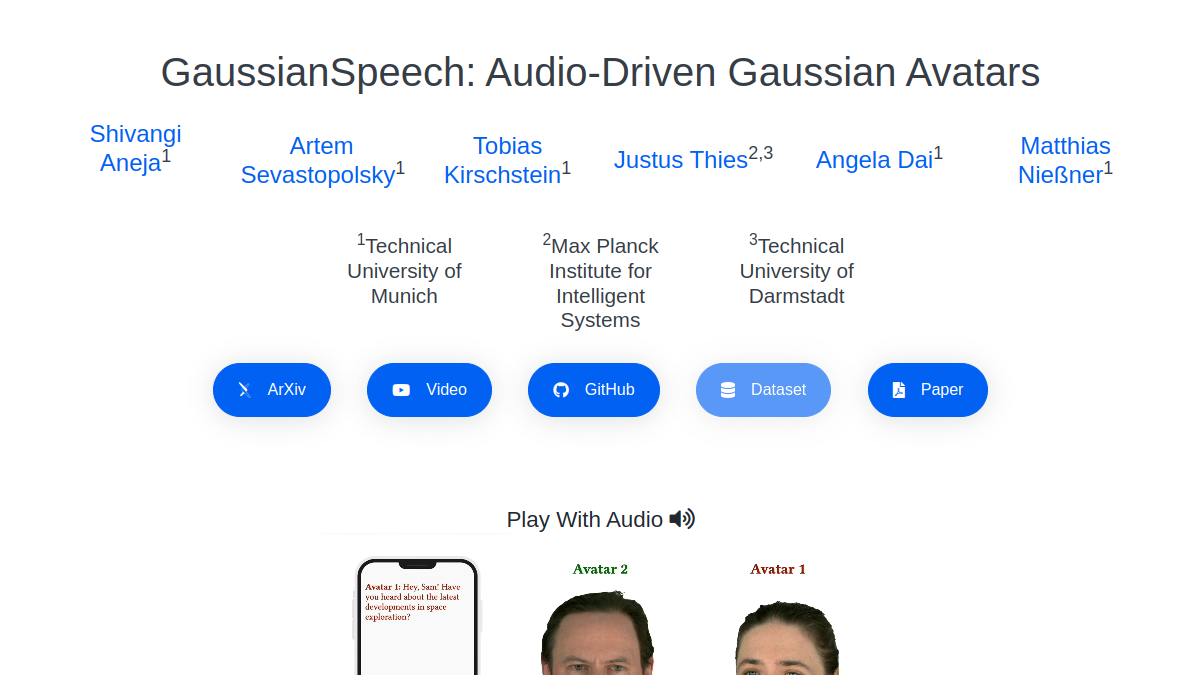
GaussianSpeech是基于3D高斯绘制技术的语音驱动3D人头化身生成平台,核心定位为将语音信号转换为高保真3D面部动画的技术演示与方案展示平台。其核心功能包括语音输入驱动3D面部动作生成、多视角动画效果渲染、个性化面部风格适配,支持用户上传语音片段生成对应匹配的面部动态序列,同时提供不同风格、不同特征的人头模型效果预览。目标用户覆盖计算机图形学研究者、动画制作从业者、虚拟数字人开发人员、语音交互产品设计师等群体,可应用于虚拟主播内容制作、元宇宙虚拟形象交互、短视频3D角色动画生成、无障碍语音可视化呈现等多种场景,为语音到3D视觉内容的转换提供可参考的技术实现路径。

aigc3d.github.io
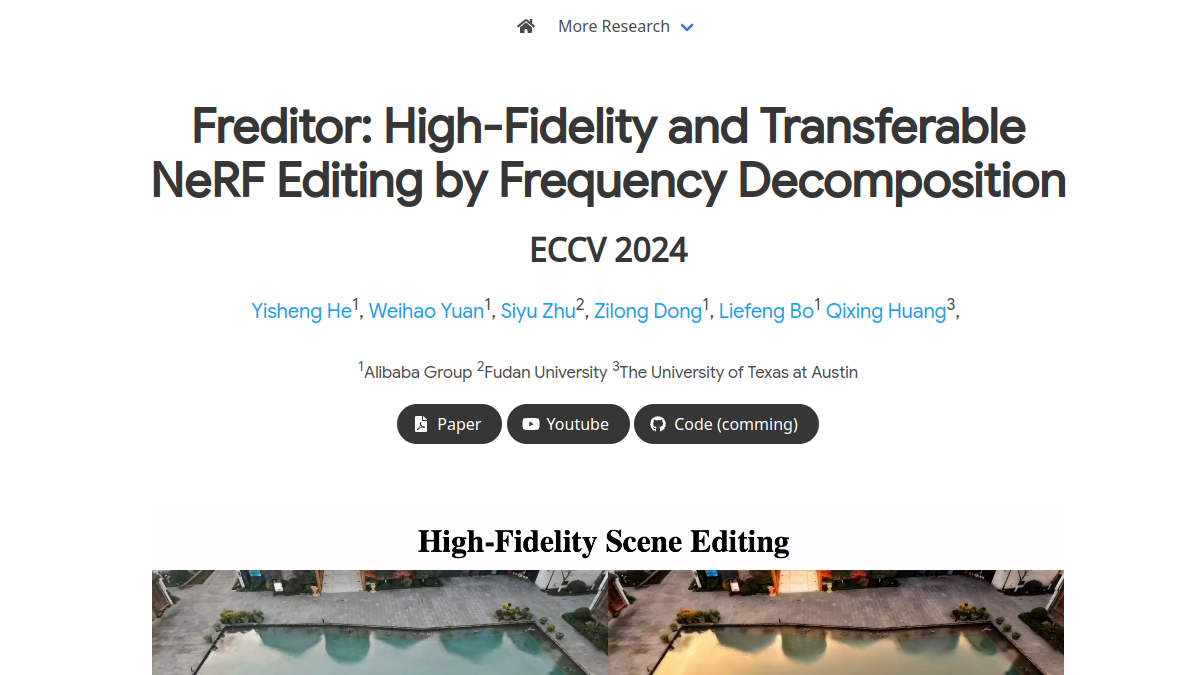
Freditor是基于频域分解技术的NeRF场景编辑工具,核心定位是为3D内容创作者、计算机视觉研究者提供高保真的神经辐射场编辑能力。核心功能包括NeRF场景频域拆分、低频区域风格迁移、高频细节保留集成、编辑强度实时调控,可适配多种不同类型的NeRF预训练场景。目标用户覆盖高校计算机视觉方向研究人员、3D内容制作团队、数字孪生项目开发人员、元宇宙场景创作者、AI生成内容开发者、计算机图形学爱好者。使用场景包括学术研究中NeRF编辑效果对比实验、3D场景风格化改造、数字孪生场景外观调整、元宇宙虚拟空间自定义设计、NeRF编辑算法性能验证等。

chisquares.com
Chisquares是聚焦调查研究领域的样本生成与调研辅助工具,核心定位为面向各类调研需求用户提供全流程调研支持服务。其核心功能包括多维度代表性样本生成,可覆盖全球多数国家的国家级与州级区域样本;样本量智能计算功能,可依据调研置信水平、误差范围等参数输出适配的样本规模;AI调研问题生成与内置数据收集平台,可一站式完成问卷设计到数据回收的全流程操作。工具面向学术研究人员、市场调研从业者、企业战略分析人员、高校学生、政策研究人员、社会组织调研人员等群体,适用于学术课题调研、消费者行为研究、公共政策民意调查、品牌市场洞察、社会议题调研、课程实践作业等多种场景。

onevfall.github.io
DiTCtrl是基于多模态扩散变换器(MM-DiT)架构的视频生成模型工具网站,核心定位是为用户提供无需额外训练的多提示连贯视频生成服务。网站支持多段连续文本提示输入生成连贯场景视频,内置MPVBench多提示视频生成评估基准,可对生成结果做量化性能检测,还能实现电影风格的画面过渡效果配置。目标用户覆盖AI视频研发人员、内容创作从业者、学术研究人员等群体,可应用于短视频内容制作、学术实验验证、影视分镜预演、创意视频Demo制作等多种场景。

meetsurvey.com
SurveyAnalyzer是一款基于人工智能技术的调查数据分析工具,核心定位是帮助用户从多渠道回收的问卷数据中快速提取有效洞察,降低问卷分析的技术门槛。平台支持Google Forms、Typeform、Qualtrics、Survey Monkey、Zoho Survey、Jotform等多款主流问卷工具的数据接入,内置智能洞察生成、多维度交叉分析、开放式问题语义分类、自定义报告导出等核心功能。目标用户覆盖市场调研人员、产品经理、高校科研人员、企业运营人员、学生群体、客户 success 团队等,可应用于用户满意度调研分析、产品需求调研整理、学术问卷数据处理、市场调研结果解读、员工反馈调研汇总等多种场景,帮助用户减少问卷数据手动整理的工作量,提升数据分析的效率。
geometric-rl.mpi-inf.mpg.de
SRM是德国马普信息研究所开发的基于去噪生成模型的空间推理框架,核心定位为解决连续变量集合的推理任务,适用于空间数据生成、概率分布建模等研究场景。核心功能包括连续变量分步推理、独立噪声水平分配、生成顺序智能预测、幻觉现象抑制、复杂分布适配,目标用户为人工智能领域研究人员、计算机视觉算法开发者、生成模型从业者、高校计算机相关专业师生、空间数据分析人员,可用于三维空间数据生成、多模态变量推理、生成模型效果优化、空间推理算法实验等场景。

visualcloze.github.io
VisualCloze是一个基于视觉上下文学习的通用图像生成框架站点,核心定位为突破传统任务特定图像生成模型的局限性,支持多场景图像生成与任务泛化。站点内置任务可视化示例库、自定义图像填充、未见过任务泛化测试、生成结果对比分析、模型参数调优五大核心功能,面向计算机视觉研究人员、AI图像开发从业者、高校相关专业学生、内容创作团队、产品原型设计人员、AI技术爱好者群体,可用于学术研究中的模型效果验证、实际业务中的图像内容生成、新图像任务的快速适配测试、不同生成模型的效果对比实验等场景。

datalimeai.com
Lime AI是一款AI数据研究助手类工具,核心定位是为用户提供智能化的数据查询、整合与分析服务。核心功能包括多源数据聚合检索,可覆盖公开网页、行业报告、学术文献等多个数据源的内容抓取;AI驱动的结构化分析,能自动梳理数据关联、生成趋势总结;可视化报表生成,支持将分析结果转化为直观的图表、看板。目标用户覆盖市场调研人员、学术研究者、企业运营人员、内容创作者等群体,可应用于行业趋势调研、学术文献梳理、竞品数据收集、运营数据复盘、内容素材整理等多种场景,帮助用户降低数据处理的人力成本,提升数据研究的效率。

make-an-audio-2.github.io
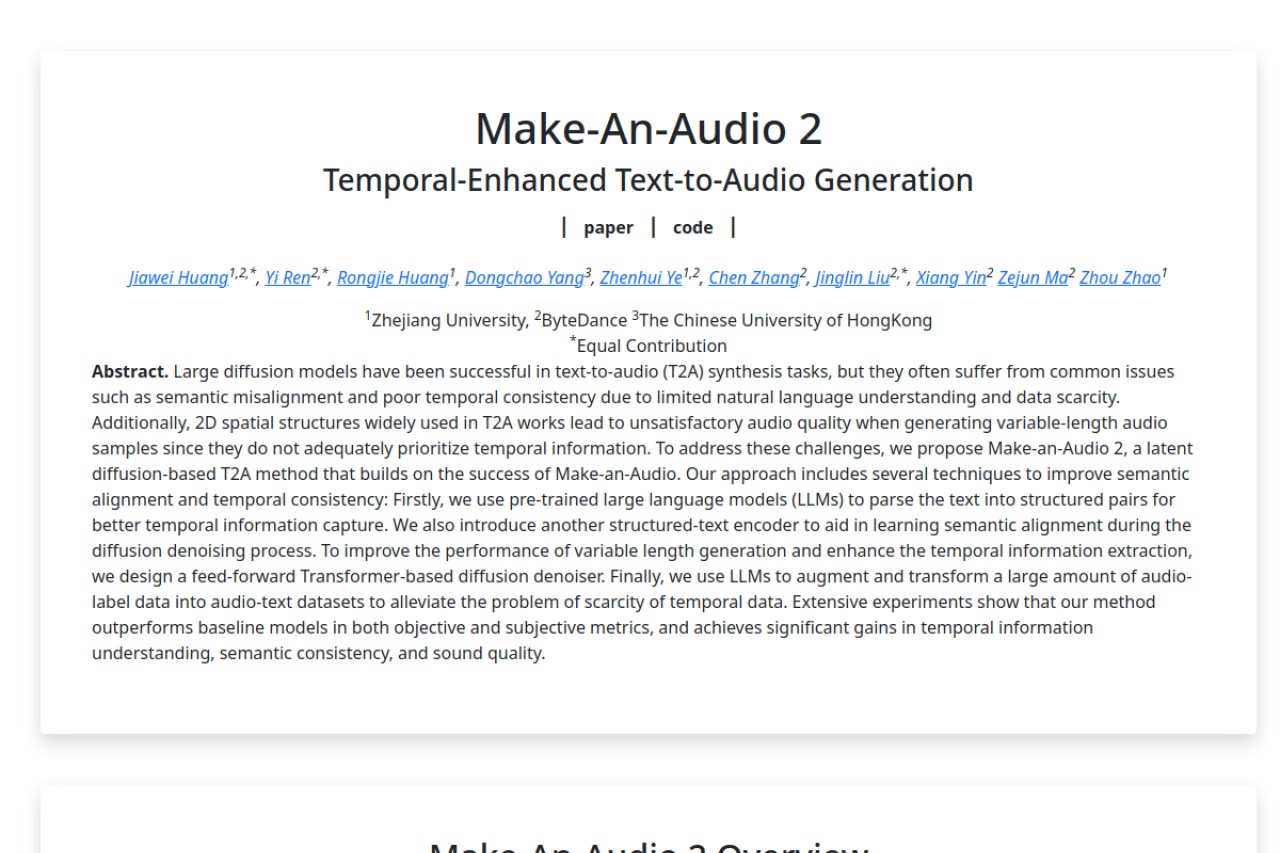
Make-An-Audio 2是由浙江大学、字节跳动、香港中文大学联合研发的文本到音频生成技术官方展示站点,核心定位为面向学术研究与创意开发群体的音频生成技术演示平台。核心功能包括文本语义解析转音频、变长音频生成、音频时间一致性优化、音频生成效果对比展示。目标用户覆盖音频领域研究人员、AI技术开发者、内容创作从业者、高校计算机相关专业师生。使用场景包括学术研究中的技术效果验证、内容创作前期的音效小样生成、AI音频技术开发的算法参考、高校相关课程的技术案例演示。
llava-vl.github.io
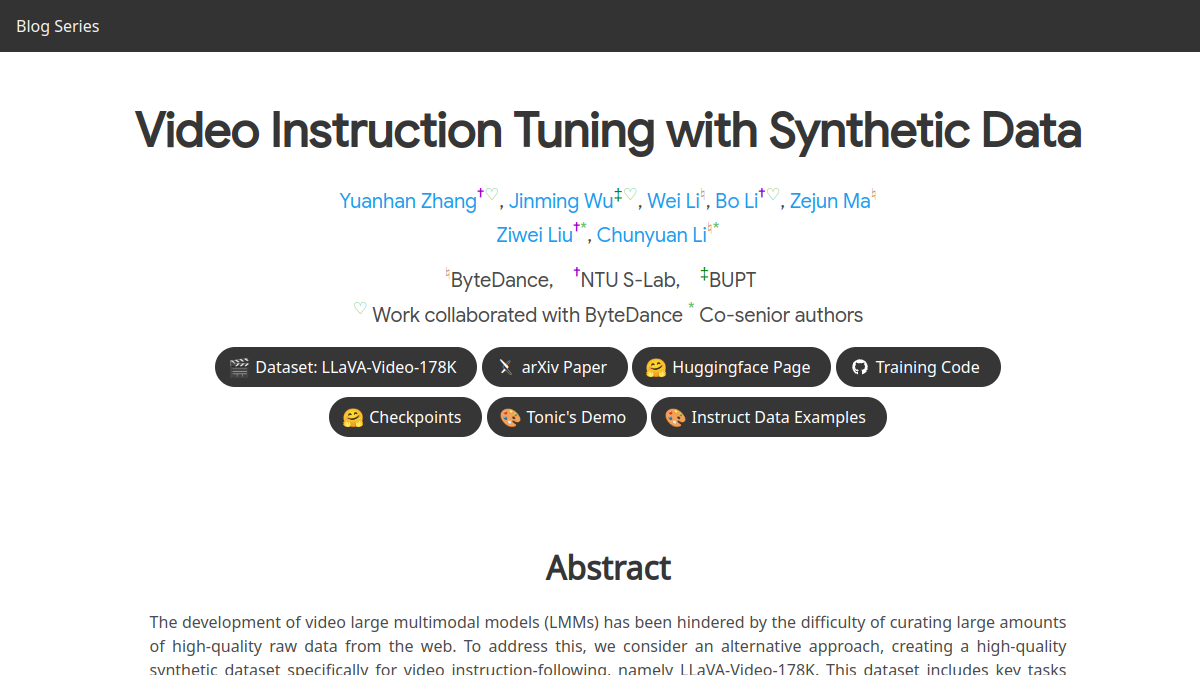
LLaVA-Video是专注于视频领域的大型多模态模型项目,核心定位为通过指令调优提升视频理解与推理能力。核心功能包括构建高质量视频指令调优数据集LLaVA-Video-178K,覆盖多类视频理解任务;支持开放式问答、多项选择问答、细粒度视频描述等多场景推理;提供模型基准测试结果与训练方案参考。目标用户覆盖AI研究人员、多模态模型开发者、视频内容分析从业者等,可用于学术研究实验、视频分析工具开发、多模态模型迭代优化等场景,为视频方向的多模态技术落地提供数据与模型参考。
sanderwood.github.io
CLaMP 3是一个基于对比学习训练的音乐信息检索模型演示站点,核心定位是实现跨模态、跨语言的音乐特征对齐与检索服务。核心功能包括文本到音乐检索、乐谱图像到音乐检索、多语言音乐特征匹配,支持用户输入不同形式的查询内容,匹配对应的音乐资源。目标用户覆盖音乐研究人员、音乐创作者、版权从业人员、文化研究学者等群体,可应用于音乐素材查找、版权溯源、传统音乐数字化整理、跨语言音乐资源检索等多个场景,帮助用户突破模态和语言限制,完成多元音乐信息的匹配需求。
wery.ai
Wery.AI是一个支持多专业智能体协同并行执行任务的AI工作空间平台,面向有复杂任务处理需求的创作者、研究者与从业者提供定制化智能协作服务。平台支持用户自定义智能体角色与任务流程,可同时调用多个不同定位的AI模型分工处理同一项目,也支持任务结果整合与二次编辑,帮助用户拆分复杂工作,提升任务处理效率,适用场景包含内容创作、学术研究梳理、产品开发策划、数据整理分析等多类需要多模块协作的工作需求。
goover.ai
Goover是一款面向研究与学习场景的AI研究助手,依托特定领域知识储备与先进搜索能力,为用户提供精准的信息整理与研究支持。核心功能支持领域定向搜索、研究文献整理、研究大纲生成、内容总结提炼以及观点交叉验证,同时支持多轮对话调整输出内容。服务目标用户包括学术研究人员、在校学生、行业分析师、内容创作者等,适用于课题前期调研、文献综述撰写、行业报告整理、知识内容梳理等多种研究学习场景。

dreamllm.github.io
DreamLLM是专注于多模态大语言模型研发的开源学习框架,核心定位是打破传统多模态模型的技术瓶颈,实现理解与创作能力的协同提升。核心功能包括原生多模态空间采样生成、无外部特征依赖的语义理解、跨模态联合分布建模三类,支持研究人员快速复现多模态生成实验,也可供AI开发人员搭建跨模态内容生成系统。目标用户覆盖AI领域研究学者、大模型开发工程师、高校计算机相关专业师生等群体,适用于多模态模型技术研发、跨模态内容生成工具开发、大模型相关学术实验验证等场景。
scite.ai
scite是一款基于人工智能技术的学术研究工具,核心定位为帮助科研人员分析学术文献的引用上下文,判断引用性质。平台可自动识别文献引用类型,区分支持性、矛盾性与提及类引用;支持单篇文献的引用维度质量分析,也可按主题检索相关领域的引用争议内容。目标用户覆盖高校科研人员、研究生、期刊编辑、科技政策研究者等群体,适用于文献综述撰写、科研选题调研、投稿前学术可信度核查、期刊稿件同行评审辅助等场景,可帮助用户更全面地判断学术成果的实际接受度与争议点。
wolframalpha.com
WolframAlpha是由Wolfram Research推出的计算知识引擎,核心定位是基于结构化知识库为用户提供可溯源的专业领域计算与知识查询服务。核心功能包括多学科公式推导计算、跨领域知识事实检索、自定义数据可视化生成,目标用户覆盖学生、科研人员、行业从业者、教育工作者等群体,可应用于课程作业解题、学术研究数据验证、行业参数计算、科普内容查证等多种场景,区别于常规搜索引擎的网页信息聚合模式,所有结果均通过内置知识库算法计算生成,信息来源可追溯,专业属性突出。
fodda.ai
Fodda是一款聚焦提升AI推理与输出准确度的AI辅助工具,核心通过专家整理的专业知识库与真实机构公开证据资源,替代AI生成内容时常用的通用背景信息,输出结果附带可溯源依据。其核心功能包括机构证据检索、专业知识匹配、生成结果溯源校验,适合学术研究人员、内容创作者、行业分析师、法律从业者等群体,可用于学术论文论据核对、行业报告内容校验、专业内容创作素材补充、法律文书事实核验等多种场景,帮助用户降低AI生成内容的事实性错误概率。
readfrog.app
陪读蛙是一款聚焦外文文献处理的AI辅助阅读工具,核心为学术场景下的英文论文、专业文档提供智能解析服务。平台支持多格式文档上传、分段落精准翻译、结构化摘要生成、关键信息自动提取等功能,可降低外文文献的阅读门槛,缩短信息筛选周期。目标用户覆盖高校学生、科研人员、学术译者、行业研究员等群体,适用于文献综述撰写、外文资料调研、学术论文精读、专业内容翻译等多个场景,助力用户提升学术研究及资料整理的效率。

feisoo.com
飞搜侠是聚焦AI搜索服务的智能化工具平台,核心定位为用户提供高效的信息检索与内容整合服务。平台支持多模态内容搜索、AI摘要生成、跨源信息聚合三类核心功能,面向内容创作者、学术研究者、职场办公人员等多类群体,适用于资料收集、内容创作参考、行业信息调研、日常信息查询等多种场景,帮助用户减少信息筛选的时间成本,提升信息获取效率。
researchpal.co
ResearchPal是面向学术研究、文献整理场景的AI辅助工具,核心定位是为研究人员降低文献处理的时间成本。其核心功能包括多格式文献解析、语义化文献综述生成、引用格式自动校准,支持PDF、Word等常见文献格式上传,可基于上传文献自动提炼核心观点与研究脉络。目标用户覆盖高校学生、科研人员、行业研究员等群体,适用于课程论文撰写、课题文献调研、学术期刊投稿、行业研究报告撰写等多种场景,帮助用户更高效地完成文献相关的研究工作。
giantailab.github.io
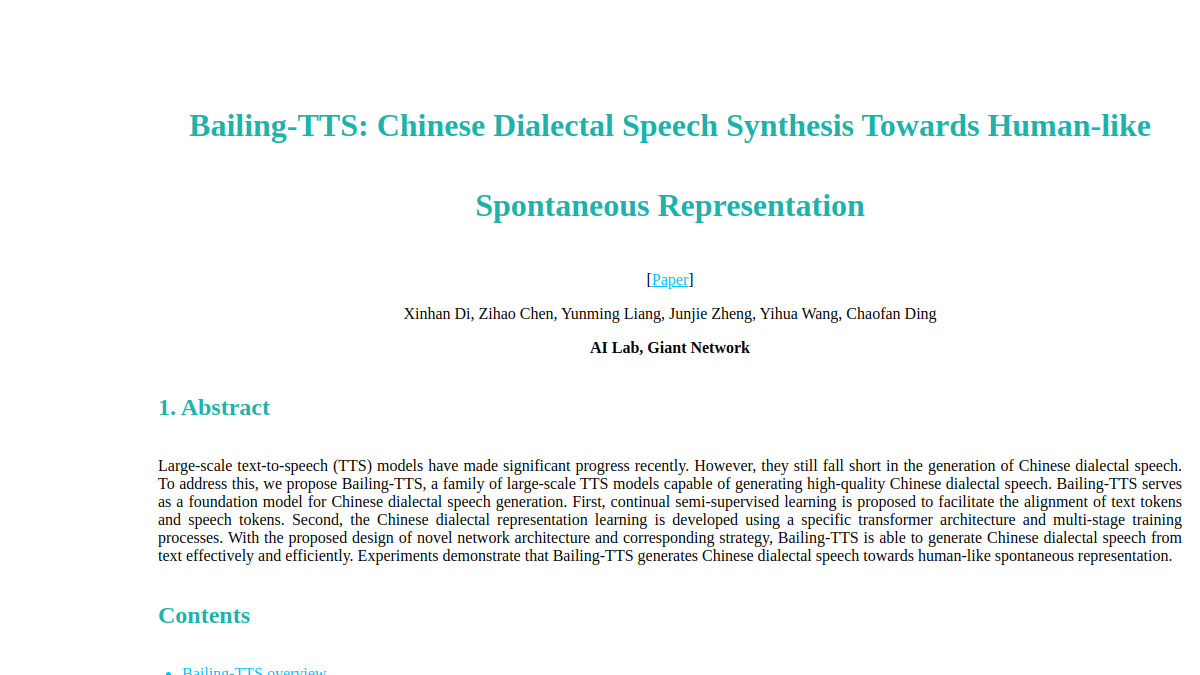
Bailing-TTS是巨人网络AI Lab研发的中文方言文本转语音模型系列技术站点,核心定位为方言语音合成技术的展示与技术方案输出。站点支持多类中文方言的语音合成效果预览,提供完整的技术架构说明与训练方法解析,同时公开模型相关实验对比数据。目标用户覆盖语音技术研发人员、方言文化传播从业者、内容创作群体以及相关学术研究人员,可应用于方言有声读物制作、方言语音交互产品开发、地方文化内容数字化留存、多语言语音产品原型测试等多个场景。