视觉语言模型
mmstar-benchmark.github.io
MMStar是面向大型视觉语言模型多模态能力评估的基准测试集平台,核心定位是为多模态模型研发领域提供标准化、低偏差的能力评测方案。平台包含1500个经过人工筛选的视觉语言样本,覆盖6类核心能力与18个细分评估维度,同时提供传统准确率之外的两套新增评估指标,可帮助研究者识别模型数据泄露风险、量化多模态训练带来的实际性能增益。其目标用户涵盖AI领域研究人员、多模态模型开发团队、高校人工智能相关专业师生,可应用于模型迭代效果验证、学术研究实验评测、模型公开能力对比等多种场景。
jerryxu.net
PixelLLM是一个专注于图像定位任务的视觉-语言模型展示站点,核心功能涵盖位置引导的图像描述生成、文本引导的像素坐标定位、多数据集性能结果查询。该站点面向计算机视觉研究者、AI算法开发人员、多模态学习领域学生,可用于学术研究参考、模型效果验证、相关任务技术选型等场景,帮助用户直观了解视觉与像素对齐技术的落地表现。
video-language-planning.github.io
Video Language Planning(简称VLP)是面向机器人任务规划领域的算法展示与技术说明站点,核心定位是展示基于视觉语言模型与文本到视频模型结合的长期任务视觉规划方案。站点核心功能包括算法原理的可视化讲解、不同应用场景的实验结果展示、可复现的技术实现文档开放,目标用户覆盖机器人研发人员、多模态AI研究者、高校自动化相关专业师生,可用于机器人任务规划算法调研、多模态模型落地机器人场景的技术参考、相关领域学术研究的案例参考等场景。
mini-gemini.github.io
MiniGemini是开源多模态视觉语言模型项目站点,核心提供不同参数规模的视觉语言模型资源与相关技术文档。站点支持多版本模型下载、技术框架说明、基准测试结果展示三大核心功能,面向AI科研人员、多模态应用开发者、计算机专业学生、算法工程师等群体,可应用于多模态模型性能验证、视觉理解应用开发、学术研究对比、模型技术学习等多种场景,帮助用户快速获取MiniGemini模型相关技术细节与使用资源。

emova-ollm.github.io
EMOVA全称是EMotionally Omni-present Voice Assistant,是一款多模态语言模型工具网站,核心定位为实现端到端语音处理与高水准视觉-语言能力融合的多模态交互模型。核心功能包括语义-声学解耦的语音分词处理、情感丰富的多模态对话交互、跨视觉与语音模态的任务响应。目标用户覆盖AI模型研究者、多模态应用开发者、语音交互产品设计师、自然语言处理方向学生等群体,可用于多模态模型性能测试、智能语音对话系统开发、情感化交互产品原型搭建、跨模态任务算法验证等场景,帮助用户探索多模态大模型在语音、视觉、语义融合方向的落地可能性。

internvl.opengvlab.com
OpenGVLab InternVL是上海人工智能实验室推出的视觉语言大模型官方体验平台,核心定位是为用户提供可落地的多模态交互能力,支持图像理解、图文问答、OCR识别等核心功能,适合AI开发者、内容创作者、科研人员、企业技术团队等群体使用,可应用于学术研究验证、内容素材标注、业务场景原型测试、多模态应用开发等多个场景,帮助用户快速验证视觉语言模型的能力边界,降低多模态技术的试用门槛。

helpful-doggybot.github.io
Helpful DoggyBot是面向四足机器人研发的室内移动操作系统,核心围绕四足机器人的室内任务执行需求设计,可支持机器人实现复杂环境下的移动与操作。系统搭载模拟训练的低级运动控制器,可实现攀爬、全身倾斜等敏捷动作;同时融合预训练视觉-语言模型,具备语义理解与指令生成能力;支持零样本泛化,无需额外实地数据采集或训练即可在陌生环境执行任务。目标用户涵盖机器人研发人员、高校自动化相关专业师生、智能硬件开发团队、室内服务机器人方案提供商等,可应用于四足机器人运动算法验证、室内服务机器人任务逻辑调试、多模态交互机器人原型开发、机器人零样本泛化能力测试等场景。

chrisjuniorli.github.io
CuMo是面向多模态大模型技术研究与落地场景的开源架构方案展示平台,核心定位为多模态大型语言模型的可扩展架构技术输出站点。平台核心功能包括CuMo架构技术细节公开、基准测试对比数据查询、训练流程文档下载、相关开源数据集索引,以及模型部署参考方案展示。目标用户覆盖人工智能领域科研人员、多模态模型开发工程师、高校AI相关专业师生、AI创业团队技术负责人等群体,可应用于多模态模型架构优化研究、VQA系统开发、视觉指令遵循模型训练、大模型可扩展性技术验证等场景,帮助相关从业者了解稀疏门控专家混合技术在多模态大模型中的落地路径。

moondream.ai
Moondream AI是专注于开源视觉语言模型研发与落地的技术服务平台,核心定位是为开发者提供轻量高效的多模态AI能力支持。平台提供多格式量化模型下载服务,支持fp16、int8、int4等多种精度版本,适配服务器、PC、移动设备等不同硬件环境;提供开箱即用的推理部署工具包,包含GPU/CPU双端优化方案,降低部署门槛;还提供模型二次开发文档与社区支持,方便开发者根据业务需求调整模型参数。服务目标人群覆盖AI应用开发者、嵌入式设备研发人员、科研机构研究人员等,可应用于端侧智能图像识别、离线多模态交互、行业定制视觉问答等多种业务场景。
algolzw.github.io
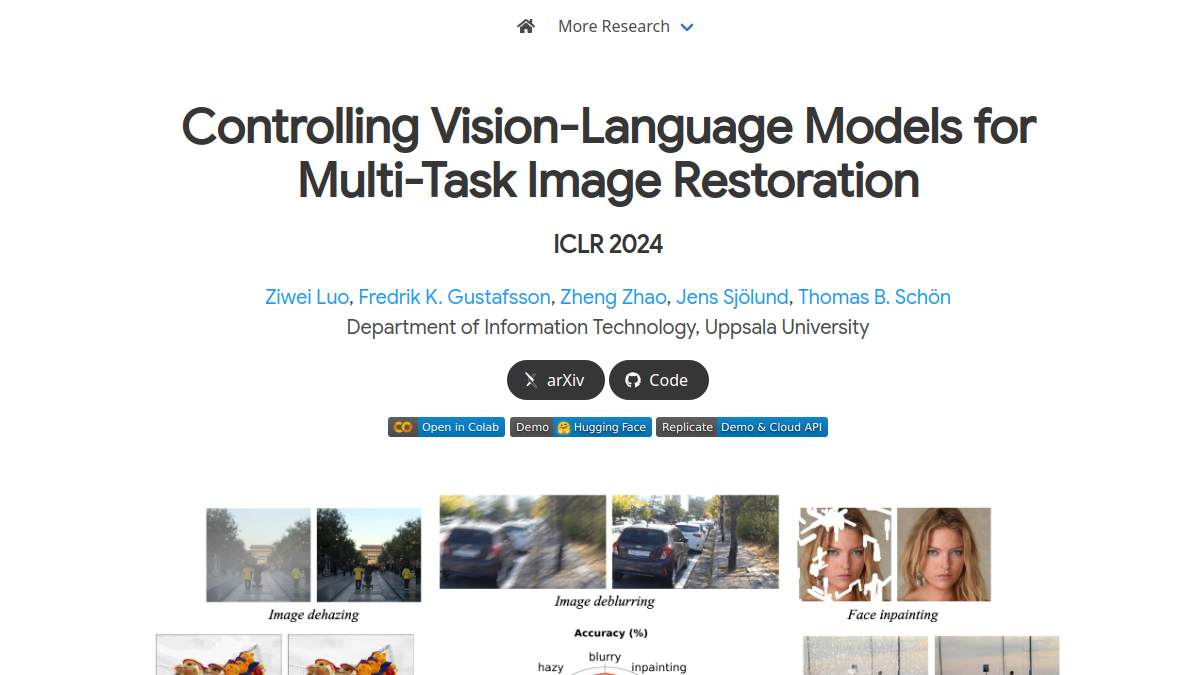
DA-CLIP是专注于图像恢复领域的降级感知视觉语言模型官方展示站点,核心定位为面向学术研究与工业应用的通用图像恢复技术方案载体。站点核心功能包含DA-CLIP模型技术原理详解、多场景图像恢复效果对比演示、混合降级数据集训练成果展示三类内容,主要面向计算机视觉领域研究人员、图像算法开发工程师、高校相关专业师生、数字内容处理从业者等群体,可用于学术研究参考、算法选型评估、教学案例演示、实际业务场景落地验证等多种场景,帮助用户直观理解降级感知视觉语言模型在图像恢复任务中的应用逻辑与实际效果。
dl3dv-10k.github.io
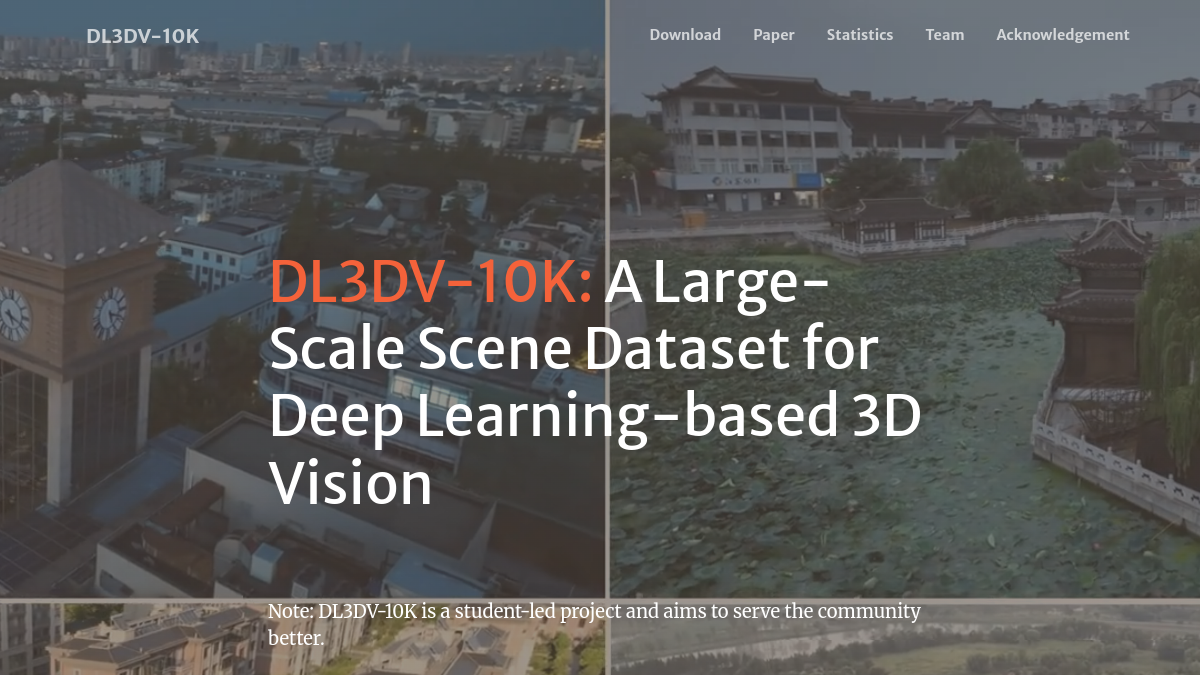
DL3DV-10K是面向计算机视觉领域研究人员的大规模实景3D视频数据集平台,核心定位为3D视觉相关研究提供标注完备的大规模训练与测试数据源。核心功能包含万级规模多场景标注视频库,覆盖日常室内、户外街道、自然景观等多元场景,配套标注包含相机姿态、NeRF估计深度、点云、3D网格等多类3D相关数据,同时提供场景复杂度、关键点人工标注结果,可支持NeRF模型训练优化、场景一致性跟踪算法验证、视觉语言模型跨模态关联研究等方向,目标用户涵盖高校计算机专业研究者、AI实验室研发人员、3D视觉相关算法开发人员,适用于论文实验数据支撑、算法性能基准测试、3D重建技术迭代验证等场景。
tsinghua-mars-lab.github.io
DriveVLM是清华大学MARS实验室推出的自动驾驶研发系统,核心定位是将视觉语言模型能力融入自动驾驶流程,提升复杂场景下的感知与决策表现。该系统具备场景语义描述、多维度场景分析、分层驾驶规划三类核心功能,同时推出混合架构的DriveVLM-Dual版本,平衡大模型推理能力与传统自动驾驶系统的空间计算、实时响应优势。目标用户覆盖自动驾驶领域研究人员、高校相关专业师生、自动驾驶企业技术研发团队,可用于自动驾驶算法迭代、长尾场景处理方案验证、大模型在自动驾驶领域的落地研究等场景,相关实验成果已在nuScenes、SUP-AD公开数据集以及量产实车环境中完成验证。
nvlm-project.github.io
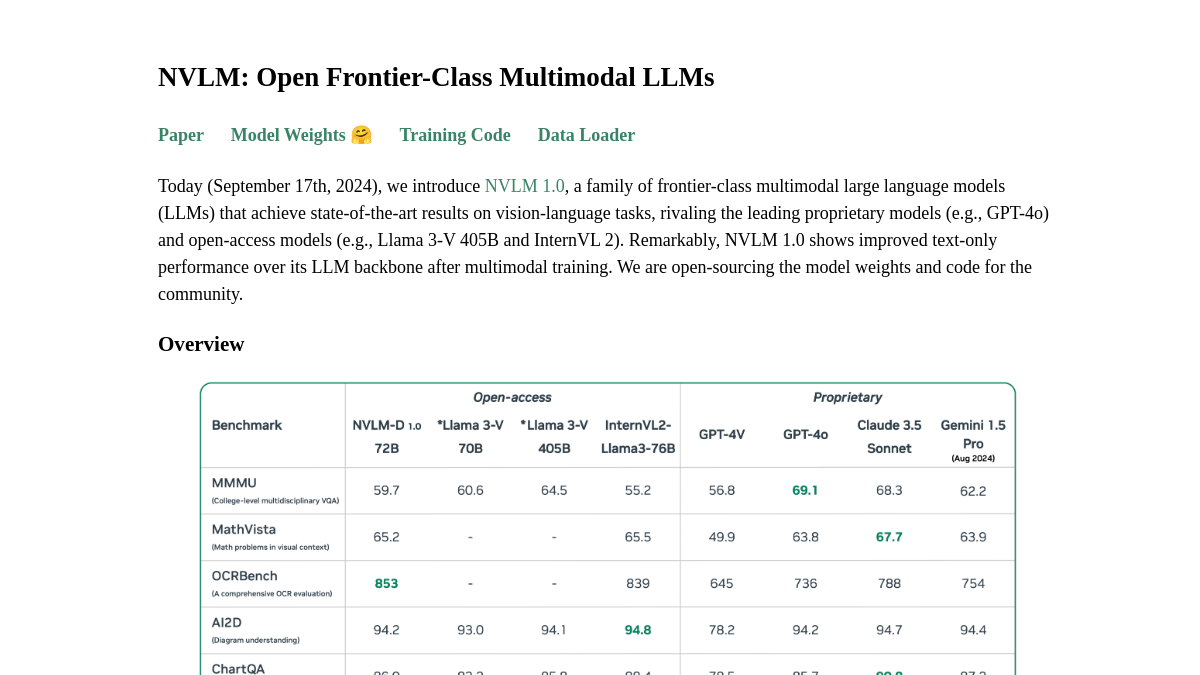
NVLM是一个开源多模态大型语言模型项目站点,核心定位为向学术研究与产业开发群体提供高性能的视觉-语言融合模型资源。项目核心功能包含多模态模型权重开源下载、训练推理代码仓库访问、模型性能基准测试结果公开,同时配套模型适配与二次开发指导文档。目标用户覆盖AI领域研究人员、应用开发工程师、高校相关专业师生等群体,可应用于多模态任务性能对比、定制化视觉理解应用搭建、多模态模型技术原理研究等多个场景,为多模态大模型技术落地与学术探索提供可复用的基础资源。

adithya-s-k.github.io
VARAG是一款聚焦多模态文档检索的开源技术系统,核心定位是优化文本、图像及混合类型文档的检索效率与准确率。它支持页面级图像嵌入编码,可直接将文档页面以图像形式纳入检索流程,无需复杂的内容拆分预处理;搭载视觉语言模型完成内容理解编码,能够识别文档中的图表、手写批注、版式元素等非结构化内容;支持检索结果的相关性排序与内容溯源,方便用户快速定位目标文档片段。该系统面向AI研发人员、文档管理从业者、多模态技术研究者等群体,适用于企业内部知识库检索、学术文献批量检索、扫描版文档内容查找、多模态数据集内容筛选等场景。
spatial-vlm.github.io
SpatialVLM是谷歌DeepMind研发的空间视觉语言模型展示站点,核心定位是呈现可实现定量空间关系理解与推理的多模态模型能力。平台支持空间视觉问答测试、空间推理路径可视化、机器人控制场景效果演示三类核心功能,面向AI研究者、机器人开发工程师、多模态模型学习者、计算机视觉领域从业者,可用于空间推理类模型性能验证、机器人导航逻辑预测试、多模态模型训练方向参考等场景,帮助用户直观了解空间视觉语言模型的技术特点与落地可能性。
craftjarvis.github.io
ROCKET-1是专注于开放世界具身决策场景的视觉-语言模型,核心定位是打通视觉语言大模型与具身策略模型的通信链路,提升智能体在开放交互环境中的任务完成能力。核心功能包括视觉-时间上下文提示协议构建、多帧观测对象分割引导、长序列复杂任务推理调度三类,主要面向人工智能研究人员、具身智能开发人员、开放世界游戏AI开发人员等群体,可应用于虚拟世界智能体训练、机器人具身决策算法验证、复杂开放环境任务推理研究等场景,为具身智能领域的视觉语言融合方案提供可参考的实现路径。