大模型评测
mmstar-benchmark.github.io
MMStar是面向大型视觉语言模型多模态能力评估的基准测试集平台,核心定位是为多模态模型研发领域提供标准化、低偏差的能力评测方案。平台包含1500个经过人工筛选的视觉语言样本,覆盖6类核心能力与18个细分评估维度,同时提供传统准确率之外的两套新增评估指标,可帮助研究者识别模型数据泄露风险、量化多模态训练带来的实际性能增益。其目标用户涵盖AI领域研究人员、多模态模型开发团队、高校人工智能相关专业师生,可应用于模型迭代效果验证、学术研究实验评测、模型公开能力对比等多种场景。
wizardlm.github.io
WizardLM-2是WizardLM团队推出的新一代大型语言模型官方介绍站点,核心定位为面向AI开发人员、研究人员提供大模型技术细节、使用方法与落地参考的技术平台。站点公开了8x22B、70B、7B三个参数规格的模型训练框架与性能基准,提供模型下载指引与推理部署教程,支持用户查看不同场景下的模型效果实测数据。目标用户覆盖AI研究人员、应用开发工程师、企业AI技术负责人、高校AI相关专业学生,可用于大模型选型评估、定制化微调训练、下游AI应用开发、学术研究对比等多种场景。

medium.com
该页面是发布在Medium平台的技术分析文章,核心定位为深度解析GPT-4o (Omni)多模态大模型的功能特性与应用价值。文章梳理了模型在文本生成、图像理解、音频交互三类场景的落地表现,同时对比了前代模型的能力差异。目标用户涵盖AI技术爱好者、产品开发者、行业研究者等群体,适合需要了解GPT-4o核心能力、评估其商业化落地可能性的读者阅读,也可作为技术选型、功能设计时的参考资料。
superclueai.com
SuperCLUE是面向大语言模型性能评估的专业在线平台,核心定位为AI领域模型能力的标准化评测工具矩阵。平台内置多维度评测任务集,覆盖基础语义理解、复杂逻辑推理、垂直场景适配等多个评测维度,同时支持自定义评测数据集上传;平台定期更新综合排行榜,直观呈现不同大模型在各任务上的表现差异。目标用户包括AI领域研究者、大模型开发团队、AI应用开发者、高校AI相关专业师生等,可应用于模型迭代效果验证、大模型选型对比、学术研究实验支撑、AI应用落地前的模型适配度测试等多种场景。
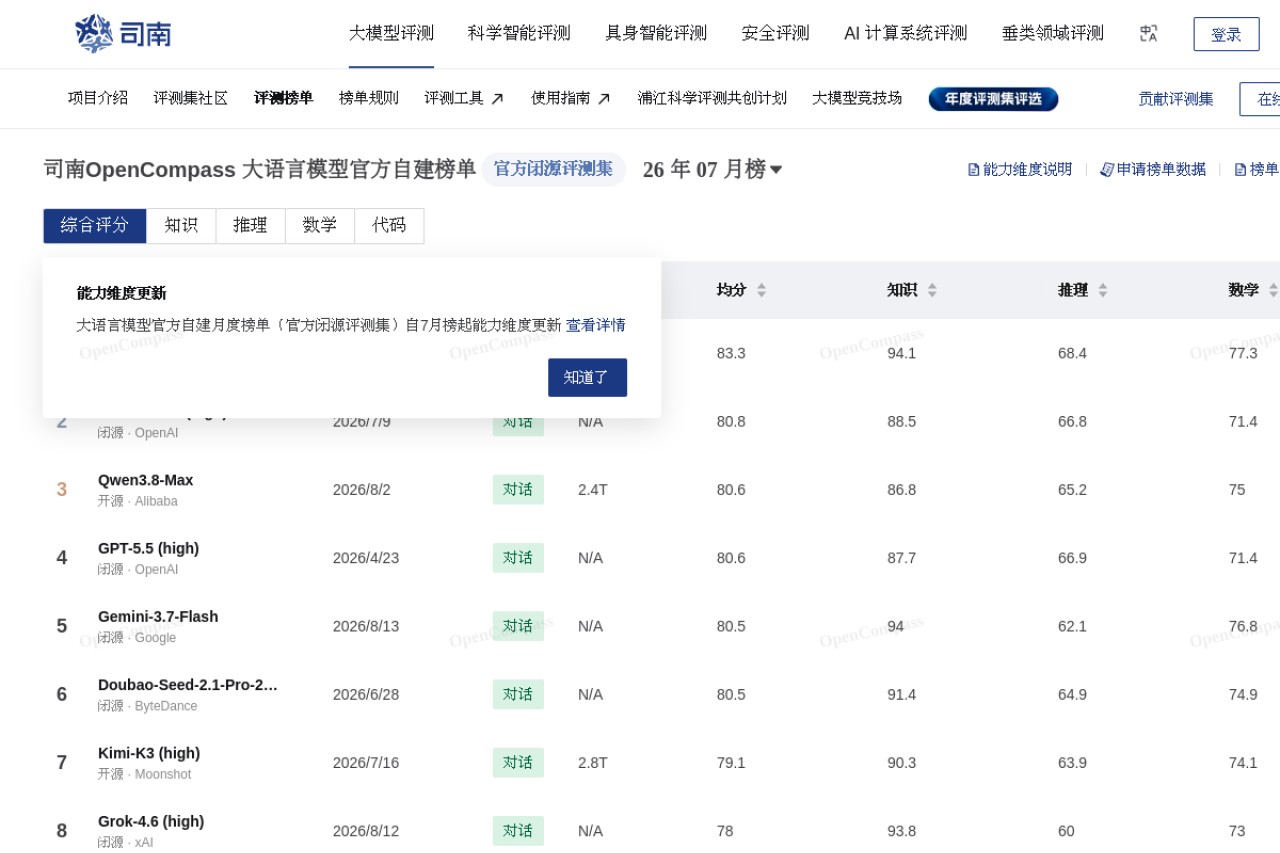
rank.opencompass.org.cn
OpenCompass 2.0 Large Language Model Leaderboard是面向大语言模型领域的专业性能评估平台,核心定位是提供中立、多维度的大模型能力评测结果展示。平台支持全球主流大语言模型的多维度能力评估,覆盖语言理解、知识储备、逻辑推理、数学计算、代码开发等多个技能维度,可生成模型综合排名与单项能力得分对比,支持不同模型的横向能力对标。目标用户包含大模型研发人员、AI领域研究者、企业技术选型负责人、AI应用开发者、高校计算机专业师生等群体,可用于大模型研发效果验证、学术研究性能参照、企业落地模型选型、AI应用开发模型匹配等多种场景,为大模型相关的研发、选型、研究工作提供客观的数据参考。

damoai.com.cn
大模型之家是专注于人工智能大模型产业的信息聚合与产业服务平台,核心定位为大模型领域的垂直信息枢纽。平台核心功能包括大模型行业动态更新、产业研究报告汇总、大模型产品评测发布三类。目标用户覆盖大模型从业者、科技企业决策者、AI技术学习者、创投机构从业者等群体,可满足用户了解行业趋势、获取研究资料、选型大模型产品、挖掘产业合作机会等多场景需求,为不同角色的用户提供大模型领域的信息支持。

rank.opencompass.org.cn
OpenCompass司南是由上海人工智能实验室联合多家机构发起的开源大语言模型评测平台,核心定位为提供中立、可复现的大模型能力评测服务。平台支持超100个主流基准数据集,覆盖知识推理、数学计算、代码生成、语言理解、多模态处理等二十余个能力维度,可满足不同场景下的模型性能核验需求。平台面向大模型研发团队、AI领域研究者、企业技术选型人员、高校相关专业学生等群体,可用于模型研发过程中的能力迭代验证、学术研究中的性能对比、企业落地场景下的模型选型参考等多个场景,同时所有评测流程与数据完全开源,支持用户自定义评测任务配置。

flageval.baai.ac.cn
FlagEval是北京智源人工智能研究院推出的AI模型评测平台,核心定位是为大语言模型、多模态模型提供统一标准的评测服务。平台支持多维度模型性能对比、专项领域定制化评测、评测报告自动生成三大核心功能,面向AI研究者、算法工程师、行业产品经理等群体,可应用于模型研发迭代、选型采购、学术研究性能验证等场景,助力AI技术落地与行业生态建设。
promptpilot.volcengine.com
PromptPilot是火山引擎推出的大语言模型全周期优化平台,核心定位为帮助用户提升AI交互输出质量与匹配度。平台提供智能提示词生成、多维度效果调优、迭代效果追踪三类核心功能,支持用户根据业务需求快速生成适配不同大模型的提示词方案,同时可对提示词效果进行批量测试与持续优化。目标用户覆盖AI应用开发者、企业内容生产团队、AI产品运营人员等群体,适用于智能客服话术优化、AI内容生成质量提升、大模型应用落地调试等多种场景。

lyihub.com
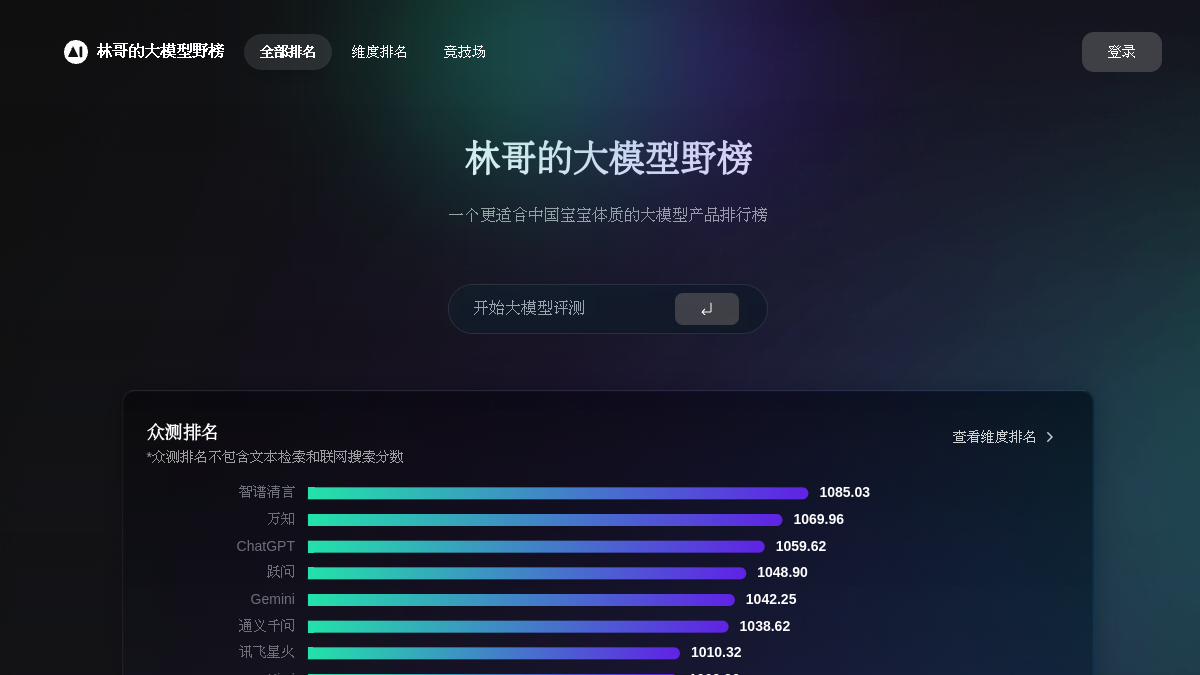
林哥的大模型野榜是聚焦国内大模型产品的第三方评测排名平台,核心定位为面向中文用户的大模型选择参考工具。平台覆盖国内主流大模型产品,提供多维度实测评分、横向对比表、实测案例展示三大核心功能,面向普通互联网用户、AI工具开发者、企业选型人员、内容创作者等群体,可应用于大模型选购决策、行业性能调研、产品特性对比等场景,帮助用户基于真实测试数据了解不同大模型的能力差异,找到适配自身需求的产品。
thefastest.ai
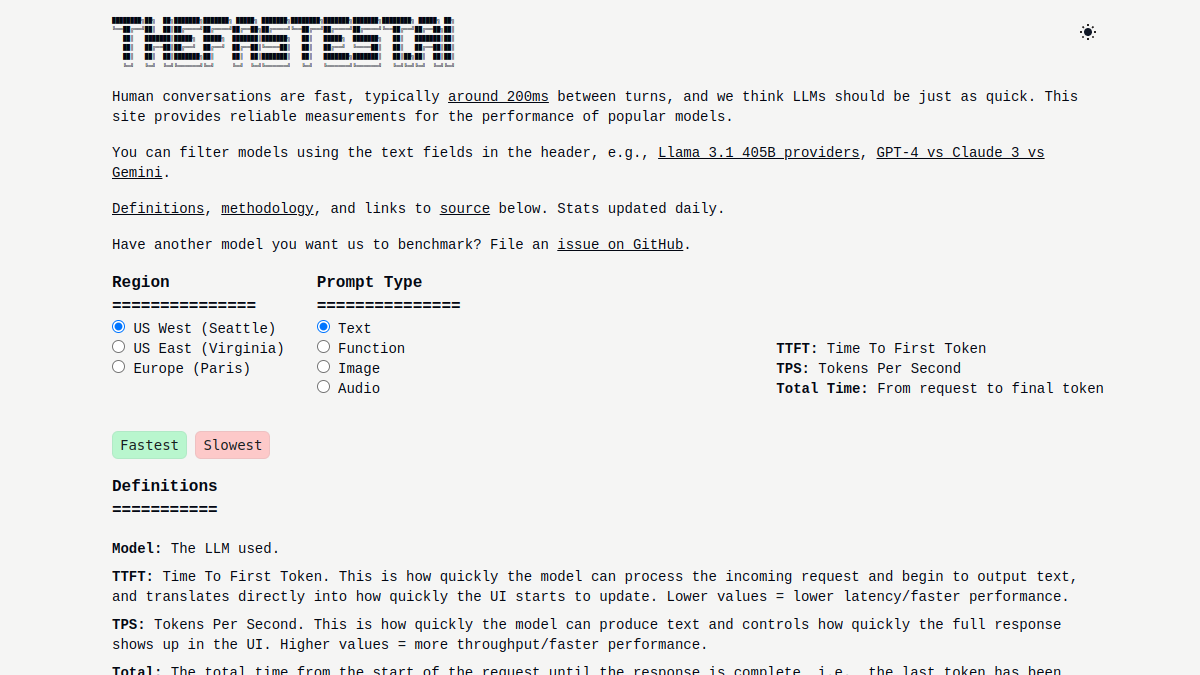
TheFastest.ai是专注于主流AI大模型性能实测与对比的工具类网站,核心定位为用户提供真实、实时的AI模型性能参考数据。核心功能包括多维度模型性能指标测试、多模型横向对比榜单、性能数据每日更新。目标用户覆盖AI工具开发者、企业AI选型负责人、AI产品研究人员、普通AI使用者等群体,可应用于AI模型选型、AI应用性能优化、行业研究数据支撑等多个场景,帮助用户结合自身需求筛选匹配的AI模型服务。

trismik.com
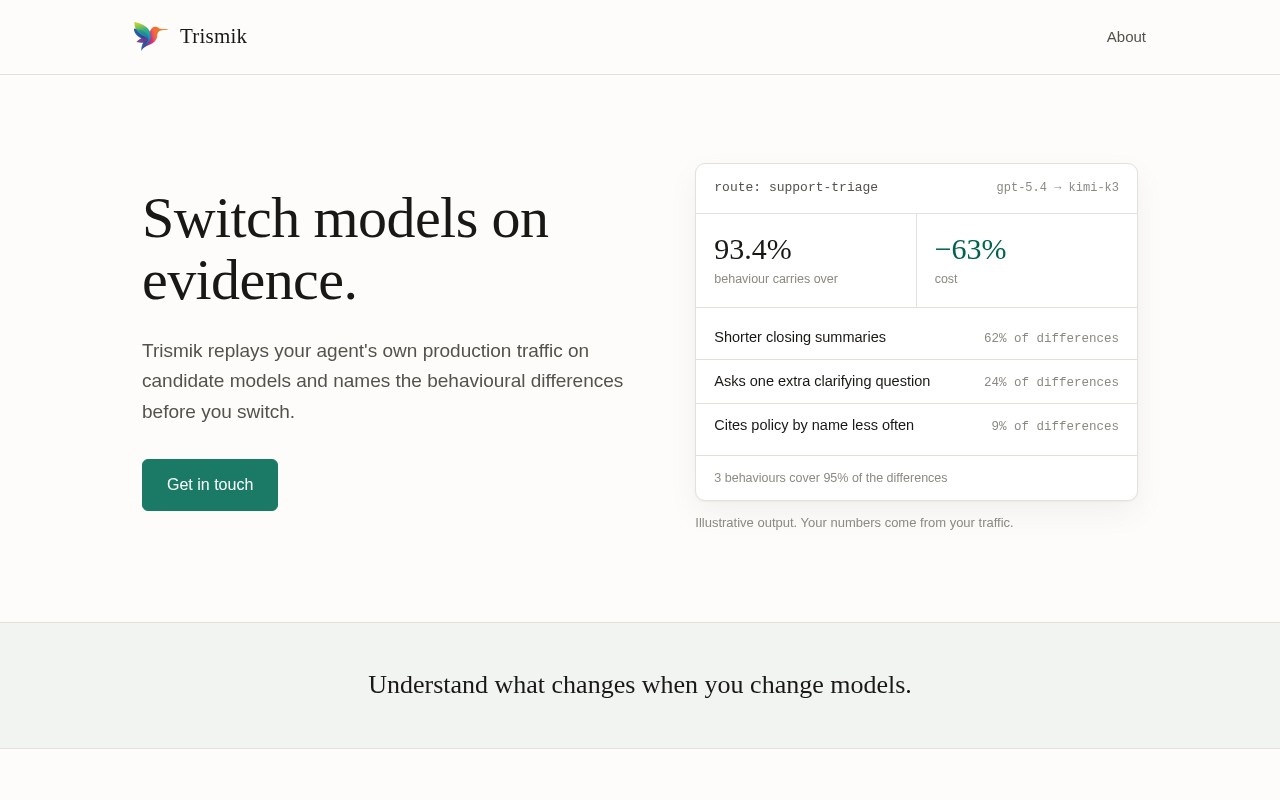
Trismik是一个第三方大语言模型评测对比平台,核心定位是基于自有测试数据,为用户提供不同大语言模型在质量、成本、速度维度的客观对比信息。平台可支持用户查看不同模型在多场景下的评测结果,也可让用户筛选符合自身需求的大语言模型,帮助用户在选择模型时获得参考数据。核心功能包含多维度模型评测、自定义筛选对比、成本估算工具、速度测试展示、模型信息汇总等,面向需要选型大语言模型的开发团队、AI应用创业者、AI研究者等用户,适用在模型选型、项目开发、AI应用部署前的参考对比场景。