- 适用对象
- 大模型研发工程师 校验自研模型跨学科知识理解能力
- 主要功能
- 多学科覆盖评测、分层难度校验
- 已收录
- 2026.10.18(12 天)
阅读目录
编辑评测与站内热度
全站热度排名
待评估
分类内排名
待评估
累计站内点击
1
近 7 日点击
1
排名与点击为站内真实统计口径,反映 Toolifai 用户行为,非编辑评分。
MMLU是什么,怎么使用?
约 4 分钟MMLU 是一个广泛使用的基准,测试模型在多个学科和任务上的语言理解能力,涵盖高中、大学和专业水平的知识。
MMLU是大模型评测领域应用广泛的通用基准,核心解决过往单学科语言理解测试维度窄、分层难度缺失的问题,不会出现模型在单一领域得分虚高但综合知识能力不达预期的偏差。它覆盖从高中、大学到专业执业级别的数十个细分学科任务,通过标准化的试题集对模型的多场景语言理解、知识调用能力做统一校验,评测结果可直接用于不同大模型间的横向能力对标。
它的能力边界集中在多任务语言理解维度,暂不覆盖非文本类的多模态能力评测,也没有内置自定义私有数据集上传的专属校验通道。如果你需要对比不同开源/闭源大模型的通用语言知识储备水平,或者校验自研大模型的跨学科基础理解能力,选择这个基准可以拿到行业认可度较高的对标结果,省去自行搭建多学科测试集的重复工作量。
主要功能
- 多学科覆盖评测:覆盖高中、大学到专业水平的多学科试题,可直接完成跨领域语言理解能力的统一校验,拿到行业通用对标结果
- 分层难度校验:按不同教育、执业层级设置试题梯度,可精准区分不同能力段模型的知识储备厚度,避免单一难度下得分失真
- 行业通用标尺:评测结果适配主流大模型研究的公开对比标准,无需额外调整规则即可和公开的SOTA模型数据做横向对标
- 轻量化接入路径:依托Web端PaperWithCode平台运行,无需本地部署复杂环境,打开浏览器即可查看对应基准的完整测试规则
怎么使用
- 打开浏览器输入给定的MMLU官方对应PaperWithCode页面链接,进入基准的专属详情界面
- 浏览页面内公开的基准测试规则、学科覆盖范围和已有的公开SOTA模型得分参考数据
- 按照页面公示的测试提交规范,上传待评测大模型的对应测试输出结果文件完成提交
- 等待平台自动完成得分核算,查看对应模型在MMLU基准下的各分项得分与综合排名数据
适合什么人群
- 大模型研发工程师 校验自研模型跨学科知识理解能力
- AI算法研究员 做不同大模型公开能力的横向对标分析
- 高校AI方向师生 开展大模型理解能力相关课题实验
- 大模型产品经理 筛选适配知识类场景的候选大模型
用 MMLU 做多学科模型能力横向对比
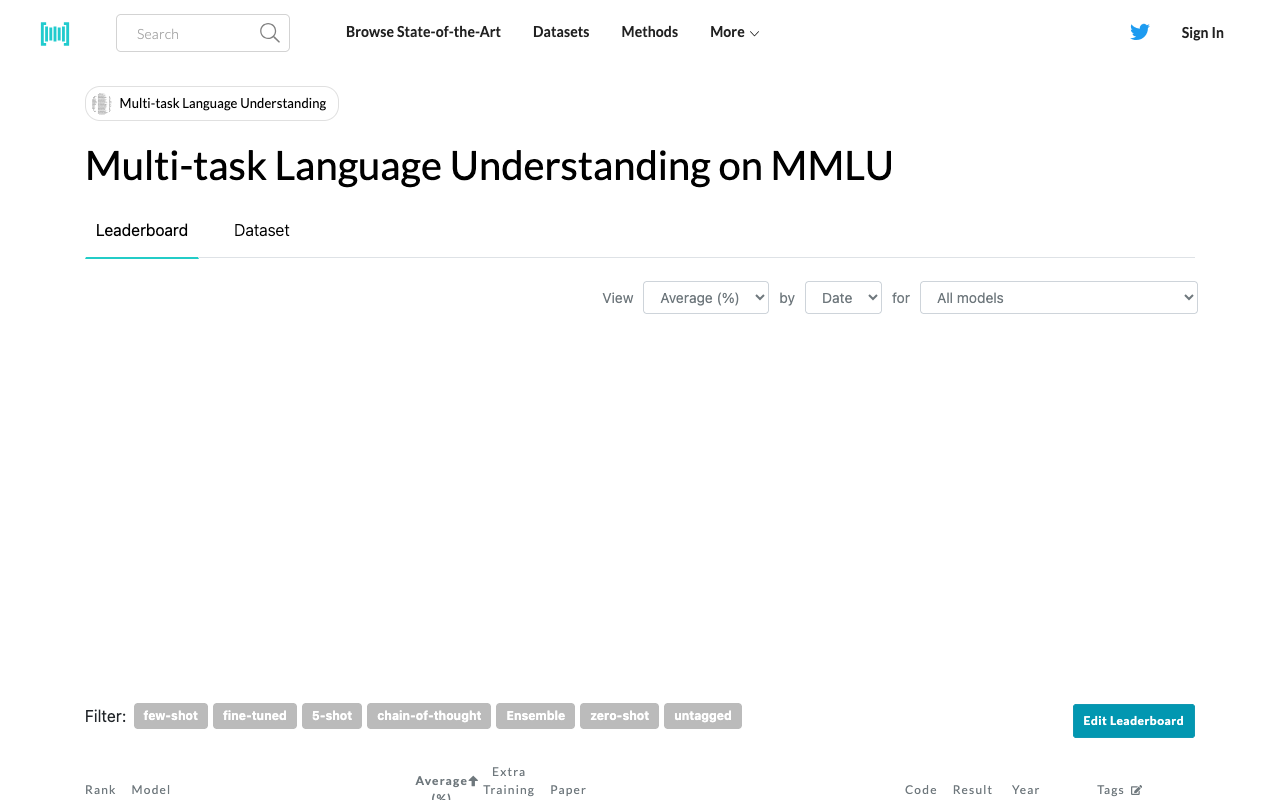
打开浏览器访问 MMLU 官方 Papers With Code 页面,在顶部 SOTA 榜单区域找到筛选栏。勾选你需要覆盖的学科类目,比如数学、法律、医学、计算机科学等,调整筛选条件匹配高中、大学或专业级别的测试难度,点击确认加载结果。页面会自动生成排序后的模型得分列表,每一项都附带对应模型的测试准确率、参数量标注、对应开源项目跳转链接。
你可以点击任意模型条目,查看该模型在每一个细分学科下的单独得分明细,对比不同模型在不同知识维度的表现差异。所有得分数据支持直接复制导出,也可以跳转至对应论文页面查看完整的测试流程细节,无需额外安装本地工具。
用 MMLU 做自研语言模型知识水平校验
在 MMLU 页面的侧边栏找到测试数据集下载入口,获取完整的多学科测试题库文件,题库覆盖不同难度层级的客观选择题及对应标准答案。将自研模型接入测试脚本,按照官方设定的统一规则批量导入题目,完成自动化答题流程后输出结果文件。
把结果文件上传至 MMLU 页面的得分校验入口,系统会自动完成判分,生成对应模型的综合得分报告,标注其在各学科维度的能力短板。你可以将报告得分和榜单上的公开模型数据做对齐参照,确认自研模型的知识掌握水平所处区间。
开始使用 MMLU
直接通过浏览器访问官方指定网页即可进入使用,无需额外注册账号,所有公开榜单、数据集资源都可以直接浏览下载。平台定价未做单独标注,所有可访问的公开内容均以官网公示的使用规则为准。
首次使用可以先浏览首页的默认 SOTA 榜单,熟悉不同学科的得分分布逻辑,再根据自身需求筛选对应难度或学科的测试子集。页面默认语言为英文,操作过程中遇到功能跳转异常的情况,可以刷新页面重新加载,所有测试相关的规则细节都能在页面附带的官方论文链接中查到。
优点与不足
优点
- 覆盖多层级多学科测试维度,评测结果行业认可度高,可直接用于公开横向对标
- 无需本地部署复杂运行环境,依托Web端即可完成全部操作,接入门槛低
- 公开了大量已有的SOTA模型得分参考数据,可直接作为基准参照值使用
不足
- 仅支持文本类语言理解能力评测,不覆盖任何多模态相关的能力测试
- 自定义测试集的修改权限受限,无法自由调整基准内的原有试题内容
- 测试提交规则固定,不支持针对特定垂直领域的定向定制化评测需求
能帮你做的 6 件事
- 01多学科覆盖评测
- 02分层难度校验
- 03行业通用标尺
- 04轻量化接入路径
- 05大模型评测场景的常用方案
- 06大模型研发工程师 校验自研模型跨学科知识理解能力的日常效率工具
更新历史
- MMLU 收录进 Toolifai 目录
- 页面资料核验与信息更新
常见问题
使用这个基准评测需要付费吗
该基准的基础公开访问权限完全免费,部分特殊的定制化评测服务收费规则以官网公示为准,普通用户查看公开数据、提交常规测试申请无需额外支付费用。
上传的测试数据会被公开吗
默认情况下你提交的非公开测试数据不会被对外展示,若你主动选择将结果加入公开排行榜,对应提交的相关数据才会同步到公开页面供所有访问者查看。
它能测多模态大模型的图像理解能力吗
不能,MMLU的所有测试题均为文本类任务,仅针对大模型的多任务语言理解能力设计,没有内置任何图像、音频类的多模态测试用例,无法校验图像理解相关能力。
没有代码基础能上手用它吗
可以,平台提供了可视化的Web操作界面,所有提交步骤都有明确的文字指引,仅需按照要求整理好待提交的模型输出结果即可完成操作,不需要自行编写评测代码。
开始使用 MMLU
从官方入口了解最新功能与使用方式。
由 Toolifai 编辑维护
欢迎产品方补充截图、功能介绍与官方资料。更新和纠错由编辑审核后发布。