3D重建

heye0507.github.io
LucidFusion是一款专注于3D高斯生成的端到端前馈框架工具站点,核心定位为帮助用户基于多视图图像快速完成3D内容重建。其核心功能包括多视图图像3D高斯生成、相对坐标图几何特征对齐、单图转3D流程适配三大模块,面向计算机视觉研究者、3D内容创作者、游戏开发人员等群体,可应用于3D资产生产、学术实验验证、数字孪生场景建模等多个场景,无需预先对输入图像进行摆姿势校准,即可处理稀疏、任意数量的多视图输入,输出高分辨率3D高斯资源。

ai.meta.com
SceneScript是Meta Reality Labs研究团队推出的3D场景重建技术专题页面,核心定位是展示前沿AI驱动的3D场景理解与重建技术研究成果。页面核心功能包括技术原理解析、实验效果展示、研究论文资源下载、应用场景落地说明,面向计算机视觉研究人员、3D内容创作者、AR/VR领域开发者、元宇宙相关从业者,可用于学术研究参考、3D开发技术选型、AR/VR场景构建方案调研等多种场景,帮助相关从业者了解单张图像生成高精度3D模型的技术路径与落地可能性。

xgrids.com
Lixel CyberColor(简称LCC)是XGRIDS公司研发的3D场景创建技术产品,聚焦于高精度3D重建与智能空间计算领域。核心功能包括基于Multi-SLAM与3DGS技术的超逼真大型3D模型自动生成、90%模型体积压缩的轻量化处理、多平台插件与SDK适配。目标用户覆盖游戏开发从业者、影视内容制作团队、虚拟现实内容创作者、城市规划设计师、工业仿真工程师等群体,可应用于开放世界游戏场景搭建、影视虚拟拍摄场景还原、VR/AR内容场景构建、城市数字孪生模型制作、工业产线三维仿真等多种工作场景,为3D内容生产提供技术支撑。
yihua7.github.io
SC-GS是专注于动态3D场景重建与渲染的技术展示与工具网站,核心基于稀疏控制点结合高斯溅射的新型表示方案,可实现动态场景外观与运动的分离建模。核心功能包括动态3D场景的联合重建、可控的3D运动编辑、实时新视图合成渲染,面向计算机视觉研究人员、3D内容开发者、元宇宙场景构建人员、游戏场景设计师、影视特效制作人员、三维重建算法工程师等群体,可用于动态场景数字化存档、3D交互内容制作、算法效果验证、影视虚拟场景渲染、学术研究对比实验等多种场景。

langsplat.github.io
LangSplat是面向3D场景语言查询的学术开源项目,核心定位是构建高效的3D语言场,支持开放词汇的3D场景语义检索。其核心功能包括将CLIP语言嵌入映射到3D高斯分布实现语义建模、规避NeRF类方法的高成本渲染流程提升运算效率、生成无需后处理的高精度对象边界语义特征。目标用户覆盖计算机视觉研究者、3D内容开发人员、机器人导航算法工程师等群体,可应用于3D场景语义标注、机器人环境理解、AR内容语义交互、三维重建后语义分析等场景,为3D场景的语言交互需求提供高效的技术实现方案。

gaussiancube.github.io
GaussianCube是一个专注于3D辐射表示技术的学术项目网站,核心定位是展示结构化显式3D辐射表示的相关研究成果与应用资源。核心功能包括提供结构化高斯表示技术的完整技术文档、开源算法代码包下载、3D重建与生成效果演示案例、相关研究论文与实验数据下载、开发者使用教程与常见问题解答。目标用户覆盖计算机视觉领域研究人员、3D内容开发工程师、图形学方向高校师生、元宇宙内容创作者、3D建模从业者。适用场景包括3D内容生成模型研发、高精度3D场景重建、游戏与影视3D资产制作、AR/VR场景内容构建、3D测量与数字孪生建模等多个领域,帮助相关从业者降低3D生成建模的开发门槛,提升3D内容的制作效率与呈现质量。

cat3d.github.io
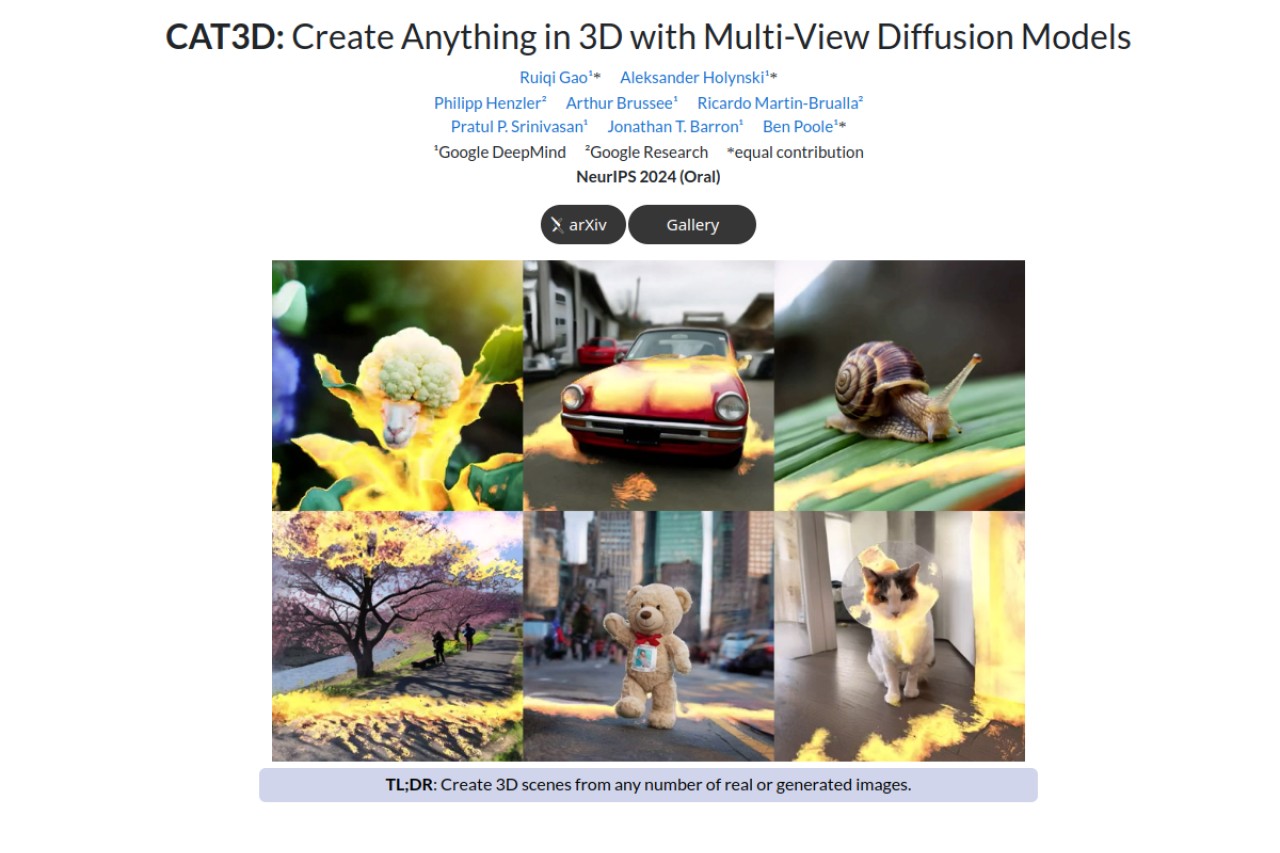
CAT3D是一款基于多视角扩散模型的在线3D场景重建工具,核心定位是帮助用户通过少量输入图像快速生成可交互的3D场景内容。平台支持任意数量的多视角图像输入,可自动生成同一场景的新视角视图,再通过内置的3D重建管道将视图整合为可实时渲染的3D资源,全程处理时间约一分钟。该工具面向3D建模从业者、内容创作者、科研人员、高校学生等群体,可应用于数字孪生场景搭建、文创产品3D化、学术研究中的3D数据生成、个人3D创作原型快速验证等场景,降低3D内容生成的技术门槛。

illuminerf.github.io
IllumiNeRF是专注于3D重光照与新视角渲染的技术服务站点,核心基于神经辐射场(NeRF)与图像扩散模型的组合方案,解决传统逆向渲染方法计算成本高、优化过程不稳定的问题。核心功能包括未知光照下的3D场景重建、指定目标光照的新视角渲染、多视角输入图像的自动重光照预处理、重光照效果基准测试对比等。服务于计算机视觉研究人员、3D内容创作者、影视动画制作人员、AR/VR开发人员等群体,可用于3D资产制作、虚拟场景光照调整、数字孪生场景还原、影视道具渲染等多种场景,无需提前获取拍摄环境的光照参数,仅通过普通拍摄的多视角图像即可完成3D内容的光照可控渲染。
dust3r.europe.naverlabs.com
DUSt3R是Naver Labs Europe推出的3D重建技术官方网站,核心为无约束密集立体3D重建算法服务。网站提供算法原理详解、在线Demo体验、预训练模型下载、部署教程等核心功能,面向计算机视觉研究人员、3D内容创作者、机器人研发工程师、VR/AR开发人员等用户群体,可应用于室内外场景三维重建、数字孪生模型制作、自动驾驶环境感知、影视虚拟场景搭建等多个工作场景,无需用户提前掌握相机校准或视点姿态相关专业知识,即可实现从任意图像集合到3D模型的转换。
huiyu-gao.github.io
VisFusion是一款基于计算机视觉与深度学习技术的在线3D场景重建工具,核心定位是帮助用户从普通视频数据中快速生成高精度三维环境模型。其核心功能包括视频帧自动特征提取、多视角点云融合建模、模型纹理自动映射,支持主流视频格式上传,无需专业三维扫描设备即可完成场景还原。目标用户覆盖计算机视觉研究人员、三维建模从业者、AR/VR内容开发者、建筑测绘人员等,可应用于数字孪生场景搭建、文化遗产三维存档、虚拟场景内容制作、室内外空间测绘等多个场景,降低了3D场景建模的技术门槛。

lingtengqiu.github.io
LHM是一款基于多模态变压器架构的大规模可动画人类重建模型工具站点,核心面向3D内容创作、数字人开发等领域提供高保真3D重建能力。站点支持单张图像输入生成可驱动的3D人类形象,可精准还原服装几何结构与表面纹理,面部身份特征与细节恢复效果稳定,适合数字人制作、游戏角色开发、虚拟形象定制等对3D重建精度有要求的工作场景,目标用户覆盖3D美术从业者、数字人开发者、高校计算机视觉方向研究人员等群体。
benhenryl.github.io
Deblurring 3D Gaussian Splatting是面向3D重建领域的神经场去模糊技术展示与框架应用站点,核心基于3D高斯光栅化方法构建去模糊计算体系。核心功能包括模糊图像3D场景清晰重建、实时渲染同步去模糊处理、3D高斯点云动态优化。目标用户覆盖计算机视觉研究者、3D内容开发人员、自动驾驶感知算法工程师、AR/VR场景建模人员等。使用场景涵盖运动模糊拍摄的场景3D重建、低质量多视角图像的高精度模型生成、实时渲染场景的动态去模糊优化等,为3D重建领域的模糊数据处理提供可落地的技术参考与实现方案。
animatabledreamer.github.io
AnimatableDreamer是专注于非刚体3D模型生成与重建的技术框架网站,核心定位为面向单目视频输入的可动画3D内容生成工具。核心功能包括从普通单眼视频中提取物体运动规律、生成不同类别的可动画非刚体3D模型、实现4D动态生成效果的时间一致性校验。目标用户覆盖计算机视觉研究者、3D内容创作者、动画制作从业者、元宇宙内容开发人员、学术科研人员。可应用于短视频3D内容转制、角色动画模型快速生成、文物3D动态还原、虚拟数字人模型搭建、动态物体3D存档等多种场景,为非刚体3D内容生产提供技术支撑。
justimyhxu.github.io
GRM是面向3D内容创作领域的大规模重建与生成模型项目站点,核心提供稀疏视图图像到3D资产的快速转换能力,支持基于Transformer架构的多视图信息融合,可对接多视图扩散模型实现文本到3D、图像到3D的生成任务。站点面向3D建模从业者、计算机视觉研究人员、元宇宙内容开发者、游戏制作人员、数字孪生技术人员、动画创作者等群体,可应用于小规模3D资产快速重建、学术研究算法效果比对、3D内容批量生成测试、多模态3D生成场景落地验证等多个场景,为3D内容生产的效率提升提供技术方案参考与效果演示。
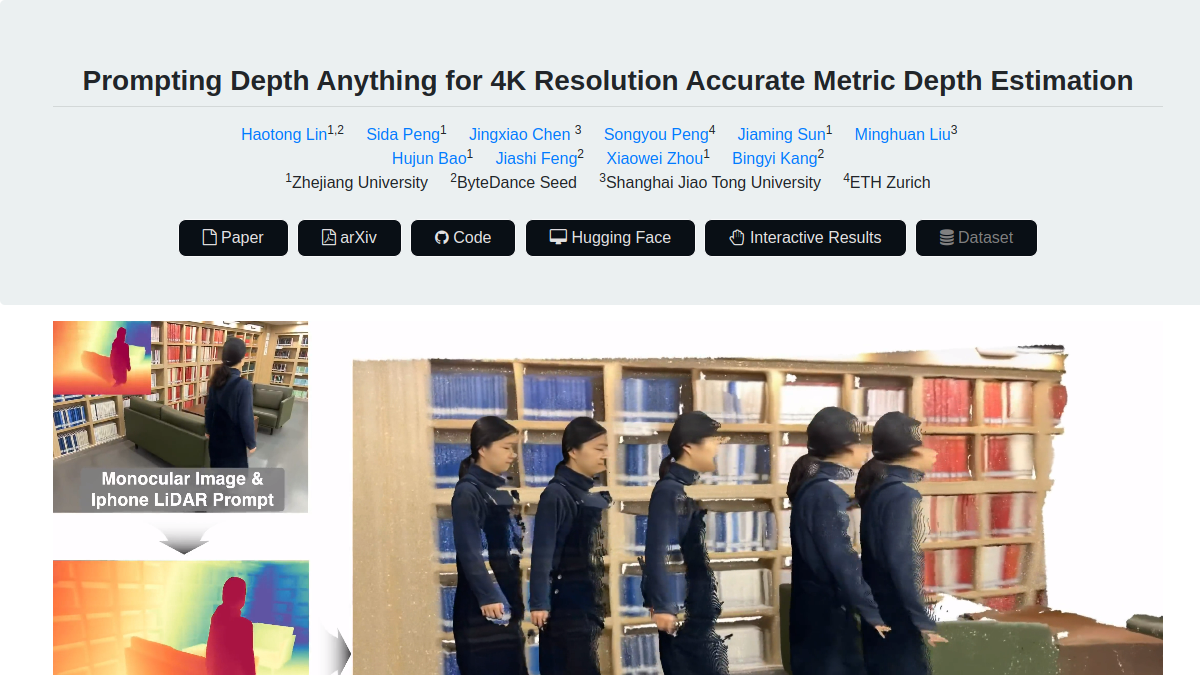
promptda.github.io
Prompt Depth Anything是聚焦于度量深度估计领域的技术展示与资源开放平台,核心定位为高分辨率、高精度深度估计技术的落地验证和成果共享站点。平台支持4K级度量深度估计在线演示,开放ScanNet++增强深度注释数据集下载,同时提供可扩展训练数据管道的技术文档。目标用户覆盖计算机视觉研究人员、3D内容开发从业者、机器人技术研发人员、移动端AR应用开发人员等,可应用于学术研究验证、3D重建项目落地、机器人感知模块开发、AR场景交互优化等多个场景,帮助相关从业者降低深度估计技术的落地门槛。

costwen.github.io
Ouroboros3D是面向3D内容创作领域的统一3D生成开源框架,核心是将基于扩散的多视图图像生成与3D重建能力集成到递归扩散流程中,通过自条件机制实现两个模块的联合训练适配。其核心功能包括多视图图像递归生成、3D模型实时重建、几何一致性校验、推理过程可视化、自定义训练参数配置。目标用户覆盖3D算法研究人员、计算机图形学开发者、3D内容创作从业者、高校相关专业师生、AI生成内容技术爱好者。可应用于3D内容批量创作、数字孪生模型构建、游戏素材快速生成、学术研究算法验证、元宇宙场景搭建等多个场景,帮助用户降低3D内容生成的技术门槛,提升3D模型生成的几何稳定性。

sam-3d.com
SAM 3D是Meta AI推出的3D重建在线工具,核心定位是通过单张图像快速生成3D模型,降低3D内容创作的技术门槛。平台支持3D物体、人物、场景三类内容的重建,还提供物体建模、人体建模专项优化工具,可自动识别图像中的主体结构并生成拓扑合理的3D网格。目标用户覆盖3D内容创作者、游戏开发者、电商运营人员、建筑设计从业者、数字艺术创作者等群体,适用于游戏资产快速制作、电商3D商品展示、数字人模型初版生成、建筑场景概念建模等多种场景,可有效缩短3D资产从创意到成品的制作周期。
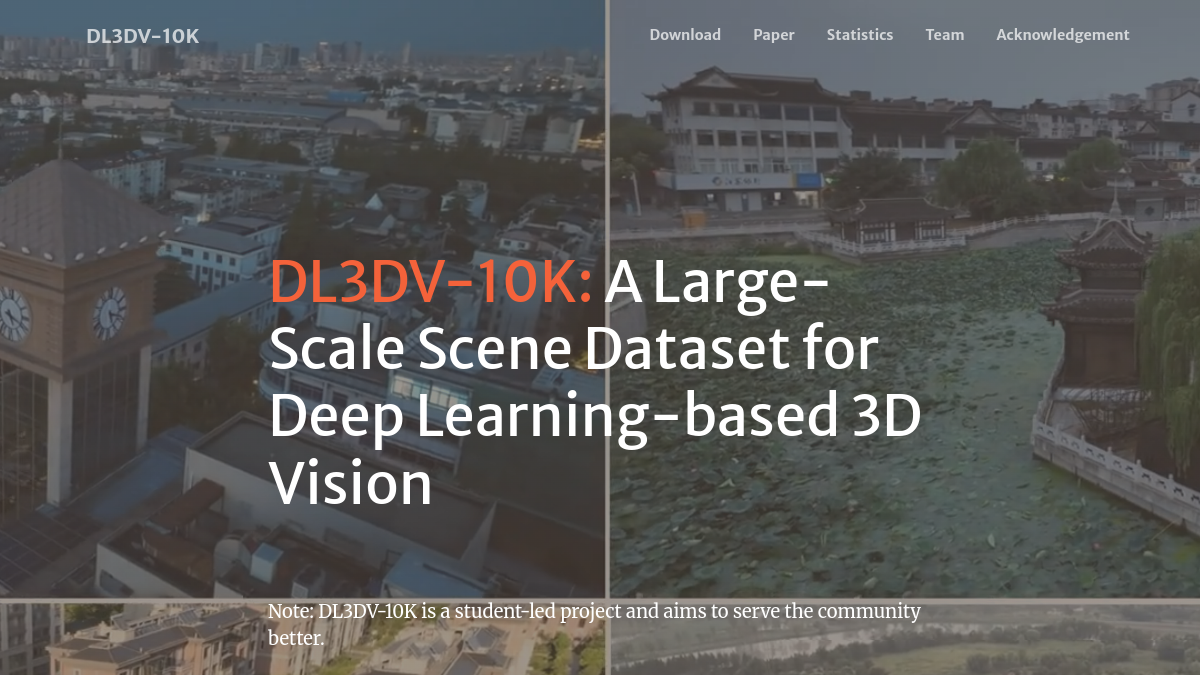
dl3dv-10k.github.io
DL3DV-10K是面向计算机视觉领域研究人员的大规模实景3D视频数据集平台,核心定位为3D视觉相关研究提供标注完备的大规模训练与测试数据源。核心功能包含万级规模多场景标注视频库,覆盖日常室内、户外街道、自然景观等多元场景,配套标注包含相机姿态、NeRF估计深度、点云、3D网格等多类3D相关数据,同时提供场景复杂度、关键点人工标注结果,可支持NeRF模型训练优化、场景一致性跟踪算法验证、视觉语言模型跨模态关联研究等方向,目标用户涵盖高校计算机专业研究者、AI实验室研发人员、3D视觉相关算法开发人员,适用于论文实验数据支撑、算法性能基准测试、3D重建技术迭代验证等场景。
reconfusion.github.io
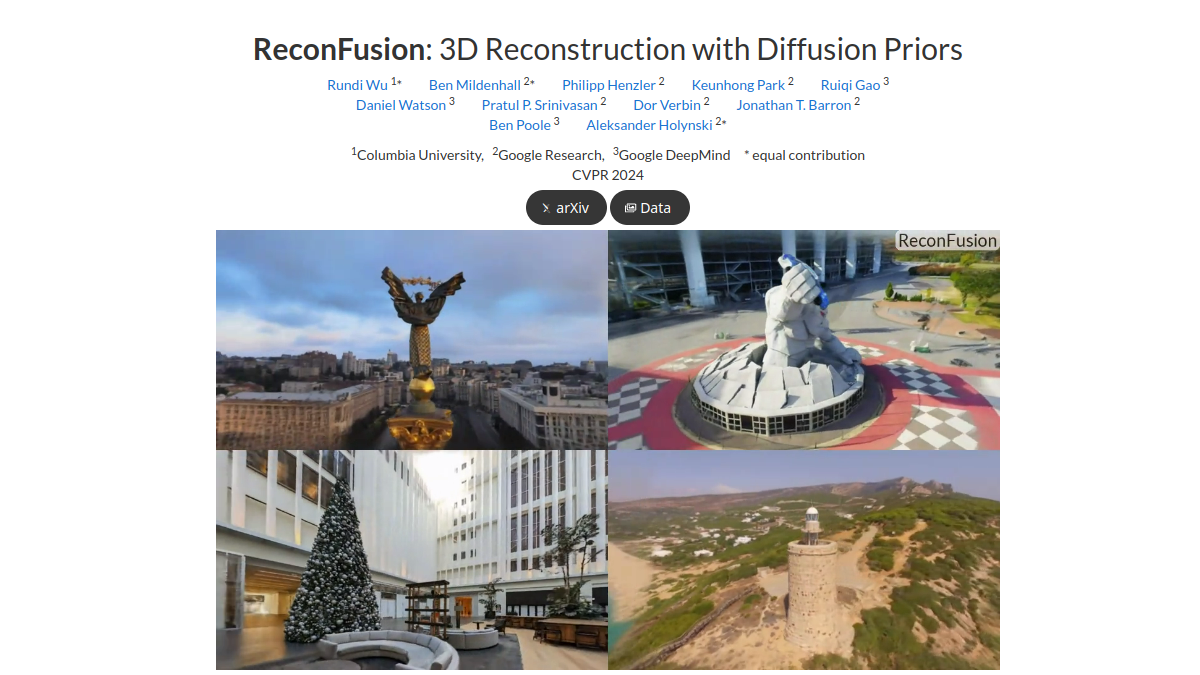
ReconFusion是面向3D视觉研究与应用领域的技术项目官网,核心展示结合神经辐射场(NeRFs)与扩散先验的少量视图3D重建方法,可在仅提供少量实景照片的前提下完成真实场景的三维结构与纹理还原。核心功能包括3D重建效果可视化演示、技术论文与数据集资源下载、相关实验评估结果公开,目标用户覆盖计算机视觉领域研究者、3D内容创作者、VR/AR场景开发人员等,可应用于小样本实景3D建模、虚拟场景内容生成、受限视角场景三维还原等多种场景。
zfkuang.github.io
NeROIC是基于神经辐射场技术的物体3D表示获取工具,核心定位是从多源在线图像集合中提取物体的高精度几何与材质属性,支撑多种3D渲染相关应用。核心功能包括多图像联合几何重建、材质与光照属性分离、瞬态场景元素处理,目标用户覆盖计算机视觉研究者、3D内容创作者、数字资产开发人员等,可应用于新视角合成、物体重照明、虚拟场景融合、数字孪生建模等场景,无需复杂的专业采集设备,仅通过普通图像输入即可完成物体的可渲染3D表示构建。
depth-anything.github.io
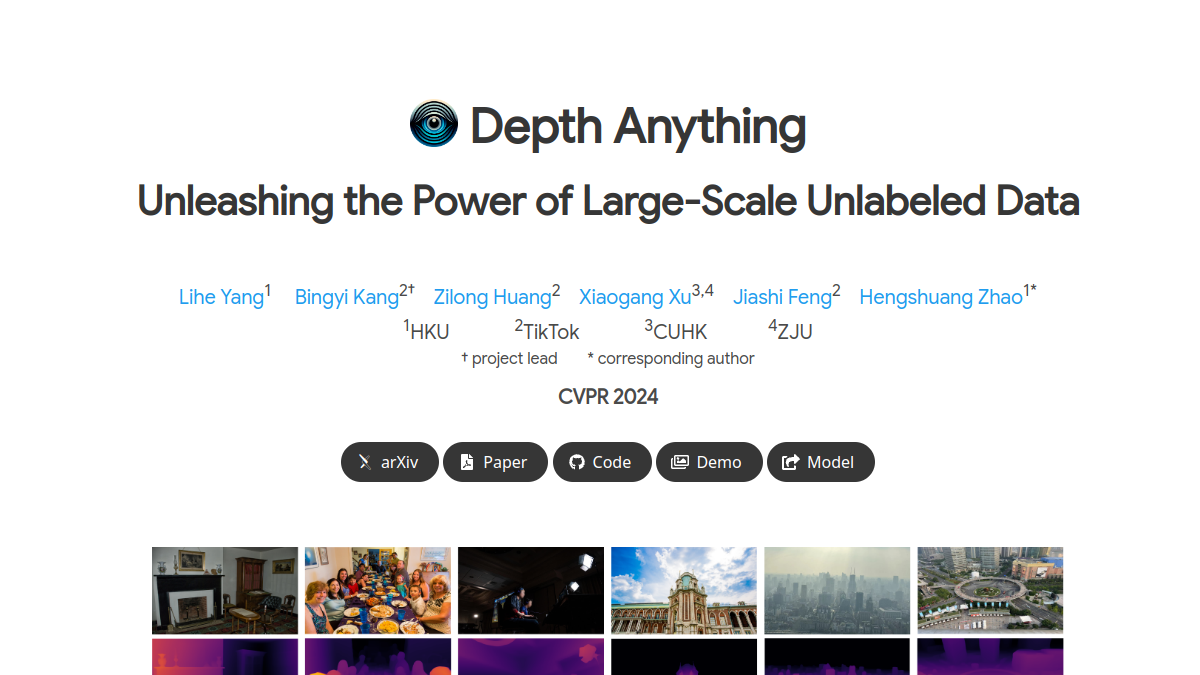
Depth Anything是专注于单目深度估计的技术项目官网,核心定位是提供可泛化的单目视觉深度估计基础模型。核心功能包括开源模型资源下载、零样本深度估计效果演示、不同微调版本的效果对比展示,同时提供配套的技术论文、训练数据说明文档。目标用户覆盖计算机视觉研究人员、自动驾驶算法开发人员、AR/VR内容创作者、影视后期制作人员等,可应用于3D场景重建、自动驾驶环境感知、AR虚实融合效果调校、影视景深特效生成等多个场景,为需要从单张图像获取深度信息的工作提供模型支撑。

worldlabs.ai
World Labs是聚焦空间智能领域的技术研究与服务平台,核心定位是搭建大型世界模型(Large World Models)技术体系,实现对3D世界的感知、生成与交互。核心功能包括基于神经辐射场(NeRF)的3D场景高精度重建、多视角图像输入的新视角合成、3D内容交互式生成等。目标用户覆盖3D内容创作者、AI研究人员、自动驾驶研发团队、数字孪生项目从业者、影视特效制作人员等群体,可应用于数字孪生场景搭建、自动驾驶仿真环境构建、影视虚拟场景制作、文博数字藏品3D化还原、元宇宙场景内容生产等多个场景,为不同领域的3D技术需求提供技术支撑与解决方案。
docs.nerf.studio
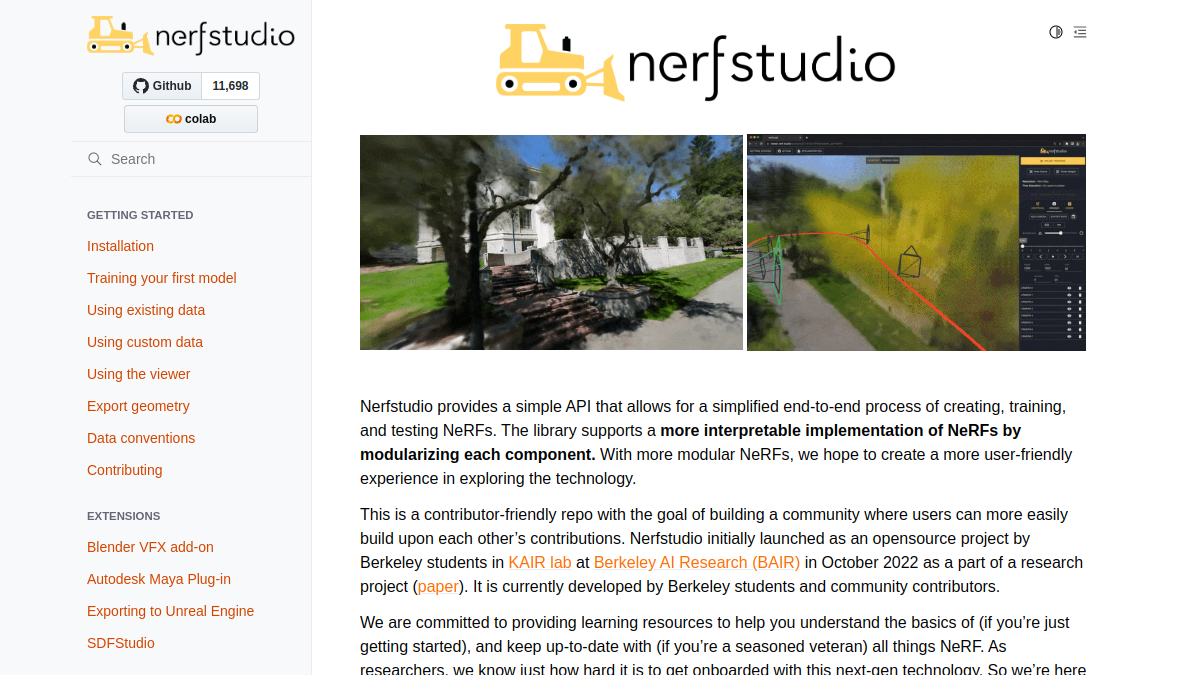
nerfstudio是面向神经辐射场(NeRF)领域的开源开发框架官方文档站点,核心定位是为NeRF研发与应用人员提供体系化的技术支撑资源。站点覆盖模块化框架接口说明、多场景数据预处理教程、训练过程可视化操作指引三类核心内容,目标用户包含计算机视觉领域研究人员、3D内容开发从业者、高校相关专业学生、NeRF技术爱好者等群体,可满足用户学习NeRF基础原理、复现前沿模型、开发自定义3D重建应用、调试模型训练参数等多类场景需求。
arthurhero.github.io
Long-LRM是面向3D大场景高斯重建的技术展示项目,核心定位是实现高效的大规模3D场景从图像到三维模型的转化。核心功能包括多输入图像的3D高斯快速重建、大场景一次性完整建模、低算力成本下的高速度处理。目标用户涵盖计算机视觉研究人员、3D内容创作者、自动驾驶场景建模人员、数字孪生开发人员等。可应用于城市场景三维复刻、文物数字化存档、影视虚拟场景构建、自动驾驶仿真环境搭建等多种场景,解决传统3D重建耗时长、无法一次性处理大场景的痛点。