3D内容创作
video2game.github.io
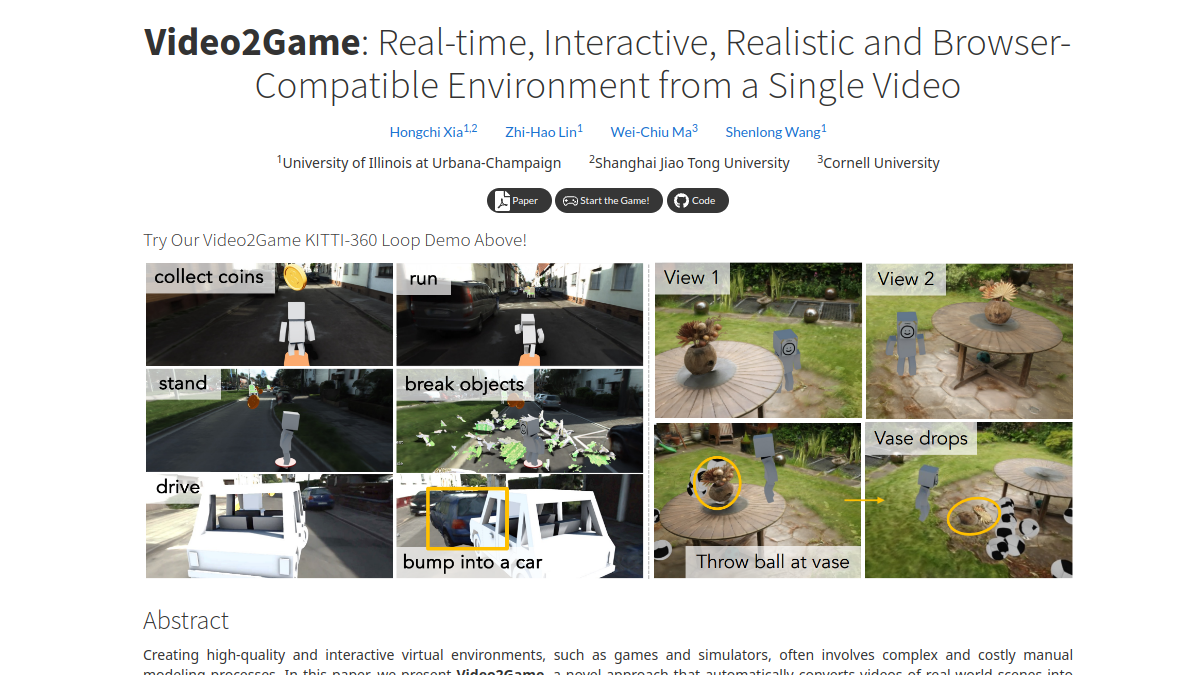
Video2Game是一款专注于视频转虚拟互动环境的在线技术工具,核心定位是将普通视频素材转化为支持实时交互的3D虚拟场景。其核心功能包括基于NeRF的3D场景重建、游戏引擎兼容的动力学网格生成、神经纹理UV映射处理三类,面向3D内容创作者、游戏开发人员、虚拟场景设计从业者、科研人员等群体,可应用于独立游戏场景快速搭建、虚拟展厅内容制作、VR场景内容生成、数字孪生场景还原等多种场景,无需复杂的专业建模流程即可完成从二维视频到可交互3D环境的转换,输出内容可直接在主流浏览器中正常加载运行。
physdreamer.github.io
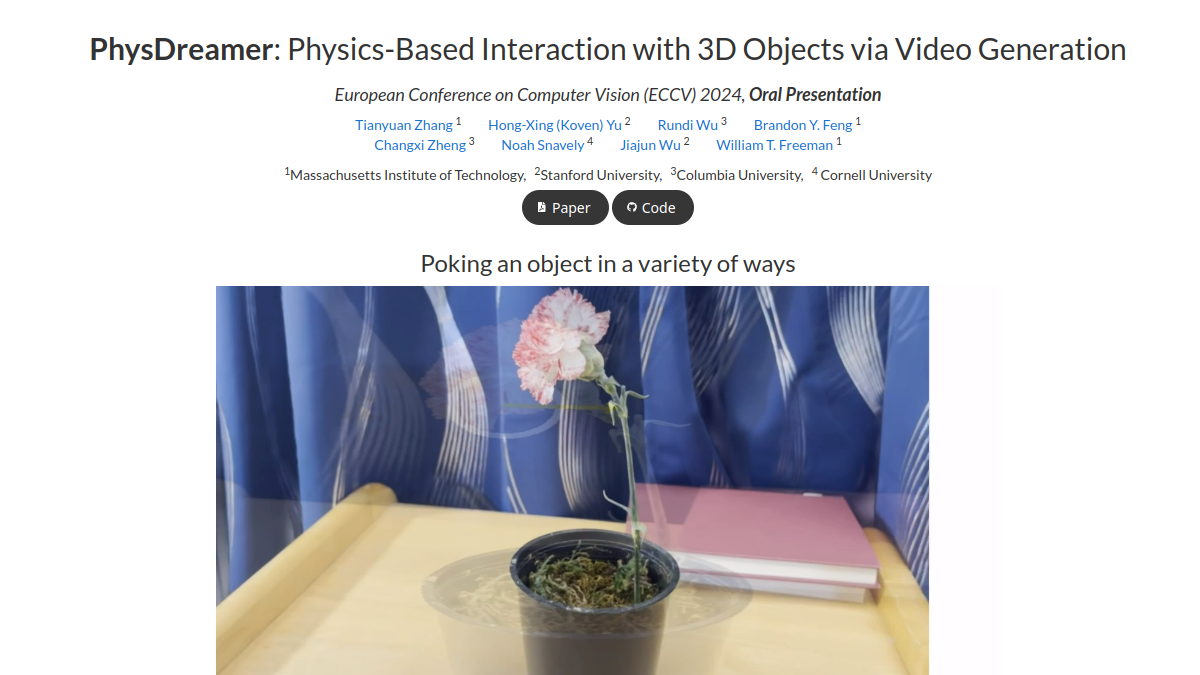
PhysDreamer是专注于静态3D对象交互式动力学模拟的技术展示平台,核心定位是为缺乏物理属性数据的3D对象赋予符合现实规律的动态交互效果。平台核心功能包括基于视频动力学先验的物理模拟、多类型交互输入的动态反馈生成、模拟结果可视化渲染输出三类,主要面向计算机图形学研究者、3D内容创作者、游戏开发工程师、虚拟交互场景设计师等群体,可应用于元宇宙场景搭建、游戏交互逻辑验证、虚拟产品原型测试、动画内容制作等多种场景,帮助用户在无需采集真实物体物理参数的前提下,生成符合现实物理规律的3D对象交互反应效果。
instruct-nerf2nerf.github.io
Instruct-NeRF2NeRF是专注于3D NeRF场景指令式编辑的学术项目网站,核心定位为通过文本指令实现NeRF场景的可控编辑。核心功能包括文本指令驱动的3D场景修改、多视角一致性编辑优化、真实世界大规模场景适配。目标用户覆盖计算机图形学研究人员、3D内容开发者、VR/AR内容创作者、影视特效制作人员、高校相关专业学生等。适用于3D场景风格转换、场景元素替换、场景属性调整、数字孪生场景迭代等多种工作场景,无需手动逐帧调整3D资产,即可输出符合指令要求的一致性3D编辑结果。

avataar.ai
Avataar.ai是基于AI技术的3D内容创作平台,核心定位是为品牌提供轻量化的3D视觉内容生产解决方案,核心功能包括AI驱动的2D图像转3D模型生成、3D动态视频自动渲染、交互式3D体验搭建三类。平台面向电商、零售、营销、广告等领域的从业者,可应用于电商产品展示升级、品牌营销物料制作、虚拟展厅内容搭建、社交媒体创意内容产出等场景,无需专业3D建模背景即可完成高质量3D内容生产,降低3D内容制作的技术门槛与时间成本。

rebellis.ai
Rebellis AI是一款专注于文本转3D动画的生成式AI视频平台,核心定位是为创作者提供低门槛的3D角色动画制作能力。其核心功能包括文本到动作实时转换、可定制化动画输出、主流开发环境无缝集成、品牌专属角色动画定制、智能提示推荐。该平台面向游戏开发者、3D工作室、品牌营销团队、动画创作者、教育从业者等群体,可应用于游戏原型开发、品牌营销内容制作、动画短片创作、教学内容可视化、短视频内容创作等多个场景,帮助用户降低动画制作的技术门槛,减少制作时间与成本投入。
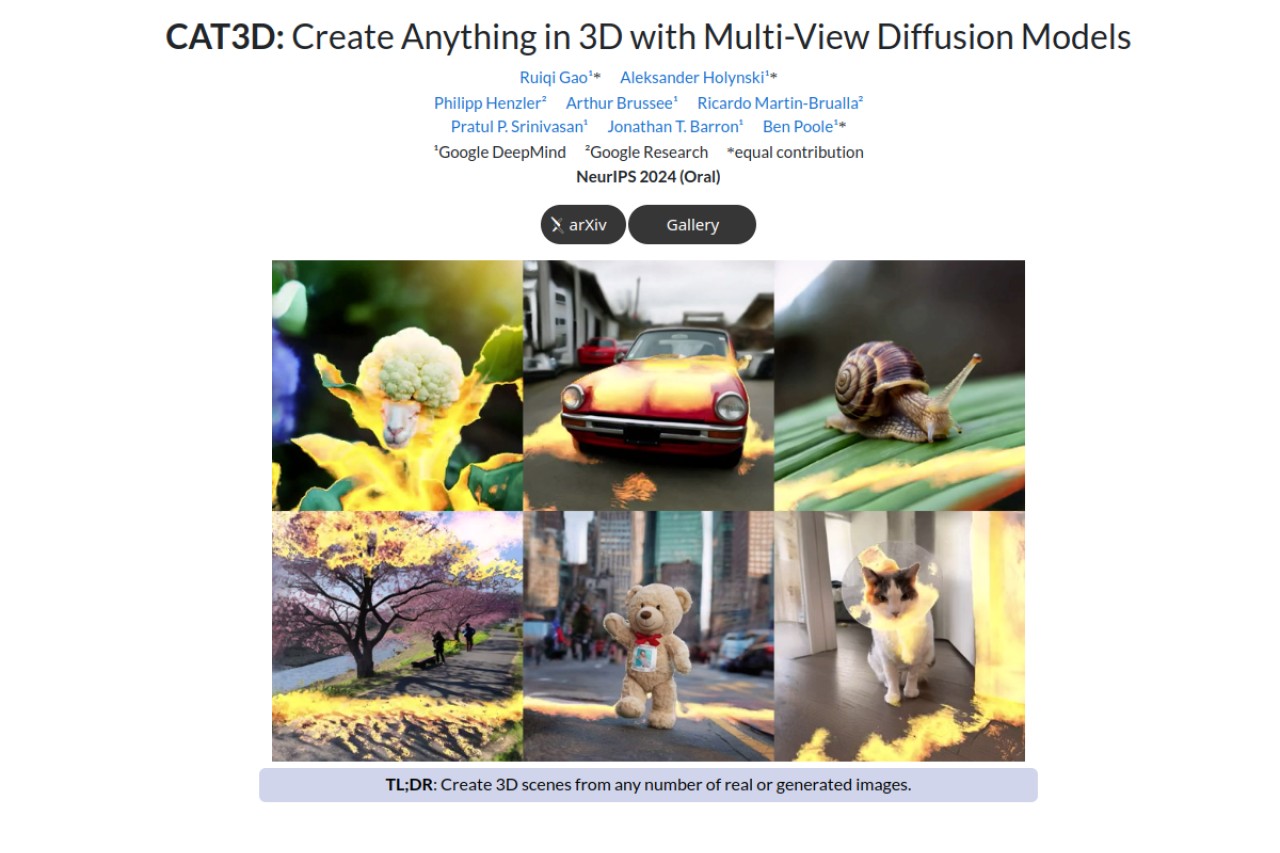

cat3d.github.io
CAT3D是一款基于多视角扩散模型的在线3D场景重建工具,核心定位是帮助用户通过少量输入图像快速生成可交互的3D场景内容。平台支持任意数量的多视角图像输入,可自动生成同一场景的新视角视图,再通过内置的3D重建管道将视图整合为可实时渲染的3D资源,全程处理时间约一分钟。该工具面向3D建模从业者、内容创作者、科研人员、高校学生等群体,可应用于数字孪生场景搭建、文创产品3D化、学术研究中的3D数据生成、个人3D创作原型快速验证等场景,降低3D内容生成的技术门槛。
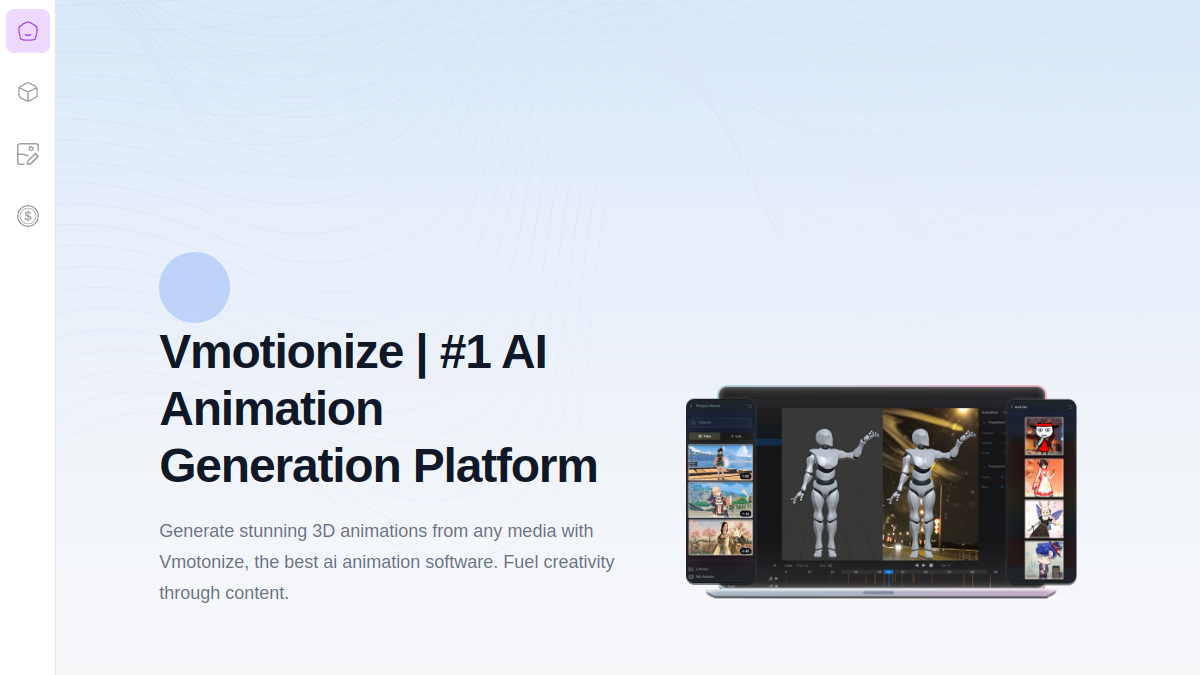

vmotionize.com
Vmotionize是专注于AI驱动3D动画生成的在线平台,核心定位是降低3D动画制作门槛,为内容创作者提供便捷的数字内容生产工具。其核心功能包括多模态内容转3D动画、AI动作捕捉、动态图形生成,支持将视频、音频、文本、图片等不同格式的素材转化为3D动画内容。平台面向独立动画创作者、品牌营销人员、游戏开发者、新媒体运营者等群体,适用于短视频内容制作、品牌宣传动画产出、游戏角色动作设计、虚拟场景搭建等多种场景,无需掌握复杂的3D建模技术即可完成高质量3D动态内容的生产。
chenshuo20.github.io
DimensionX是基于视频扩散模型的科研类场景生成工具,核心定位是实现从单张图像到3D、4D场景的自动化生成。它支持用户上传单张图片生成多视角一致的三维场景,可根据文本提示词调整场景动态效果,生成的内容可直接导出兼容主流3D建模软件的格式。该工具面向计算机视觉研究人员、3D内容创作者、游戏开发人员等群体,可用于学术研究中的场景重建实验、动画前期的场景快速搭建、元宇宙内容的原型制作等场景。

nation-a.com
Neuroid是基于生成对抗网络技术打造的3D建模与动画生成工具,核心定位是为3D创作从业者提供AI辅助的内容生产方案。其核心功能包括文本驱动3D模型生成、动作库智能匹配调用、动画参数批量调整,能够帮助用户降低3D创作的技术门槛,缩短内容产出周期。目标用户覆盖3D设计师、游戏开发者、影视动画从业者、广告创意人员等群体,可应用于游戏角色建模、短视频动画制作、产品3D展示设计、虚拟数字人动作调试等多个场景。
sizhean.github.io
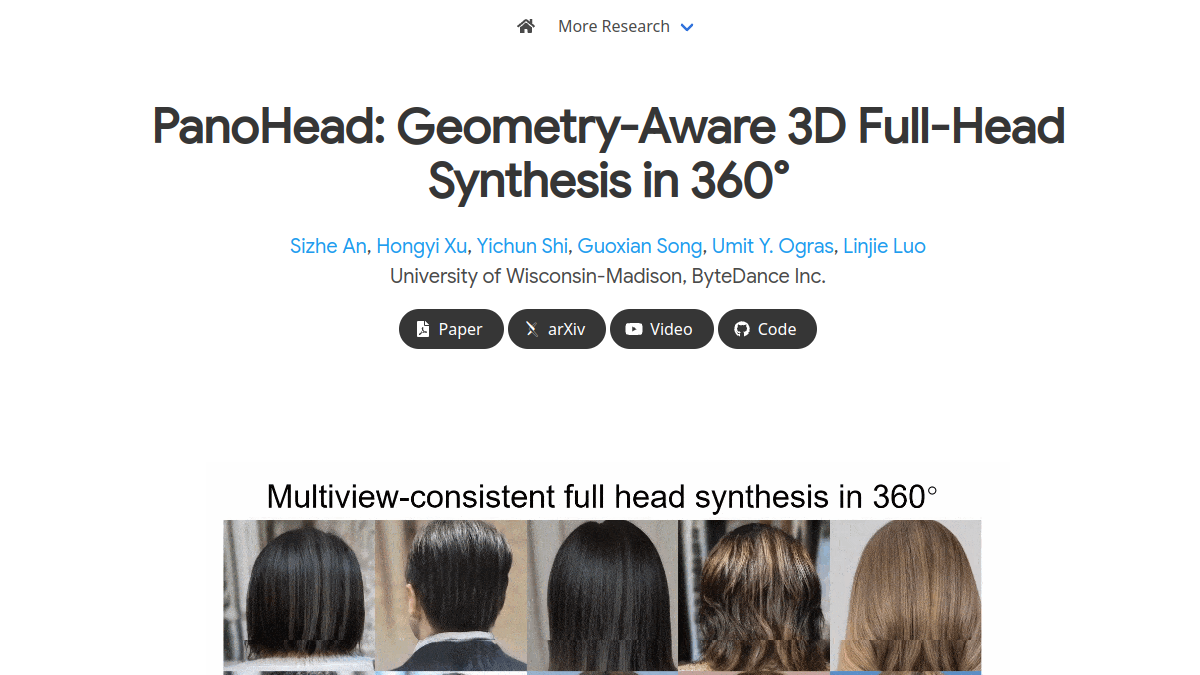
PanoHead是专注于360°全头部3D合成的学术研究项目站点,核心定位为面向计算机视觉领域的3D人头生成技术展示与资源输出平台。核心功能包括360°几何感知的全头合成技术演示、非结构化图像训练方案说明、视图一致的3D头部生成效果展示。目标用户覆盖计算机视觉研究人员、3D内容开发者、数字人制作从业者、高校图形学相关专业师生。可应用于数字人模型快速生成、影视虚拟角色原型制作、VR/AR虚拟头像定制、人脸相关算法研究验证等场景,帮助用户降低3D头部模型的制作门槛,提升生成内容的视角一致性与几何细节精度。
akashsengupta1997.github.io
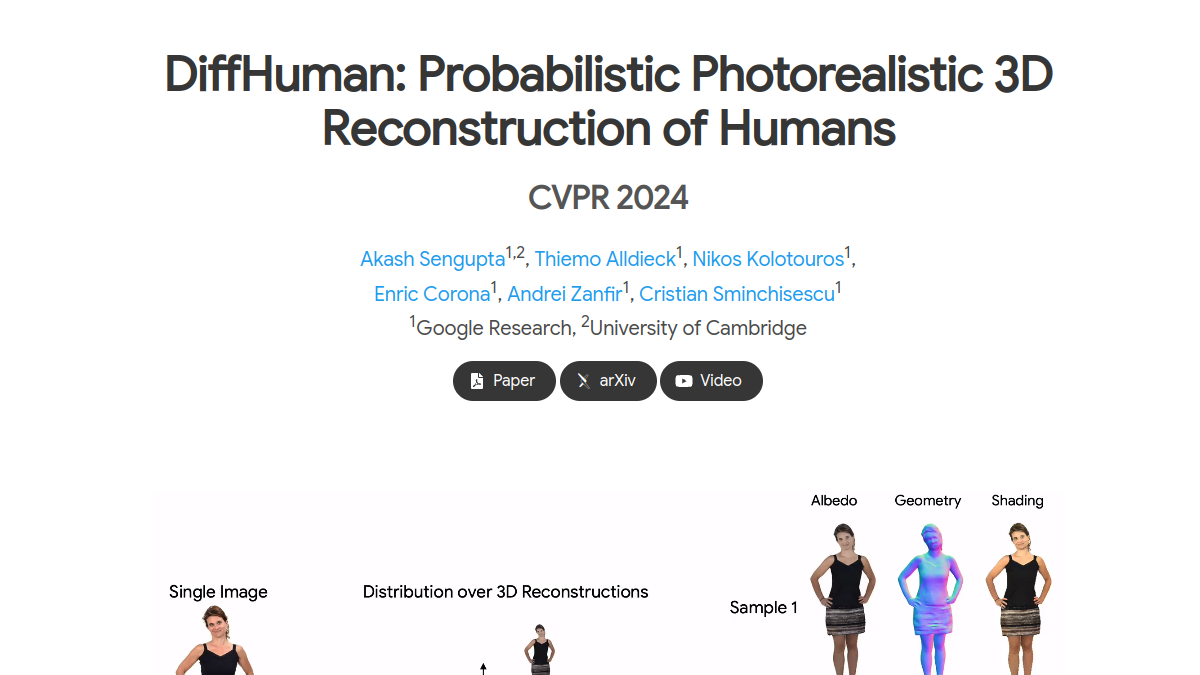
DiffHuman是一个面向3D人体重建领域的学术项目展示网站,核心呈现基于扩散模型的概率式光度逼真3D人体重建方案。该网站支持单张RGB图像输入的3D人体分布预测、多采样高细节人体模型生成、加速推理效果对比三大核心功能,主要服务于计算机视觉研究人员、3D内容开发者、动画制作从业者、数字人研发团队等群体,可应用于学术研究验证、动画角色快速建模、数字人素材生成、3D重建算法效果比对等多种场景,帮助用户直观了解非确定性3D人体重建技术的实现逻辑与实际应用效果。
ken-ouyang.github.io
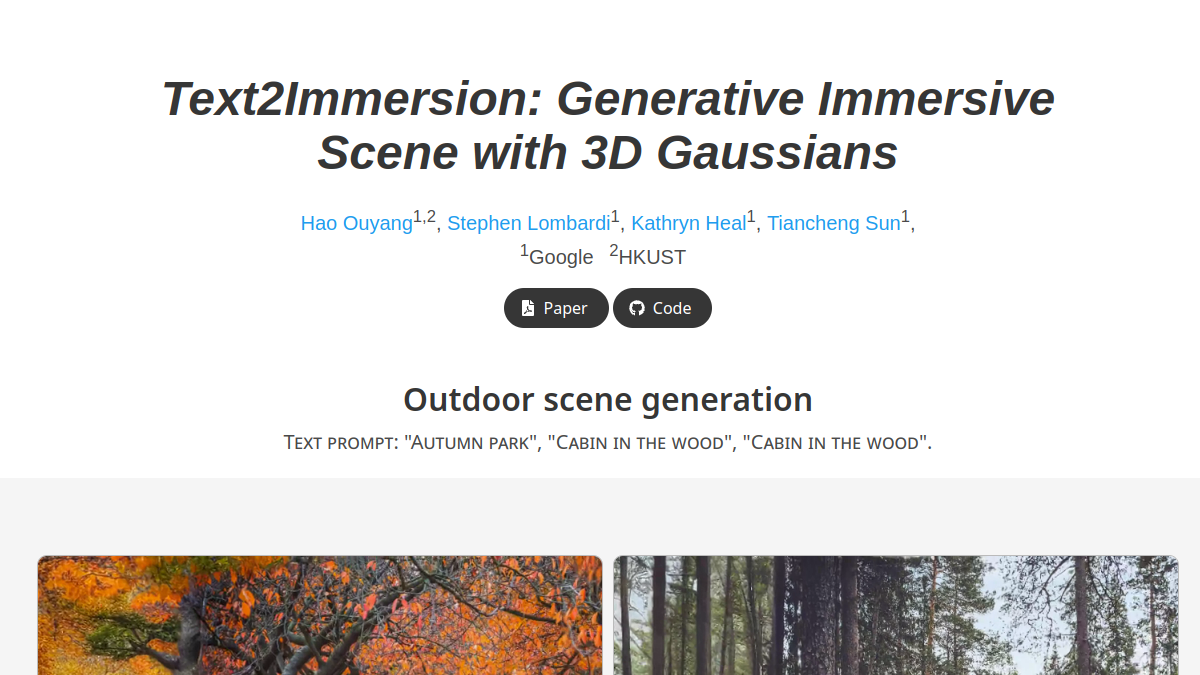
Text2Immersion是一款专注于文本到3D沉浸场景生成的学术演示类工具,核心定位为基于生成式AI技术实现自然语言驱动的三维场景创作系统。其核心功能包括文本提示解析与高斯云生成、3D场景多阶段细节精炼、沉浸视角场景插值浏览三大模块,目标用户覆盖计算机图形学研究者、VR内容开发者、游戏场景设计师、创意内容创作者等群体,可应用于虚拟现实场景原型搭建、游戏概念场景快速输出、创意概念可视化、学术研究效果对比等多种场景,支持用户通过简单的文本描述生成包含多类物体、风格多样的3D空间场景,无需复杂的三维建模操作即可产出可交互预览的沉浸场景效果。
balamuruganthambiraja.github.io
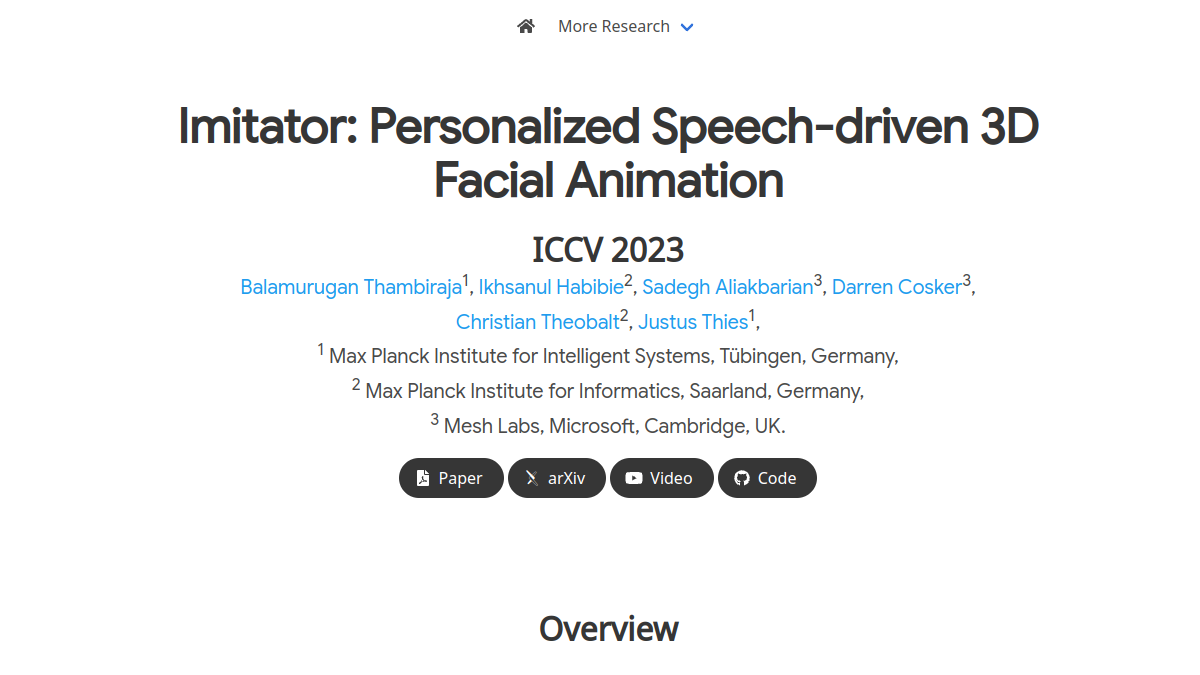
Imitator是专注于个性化语音驱动3D面部动画生成的技术工具网站,核心基于深度学习模型实现音频到面部动作的精准映射。支持通过短参考视频提取用户专属面部运动风格特征,可生成符合发音规律的唇部动态,尤其对双唇辅音的唇部闭合动作匹配度较高,还可导出适配主流3D引擎的动画数据。目标用户涵盖3D动画从业者、游戏开发人员、虚拟数字人创作者、科研人员等群体,适用于短视频虚拟角色制作、游戏角色语音动画匹配、虚拟主播实时驱动、影视动画后期配音对齐等多个场景,可降低面部动画手动制作的工作量。

luciddreamer-cvlab.github.io
LucidDreamer是由CVLab开发的无域3D场景生成技术网站,核心为用户提供基于文本或单张图像的可导航3D场景生成服务。核心功能包括单文本提示生成3D场景、单图像驱动3D场景构建、多视角一致性内容对齐。目标用户覆盖计算机视觉研发人员、3D内容创作者、游戏场景设计师、影视美术从业者、科研院校相关专业师生等。适用场景包含元宇宙场景快速搭建、影视虚拟背景制作、游戏关卡原型设计、3D内容学术研究测试、数字孪生场景初稿生成等,无需预设场景域限制即可完成多样化3D场景输出。
signerf.jdihlmann.com
SIGNeRF是面向神经辐射场(NeRF)场景编辑与对象生成的技术服务平台,核心定位为提供3D场景可控编辑方案,可实现无需迭代优化的3D一致性场景修改。平台支持现有NeRF场景内已有对象编辑、新对象集成生成两大核心功能,依托ControlNet深度条件图像扩散模型能力,简化NeRF场景修改流程。目标用户覆盖3D内容创作者、计算机视觉研究人员、元宇宙场景开发人员、影视后期制作人员、游戏场景设计师等群体,可应用于数字场景修改、虚拟资产制作、3D科研实验、影视虚拟布景搭建、游戏场景迭代更新等多种场景,帮助用户降低NeRF场景编辑的技术门槛,提升3D内容修改效率。
me.kiui.moe
LGM是专注于3D模型生成的技术框架站点,核心定位是为用户提供从文本提示或单视图图像生成高分辨率3D模型的技术能力。其核心功能包括多视图高斯特征3D表示、非对称U-Net多视图处理、高分辨率3D内容快速生成。目标用户覆盖3D内容创作者、游戏开发人员、AI研究人员、工业设计从业者等群体,可应用于游戏资源制作、元宇宙场景搭建、产品原型3D建模、学术研究实验等多个场景,帮助用户降低3D模型创作的技术门槛,提升生成效率与输出质量。

movmi.co
Movmi是一款基于AI技术的云端动作捕捉工具,核心定位是为内容创作者与开发人员提供无需高端硬件的人体动作捕捉解决方案。其核心功能包括通过普通2D图像或视频完成人体动作捕捉、支持多人场景动作识别、配套可商用角色素材库,用户无需购置动捕服、深度摄像头等专业设备,仅需普通拍摄设备采集的素材即可完成动捕流程。目标用户覆盖3D动画制作者、游戏开发者、虚拟内容创作者、影视后期人员等群体,可应用于独立动画项目制作、游戏角色动作导入、虚拟主播动作驱动、短视频3D内容创作等多个场景,输出的FBX格式文件可适配各类主流3D创作环境。
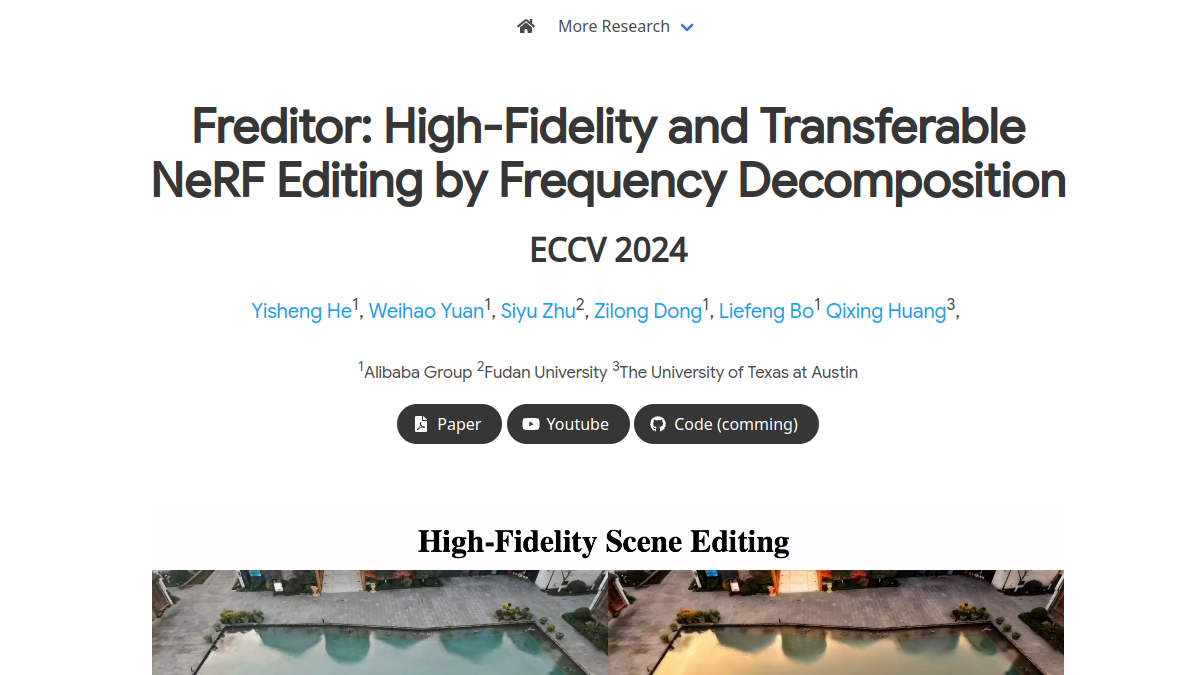

aigc3d.github.io
Freditor是基于频域分解技术的NeRF场景编辑工具,核心定位是为3D内容创作者、计算机视觉研究者提供高保真的神经辐射场编辑能力。核心功能包括NeRF场景频域拆分、低频区域风格迁移、高频细节保留集成、编辑强度实时调控,可适配多种不同类型的NeRF预训练场景。目标用户覆盖高校计算机视觉方向研究人员、3D内容制作团队、数字孪生项目开发人员、元宇宙场景创作者、AI生成内容开发者、计算机图形学爱好者。使用场景包括学术研究中NeRF编辑效果对比实验、3D场景风格化改造、数字孪生场景外观调整、元宇宙虚拟空间自定义设计、NeRF编辑算法性能验证等。

igl-hkust.github.io
Diffusion as Shader(简称DaS)是香港科技大学等高校研究团队开发的3D感知视频生成控制模型工具站,核心定位是为视频创作与3D内容生产领域提供基于扩散模型的多任务控制解决方案。核心功能包括支持网格到视频生成,可将3D网格素材转化为写实或风格化的连续视频内容;支持相机路径自定义控制,生成符合指定镜头运动逻辑的动态视频;支持运动迁移与对象属性编辑,可在保留原有3D空间逻辑的前提下修改对象外观、动作参数。目标用户覆盖CG从业者、影视动画制作人员、VR内容开发者、AI生成技术研究人员、高校计算机相关专业学生等,适用于影视片段预演、VR场景内容生成、3D动画效果测试、AI视频生成学术研究等多个场景。
3d.hunyuan.tencent.com
腾讯混元3D是腾讯推出的AI 3D内容生成平台,核心定位为降低3D内容创作的技术门槛。平台支持文本生成3D模型、图像生成3D模型、3D模型精细编辑三大核心功能,面向3D设计师、游戏开发者、动画制作人员、高校设计专业学生、文创从业者、元宇宙内容创作者等群体,可应用于游戏场景搭建、动画角色制作、文创产品设计、虚拟场景构建、教学实训演示等多个场景,无需用户掌握复杂的3D建模软件操作逻辑,即可快速生成符合需求的3D内容素材。

costwen.github.io
Ouroboros3D是面向3D内容创作领域的统一3D生成开源框架,核心是将基于扩散的多视图图像生成与3D重建能力集成到递归扩散流程中,通过自条件机制实现两个模块的联合训练适配。其核心功能包括多视图图像递归生成、3D模型实时重建、几何一致性校验、推理过程可视化、自定义训练参数配置。目标用户覆盖3D算法研究人员、计算机图形学开发者、3D内容创作从业者、高校相关专业师生、AI生成内容技术爱好者。可应用于3D内容批量创作、数字孪生模型构建、游戏素材快速生成、学术研究算法验证、元宇宙场景搭建等多个场景,帮助用户降低3D内容生成的技术门槛,提升3D模型生成的几何稳定性。

ai-3d.org
AI 3D Model Generator是一款依托Hunyuan与Seed3D技术打造的在线AI 3D模型生成工具,核心定位是降低3D内容创作的技术门槛,支持文本、图片两种输入方式生成3D模型,生成的模型支持GLB格式导出。其核心功能包括文本生成3D模型、图片生成3D模型、一键导出GLB文件,无需专业3D建模基础即可使用,适合3D设计从业者、游戏开发者、电商内容创作者、元宇宙内容搭建人员等群体,可应用于产品原型快速建模、游戏素材制作、电商3D展示内容生成、虚拟场景搭建等多个场景,帮助用户减少传统3D建模的时间投入。

51jianmo.com
51建模网是聚焦AI3D建模服务的在线平台,核心定位是降低3D内容创作门槛,无需用户安装专业建模软件即可完成全流程操作。平台支持2D图像转3D模型、关键词智能渲染、在线编辑优化三大核心功能,面向设计师、电商从业者、教育工作者、内容创作者等群体,可应用于商品展示、课件制作、文创设计、虚拟场景搭建等多种场景,帮助用户高效完成3D内容的创作与分发。
tripo3d.ai
Tripo3D是专注于AI驱动3D内容创作的在线平台,核心定位是降低3D模型制作的技术门槛,为内容创作者提供高效的3D资产生成解决方案。平台核心功能包括文本生成3D模型、单图转3D模型、智能纹理生成,支持游戏开发者、3D设计师、元宇宙内容创作者、动画制作人员、工业设计人员等群体使用,可应用于游戏原型开发、虚拟场景搭建、3D打印原型设计、动画内容制作、电商3D商品展示等多种场景,帮助用户减少传统3D建模的时间成本,提升内容生产效率。
zfkuang.github.io
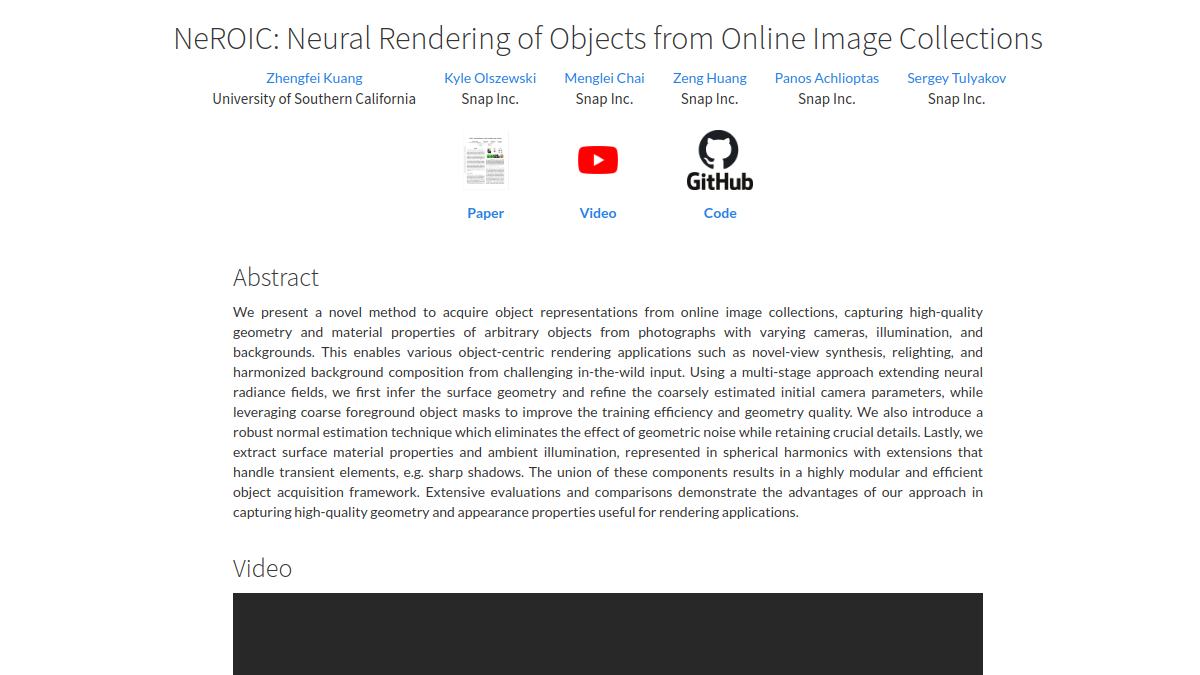
NeROIC是基于神经辐射场技术的物体3D表示获取工具,核心定位是从多源在线图像集合中提取物体的高精度几何与材质属性,支撑多种3D渲染相关应用。核心功能包括多图像联合几何重建、材质与光照属性分离、瞬态场景元素处理,目标用户覆盖计算机视觉研究者、3D内容创作者、数字资产开发人员等,可应用于新视角合成、物体重照明、虚拟场景融合、数字孪生建模等场景,无需复杂的专业采集设备,仅通过普通图像输入即可完成物体的可渲染3D表示构建。
zqh0253.github.io
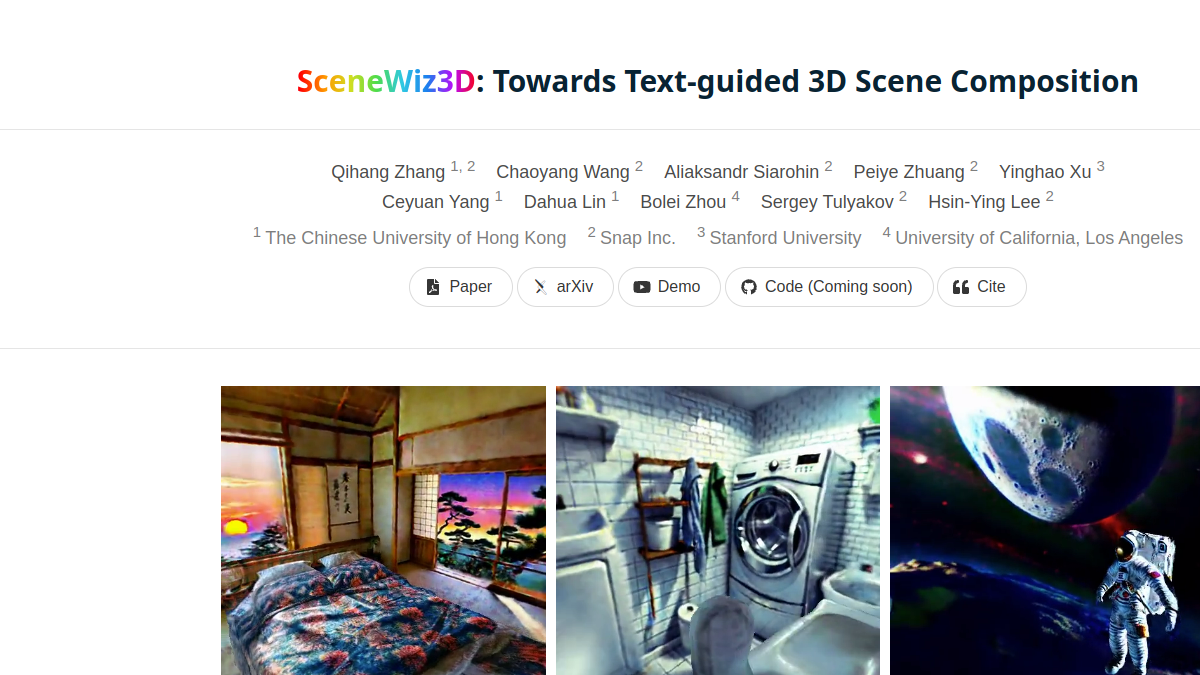
SceneWiz3D是基于文本生成高保真3D场景的开源技术工具,核心采用对象显式+场景隐式的混合3D表示方法,支持文本生成3D对象与自定义对象导入功能,可通过粒子群优化算法自动配置场景布局,还搭载RGBD全景扩散模型优化遮挡区域几何效果。工具面向3D设计从业者、游戏场景开发人员、数字孪生研发人员、计算机视觉研究者等群体,可应用于游戏场景快速搭建、室内设计方案可视化、虚拟场景内容制作、3D场景生成技术研发等多个场景。
anuttacon.com
Anuttacon是专注于虚拟世界体验搭建与通用人工智能(AGI)技术研发的科技服务平台,核心定位是为不同需求的用户提供融合AI能力的数字化互动解决方案。平台核心功能包括AI驱动的虚拟场景自定义生成、多模态AGI互动引擎接入、虚拟数字内容资产化管理,可覆盖创意内容制作、虚拟活动举办、智能交互项目开发等多种需求。目标用户涵盖内容创作者、活动策划人员、AI技术开发者、企业品牌运营人员、数字艺术从业者等,适合需要搭建虚拟互动场景、开发智能交互产品、制作数字化创意内容的各类场景使用。
cascadeur.com
Cascadeur是专注于3D关键帧动画制作的专业软件官网,核心定位是为动画创作者提供具备AI辅助能力的角色动画制作工具。核心功能包括AI辅助关键姿势生成、实时物理效果模拟、次要动作自动调整三类,支持创作者在保留完全创作控制权的前提下提升动画制作效率。目标用户覆盖独立动画创作者、游戏动画设计师、影视动画制作人员、动画专业学生等群体,可应用于游戏角色动作设计、影视动画短片制作、动画课程作业创作、3D内容短视频制作等多种场景,帮助创作者简化动画制作的重复操作环节,聚焦动画内容的创意表达。
mohamad-shahbazi.github.io
InseRF是专注于NeRF三维场景对象插入的技术展示站点,核心功能为基于文本提示生成3D对象、2D边界框位置锚定、多视角场景一致性校验。目标用户覆盖三维重建从业者、计算机视觉研究人员、数字内容创作者、游戏场景开发人员等。可应用于NeRF场景内容扩充、虚拟场景交互设计、三维内容生成算法研究、影视虚拟道具置入等多种场景,帮助用户在无需显式3D建模的前提下,完成符合三维空间逻辑的对象插入操作。
skhu101.github.io
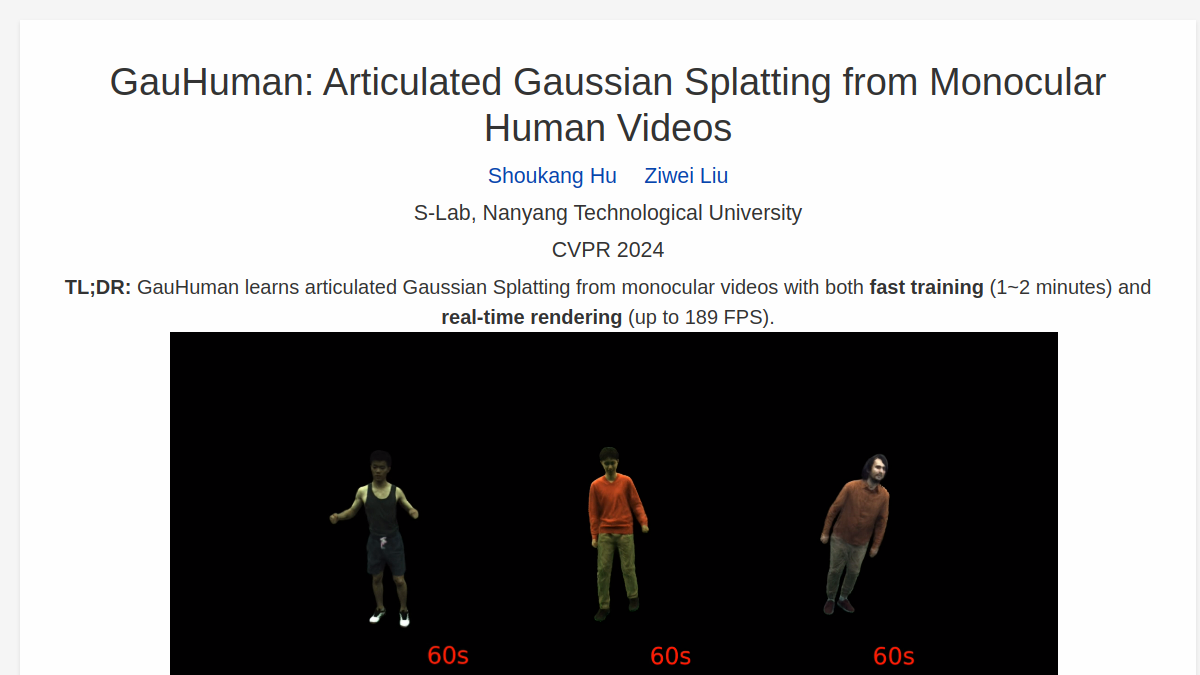
GauHuman是面向3D数字人领域的高斯人体建模开源项目,核心定位为实现高效的3D人体重建与实时渲染。核心功能包括1-2分钟快速训练3D人体高斯模型、最高189FPS的实时高保真渲染、支持多姿态下的人体细节还原。目标用户覆盖计算机视觉研究者、3D内容创作者、游戏开发人员、数字人从业者、动画制作人员等。可应用于数字人直播模型构建、游戏角色资产制作、影视动画人物渲染、3D人体动作捕捉后处理等场景,相较于传统NeRF类方案大幅降低建模时间成本,提升渲染效率。
docs.nerf.studio
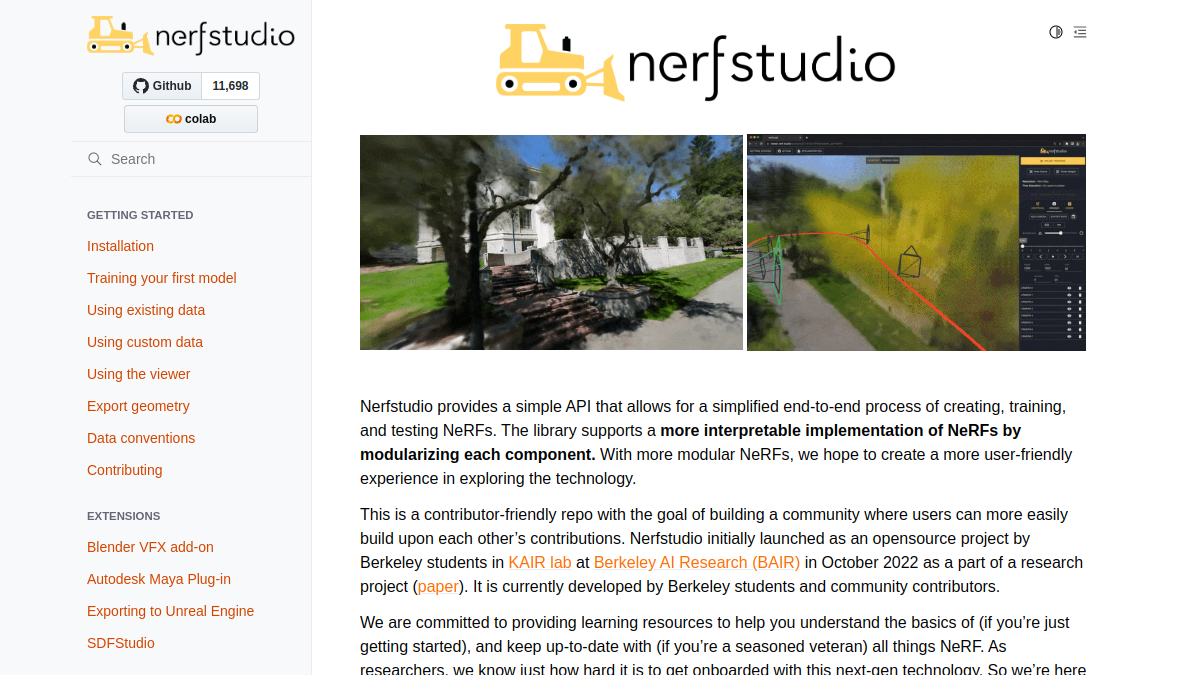
nerfstudio是面向神经辐射场(NeRF)领域的开源开发框架官方文档站点,核心定位是为NeRF研发与应用人员提供体系化的技术支撑资源。站点覆盖模块化框架接口说明、多场景数据预处理教程、训练过程可视化操作指引三类核心内容,目标用户包含计算机视觉领域研究人员、3D内容开发从业者、高校相关专业学生、NeRF技术爱好者等群体,可满足用户学习NeRF基础原理、复现前沿模型、开发自定义3D重建应用、调试模型训练参数等多类场景需求。
threedle.github.io
MeshUp是基于混合得分蒸馏技术的3D网格变形工具,核心定位是为3D创作、科研人员提供精准可控的网格局部编辑能力。核心功能包括文本/图像驱动的多概念变形、自定义顶点选择的局部区域控制、3D一致掩码的概念混合效果生成。目标用户覆盖3D建模从业者、计算机图形学研究者、游戏美术设计师、数字内容创作者。可应用于3D模型局部风格调整、多风格融合的角色模型制作、科研场景下的3D网格变形算法验证等场景,无需复杂的手动网格调整操作,即可实现高精度的网格形态修改。
arthurhero.github.io
Long-LRM是面向3D大场景高斯重建的技术展示项目,核心定位是实现高效的大规模3D场景从图像到三维模型的转化。核心功能包括多输入图像的3D高斯快速重建、大场景一次性完整建模、低算力成本下的高速度处理。目标用户涵盖计算机视觉研究人员、3D内容创作者、自动驾驶场景建模人员、数字孪生开发人员等。可应用于城市场景三维复刻、文物数字化存档、影视虚拟场景构建、自动驾驶仿真环境搭建等多种场景,解决传统3D重建耗时长、无法一次性处理大场景的痛点。
chenhonghua.github.io
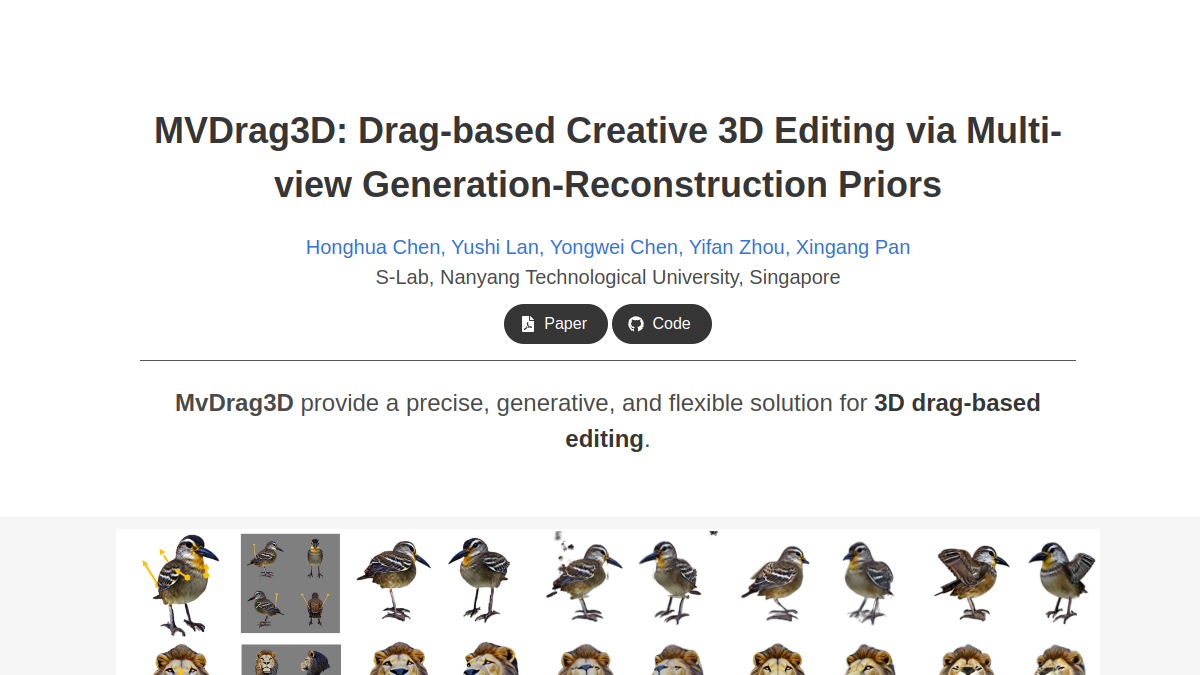
MVDrag3D是基于多视图生成与重建先验技术打造的拖拽式3D编辑框架,核心定位是降低3D内容编辑的操作门槛,实现更灵活的3D对象调整。核心功能包括多视图一致的拖拽式3D变形、3D高斯实时重建与优化、跨视图编辑效果一致性校验。目标用户覆盖3D建模从业者、计算机图形学研究人员、游戏内容开发者、工业设计人员、数字内容创作者等群体,可应用于3D模型局部调整、创意3D造型设计、多视图一致内容生成、3D重建后优化等多种场景,支持多种常见3D对象类别的编辑需求。