单目视频处理
animatabledreamer.github.io
AnimatableDreamer是专注于非刚体3D模型生成与重建的技术框架网站,核心定位为面向单目视频输入的可动画3D内容生成工具。核心功能包括从普通单眼视频中提取物体运动规律、生成不同类别的可动画非刚体3D模型、实现4D动态生成效果的时间一致性校验。目标用户覆盖计算机视觉研究者、3D内容创作者、动画制作从业者、元宇宙内容开发人员、学术科研人员。可应用于短视频3D内容转制、角色动画模型快速生成、文物3D动态还原、虚拟数字人模型搭建、动态物体3D存档等多种场景,为非刚体3D内容生产提供技术支撑。

cat-4d.github.io
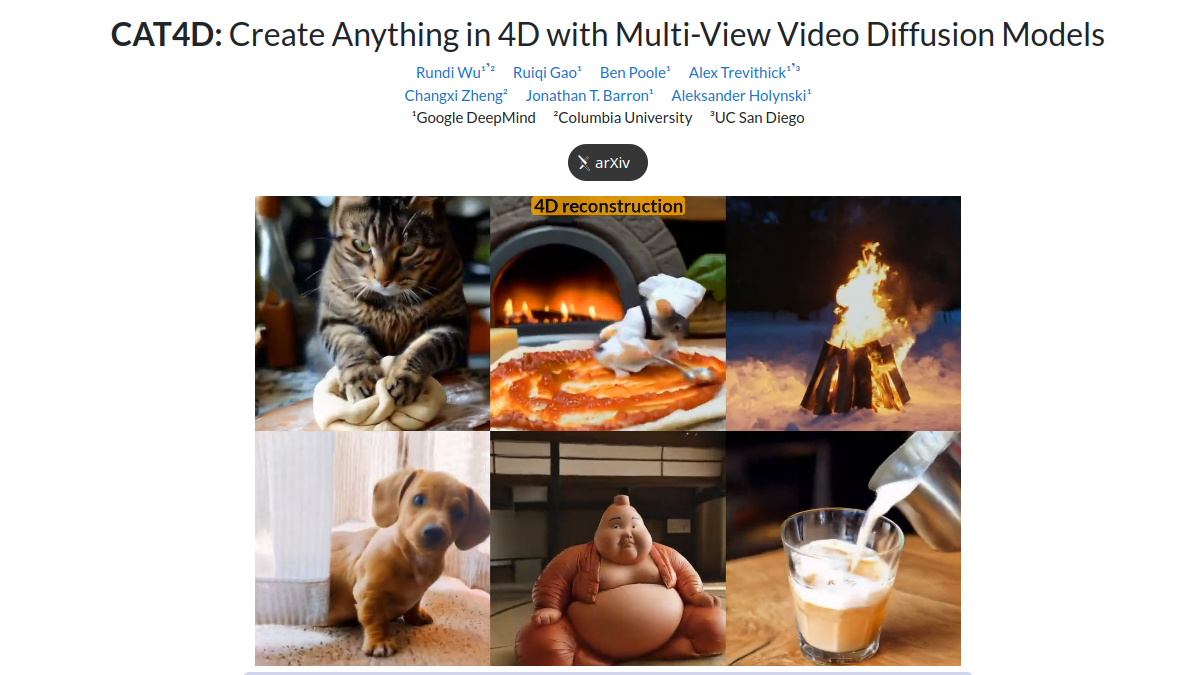
CAT4D是由Google DeepMind、哥伦比亚大学与加州大学圣地亚哥分校联合研发的4D场景生成技术官方站点,核心定位是为科研人员、内容创作者提供基于单目视频的4D场景重建服务。站点核心功能包括单目视频多视角生成、动态3D场景时序重建、4D结果可视化预览三类,目标用户覆盖计算机视觉研究者、AR/VR内容开发者、三维建模从业人员等,可应用于旧视频资源4D化转换、AR场景素材制作、动态三维资产生成等多个场景,帮助用户仅通过普通单视角视频即可完成包含时间维度的4D场景搭建,无需依赖多相机阵列等专业采集设备。
mega-sam.github.io
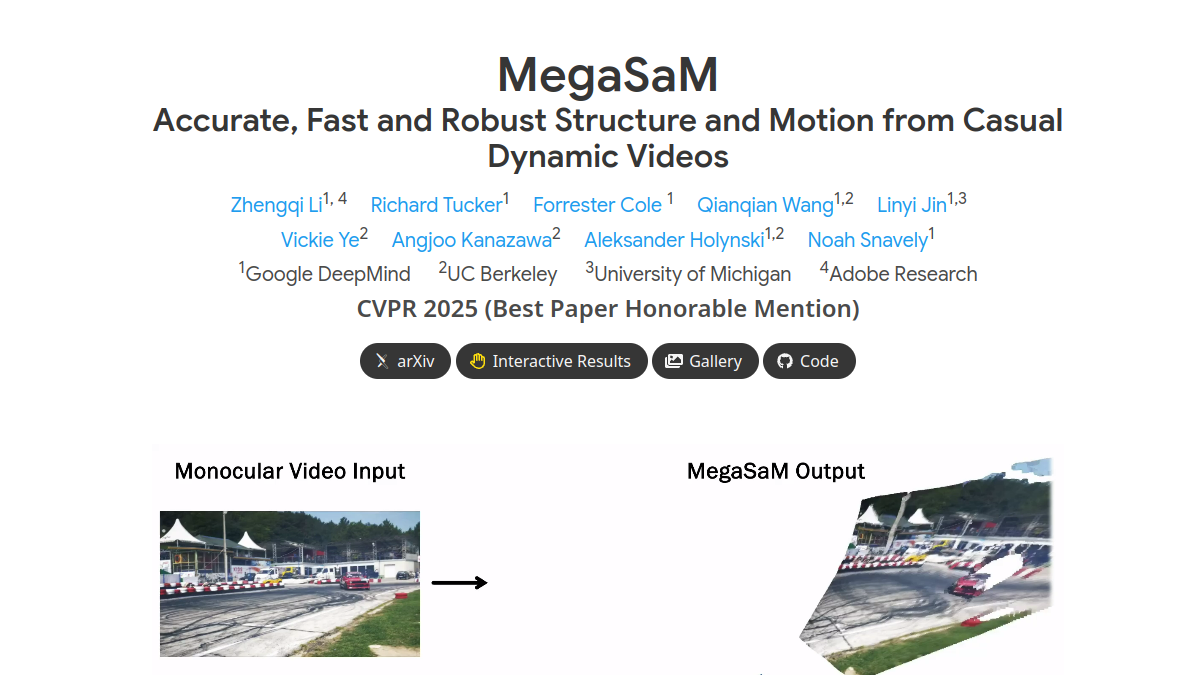
MegaSaM是一个面向动态场景单目视频处理的视觉SLAM技术系统,核心定位为从单目视频中快速稳健估计相机参数与深度图。其核心功能包括动态场景相机姿态估计、高精度深度图生成、不受限相机路径适配。目标用户覆盖计算机视觉研究人员、自动驾驶算法开发者、三维重建从业者、影视特效制作人员、AR/VR技术开发者等群体,可应用于动态街景三维重建、移动设备空间定位、动态场景虚实融合、影视镜头三维信息提取、机器人环境感知等多个场景,解决传统SLAM技术仅适用于静态场景、对相机路径限制较多的问题。
cs.stanford.edu
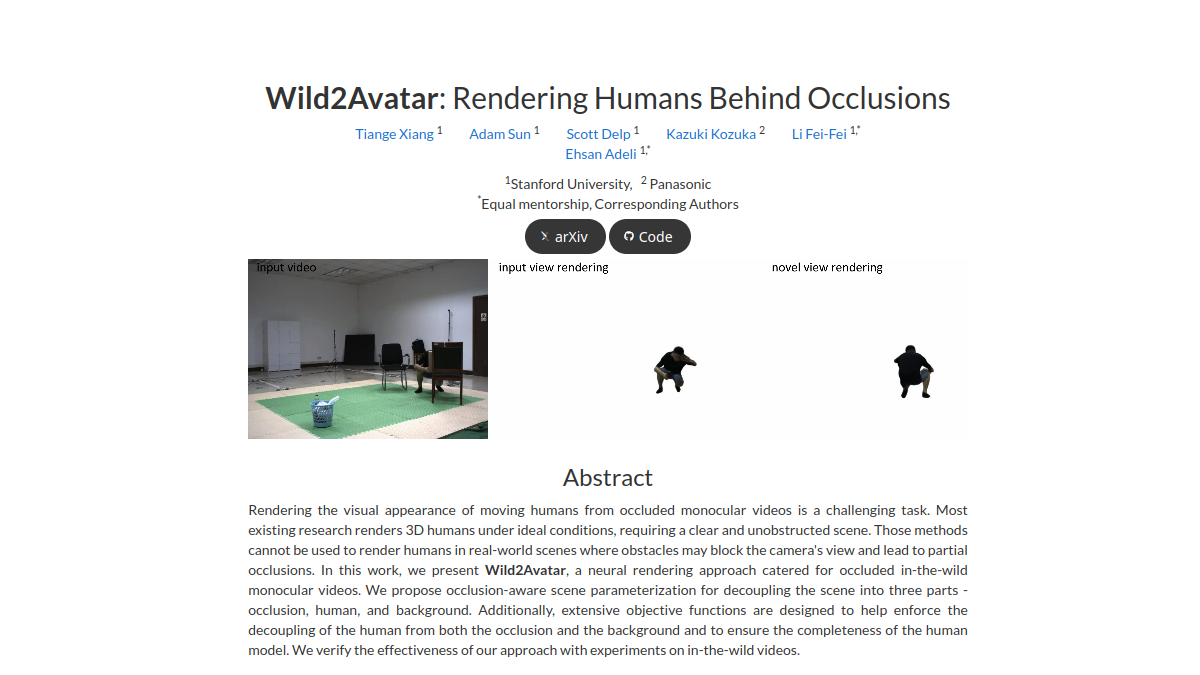
Wild2Avatar是斯坦福大学团队研发的神经渲染技术项目网站,核心定位于解决野外单目视频中被遮挡人体的完整外观渲染问题。核心功能包括三部分场景分解技术、遮挡-人体-背景分离算法、高完整度人体模型重建输出。目标用户覆盖计算机视觉研究者、动画制作人员、智能监控开发人员、AR/VR内容开发者等群体。可应用于复杂街景下的行人姿态还原、影视剧拍摄中被遮挡演员的动作补全、安防监控中被遮挡目标的身份识别、AR交互场景中现实障碍物后的人体模型渲染等多种场景,为真实复杂环境下的人体视觉信息提取提供技术支撑。
lizhiqi49.github.io
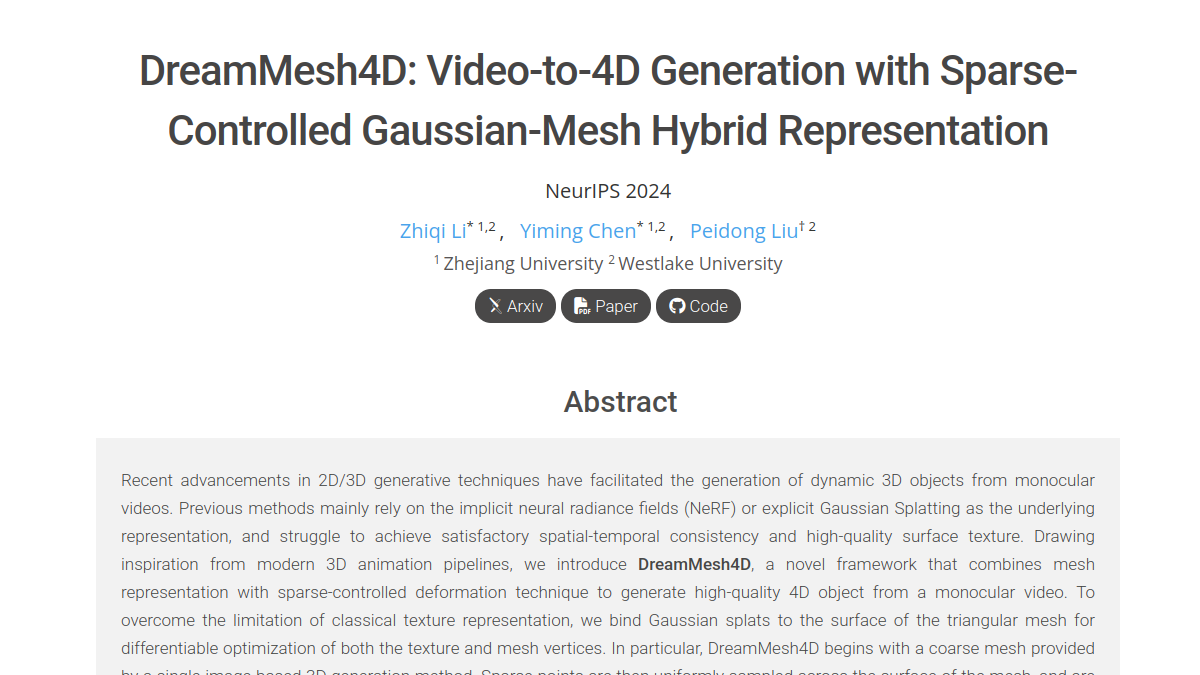
DreamMesh4D是一个面向4D内容生成的学术技术框架站点,核心定位是实现从单目视频输入到高质量4D动态对象的自动生成。其核心功能包括单目视频4D对象重建,支持结合NeRF或3D高斯作为底层表示实现高保真渲染,还提供兼容主流3D生产流程的网格输出能力。站点目标用户覆盖计算机图形学研究者、3D内容创作者、游戏开发人员、影视动画制作者等群体,可用于学术研究中的4D重建技术验证、游戏资产的动态化制作、影视动画中角色与道具的4D内容生成、AR/VR场景中的动态模型搭建等多种场景,有效降低4D内容生产的技术门槛。