计算机视觉工具
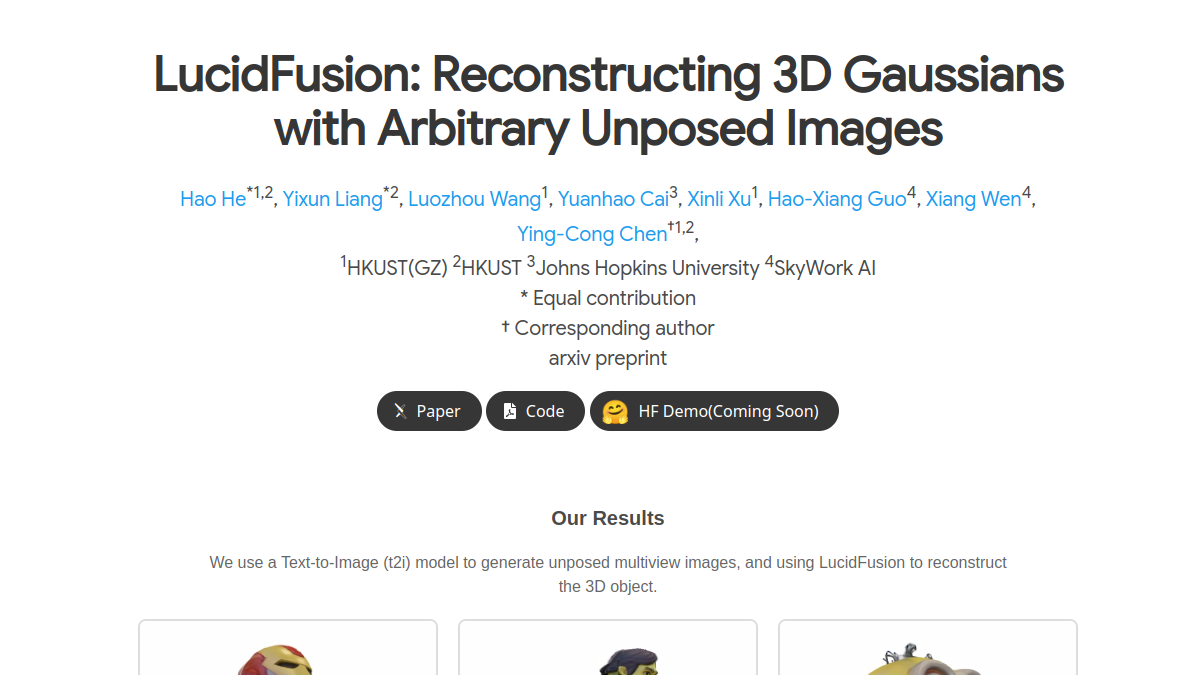

heye0507.github.io
LucidFusion是一款专注于3D高斯生成的端到端前馈框架工具站点,核心定位为帮助用户基于多视图图像快速完成3D内容重建。其核心功能包括多视图图像3D高斯生成、相对坐标图几何特征对齐、单图转3D流程适配三大模块,面向计算机视觉研究者、3D内容创作者、游戏开发人员等群体,可应用于3D资产生产、学术实验验证、数字孪生场景建模等多个场景,无需预先对输入图像进行摆姿势校准,即可处理稀疏、任意数量的多视图输入,输出高分辨率3D高斯资源。
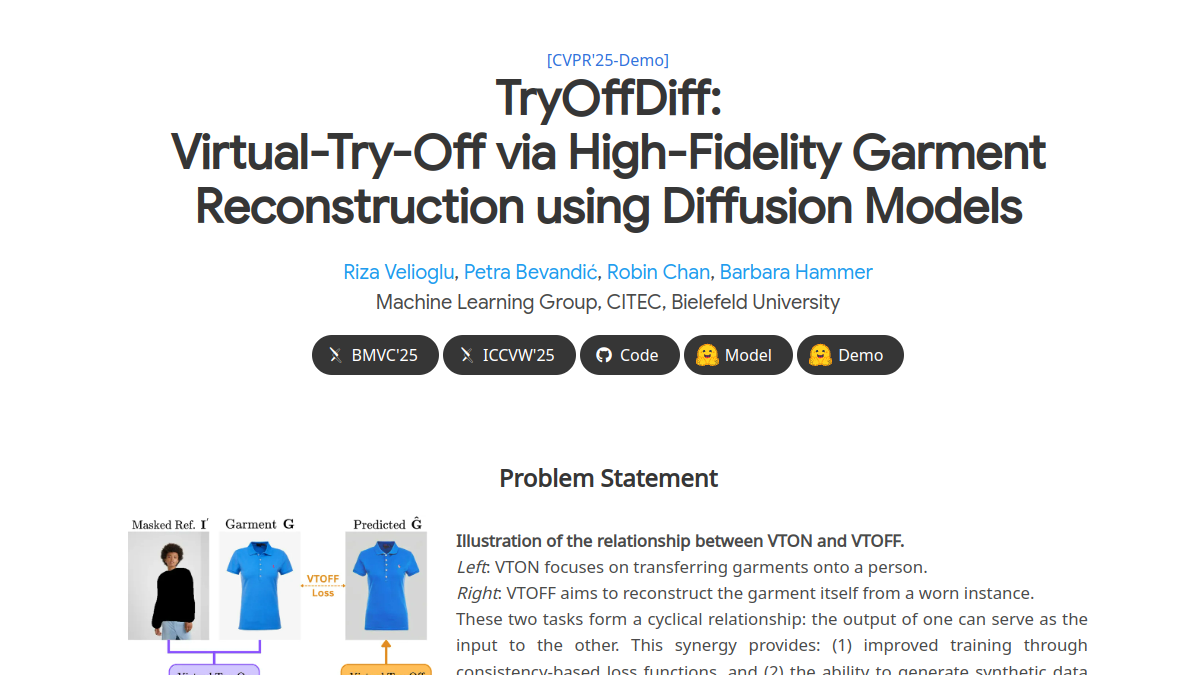

rizavelioglu.github.io
TryOffDiff是基于扩散模型的服装重建技术工具,核心作用是从单张人物穿搭照片中生成标准化的无模特服装图像。核心功能包括高保真服装纹理还原、复杂图案细节保留、服装规范形态提取三类,支持直接输出符合电商展示标准的白底服装图,无需大量人工修图操作。目标用户覆盖电商服装商家、虚拟试穿技术研发人员、计算机视觉领域研究者等群体,可用于电商产品图制作、服装数据集构建、扩散模型效果测试等多个场景。
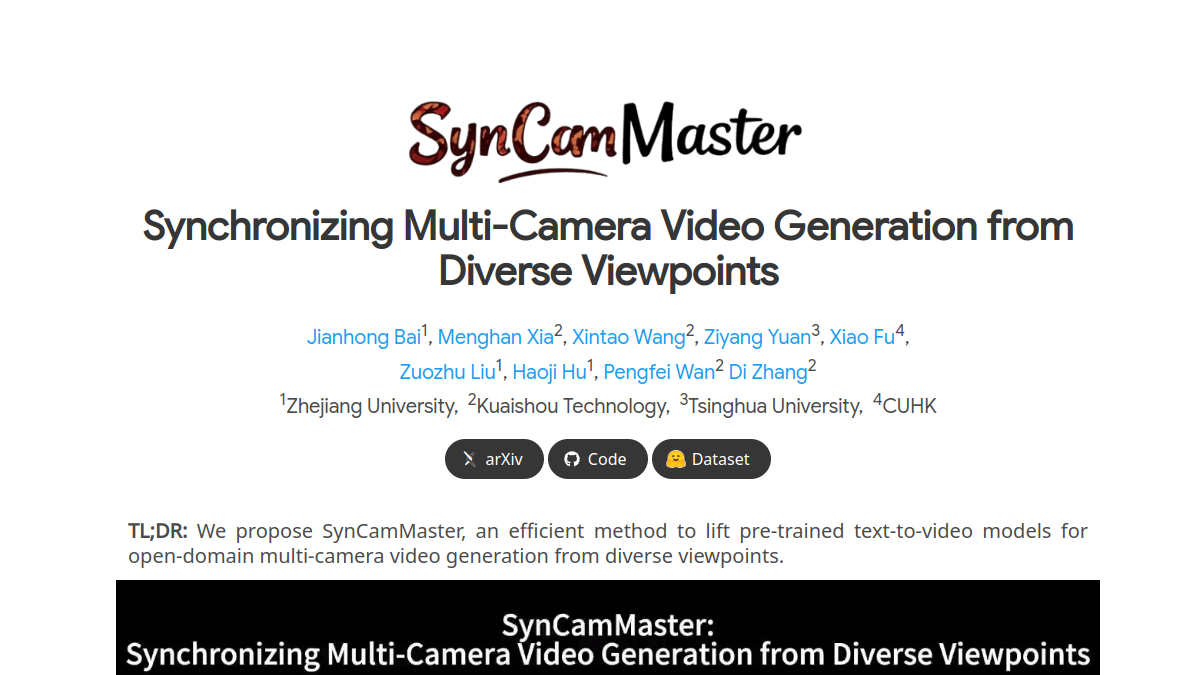
jianhongbai.github.io
SynCamMaster是面向多视角视频生成需求的技术演示平台,核心功能基于多视角同步视频生成技术,可实现任意视角的视频生成、6自由度摄像机姿态适配,以及多源训练数据的模型优化。目标用户覆盖影视制作人员、VR内容开发者、计算机视觉研究者、虚拟场景设计师等群体,可应用于虚拟拍摄多机位素材生成、VR全景内容多视角补充、自动驾驶仿真场景多视角视频构建、计算机视觉多视角算法训练数据集制作等场景,帮助用户降低多视角视频内容的制作成本,提升不同视角内容的动态一致性。
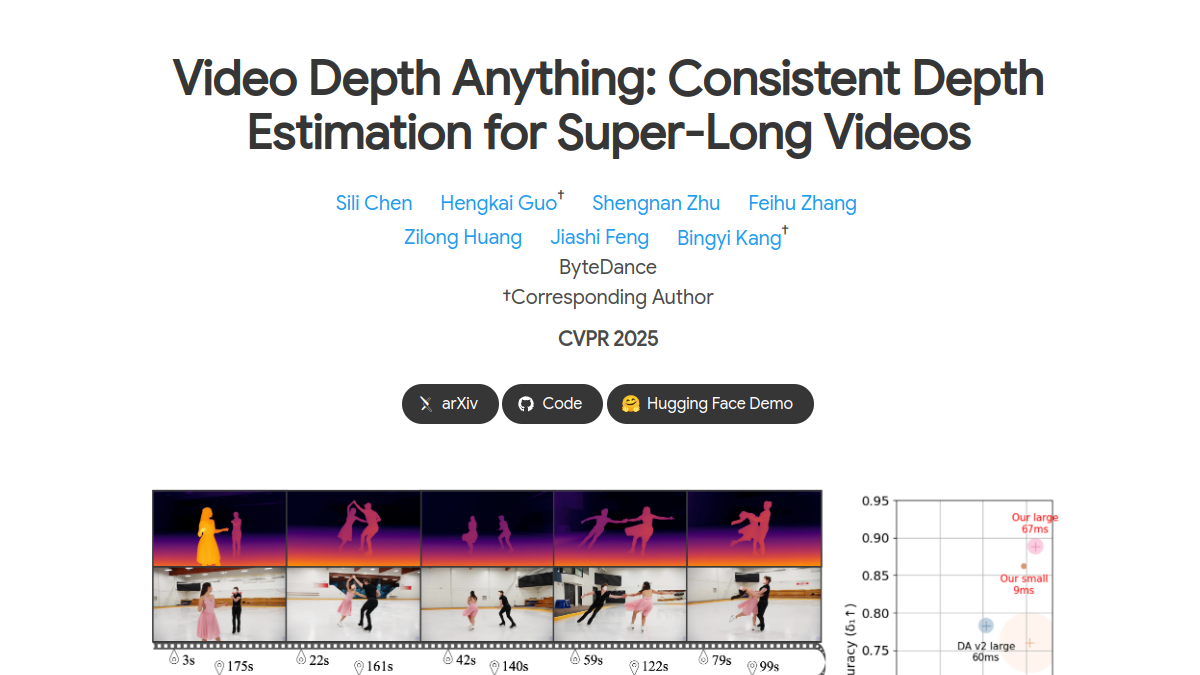

videodepthanything.github.io
Video Depth Anything是一个面向长视频的深度估计在线工具,核心定位是为各类视频提供稳定连贯的深度信息生成服务。平台支持超长时间视频的深度计算,可保持帧间深度结果的一致性,避免出现画面抖动或跳变问题,同时支持多种常见视频格式上传,生成的深度结果可直接导出使用。目标用户覆盖计算机视觉研发人员、视频特效创作者、三维重建从业者、自动驾驶仿真测试人员等群体,可用于3D视频内容制作、自动驾驶场景数据集构建、影视后期特效合成、AR交互场景搭建等多种场景,帮助用户降低手动标注深度信息的工作量。

layerx.ai
LayerX.ai是面向计算机视觉领域的AI数据全生命周期管理平台,核心服务于计算机视觉项目研发团队,提供数据归集、标注管理、数据集检索、工作流集成等能力。平台支持多源异构数据统一存储管理,可实现亿级规模数据集的秒级检索,同时开放全链路API与SDK接口,能够与现有标注工具、训练框架、存储基础设施无缝对接。适合计算机视觉算法团队在自动驾驶、工业质检、安防监控、医疗影像等项目场景中使用,帮助团队减少数据处理环节的重复劳动,提升模型训练的数据集质量与迭代效率。

sliderspace.baulab.info
SliderSpace是由BAU实验室推出的扩散模型能力分析与交互工具,核心定位是为AI生成图像研究人员、开发者提供可视化的扩散模型内部机制解析途径。其核心功能包括通过可调节滑块拆解扩散模型不同视觉生成维度的权重、实时预览参数调整后的图像生成效果、导出模型不同层的激活特征数据。目标用户覆盖AI生成图像研究人员、计算机视觉方向学生、扩散模型开发者、AI艺术创作者等群体,可应用于扩散模型可解释性研究、生成参数调优、AI生成内容可控性实验、模型能力对比测试等多种场景。
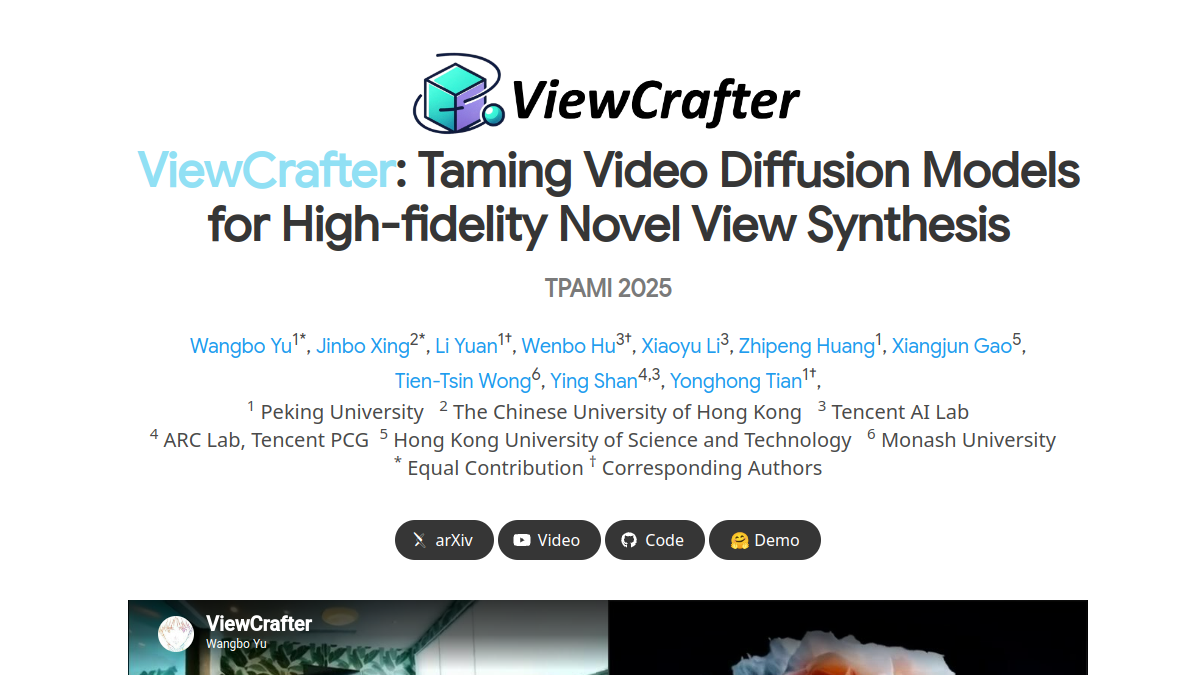
drexubery.github.io
ViewCrafter是基于视频扩散模型与点云3D表示的创新视角合成工具,核心定位为面向3D内容创作、空间可视化领域的单/稀疏图像多视角生成平台。其核心功能包括单图场景高保真新视角生成、稀疏视图3D范围迭代扩展、3D-GS格式输出适配实时渲染,主要面向3D建模师、游戏场景设计师、数字孪生开发者、内容创作者等群体,可应用于快速生成场景多视角素材、辅助3D资产重建、沉浸式内容前置预览等多个场景,无需复杂的多视图采集设备即可完成常规视角下的场景扩展生成。

lukashoel.github.io
ViewDiff是一个面向3D内容创作、计算机视觉研究领域的在线多视角一致图像生成工具,基于预训练文本到图像模型作为技术基础,结合3D体积渲染与跨帧注意力机制实现3D一致性内容生成。核心功能包括单图生成多视角一致图像、文本引导3D视角内容编辑、自定义相机参数视角渲染三类,目标用户覆盖计算机视觉研究人员、3D建模师、游戏内容创作者、动画制作人员等,可用于快速生成3D资产多视角参考图、小体量3D内容原型制作、学术研究中的3D生成效果对比等场景,帮助用户降低多视角3D内容的制作门槛。

spright-t2i.github.io
SPRIGHT是聚焦空间关系的视觉语言数据集与模型项目网站,核心为解决AI图像生成中空间关系表达偏差的行业问题。平台提供覆盖600万张图像的公开数据集下载入口,支持空间一致性生成效果的在线演示对比,还开放微调后的模型推理接口。目标用户涵盖计算机视觉领域研究人员、AI图像生成算法开发者、多模态大模型训练从业者,可用于学术研究数据支撑、图像生成模型空间能力优化、多模态模型训练数据集补充等场景。
grisoon.github.io
PersonaTalk是专注于音频驱动视觉配音的技术演示网站,核心为基于注意力机制的两阶段视觉配音框架,可实现高保真度的个性化面部生成效果。核心功能包括风格感知音频编码、双注意力面部渲染、个性化特征保留三类,支持用户上传音频与目标人物素材快速生成对应配音视频。主要面向计算机视觉研究人员、数字内容创作者、虚拟形象开发从业者、影视后期制作人员等群体,适用于虚拟人内容制作、老视频修复配音、多语言译制片面部匹配、数字人交互内容生成等多种场景,帮助用户在保证唇形同步准确度的同时,保留说话者的独特面部特征与表达风格。

depthify.ai
Depthify.ai是一款专注于普通RGB图像转空间格式的在线处理工具,核心定位是为空间内容创作者、VR设备用户提供图像格式转换服务。其核心功能包括将普通平面图像转换为兼容Apple Vision Pro、Meta Quest等主流VR设备的空间格式,可生成深度图、立体图像、符合设备要求的HEIC文件,同时支持批量图像处理以提升工作效率。该工具面向VR内容开发者、3D建模从业者、计算机视觉研究人员、普通VR设备用户等群体,可应用于VR相册内容制作、3D建模素材预处理、计算机视觉模型训练数据生成、个人空间内容创作等多个场景,无需复杂的专业软件操作即可完成平面图像到空间格式的转换。

cat-4d.github.io
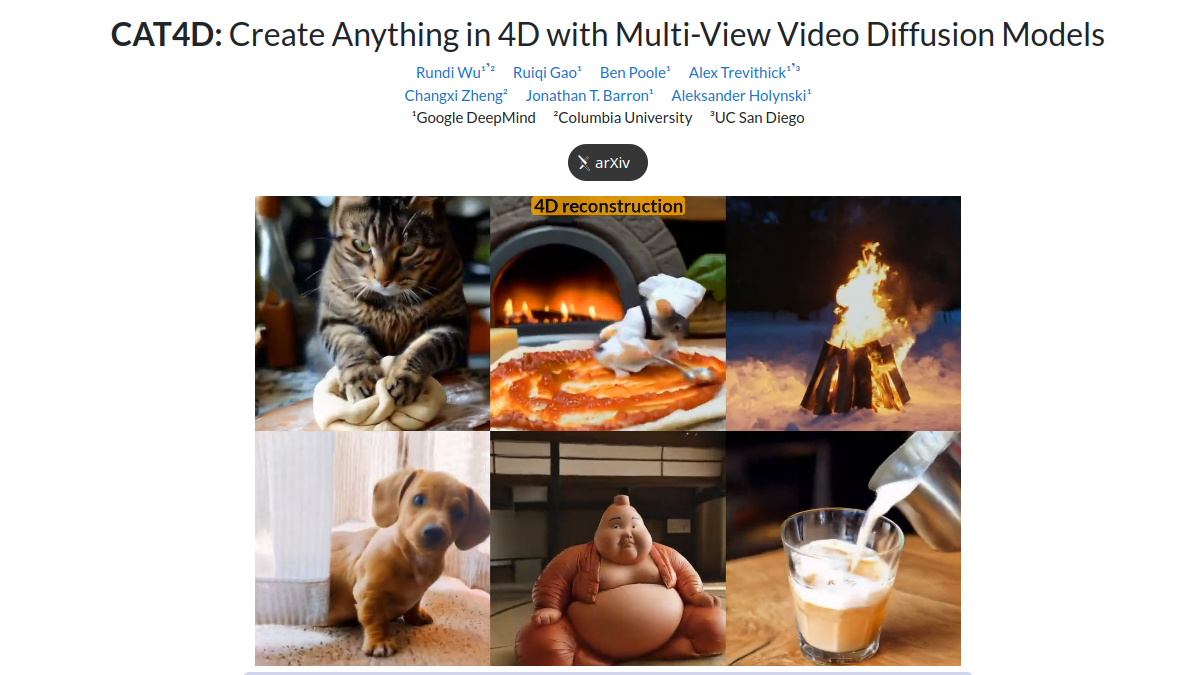
CAT4D是由Google DeepMind、哥伦比亚大学与加州大学圣地亚哥分校联合研发的4D场景生成技术官方站点,核心定位是为科研人员、内容创作者提供基于单目视频的4D场景重建服务。站点核心功能包括单目视频多视角生成、动态3D场景时序重建、4D结果可视化预览三类,目标用户覆盖计算机视觉研究者、AR/VR内容开发者、三维建模从业人员等,可应用于旧视频资源4D化转换、AR场景素材制作、动态三维资产生成等多个场景,帮助用户仅通过普通单视角视频即可完成包含时间维度的4D场景搭建,无需依赖多相机阵列等专业采集设备。

dioptra.ai
Dioptra是一款开源的数据管理与标注平台,核心面向人工智能开发场景,为计算机视觉、自然语言处理、大语言模型研发团队提供全链路数据治理支撑。平台支持元数据统一注册管理,可定位模型推理失败的根因,还内置主动学习算法,能够筛选高价值未标注数据,同时提供标准化API接口,可对接现有标注、重训练工作流。其目标用户包括AI算法工程师、数据标注团队、机器学习研发负责人等,适用于模型迭代优化、标注成本管控、训练效率提升等多个研发场景。
yongshengyu.com
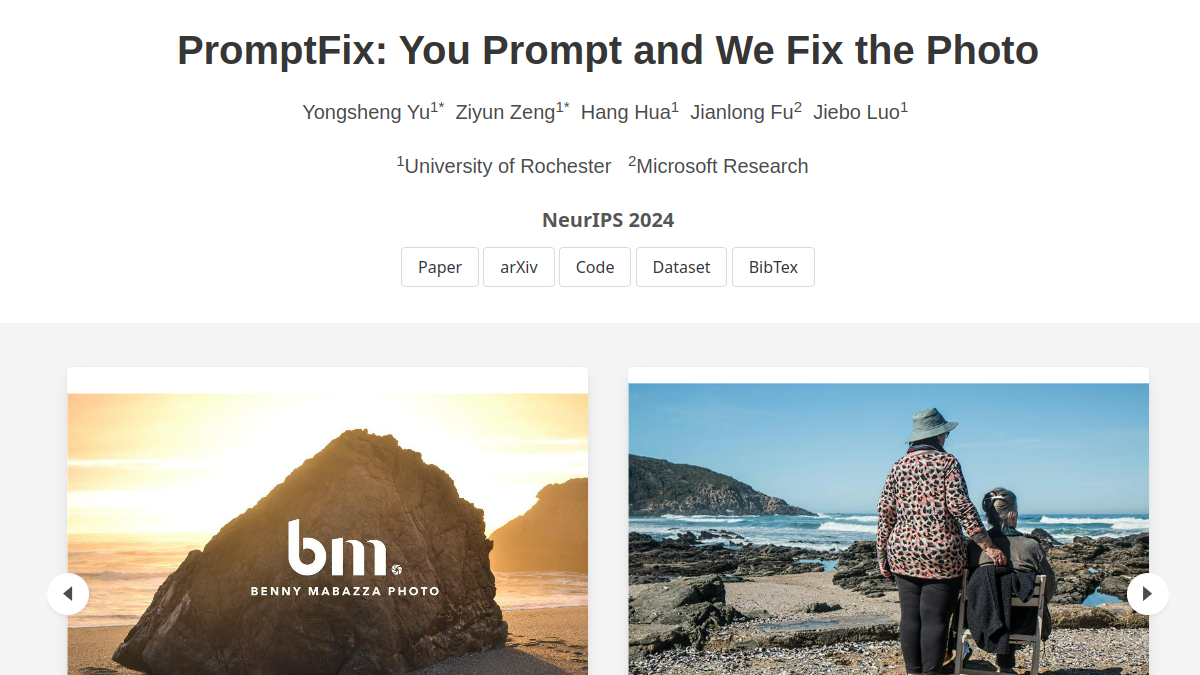
PromptFix是聚焦于扩散模型指令驱动图像处理的技术框架站点,核心定位为提升扩散模型图像编辑与修复类任务的指令遵循准确度。平台具备指令数据集构建参考、高频引导采样算法配置、辅助提示适配器参数调试三大核心功能,主要面向AI图像算法研发人员、计算机视觉方向研究者、AIGC应用开发从业者,可应用于图像盲恢复、多指令组合图像处理、零样本图像任务适配等场景,帮助开发者降低扩散模型多任务适配的研发成本,提升图像处理任务的输出匹配度。

trexlabel.com
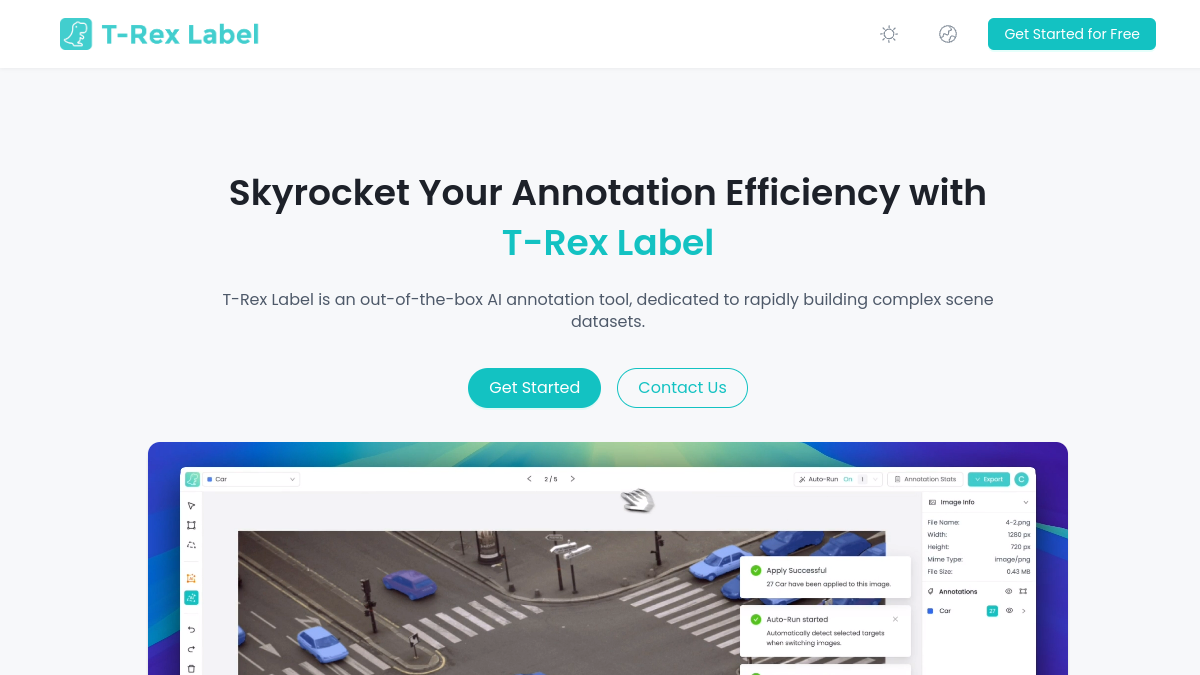
T-Rex Label是一款专注于视觉数据标注的智能工具,核心定位为面向密集场景的零样本标注平台,无需预训练即可完成多类型视觉目标的标注作业。平台支持视觉提示输入、批量目标识别、多格式数据导出三大核心功能,可适配工业缺陷检测、农业病虫害识别、城市安防监控等多个领域的标注需求,目标用户覆盖算法工程师、AI研究人员、数据集制作从业者、计算机相关专业学生等群体,可用于目标检测数据集构建、模型训练数据预处理、密集场景目标统计等多个使用场景,帮助用户降低标注门槛,提升标注作业的整体效率。
hasty.ai
Hasty是面向计算机视觉领域的一站式视觉AI开发平台,核心定位是帮助用户从原始图像、视频素材出发,快速完成数据处理到生产级模型部署的全流程工作。平台支持AI辅助自动化标注,能自动识别图像中的常见目标并生成标注框,大幅降低手动标注的工作量;内置智能质量校验功能,可自动检测标注错误、标注缺失等问题,减少人工审核的重复劳动;还提供端到端模型训练能力,无需复杂的MLops配置即可完成模型迭代优化。目标用户覆盖计算机视觉算法开发人员、数据标注团队、AI项目产品经理等,可应用于自动驾驶图像数据集构建、工业缺陷检测模型开发、安防视频分析系统搭建等多个场景,降低视觉AI项目的落地门槛。