扩散模型应用
magicanimate.org
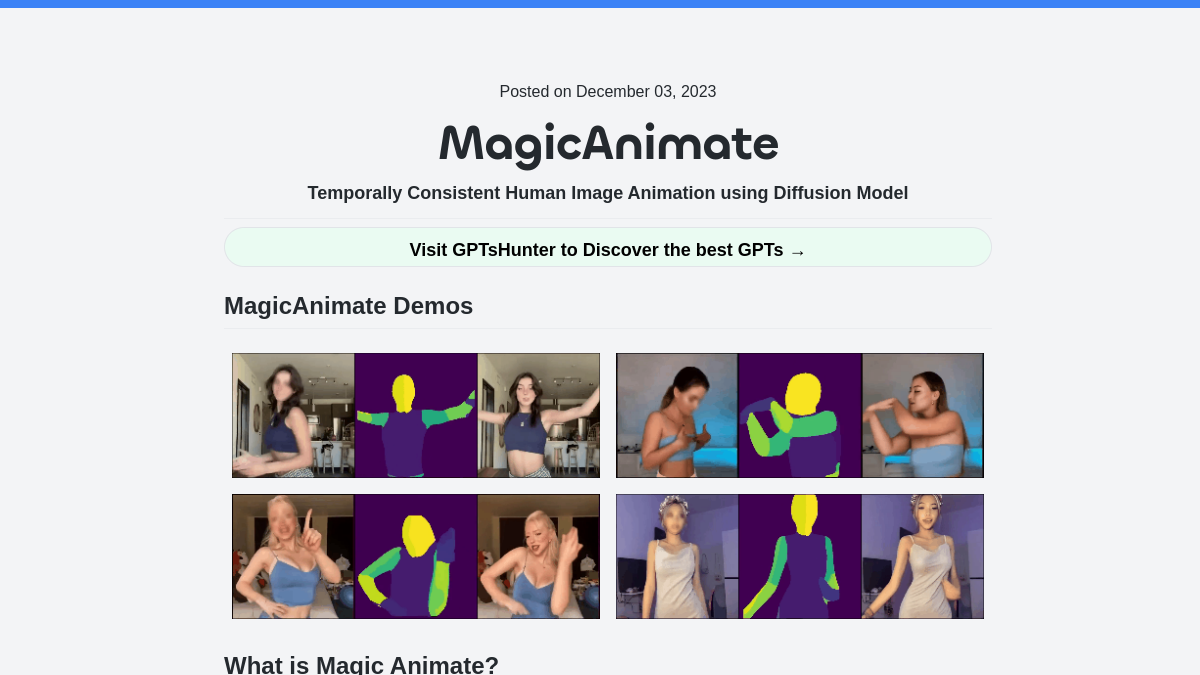
MagicAnimate Playground是由新加坡国立大学Show Lab与字节跳动联合开发的人体图像动画生成工具,核心基于扩散模型技术,可实现静态人体图像的动态化生成。平台支持单张参考图像搭配动作视频驱动生成连贯动画,保留原图像的人物特征与画面风格,同时支持跨身份动作迁移、油画/动漫等非常规领域图像动画处理,还可对接DALLE3等文本生成图像模型的输出内容赋予动态效果。目标用户涵盖动画创作者、短视频制作者、数字艺术从业者、游戏美术设计人员以及AI生成内容爱好者,可应用于短视频角色动态制作、虚拟IP形象动效生成、艺术作品动态化演绎、游戏角色动作demo制作等多个场景。

rizavelioglu.github.io
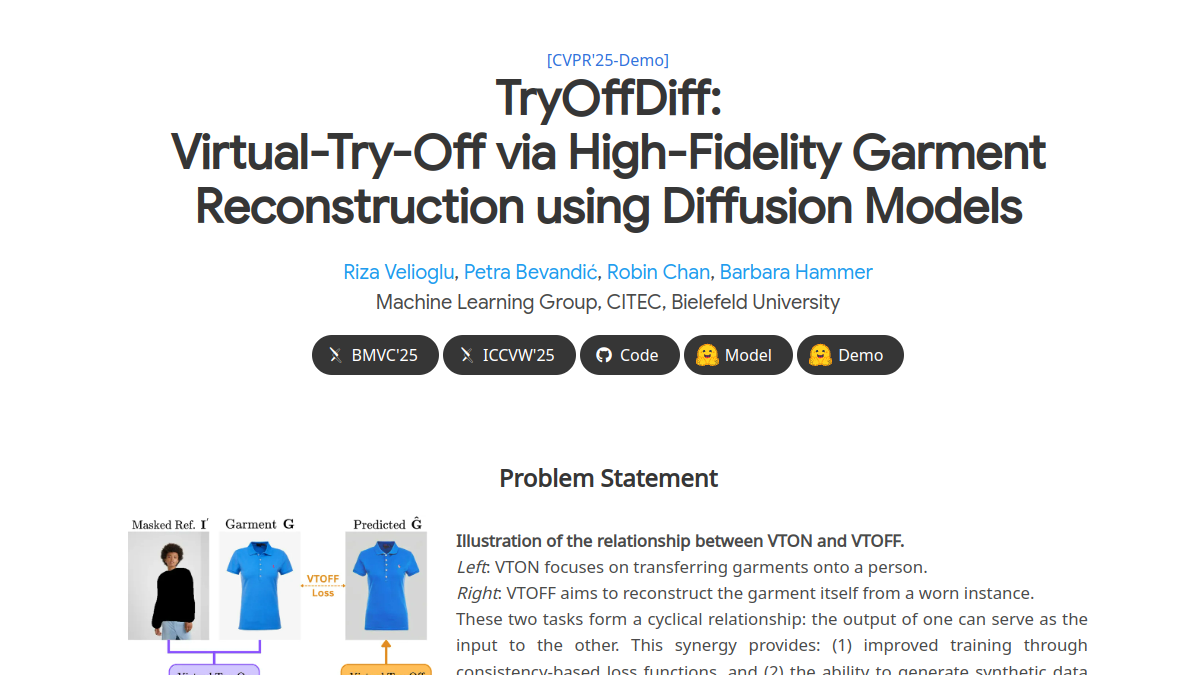
TryOffDiff是基于扩散模型的服装重建技术工具,核心作用是从单张人物穿搭照片中生成标准化的无模特服装图像。核心功能包括高保真服装纹理还原、复杂图案细节保留、服装规范形态提取三类,支持直接输出符合电商展示标准的白底服装图,无需大量人工修图操作。目标用户覆盖电商服装商家、虚拟试穿技术研发人员、计算机视觉领域研究者等群体,可用于电商产品图制作、服装数据集构建、扩散模型效果测试等多个场景。
yeungchenwa.github.io
Historical Document Repair是一个面向历史文献修复领域的线上工具站点,核心定位是为受损历史文档提供智能修复解决方案。站点搭载基于扩散模型的DiffHDR算法,可处理字符缺失、纸张破损、墨水侵蚀等多种文档损伤类型,同时支持文档编辑、文本块生成等衍生功能,目标用户涵盖档案管理员、历史研究人员、文献修复从业者、古籍数字化工作者等群体,适用于古籍档案数字化预处理、破损历史文献内容复原、文物展览资料修复、学术研究史料整理等多种场景,助力历史文化资源的保护与传承。
lijiaman.github.io
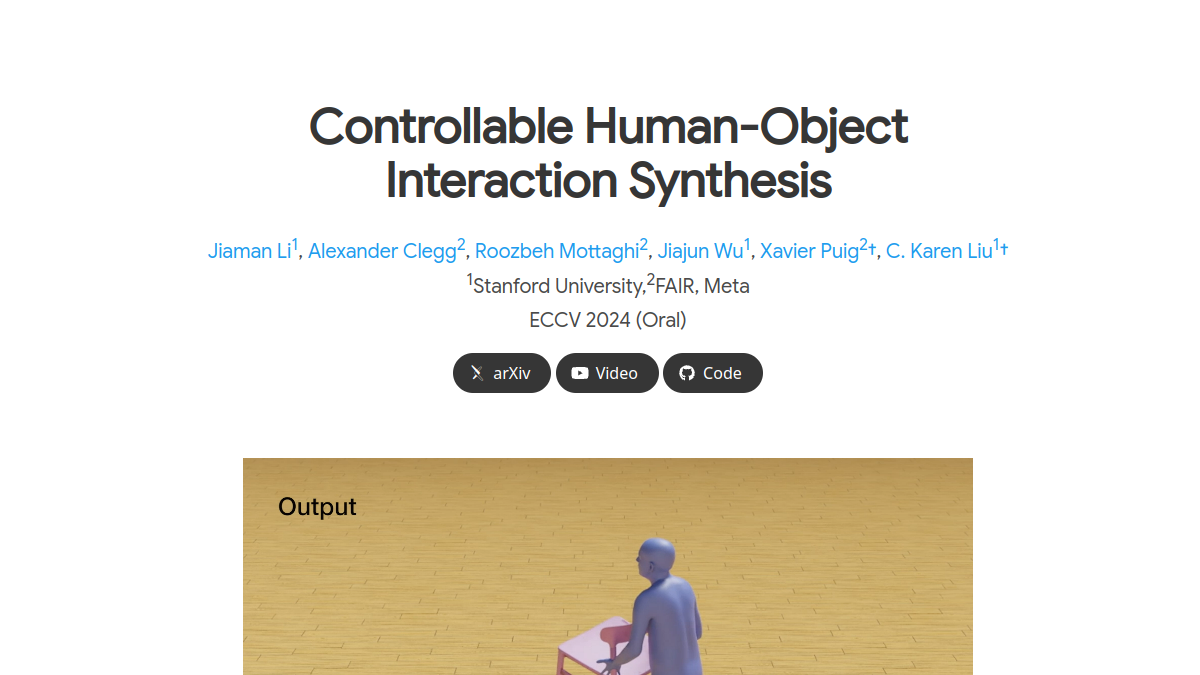
CHOIS全称为Controllable Human-Object Interaction Synthesis,是面向人机交互动作生成领域的开源技术项目,核心定位是可控的人与物体交互动作合成工具。核心功能包括根据自然语言描述生成对应的人与物体协同运动序列、结合初始状态与稀疏路径点约束输出符合物理规则的交互动作、通过接触约束保障手物交互与地面支撑的合理性。目标用户覆盖计算机图形学研究者、游戏动画开发人员、虚拟场景制作从业者、机器人运动规划研发人员等,可应用于3D动画内容制作、虚拟数字人交互动作开发、机器人行为模拟训练、元宇宙场景交互内容搭建等场景,帮助用户降低复杂交互动作的制作与研发成本。

crayon-shinchan.github.io
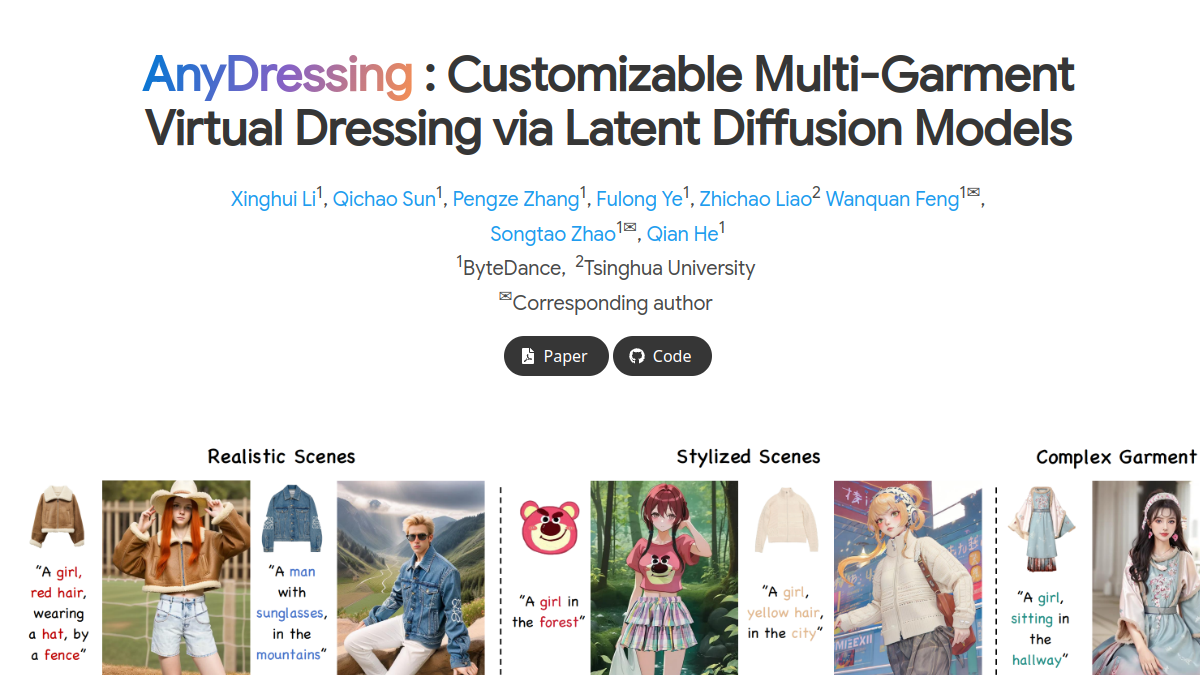
AnyDressing是由字节跳动与清华大学研究团队联合开发的虚拟试穿技术展示平台,核心基于潜在扩散模型实现多服装的定制化试穿效果生成。平台支持用户上传多件服装素材、输入个性化文本提示,即可输出高还原度的虚拟试穿图像,可保留服装原始纹理细节、适配不同身形与场景需求。当前该项目处于研究展示阶段,主要面向学术研究人员、电商服饰从业者、数字内容创作者等群体,可用于技术研发参考、服饰效果预演、虚拟人物穿搭设计等场景。

dynvfx.github.io
DynVFX是一款基于Transformer文本到视频扩散模型与视觉语言模型的视频内容编辑工具,核心定位是帮助用户通过文本指令完成动态内容的视频植入。核心功能包括文本驱动的动态元素插入、复杂场景运动适配、视频内容自然增强,无需额外训练即可实现零样本内容生成,面向视频后期创作者、内容运营人员、独立影视制作者、广告创意设计师等群体,可广泛应用于短视频特效制作、影视后期补拍、广告内容植入、创意视频二次创作等场景,降低动态特效制作的技术门槛。
aslp-lab.github.io
DiffRhythm是基于潜在扩散模型开发的端到端全曲生成工具网站,核心定位是为音乐创作相关群体提供AI辅助的歌曲生成服务。核心功能包括完整人声加伴奏全曲生成、文本提示词驱动创作、多风格音乐适配、生成结果在线预览、参数自定义调节。目标用户覆盖音乐创作者、内容运营者、学生群体、短视频制作者等,可用于原创音乐小样制作、短视频背景配乐生成、课程作业辅助创作、个人兴趣音乐尝试等多种场景,帮助用户降低音乐创作的技术门槛,拓展音乐产出的可能性。

diffusionlight.github.io
DiffusionLight是一款基于扩散模型的单图光照估计工具,核心定位是为3D创作、影视渲染、增强现实等领域提供高精度的场景照明还原方案。其核心功能包括单张LDR图像输入生成HDR全景光照图、迭代式镜面反射球生成优化、多曝光LoRA训练适配真实场景光照需求。目标用户覆盖3D建模师、影视后期特效师、AR内容开发者、计算机视觉研究者、游戏场景设计师等群体,可应用于虚拟物体插入真实场景的光照匹配、三维场景渲染的环境光设置、野外拍摄素材的后期光照还原、自动驾驶仿真场景的光照模拟等多种工作场景。
follow-your-canvas.github.io
Follow-Your-Canvas 是聚焦视频外延处理的技术演示平台,核心基于扩散模型构建,面向视频创作、多媒体开发、AI技术研究群体提供视频分辨率拓展服务。平台支持低分辨率视频向更高规格分辨率转换,通过分布式计算架构优化降低GPU显存占用门槛,转换过程中可保留视频原有帧间连贯性与画面细节,适合短视频创作者提升旧素材清晰度、研究人员测试视频生成效果、多媒体开发者验证分辨率适配方案等场景使用。
humanaigc.github.io
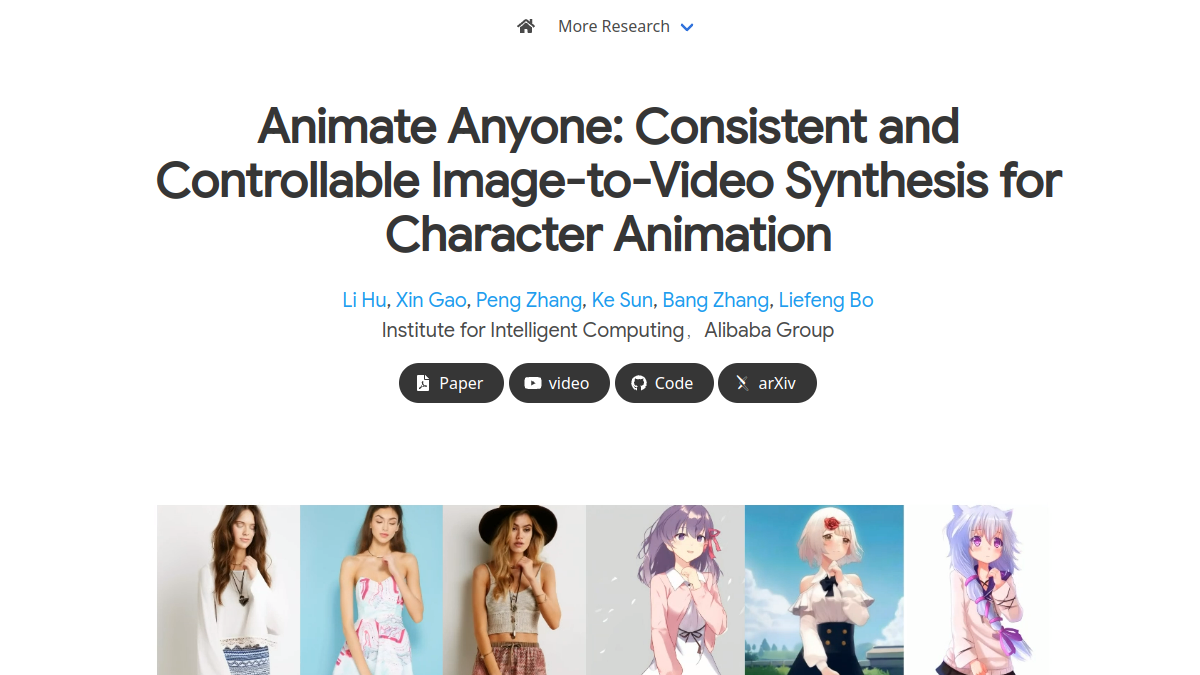
Animate Anyone是由AI生成内容团队开发的角色动画生成工具,核心定位是通过AI技术将静态角色图像转换为连贯动态视频。平台搭载ReferenceNet特征保留模块,可精准保留参考图像中角色的服饰、纹理、面部特征等细节;配备姿势引导器,支持通过动作序列控制角色运动轨迹;采用时间建模算法,保障视频帧之间的过渡自然。该工具面向动画创作者、游戏开发者、电商内容运营者、短视频创作者等群体,可应用于虚拟角色动作制作、服装动态展示、创意短视频内容生成、动漫同人动画创作等场景,无需复杂的传统动画制作流程即可输出符合需求的角色动态视频。
primecai.github.io
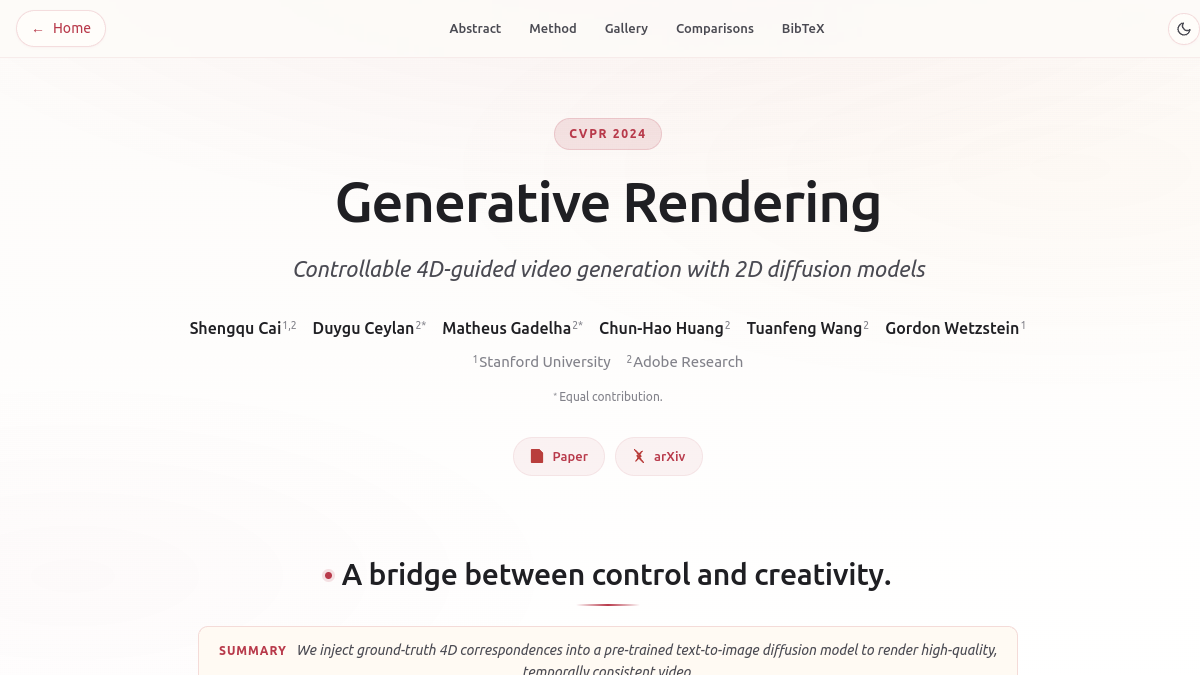
Generative Rendering:2D mesh是一款结合3D网格可控性与扩散模型生成能力的在线生成工具,核心定位是解决现有文本生成视频可控性不足的问题。其核心功能包括支持低保真动画3D网格输入生成高保真时序一致视频、可通过调整资产动作与相机路径控制视频内容、将网格对应信息注入文本生成模型各阶段保证生成质量。目标用户覆盖CG创作者、AI生成内容研究者、动画制作从业者、游戏内容开发者、新媒体内容创作者等,可应用于动画初稿制作、3D内容风格化渲染、创意短视频生成、游戏过场动画快速制作、学术研究效果验证等多种场景。

wangyuchi369.github.io
InstructAvatar是专注于文本引导2D情感头像生成的技术展示站点,核心提供基于自然语言指令的动态头像生成能力。站点支持用户通过文本描述控制头像的情感状态与面部动作,可生成匹配语音内容的唇动同步动态头像,还提供算法原理说明与效果演示案例。目标用户覆盖AI生成内容创作者、虚拟主播运营者、动画制作人员、人机交互研究人员等群体,可应用于虚拟形象定制、短视频头像内容制作、智能客服形象生成、互动式虚拟角色开发等场景,帮助用户降低动态头像制作的技术门槛。
inversepainting.github.io
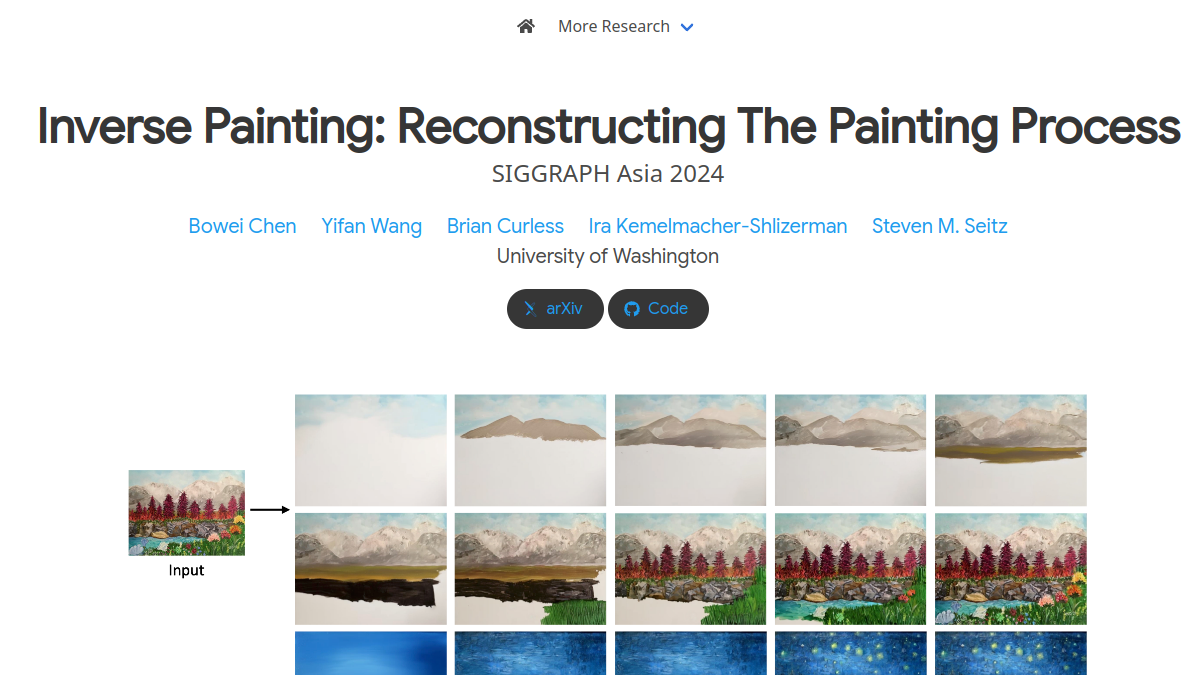
Inverse Painting是一款基于扩散模型的绘画过程生成工具,核心定位是将已完成的艺术画作反向推导并还原出类人的绘画创作时间流逝视频。其核心功能包括单图绘画过程还原、多艺术风格适配、自定义创作节奏调整,支持处理油画、水彩、丙烯、素描等多种艺术流派作品,主要面向数字艺术创作者、艺术教育工作者、动画制作人员、艺术研究学者等用户群体,可用于艺术教学演示、创作过程复盘、短视频内容制作、艺术史研究分析等多种场景。