视频推理
1 个收录工具1 个分类7 个关联标签编辑实测收录
1 个结果
llava-vl.github.io
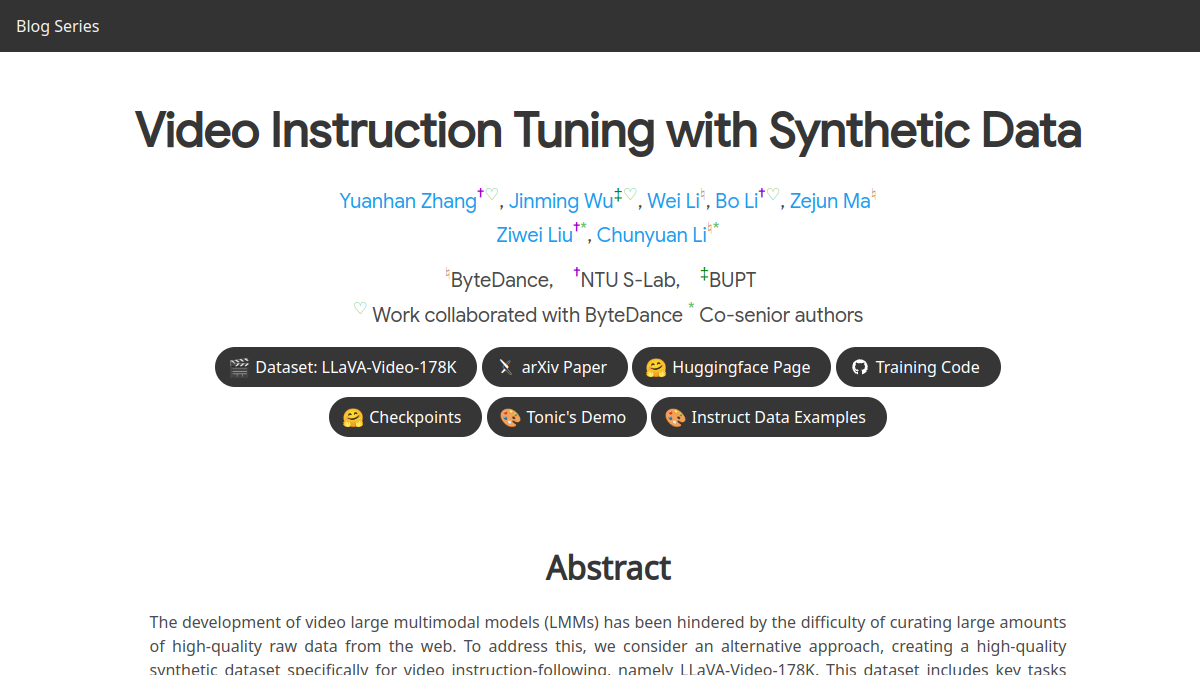
LLaVA-Video是专注于视频领域的大型多模态模型项目,核心定位为通过指令调优提升视频理解与推理能力。核心功能包括构建高质量视频指令调优数据集LLaVA-Video-178K,覆盖多类视频理解任务;支持开放式问答、多项选择问答、细粒度视频描述等多场景推理;提供模型基准测试结果与训练方案参考。目标用户覆盖AI研究人员、多模态模型开发者、视频内容分析从业者等,可用于学术研究实验、视频分析工具开发、多模态模型迭代优化等场景,为视频方向的多模态技术落地提供数据与模型参考。
多模态模型视频理解AI数据集