视频理解

hyggge.github.io
Valley 2.0是字节跳动开发的多模态大型模型官方体验站点,核心定位是为用户提供文本、图像、视频融合的多模态AI能力服务。站点支持多模态内容理解、跨模态内容生成、多轮多模态对话三类核心功能,面向AI技术研究者、内容创作者、电商运营人员、短视频从业者等群体,可应用于学术效果验证、内容素材制作、商品内容解析、视频内容摘要、智能问答交互等多种场景,帮助用户便捷体验开源多模态大模型的实际处理效果。
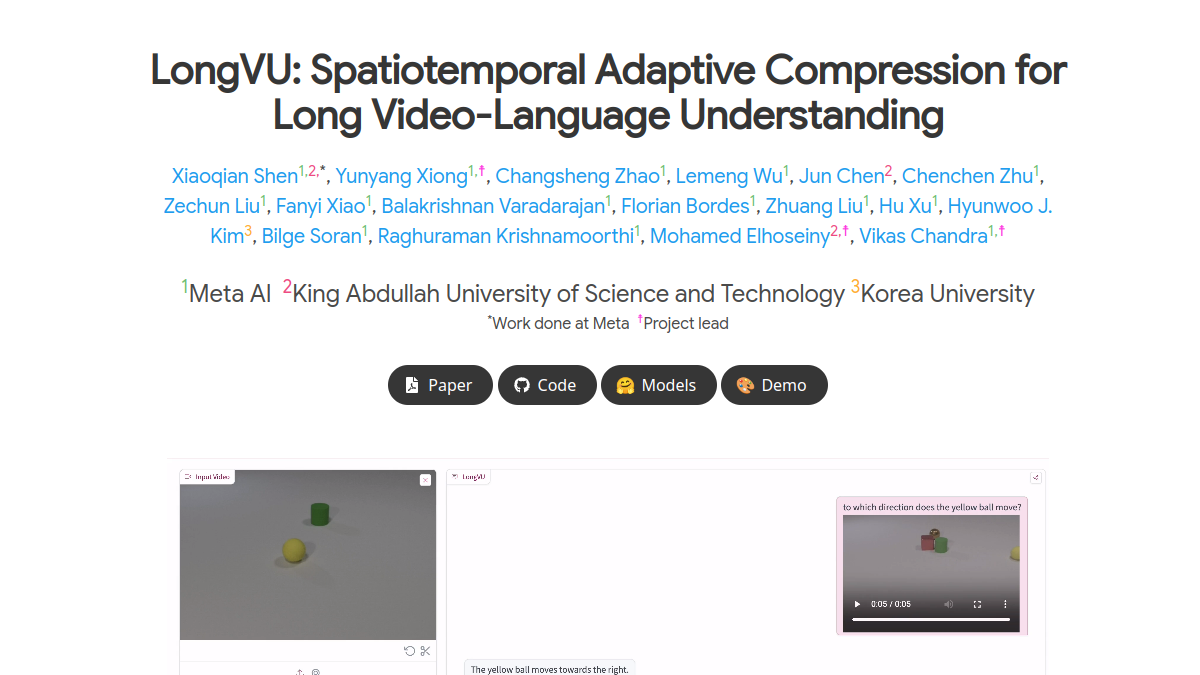

vision-cair.github.io
LongVU是专注于长视频语言理解的AI模型项目官网,核心为时空自适应压缩的视频理解技术,可在控制上下文长度的前提下降低长视频信息损耗。核心功能包含长视频内容多维度分析、跨时长视频语义问答、模型轻量化适配三个方向,面向AI研究人员、视频平台开发者、多媒体内容服务商等群体,可应用于长视频内容审核、智能视频检索、视频内容摘要生成、影视内容结构化分析等多个场景,帮助用户解决传统视频理解模型处理长时视频时信息丢失严重、计算资源消耗过高的问题。
apollo-lmms.github.io
Apollo-LMMs 是聚焦于视频理解方向的大型多模态模型研究项目官网,核心是公开Apollo系列多模态模型的相关研究成果与落地资源。该项目探索视频多模态模型的设计空间,总结性能优化关键要素,公开“Scaling Consistency”研究发现,可降低大模型研发的计算资源投入;同时提供ApolloBench基准测试套件,支持视频理解模型的能力评测。其目标用户包括人工智能领域的科研人员、多模态模型开发者、高校计算机相关专业师生、视频内容平台技术团队、智能监控研发企业、AI教育机构从业者等,可用于多模态模型研发参考、视频理解算法性能验证、大模型设计方案对比、相关课程教学案例展示等场景。

ai.meta.com
V-JEPA是Meta发布的视频联合嵌入预测架构相关的AI模型介绍官网页面,核心定位为公开前沿机器视觉相关技术成果展示与技术原理科普平台。核心功能包括V-JEPA模型技术架构解析、模型训练逻辑说明、实际应用场景案例展示。目标用户覆盖AI研究人员、计算机视觉开发者、AI相关专业学生、科技行业从业者、Meta技术爱好者。使用场景包括学术研究参考、模型原理学习、技术选型参考、行业趋势调研等多个方向,可帮助用户系统了解该非生成式视频理解模型的技术特性与发展潜力,为相关技术落地提供参考信息。
llava-vl.github.io
LLaVA-Video是专注于视频领域的大型多模态模型项目,核心定位为通过指令调优提升视频理解与推理能力。核心功能包括构建高质量视频指令调优数据集LLaVA-Video-178K,覆盖多类视频理解任务;支持开放式问答、多项选择问答、细粒度视频描述等多场景推理;提供模型基准测试结果与训练方案参考。目标用户覆盖AI研究人员、多模态模型开发者、视频内容分析从业者等,可用于学术研究实验、视频分析工具开发、多模态模型迭代优化等场景,为视频方向的多模态技术落地提供数据与模型参考。
heydavid.ai
David One是一款聚合多种AI能力的个人AI助手平台,核心定位为支持多模态交互的综合型AI服务工具,可处理视频内容理解、实时网络信息检索、文本创作、图像生成等多种任务。平台支持网页端直接访问使用,无需复杂安装配置,能够为用户提供一站式的AI问题解决服务。目标用户覆盖内容创作者、科研人员、学生、互联网从业者等不同群体,适用于日常信息查询、内容创作辅助、多媒体内容分析、创意生成等多种使用场景。
jinxxian.github.io
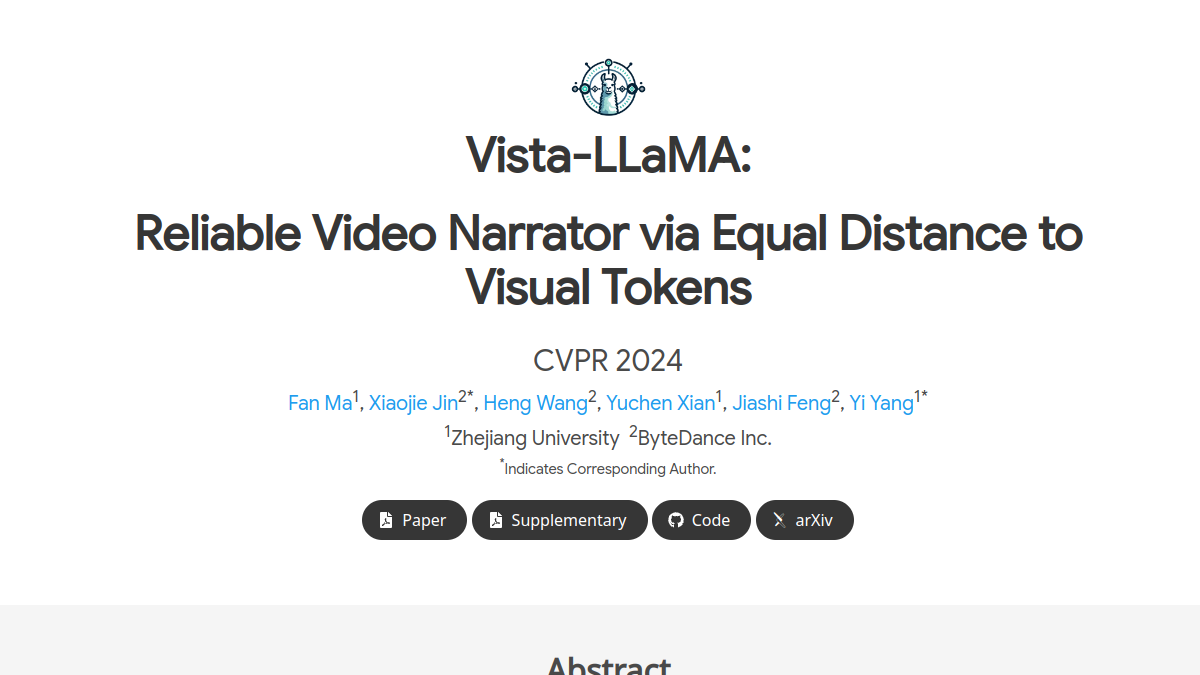
Vista-LLaMA是专注于视频语言理解领域的技术展示与模型介绍站点,核心展示专为视频文本生成任务优化的大语言模型方案。站点支持模型技术原理拆解、基准测试结果查询、相关论文资源下载三类核心功能,面向人工智能领域的研究人员、算法工程师、高校计算机相关专业师生,可用于视频理解技术调研、多模态模型研发参考、学术论文写作资料补充等场景,帮助用户系统了解该模型在视频问答、长视频内容总结等任务中的技术优势与应用思路。