基准测试
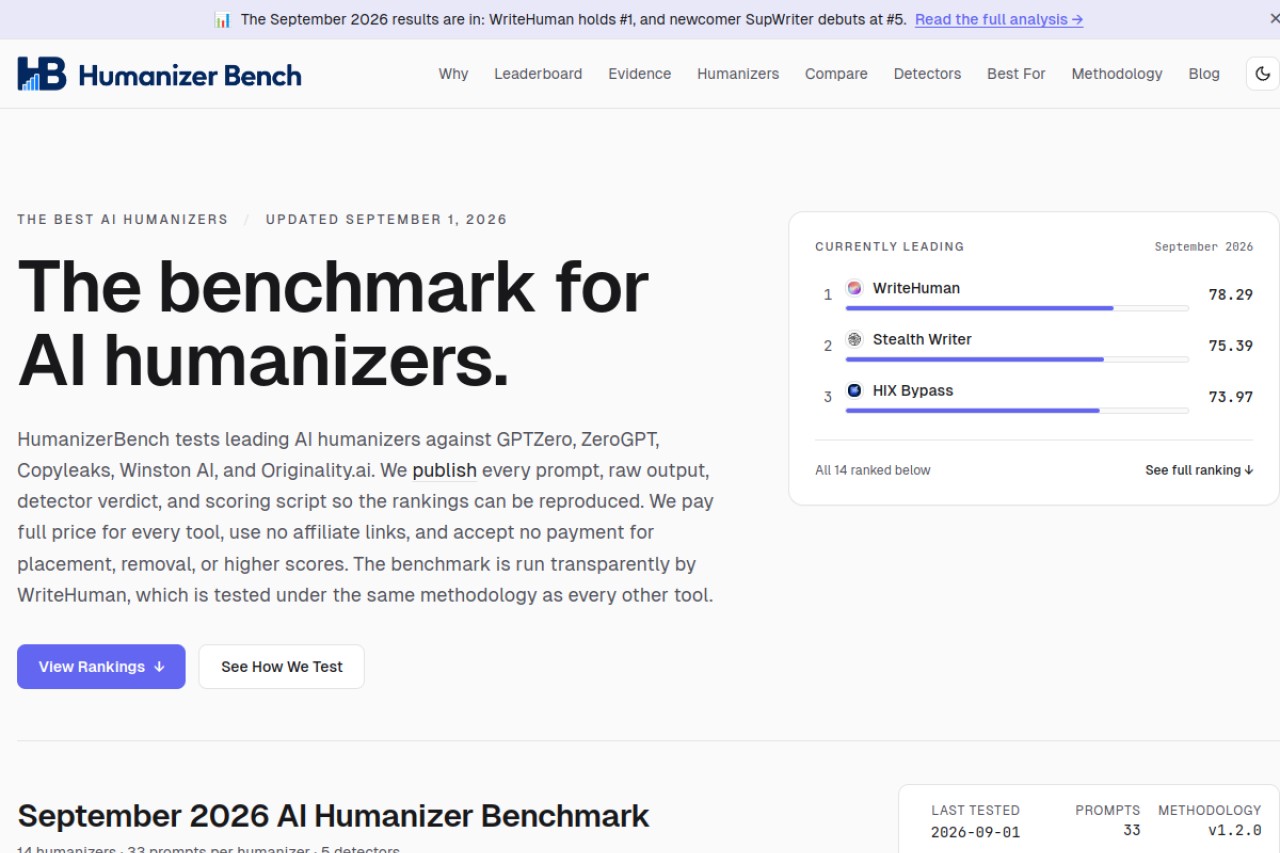
humanizerbench.com
HumanizerBench是一个面向AI内容创作者、内容运营人员的透明化AI人性化工具基准测试平台,可对各类主流AI内容人性化改写工具进行标准化效果测试,同时支持用户对常用的AI内容检测器进行交叉检测验证。平台通过统一测试标准,呈现不同工具在通过AI检测、保留原文语义、调整语句自然度等维度的实际表现,帮助用户筛选符合自身需求的AI人性化工具。可用于AI内容创作后的工具选型、不同AI检测器的灵敏度对比,以及内容发布前的效果预验证。
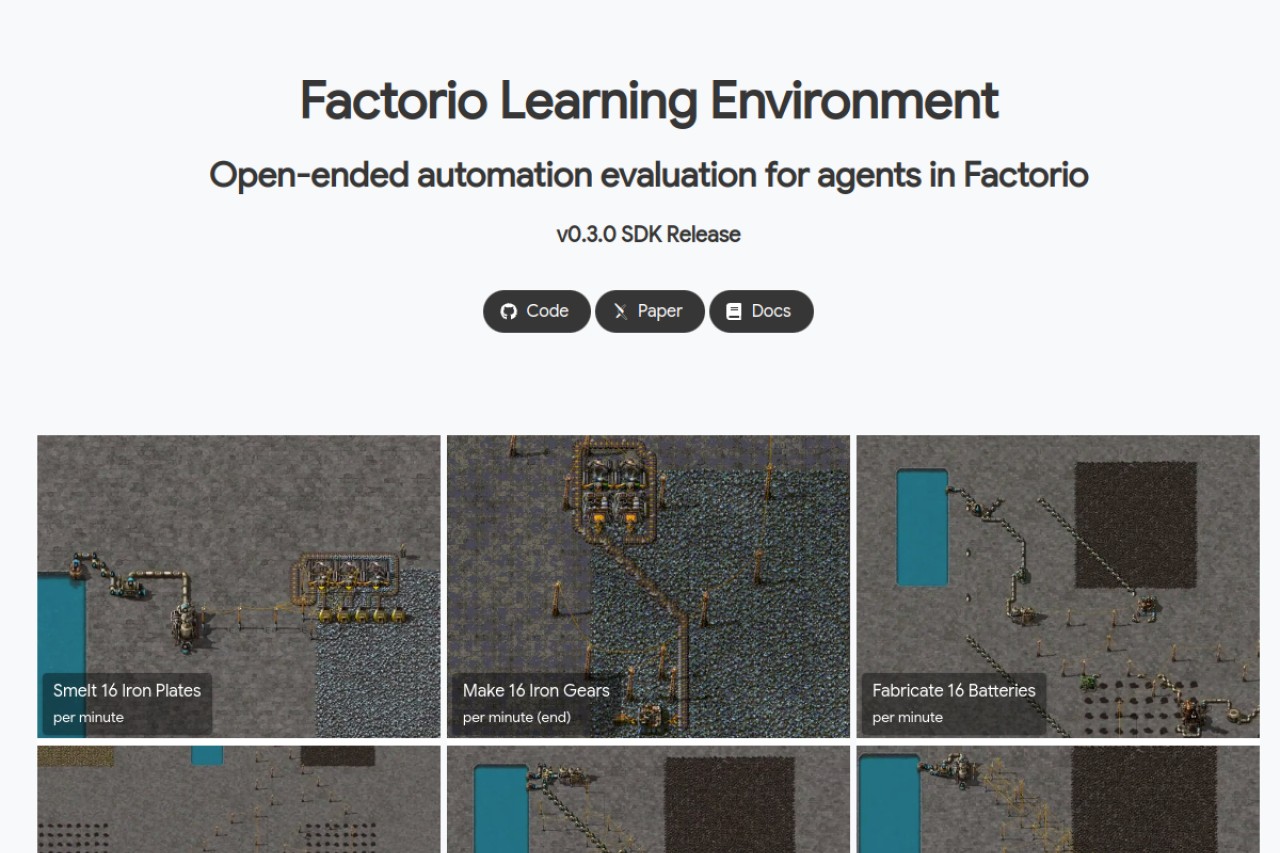

jackhopkins.github.io
Factorio学习环境(Factorio Learning Environment, FLE)是基于游戏《Factorio》构建的大语言模型能力评估框架,核心定位为AI研究领域的开放式智能体测试工具。核心功能包括支持结构化任务与开放式任务两类评估协议、可自定义难度梯度的任务配置、标准化的能力评估指标体系。目标用户覆盖AI研究人员、大语言模型开发团队、高校人工智能方向师生、智能体研发从业者、游戏AI爱好者、开源AI项目贡献者。使用场景包括LLM长期规划能力验证、程序合成效果测试、资源分配优化算法评估、智能体多步骤决策能力 benchmark 搭建、复杂开放式领域智能体训练数据集构建等,为大语言模型在复杂任务场景下的能力评估提供标准化测试载体。
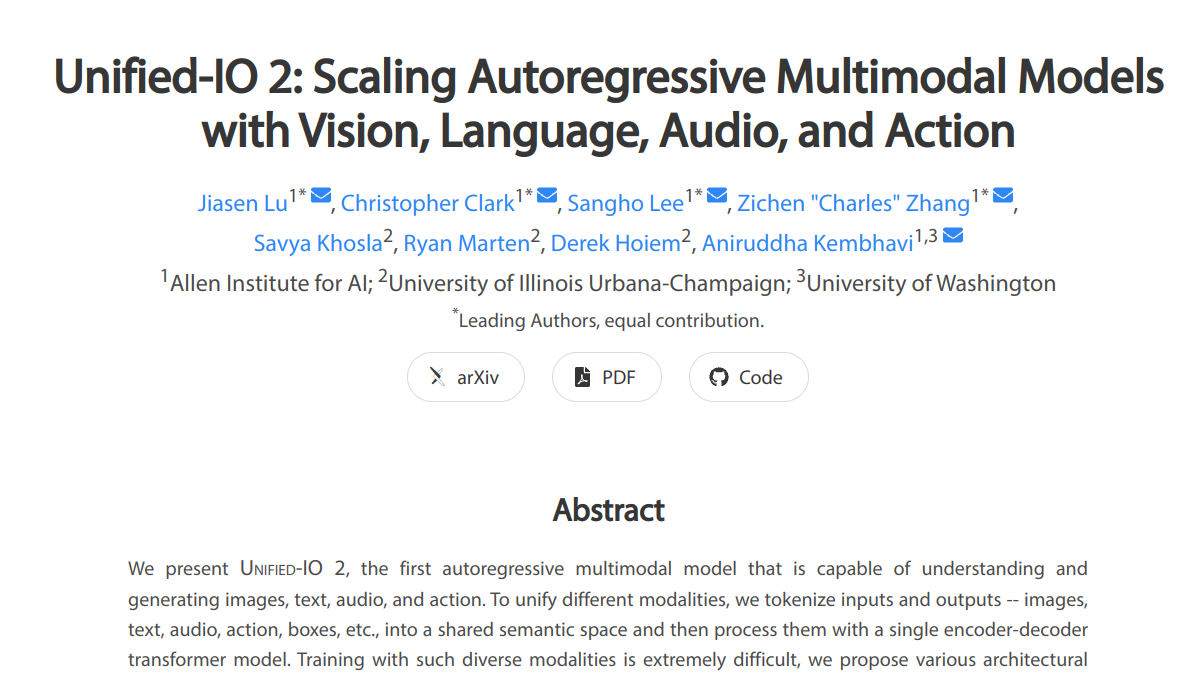
unified-io-2.allenai.org
Unified-IO 2是艾伦人工智能研究所推出的多模态生成模型演示平台,核心定位是为用户提供统一模态的AI能力体验入口。平台支持图像、文本、音频、动作四类模态的混合输入与输出,单个Transformer架构可实现跨模态语义的统一处理;内置经过120余个数据集微调的预训练模型,可直接适配多类多模态任务需求;平台同时提供基准测试结果查询功能,方便用户直观了解模型在各任务场景下的性能表现。目标用户覆盖AI研究人员、多模态应用开发者、高校相关专业师生、内容创作从业者等,可用于跨模态任务原型验证、模型性能对比分析、多模态应用效果测试、学术研究参考等场景。
apollo-lmms.github.io
Apollo-LMMs 是聚焦于视频理解方向的大型多模态模型研究项目官网,核心是公开Apollo系列多模态模型的相关研究成果与落地资源。该项目探索视频多模态模型的设计空间,总结性能优化关键要素,公开“Scaling Consistency”研究发现,可降低大模型研发的计算资源投入;同时提供ApolloBench基准测试套件,支持视频理解模型的能力评测。其目标用户包括人工智能领域的科研人员、多模态模型开发者、高校计算机相关专业师生、视频内容平台技术团队、智能监控研发企业、AI教育机构从业者等,可用于多模态模型研发参考、视频理解算法性能验证、大模型设计方案对比、相关课程教学案例展示等场景。