
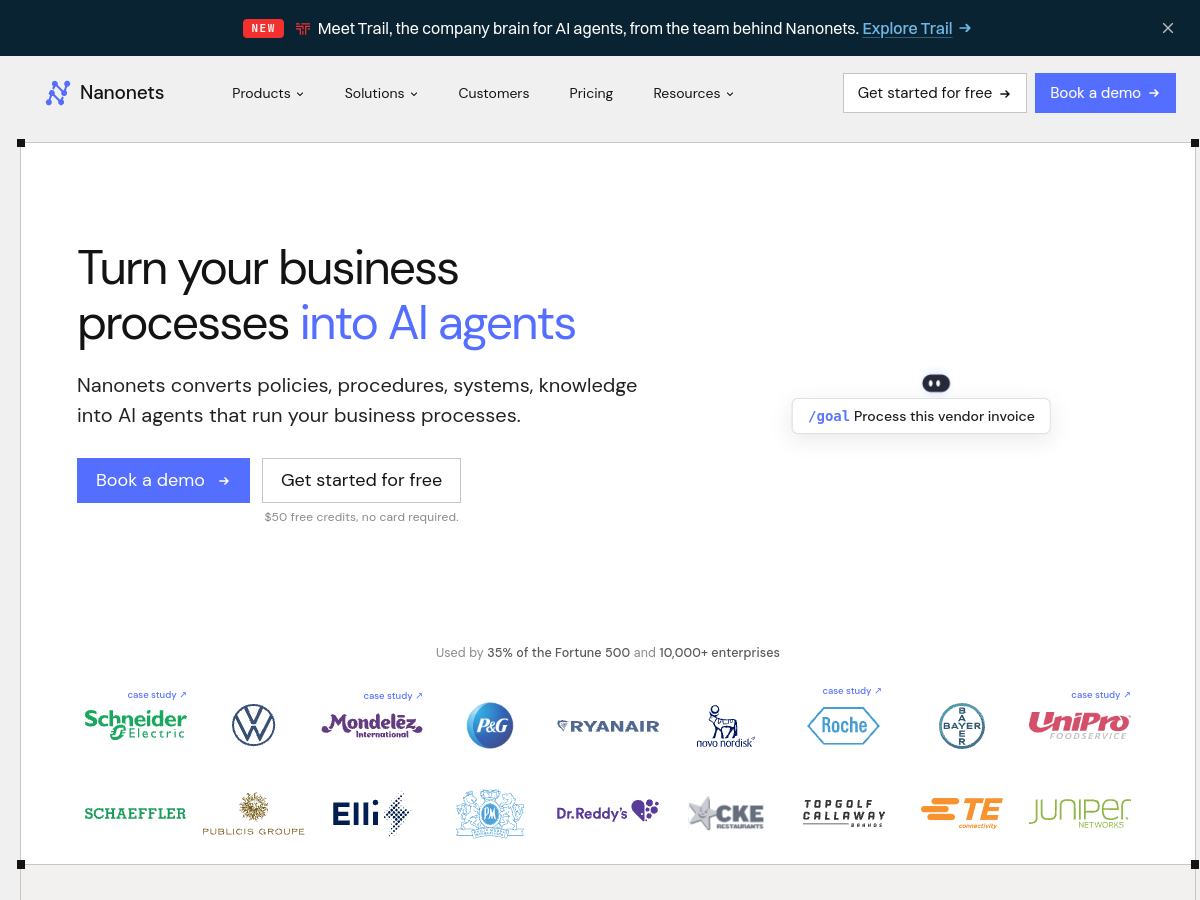
Nanonets
Nanonets是专注于文档处理自动化的AI平台,核心服务是将各类非结构化数据转化为结构化信息,帮助企业降低人工处理成本、提升数据流转效率。平台支持图片、PDF、扫描件等多格式文档的数据提取,可自定义提取字段并适配不同行业的文档模板,还提供API接口与企业现有系统对接。其目标用户覆盖金融、物流、医疗、零售等多个行业的运营、财务、数据处理岗位人员,可应用于发票报销审核、物流单据信息录入、医疗病历数据结构化、供应链订单信息整理等多种业务场景。
TextIn
TextIn是面向企业及个人用户的智能文档处理平台,主打OCR文字识别、文档格式转换、内容结构化提取等核心能力。平台支持对图片、扫描件、PDF等多类型载体的文字信息进行提取转换,可处理发票、合同、证件、表格等多种形态的文档内容,帮助用户完成文档信息的高效录入、整理与分析,适用于办公场景信息提取、批量文档数字化、财务票据核验、档案归档整理等多种使用场景。
GeoSpy.ai
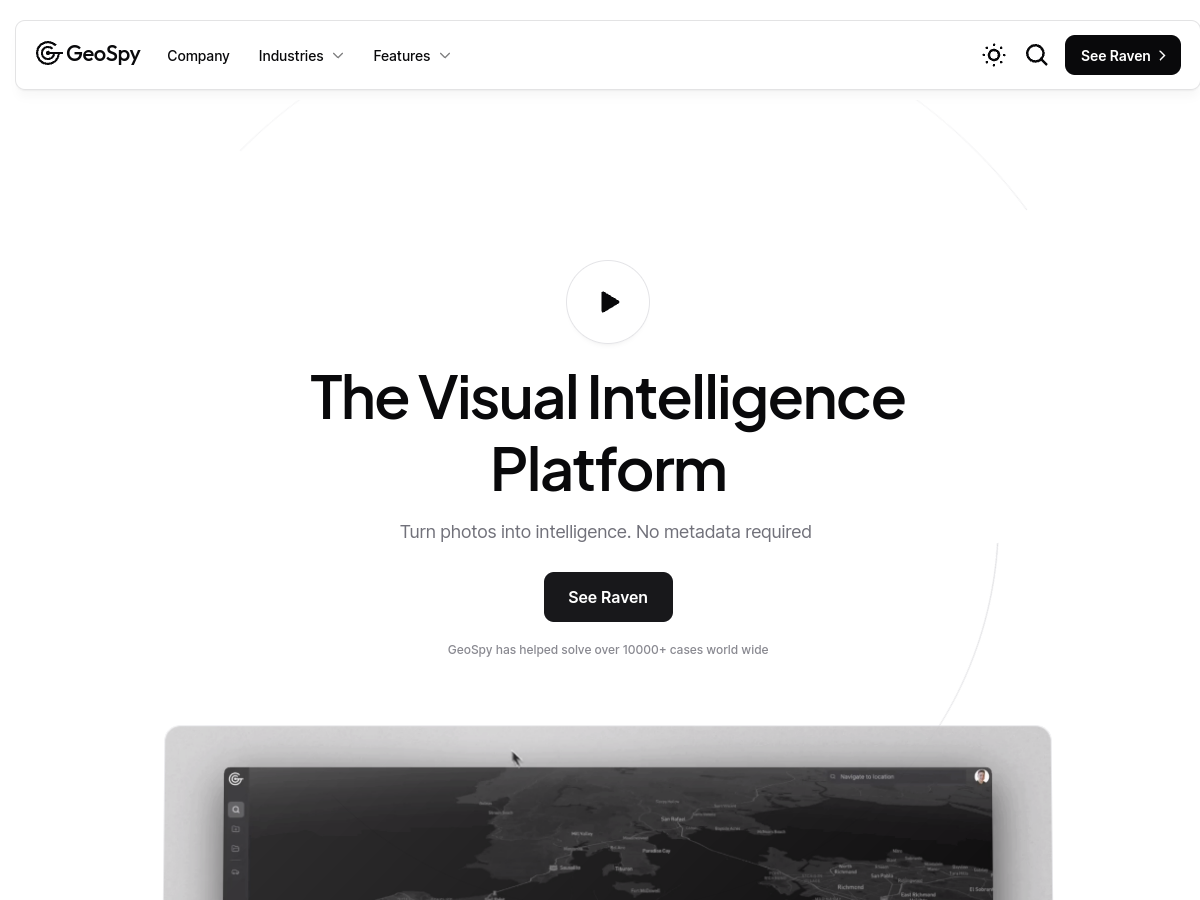
GeoSpy.ai是基于人工智能技术的图像地理位置识别工具,核心定位是通过分析图像中的视觉特征,推断照片拍摄地点并提供配套地理信息。核心功能包括图像视觉特征匹配定位、拍摄地周边信息查询、批量图像地理标签标注,支持单张/批量图片上传,识别结果包含经纬度、所属地区、置信度等维度信息,适用于媒体从业者、旅行记录整理用户、数字内容核查人员、地理数据研究人员等群体,可满足老照片溯源、旅行照片地点回忆、社交媒体内容真实性核查、地理数据集标注、摄影作品地理信息补全、失踪人员线索排查等多种场景需求。
Hyperscience
Hyperscience是面向企业的AI文档处理平台,核心定位是通过机器学习技术帮助企业将各类非结构化文档内容转化为可分析的结构化数据。平台核心功能包括多类型文档信息自动提取、数据校验与纠错、异构系统数据对接,服务于需要处理大量纸质或电子文档的企业用户,可应用于金融行业信贷资料审核、保险行业理赔单据录入、医疗行业病历信息归档等场景,帮助企业降低人工录入成本,减少人为操作失误,提升文档处理全流程的效率。
Visionati
Visionati是面向多行业的视觉内容智能分析工具平台,核心定位为将图像、视频等视觉内容转化为结构化数据与可落地洞察的工具包。平台支持多模型集成的视觉内容标签生成、多模态的长视频智能分段解析、敏感内容自动识别过滤三大核心功能,主要服务于内容运营、电商营销、媒体创作、数据研究等领域的从业者,可应用于营销素材合规审核、短视频内容标签批量标注、品牌视觉资产分类管理、UGC内容风险排查等多种场景。

Datalab.to
Datalab.to是专注于文档智能处理的开源AI工具平台,核心定位是为开发者、企业及相关从业者提供高性能的文档处理AI模型服务。平台核心功能包括高精度OCR识别、文档布局智能分析、PDF格式转Markdown导出,支持批量处理多类型文档文件。目标用户覆盖学术研究人员、企业办公人员、内容运营人员、前端开发人员、数据处理工程师等,可应用于学术文献批量整理、企业合同数字化归档、扫描文档内容提取、旧文档格式转换等多个场景,帮助用户降低文档处理的人力投入,提升内容流转效率。

Luxand.cloud
Luxand.cloud是专注于人脸识别技术的API服务平台,核心定位是为开发者和企业提供可集成的面部识别能力。平台支持人脸比对、人脸属性检测、人脸关键点识别等核心功能,可处理不同光照、角度、遮挡条件下的人脸图像。目标用户覆盖应用开发者、安防系统服务商、企业管理系统开发者等群体,适用于身份核验、用户身份标签生成、人脸属性分析、门禁系统开发等多种场景,帮助需求方降低自研人脸识别技术的成本,缩短功能上线周期。
Alphamoon
Alphamoon是一款基于人工智能技术的智能文档处理平台,核心定位是为不同行业用户提供文档数字化、信息结构化的全流程解决方案。平台支持AI OCR识别、多类型文档数据自动提取、文档智能分类等核心功能,可帮助用户减少人工处理文档的时间成本,降低信息录入出错概率。目标用户覆盖金融机构、债务回收企业、物流服务商、零售品牌、行政办公人员、财会从业者等群体,适用于发票报销审核、客户资料归档、合同信息提取、物流单据整理、财务报表录入等多种业务场景。
BringTable
BringTable是基于GPT-4技术打造的图像数据提取处理工具,核心定位是将图像中的非结构化数据转化为可编辑的结构化表格。核心功能包括图像智能扫描识别、表格格式自动转换、数据校验修正,目标用户覆盖财务人员、个体经营者、行政人员、研究人员等有数据录入需求的群体,可应用于纸质账单录入、票据信息整理、手写表格电子化、调研数据汇总等场景,减少手动录入的工作量,降低人工输入的错误概率。

DocumentPro
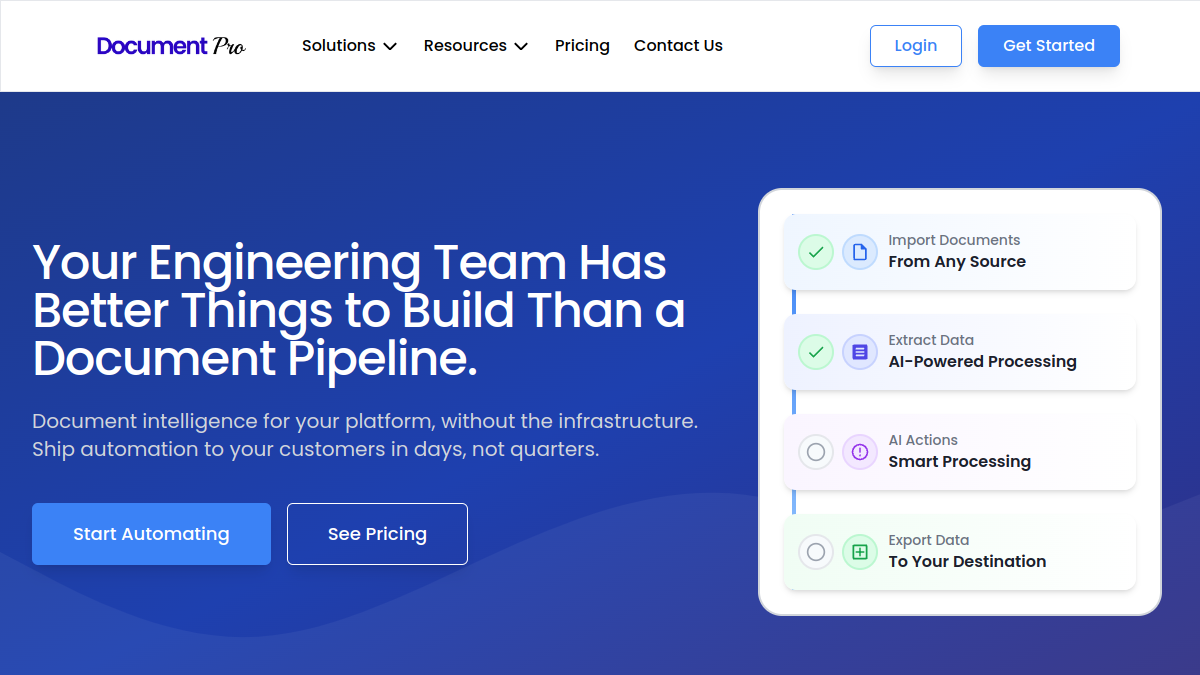
DocumentPro是一款基于AI技术的文档信息提取工具,核心定位是帮助用户从各类非结构化文档中自动抓取所需数据,替代传统手动录入流程。其核心功能包括多类型文档智能识别、表格与字段精准提取、多格式数据导出,支持发票、采购订单、身份证、提货单等十余种常用商业和个人证件类文档处理,无需提前配置模板即可直接使用。目标用户覆盖企业行政、财务人员、电商运营、物流从业者、中小企业管理者及个人用户,可应用于财务记账数据录入、物流单据信息整理、客户订单批量归档、个人证件信息数字化存储等场景,帮助用户降低手动输入的错误率,提升文档处理效率。
navan.ai
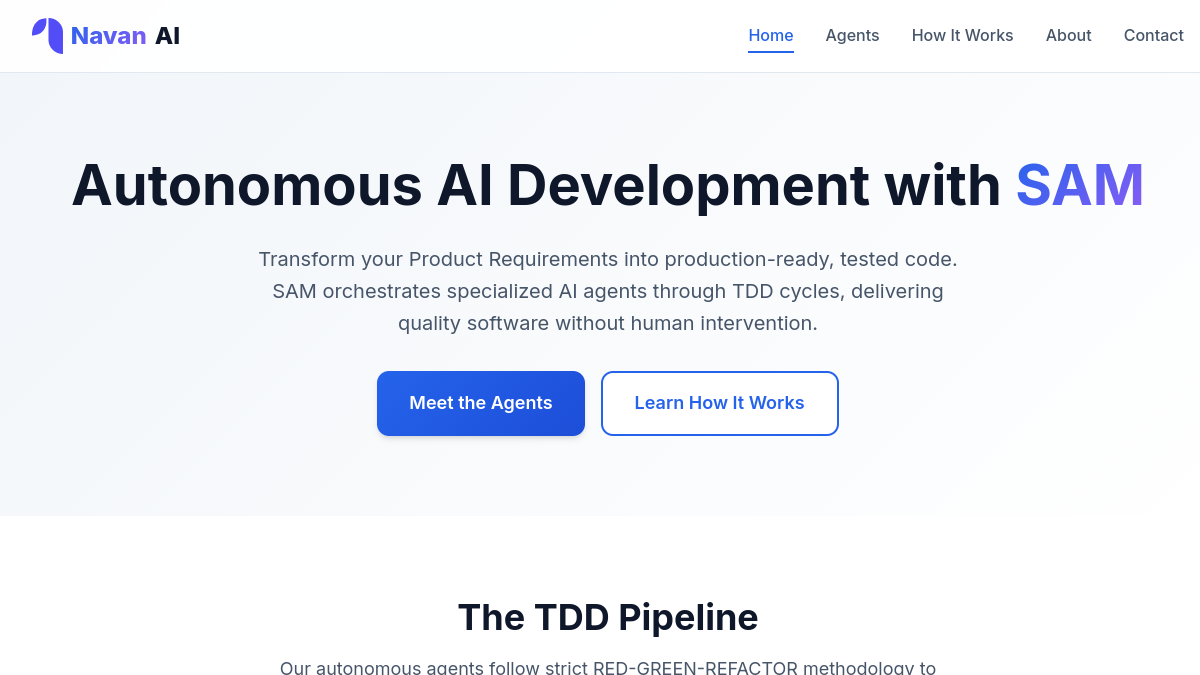
navan.ai是主打无代码操作的计算机视觉平台,核心定位为降低计算机视觉模型开发门槛,面向企业、开发者、学生等不同群体提供轻量化模型构建服务。平台支持用户上传图像数据即可完成模型训练,无需掌握复杂的深度学习代码编写技能;内置nStudio模块可实现模型性能的快速测试与效果验证;提供模型文件下载、API调用两种部署路径,满足不同场景的落地需求。平台重视用户数据隐私,支持本地数据训练无需上传至平台共享,后续还将开放模型商业化交易板块,帮助创作者实现技术成果变现。

OCR Solution
OCR Solution是Pix Dynamics推出的OCR文本识别API服务,核心定位是为各类开发场景提供可集成的文档与图像文本提取能力。核心功能包含多格式文档识别、结构化信息提取、多语言文本支持三类,可帮助开发者无需从零搭建OCR算法模型,快速为自身业务加入文本识别能力。目标用户覆盖企业技术开发人员、 SaaS 产品研发团队、政务数字化建设人员、中小商家运营人员等,可适用于发票批量录入、合同信息归档、证件信息核验、历史文档数字化等多种工作场景。
llama-ocr
llama-ocr是一款开源npm库,核心定位为基于Llama 3.2 Vision模型的光学字符识别工具,可帮助开发者快速集成文本识别能力到项目中。核心功能包括支持本地与远程图像的OCR识别、提供免费与付费两种接口调用方案、后续规划支持PDF格式文件的内容提取,项目设计受Zerox启发,整体结构轻量化易集成。目标用户覆盖前端开发人员、Node.js后端开发者、小型工具开发团队等,可应用于文档数字化、图像内容转写、批量文本提取、小票信息录入等多种开发场景,降低OCR功能的接入门槛。
GreenEyes.AI - Image Recog. Tech as API
GreenEyes.AI是一家提供计算机视觉相关API与SaaS产品的数字技术服务平台,核心定位是为各类开发者与企业用户提供可快速接入的图像识别技术解决方案。平台核心功能包括通用图像对象识别API、自定义数据集训练标注工具、多场景视觉任务部署套件,同时所有服务的算力调度均遵循低碳优化规则,降低运行过程中的碳排放量。目标用户覆盖应用开发者、AI算法研发团队、企业数字化部门、科研机构等群体,可应用于电商商品识别、安防场景目标检测、工业视觉质检、农业作物长势分析、内容平台违规内容筛查等多个实际业务场景,帮助用户在无需从零搭建计算机视觉模型的前提下,快速实现相关视觉能力的落地应用。

imgProof
imgProof是专注于图像文本内容校对的智能工具,核心定位是依托AI视觉识别与自然语言处理技术,帮助用户排查各类包含文本的图像内容中的拼写、语法等文字错误。核心功能包括多语种图像文本识别校对、多格式图像兼容处理、批量文件校对、错误位置精准标注、校对报告导出。目标用户覆盖市场营销人员、设计从业者、出版编辑、教育工作者、跨境运营人员、行政办公人员等,可用于宣传物料定稿前核验、印刷品打样校验、扫描文档内容核查、海外多语种宣传图文字检查、学生作业图片文字纠错等场景,减少图像内容中的文字疏漏带来的不必要损失。

KBY
KBY是一家专注于身份验证领域的SDK提供商,核心为各行业开发者与企业提供成熟的身份核验技术集成方案。平台支持人脸识别、活体检测、身份证识别三类核心核验能力,兼容多端开发场景,可帮助接入方快速搭建身份核验流程,降低自研技术的成本与周期。目标用户覆盖金融、政务、出行、互联网服务等多个领域的开发团队与企业运营方,适用于用户注册实名认证、交易风险核验、线下场景身份确认等多个需要核实用户真实身份的场景。

MistralOCR.net
MistralOCR.net是专注于文档智能识别的在线OCR服务平台,核心定位是为用户提供高精度的多类型文档内容提取服务。平台支持从扫描版PDF、照片、截图等多种载体中提取文本、表格、公式、图片等结构化内容,同时支持多语言识别与格式保留导出功能。目标用户覆盖学生、科研人员、办公职员、编辑出版人员、数据整理人员等群体,可适用于文献整理、办公文档数字化、手写笔记转写、数据录入、旧资料存档等多种场景,帮助用户降低手动录入成本,提升文档处理效率。
Lenso.ai
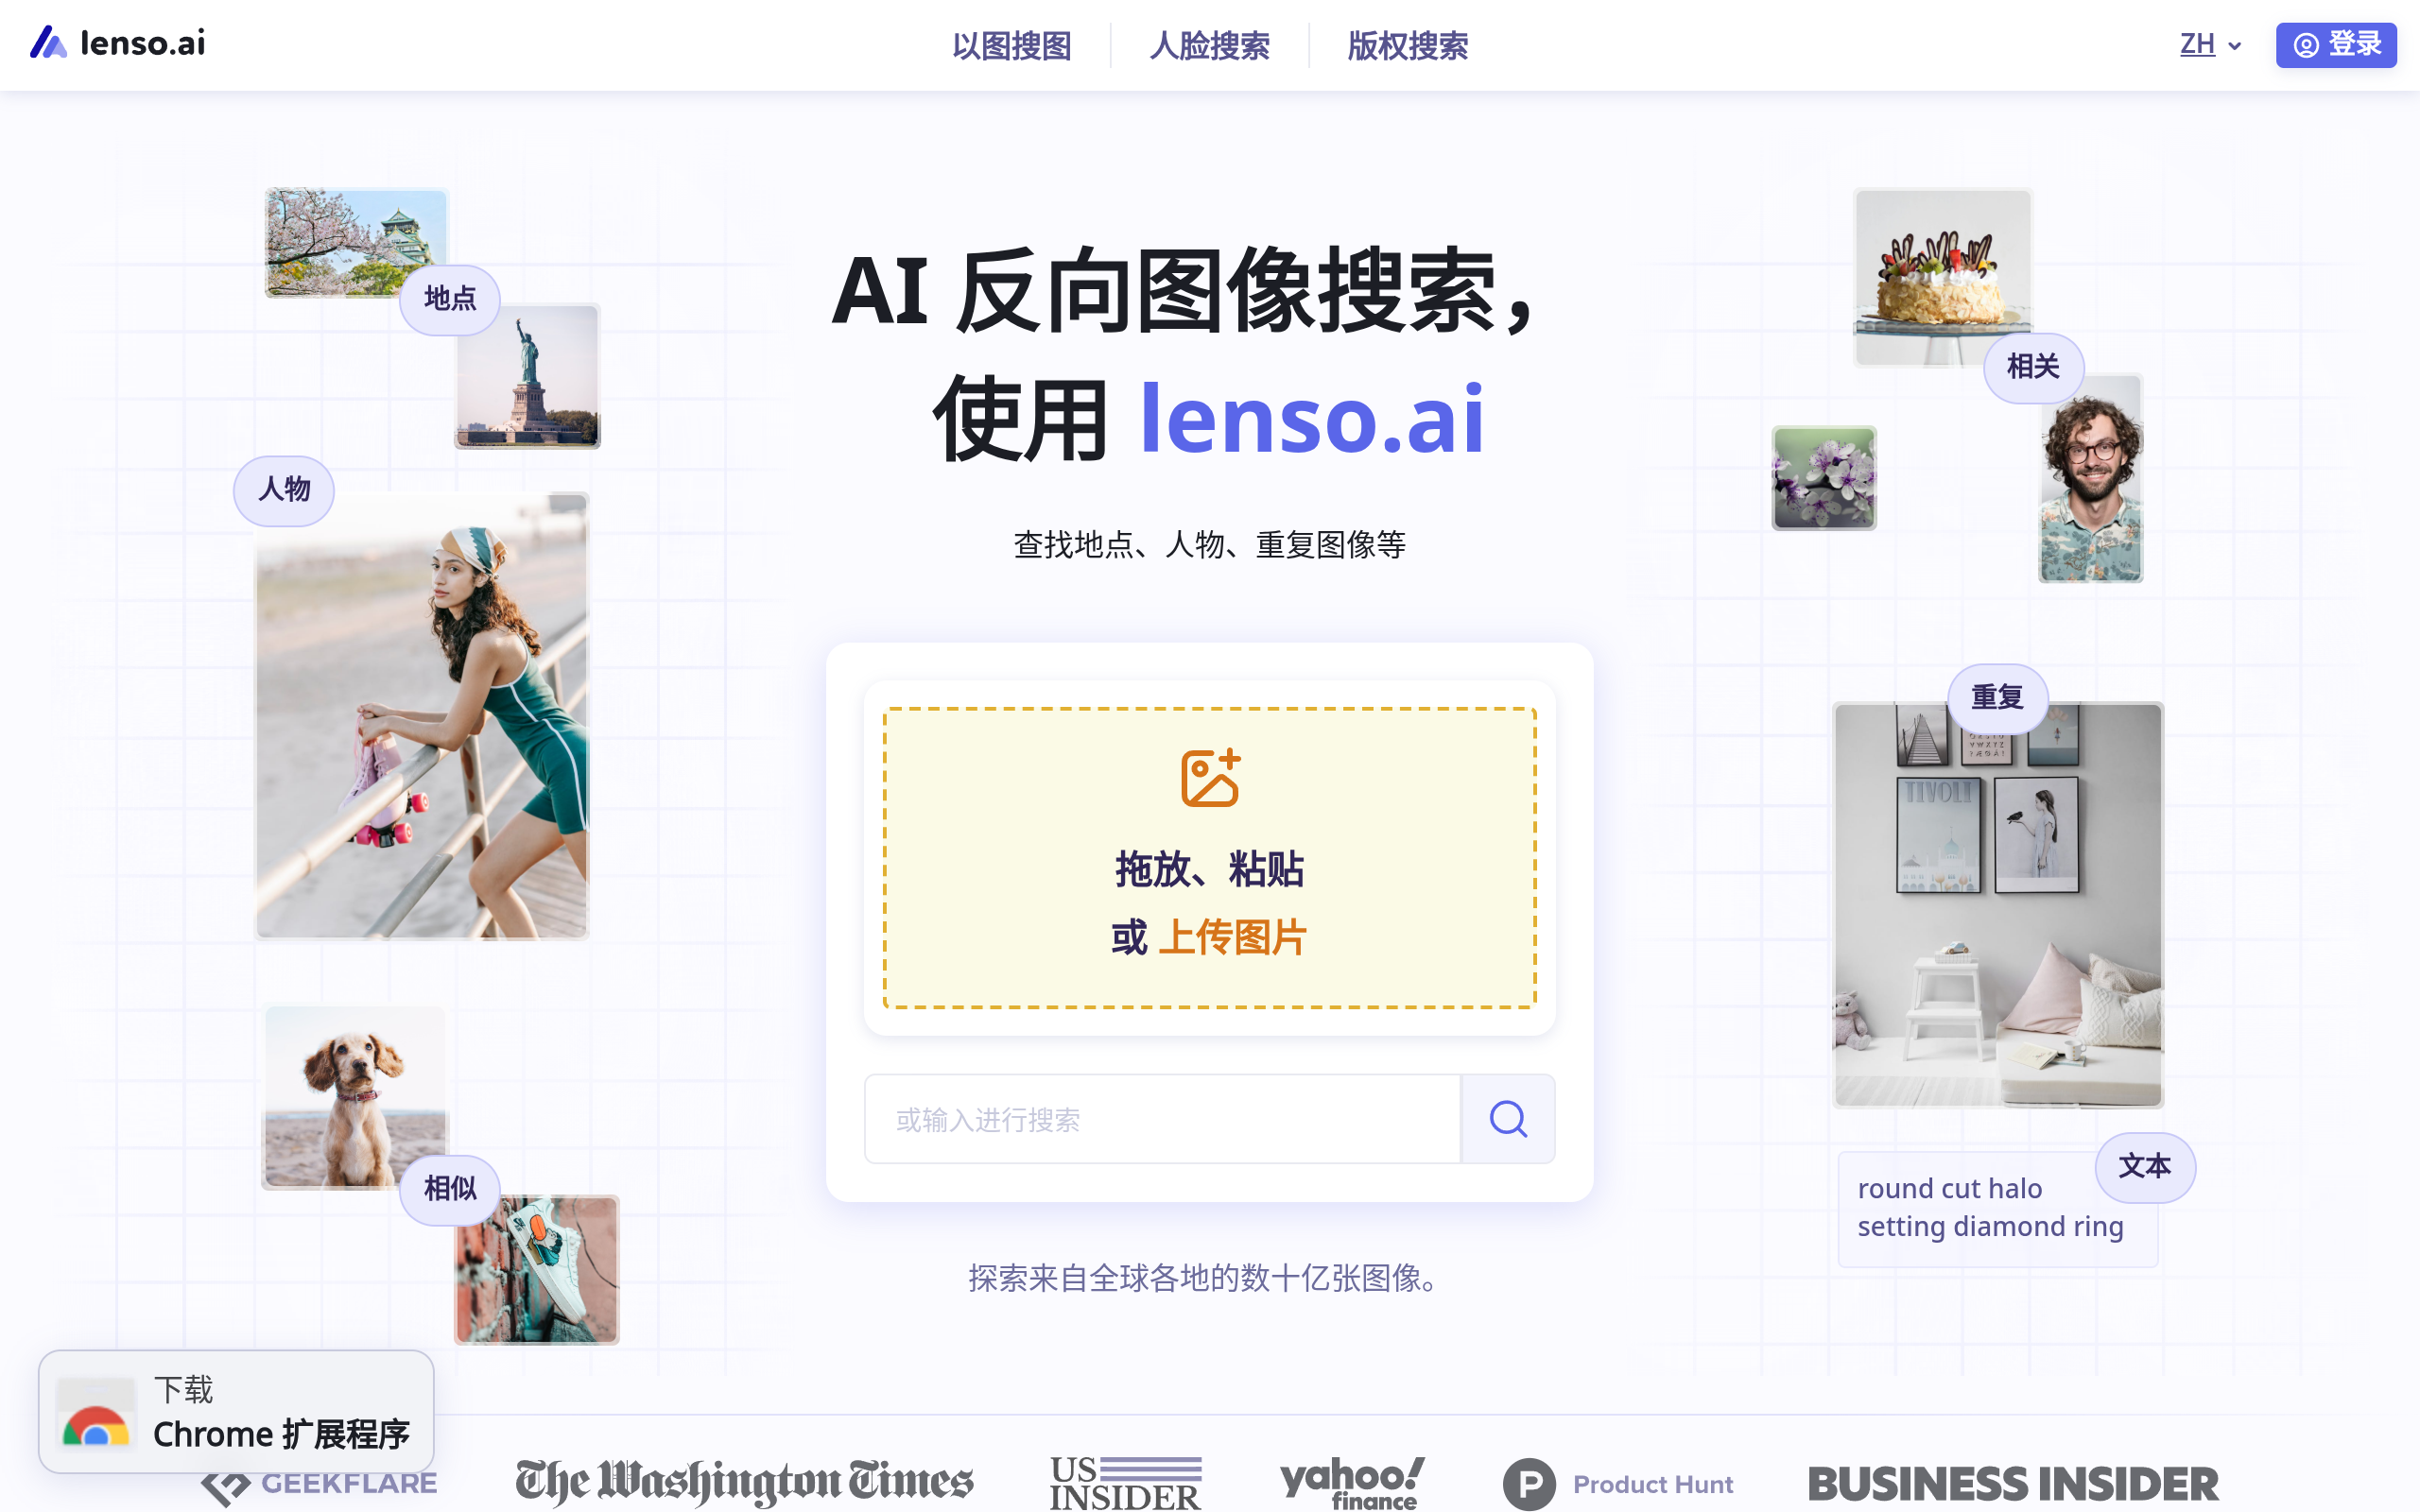
Lenso.ai是基于人工智能技术的反向图片搜索工具,依托AI算法分析图片内容,可满足多场景的图像检索需求。其核心功能包括人脸搜索、地点识别、重复图片检测、相似图片查找,以及个人隐私追踪等,目标用户覆盖摄影师、市场营销人员、内容创作者、电商从业者、普通互联网用户等群体。可应用于版权保护、素材灵感收集、地点识别、个人隐私监控、竞品商品调研等多个场景,帮助用户便捷完成图像相关的检索与管理工作。
关于图像识别与分析
图像识别与分析类工具是一类依托计算机视觉技术对图像、视频内容进行结构化解析、特征提取与信息输出的AI工具,主要解决人工图像审核效率低、海量视觉信息无法快速检索、特定视觉特征难以精准量化识别等问题,典型使用场景覆盖安防监控排查、工业质检瑕疵检测、电商商品图自动打标、医疗影像辅助初筛、遥感图像地物分类等多个领域。
这类工具按能力覆盖范围可分为通用型与垂直行业型两类,通用型工具支持人脸、物体、文字等多类常见视觉元素的基础识别,多数提供基础免费调用额度,超出后按调用量阶梯计费;垂直行业型工具针对特定场景做了数据集专项训练,比如工业瑕疵识别、医疗病理影像分析类工具,识别精度适配行业专属标准,大多采用企业级定制部署或按项目授权的收费模式,个人用户通常无法直接获取完整功能权限。
选型时可优先匹配自身场景属性,若仅需完成日常通用图像标注、文字提取等基础需求,选择支持免费调用额度的通用型工具即可满足要求;若面向工业、医疗等专业场景,优先选择经过行业专项数据集训练、提供本地化部署选项的垂直类工具,保障数据安全与识别精度;大规模商用前建议先申请工具的测试权限,针对自身业务的样本集做实测验证,确认识别准确率符合预期后再正式采购。
图像识别与分析常见问题
图像识别工具怎么选
先明确自身使用场景,基础通用需求选带免费额度的通用型工具,专业行业场景选经过专项训练、支持本地化部署的垂直类工具,大规模使用前先做实测验证。
图像识别工具免费还是收费
通用型工具大多提供基础免费调用额度,超出后按调用量阶梯计费;垂直行业型工具多采用企业定制部署或项目授权模式,个人用户一般无法免费获取完整功能。
图像识别工具适合谁用
适合安防运维人员、工业质检从业者、电商运营人员、医疗影像辅助分析人员、遥感测绘从业者,以及需要批量处理图像信息的普通办公用户。