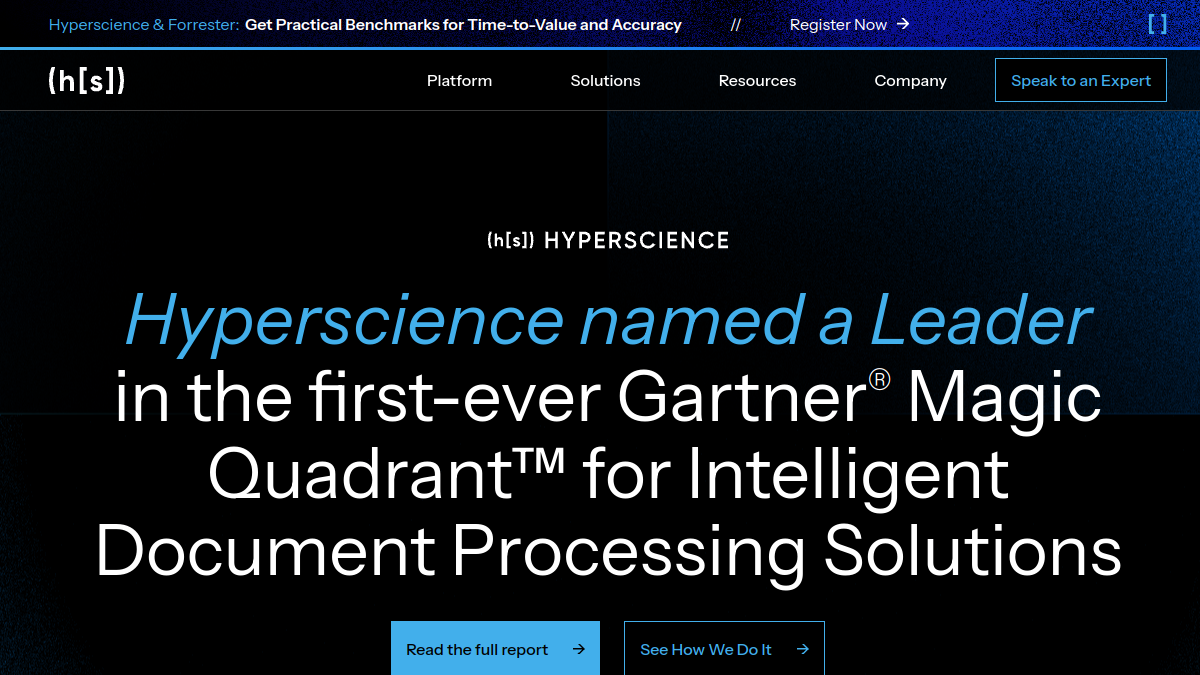
Hyperscience是面向企业的AI文档处理平台,核心定位是通过机器学习技术帮助企业将各类非结构化文档内容转化为可分析的结构化数据。平台核心功能包括多类型文档信息自动提取、数据校验与纠错、异构系统数据对接,服务于需要处理大量纸质或电子文档的企业用户,可应用于金融行业信贷资料审核、保险行业理赔单据录入、医疗行业病历信息归档等场景,帮助企业降低人工录入成本,减少人为操作失误,提升文档处理全流程的效率。
- 运营状态
- 正常运营
- 地址
- hyperscience.com
- 定价模式
- 免费试用
- 支持平台
- Web 网页 / API 接口
- 是否开源
- 闭源
- 适合人群
- 金融机构信贷部门、保险公司理赔部门、医疗机构行政部门、政务服务窗口单位
- 收录时间
- 2026/6/14
- 访问量
- 0 次
编辑点评
这是一款专注于企业级文档智能化处理的AI平台,核心优势是围绕非结构化文档的转化需求搭建了完整的处理链路,区别于普通的OCR工具,它不仅完成文档内容的识别,还提供了从字段自定义提取、规则校验、流程配置到系统对接的全流程能力,尤其适合需要处理大量不同类型文档的中大型企业。平台内置的多行业模板可以降低企业初期的配置成本,可追溯的处理流程也能满足强监管行业的合规要求,对于目前仍依赖人工录入大量文档信息的企业来说,是实现文档处理流程降本提效的可选方案。企业可以根据自身的文档处理量级和业务复杂度,选择对应的部署方式,也可对接平台团队获取定制化的行业解决方案。
核心功能
使用指南
- 1
访问Hyperscience官网,点击企业咨询入口,提交企业所属行业、日常文档处理量级、核心需求等基础信息,与平台商务团队对接获取部署方案,完成账号开通与环境配置。
- 2
登录平台管理后台,根据自身业务需求,在模板中心选用对应行业的预设模板,或者自定义创建文档处理模板,设置需要提取的字段、数据校验规则等内容。
- 3
在流程配置界面,通过可视化拖拽工具搭建文档处理流程,设置人工复核的触发条件、不同文档的流转路径、数据输出的目标位置等规则,完成后保存发布流程。
- 4
通过批量上传、API对接等方式将需要处理的文档导入平台,系统自动启动识别、提取、校验流程,存在异常的数据会自动流转到人工处理队列,相关人员可在待办中查看处理。
- 5
处理完成的结构化数据可直接导出为CSV、Excel等格式,也可通过预先配置的接口同步到企业内部业务系统,同时可在日志中心查看所有文档的处理记录,满足审计需求。
优势与不足
优点4 项
"支持200余种文档格式识别,无需针对单一文档提前配置模板,适配多场景文档处理需求"
"提供可视化流程配置界面,无需编写代码即可调整文档处理规则,降低企业使用门槛"
"全流程操作日志完整记录,满足金融、医疗等行业的合规审计要求"
"支持与市面多数主流企业管理系统API对接,打通数据链路避免二次录入"
不足3 项
"面向个人用户和小型团队的使用成本较高,更适合中大型企业客户部署"
"手写体识别准确率受字迹清晰程度影响较大,潦草手写内容仍需较多人工复核"
"部分小众行业的文档模板缺失,企业需要自行配置,初期部署周期较长"
定价说明
Hyperscience采用企业定制化定价模式,没有统一的公开售价,具体价格根据企业的文档处理量级、需要的功能模块、部署方式(云端部署/本地私有化部署)、对接系统数量等因素综合确定。平台为意向客户提供有限额的免费试用服务,试用期间可体验基础的文档识别、信息提取功能,便于企业评估适配性。建议有需求的企业直接联系官方商务团队,提供自身业务场景和处理量级等信息后获取具体报价,中小规模文档处理需求可选择云端订阅方案,有数据安全要求的强监管行业可选择私有化部署方案。
价格和授权政策可能变化,请以官网最新信息为准
适合人群与场景
- 金融机构信贷部门
信贷申请资料自动化录入审核
- 保险公司理赔部门
理赔单据信息提取与校验
- 医疗机构行政部门
病历、检验报告信息结构化归档
- 政务服务窗口单位
办事群众提交材料的自动录入分类
- 企业财务部门
发票、报销单据的自动识别与记账
- 法律事务所
合同、卷宗关键信息提取与检索
- 供应链运营企业
物流单据、采购合同信息自动录入
常见问题
深度了解
在企业日常运营过程中,大量非结构化文档的处理一直是耗费人力的环节,人工录入不仅效率低,还容易出现数据错误,Hyperscience作为专注于企业级文档智能化处理的平台,为这类问题提供了对应的解决方案。平台依托先进的机器学习和自然语言处理技术,支持200余种文档格式的识别,包括扫描件、PDF、手写文档、电子表单等,可自动提取文档中的关键信息,转化为结构化的可操作数据。
Hyperscience提供可视化的流程配置工具,企业无需编写代码即可根据自身业务需求搭建文档处理流程,设置数据校验规则和人工介入阈值,处理完成的数据可直接对接企业现有ERP、CRM、OA等系统,无需二次录入。平台完整记录文档处理全流程日志,满足金融、医疗等强监管行业的合规审计需求,还内置多个行业的预设文档模板,可缩短企业初期部署周期。
对于有数据安全要求的企业,Hyperscience还提供私有化部署方案,所有文档数据的处理和存储都在企业内部完成,保障数据安全。目前该平台已经在金融、保险、医疗、政务、法律等多个行业落地应用,帮助企业优化文档处理流程,提升运营效率,有相关需求的企业可访问官网咨询详情,获取定制化的解决方案。
Ready to try
准备好体验 Hyperscience 了吗?
点击下方按钮在新标签页打开官网,开始探索它的全部功能。
相关工具
Doc2X
免费Doc2X是专注于多格式文档智能解析与转换的在线AI工具,核心定位为低门槛文档结构化处理平台。核心功能包括支持扫描件、PDF、图片类文档的文字与版式识别,可将非结构化文档转换为可编辑的Word、Markdown、Excel等格式,同时支持公式、表格、复杂排版的精准还原。目标用户覆盖学生、科研人员、办公职员、内容编辑等需要处理各类文档的群体,可应用于文献整理、办公文档编辑、扫描件信息提取、课件内容二次编辑等多种场景,无需复杂配置即可在线完成文档处理操作。

Datalab.to
免费Datalab.to是专注于文档智能处理的开源AI工具平台,核心定位是为开发者、企业及相关从业者提供高性能的文档处理AI模型服务。平台核心功能包括高精度OCR识别、文档布局智能分析、PDF格式转Markdown导出,支持批量处理多类型文档文件。目标用户覆盖学术研究人员、企业办公人员、内容运营人员、前端开发人员、数据处理工程师等,可应用于学术文献批量整理、企业合同数字化归档、扫描文档内容提取、旧文档格式转换等多个场景,帮助用户降低文档处理的人力投入,提升内容流转效率。

UBIAI
免费UBIAI是专注于文本领域的数据标注平台,支持多类型文本数据的标注、模型训练与部署全流程管理。平台内置OCR文本提取能力,可从扫描件、图片类文档中识别文本内容;搭载自动化标注功能,可通过学习用户标注习惯降低重复工作量;支持多语言标注,覆盖希伯来语、日语、阿拉伯语、印地语等数十种语言。平台面向NLP算法工程师、数据标注团队、行业数据分析人员,适用于医疗记录分析、金融文档处理、多语种内容审核、智能客服语料标注等多个场景,帮助用户标准化文本数据处理流程,提升标注效率。
jpgtotext.com
jpgtotext.com是一款专注于图像文本提取的在线OCR工具,核心定位为无需下载安装即可直接在浏览器中完成各类图像到可编辑文本的转换。该工具支持多种常见图像格式的文本识别,可自动识别多国语言内容,还提供基础的文本编辑功能,识别结果支持多种格式导出。工具适合需要从图片中提取文字的办公人员、学生、内容创作者等用户,可应用于扫描文档数字化、图片文字摘抄、手写笔记整理、名片信息录入等多种场景。
Image to text
Image to text是专注于图片文本提取的在线工具,核心定位为用户提供无需下载安装的轻量OCR识别服务。它支持多格式图片上传识别,可自动识别多国语言文本内容,还能对识别结果进行在线编辑校对。目标用户覆盖办公人群、学生群体、内容创作者、档案整理人员等,适用于纸质文档电子化、截图信息提取、印刷资料转录、外文内容识别等多种场景,能够帮助用户降低手动录入文本的时间成本,提升信息整理效率。
TextIn
免费TextIn是面向企业及个人用户的智能文档处理平台,主打OCR文字识别、文档格式转换、内容结构化提取等核心能力。平台支持对图片、扫描件、PDF等多类型载体的文字信息进行提取转换,可处理发票、合同、证件、表格等多种形态的文档内容,帮助用户完成文档信息的高效录入、整理与分析,适用于办公场景信息提取、批量文档数字化、财务票据核验、档案归档整理等多种使用场景。

imagetotext.cc
imagetotext.cc是一款专注于在线OCR文本提取的服务网站,核心定位是为用户提供无需下载安装的网页端图像转文字处理服务。网站支持从各类常规图像格式中提取可编辑文本,同时支持转换为多种可导出格式,满足不同用户的文本提取需求。网站支持批量上传处理,支持多语言识别,无需注册即可使用基础功能。目标用户包括内容创作者、办公行政人员、在校学生、数据整理人员、文案编辑、科研工作者等,适用于扫描文档文字提取、图片截图文字转写、手写笔记数字化、书籍内容整理、会议截图文字归档等多种使用场景。
llama-ocr
免费llama-ocr是一款开源npm库,核心定位为基于Llama 3.2 Vision模型的光学字符识别工具,可帮助开发者快速集成文本识别能力到项目中。核心功能包括支持本地与远程图像的OCR识别、提供免费与付费两种接口调用方案、后续规划支持PDF格式文件的内容提取,项目设计受Zerox启发,整体结构轻量化易集成。目标用户覆盖前端开发人员、Node.js后端开发者、小型工具开发团队等,可应用于文档数字化、图像内容转写、批量文本提取、小票信息录入等多种开发场景,降低OCR功能的接入门槛。
你是 Hyperscience 的开发者或团队吗?
认领后可编辑工具信息、获取真实点击数据,并在页面上展示官方认证徽章。
访问第三方工具时,请注意账号、隐私与支付安全
用户评论
0· 0 条