RAG工具

zilliz.com
Zilliz Cloud Serverless是面向生成式AI应用打造的向量数据库服务,核心定位是为向量数据存储与检索场景提供免运维的弹性算力支持。核心功能包括:第一,自动弹性扩缩容,可根据实际请求量与数据量动态调整算力与存储资源,无需用户手动配置集群参数;第二,分层存储优化,通过DRAM、SSD与对象存储的组合架构自动调度数据存储位置,平衡访问速度与存储成本;第三,多维度向量检索支持,兼容多种主流向量索引类型,适配不同精度与延迟的查询需求。目标用户覆盖AI算法工程师、大模型应用开发者、企业AI业务负责人等群体,可应用于检索增强生成(RAG)系统搭建、多模态内容检索、推荐系统向量召回、异常检测等多个AI落地场景。

milvus.io
Milvus是面向AI开发者的开源向量数据库,核心定位是为大规模高维向量提供相似性搜索与存储解决方案。核心功能包括十亿级向量分布式扩展能力、多语言SDK适配、兼容主流AI生态工具、毫秒级低延迟向量检索、多模态向量统一管理。目标用户覆盖AI算法工程师、后端开发人员、计算机视觉研究者、大语言模型应用开发者等。使用场景涵盖图像检索系统搭建、大模型RAG知识库构建、推荐系统召回模块开发、音频指纹匹配、生物特征识别等AI应用开发环节,可降低向量数据管理的技术门槛,提升AI应用的检索效率与稳定性。
ncurator.com
馆长是一款基于轻量级RAG和AI技术的知识库管理工具,同时支持浏览器插件与网页端使用,核心定位是帮助用户搭建个人专属知识库,实现知识的高效存储、检索与复用。核心功能包括本地知识库构建、语义混合搜索、跨源知识整合、离线访问支持,目标用户覆盖学生、研究人员、职场人士、内容创作者等需要处理大量文档信息的群体,可应用于课程笔记整理、文献资料检索、工作文档归档、写作素材聚合等多种场景,无需复杂配置即可快速上手,同时保障用户数据存储安全。
activeloop.ai
Activeloop Deep Lake是专注于人工智能领域的多模态数据存储与管理平台,核心定位是为AI开发全流程提供数据层基础设施支持。平台支持文本、图像、音频、视频、点云等多类型异构数据的统一存储,内置向量检索与版本管理能力,可对接主流AI训练框架完成数据流式加载。其目标用户覆盖AI算法开发者、企业数据团队、大模型应用研发人员等,可应用于大模型预训练数据集管理、多模态检索系统搭建、计算机视觉模型训练数据迭代、AI应用落地全链路数据治理等场景,帮助用户减少数据预处理环节的重复工作,提升AI项目推进效率。

you.com
You.com是面向企业级场景的AI平台,核心定位为将大模型能力与企业需求无缝衔接。平台聚合多种主流大语言模型至同一界面,提供实时网络检索、可溯源引用、低代码工作流与私有化部署选项,帮助组织在保障数据安全与合规的前提下,快速构建高准确、可扩展、易管控的生成式AI应用。目标用户覆盖高校教研人员、保险风控人员、出版编辑、网络安全从业者、企业管理者、市场运营人员等,可应用于文献调研、风险控制、内容生产、内部效率提升、战略决策、代码开发等多元场景。
denser.ai
DenserBot是一款基于RAG技术的自定义聊天机器人搭建工具,核心定位是帮助用户基于自有数据快速生成专属问答机器人。其核心功能包括多源数据接入、RAG增强生成、无代码快速部署、多渠道适配以及问答数据统计。目标用户覆盖企业客服人员、内容创作者、教育工作者、开发者、运营人员等群体,可用于搭建网站智能客服、知识库问答助手、课程答疑机器人、内部文档查询工具等场景,无需编程基础即可完成从数据导入到机器人上线的全流程操作。
exa.ai
Exa AI是专为人工智能模型打造的搜索引擎平台,核心定位是为各类AI应用提供高质量、结构化的网络数据检索与处理服务。平台支持语义级搜索功能,可返回与查询意图高度匹配的网页内容;提供原生的结构化数据输出能力,无需额外解析即可直接对接AI模型训练、推理场景;同时内置内容过滤机制,可筛选符合使用规范的公开网络数据。目标用户覆盖AI开发者、大模型训练团队、科研机构研究人员、AI应用开发者等群体,可应用于大模型预训练数据采集、RAG应用知识库构建、AI研究数据样本获取、行业情报AI分析等多个场景,帮助用户降低AI数据获取环节的复杂度。
langsearch.com
LangSearch是面向大语言模型应用开发的网络搜索与结果重排API服务平台,核心定位是为LLM提供精准、实时的网络上下文信息支撑。平台提供实时网络内容抓取、搜索结果结构化重排、多源数据聚合、LLM适配性内容预处理、自定义搜索范围配置等核心功能,可帮助开发者解决LLM训练数据截止、幻觉生成等问题。目标用户为大语言模型应用开发者、AI应用创业团队、企业AI研发部门、AI研究人员、智能客服开发团队、内容生成工具研发团队,适用于开发对话式AI助手、AI生成内容增强、知识库动态更新、事实性内容校验、垂直领域AI应用搭建等开发场景。


svectordb.com
SvectorDB是面向无服务器架构设计的向量数据库产品,核心定位是为AI应用开发提供轻量化的向量存储与检索服务。其支持多维度向量的实时写入与相似度查询,可根据访问负载自动弹性扩缩容,同时提供低延迟的向量检索能力。目标用户覆盖AI应用开发者、大模型应用搭建团队、推荐系统开发人员、多模态内容平台技术团队等,可应用于RAG检索增强生成系统搭建、个性化推荐召回模块开发、多模态内容相似性匹配、向量数据持久化存储等多种场景,帮助用户降低向量数据库的运维投入与使用成本。

wdoc.readthedocs.io
wdoc是由医学生开发者Olicorne打造的检索增强生成(RAG)类工具,核心定位是帮助用户处理多源异构信息的查询与总结需求。该系统支持PDF文档、静态网页、YouTube视频等多种类型的资源解析,可结合不同大语言模型输出精准的查询结果,同时提供自定义扩展接口适配个性化使用需求。目标用户覆盖学生、研究人员、职场专业人士等多个群体,可用于课程资料整理、学术文献梳理、项目信息汇总、公开内容提取等多种场景,帮助用户降低大量信息处理的时间成本。
ragcheck.site
RAGCheck是一款专注于RAG(检索增强生成)适配性检测的在线工具,核心定位是帮助用户评估PDF文档是否符合RAG系统的导入要求。其核心功能包括PDF文档RAG就绪度评分、多格式结构化内容导出、AI友好型内容块自动拆分,目标用户覆盖AI应用开发者、大模型运维人员、知识库搭建从业者等群体,可应用于RAG系统知识库搭建前的文档预检、PDF内容结构化转换、向量数据库内容预处理等多种场景,帮助减少RAG系统内容导入后的检索准确率不足等问题。
damngoodsearch.com
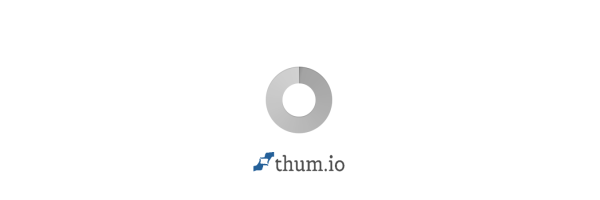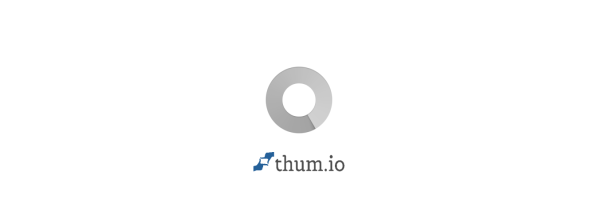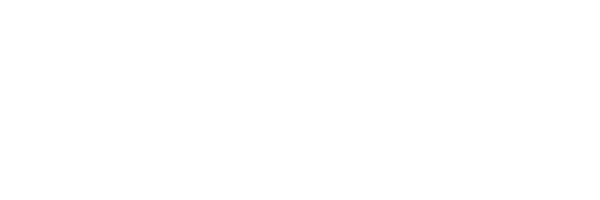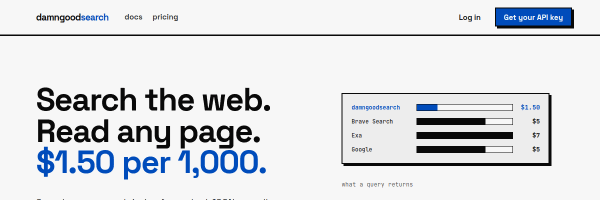
Damn Good Search 是面向AI开发场景的网页检索API服务平台,核心定位是为AI智能体、RAG系统开发者提供稳定的网页数据获取与处理能力。平台拥有自主搭建的网页索引库,支持直接返回排序后的结构化JSON检索结果,同时可将任意网页内容转换为纯净的Markdown格式,定价低于Brave、Exa、Google等同类检索API服务。适合AI应用开发者、大模型应用搭建团队、数据分析师等群体,在搭建RAG知识库、AI智能体网页搜索模块、批量网页内容采集等场景下使用。

getlinq.com
Linq API for RAG是面向检索增强生成场景的企业级搜索引擎服务,核心为各类组织提供AI驱动的知识库构建与精准检索能力。其核心功能包括多源数据统一结构化处理、LLM增强向量检索、可视化知识库管理,支持企业将分散的文档、数据表、音视频转写文本等异构数据整合为可搜索的智能知识库,可服务于企业内部知识库搭建、AI客服问答系统支撑、企业内容检索效率提升等场景,面向企业技术开发人员、企业运营管理者、AI产品研发团队等用户群体提供服务。
getindexify.ai
Indexify是一款开源多模态数据处理框架,核心定位是为大语言模型(LLM)应用提供非结构化数据的提取、索引与查询能力。其核心功能包括多模态非结构化数据自动提取、多方式混合查询能力,以及适配原型到生产的灵活部署模式。目标用户覆盖AI应用开发者、数据工程师、企业AI团队等群体,可用于检索增强生成(RAG)系统搭建、企业内部知识库构建、多模态内容检索平台开发等场景,帮助用户简化非结构化数据处理流程,降低LLM应用对接非结构化数据的开发成本。
qdrant.tech
Qdrant是一款开源云原生向量搜索数据库与搜索引擎,采用Rust语言开发,主打高效可扩展的向量相似度搜索服务,支持便捷的API接入能力。核心功能包括高性能向量相似性检索、动态水平扩展架构、多场景业务适配支持,主要面向AI应用开发者、算法工程师、企业技术团队,可应用于语义搜索搭建、推荐系统开发、相似内容匹配、异常行为检测等各类需要处理高维向量数据的AI业务场景,为大模型应用、智能检索系统等提供向量数据存储与检索的底层支撑。


tilores.io
Tilores Identity RAG是面向大语言模型场景的客户数据检索与统一服务平台,核心定位是解决大语言模型调用结构化客户数据时的匹配误差、数据分散、记录不统一等问题。平台核心功能包括实时模糊客户数据搜索、多源客户数据自动统一、动态客户档案构建,目标用户覆盖企业AI开发团队、客户服务部门、市场营销团队、数据运营人员等,可应用于AI客服客户信息查询、智能营销用户精准画像调取、大语言模型应用客户数据集成、客户数据治理等多个场景,帮助企业降低大语言模型调用客户数据的出错率,提升客户相关业务的响应准确性。
retriever.denser.ai
DenserRetriever是面向RAG场景开发的开源AI检索模型工具站,核心定位是为开发者和企业提供高性能的检索增强生成配套检索解决方案。核心功能包括异构检索器融合适配、预训练模型快速下载、Docker一键部署支持、MTEB基准测试结果查询、自定义模型微调工具包。目标用户覆盖AI算法工程师、RAG系统开发人员、企业AI技术团队、开源AI贡献者,可用于企业内部知识库问答系统搭建、垂直领域大模型检索模块开发、AI检索技术科研测试、轻量级RAG应用快速落地等场景,帮助用户提升检索环节的匹配精度,降低RAG系统的开发部署门槛。