LLM工具

ragobble.com
Ragobble是一个专注于音视频内容转结构化RAG文档的AI处理平台,核心定位是为大语言模型应用开发者提供可直接用于检索增强生成的结构化知识素材。平台支持本地音频文件上传转写、在线音视频链接解析提取、自动生成支持向量化的标准RAG文档三类核心功能,面向大语言模型开发者、AI知识库搭建人员、企业内部知识库运营者等群体,可应用于实时音视频内容接入大模型知识库、行业会议内容快速转化为模型训练素材、线上课程内容结构化存储用于AI问答系统搭建等场景,帮助用户将非结构化的音视频信息快速转化为大语言模型可直接调用的知识资源。
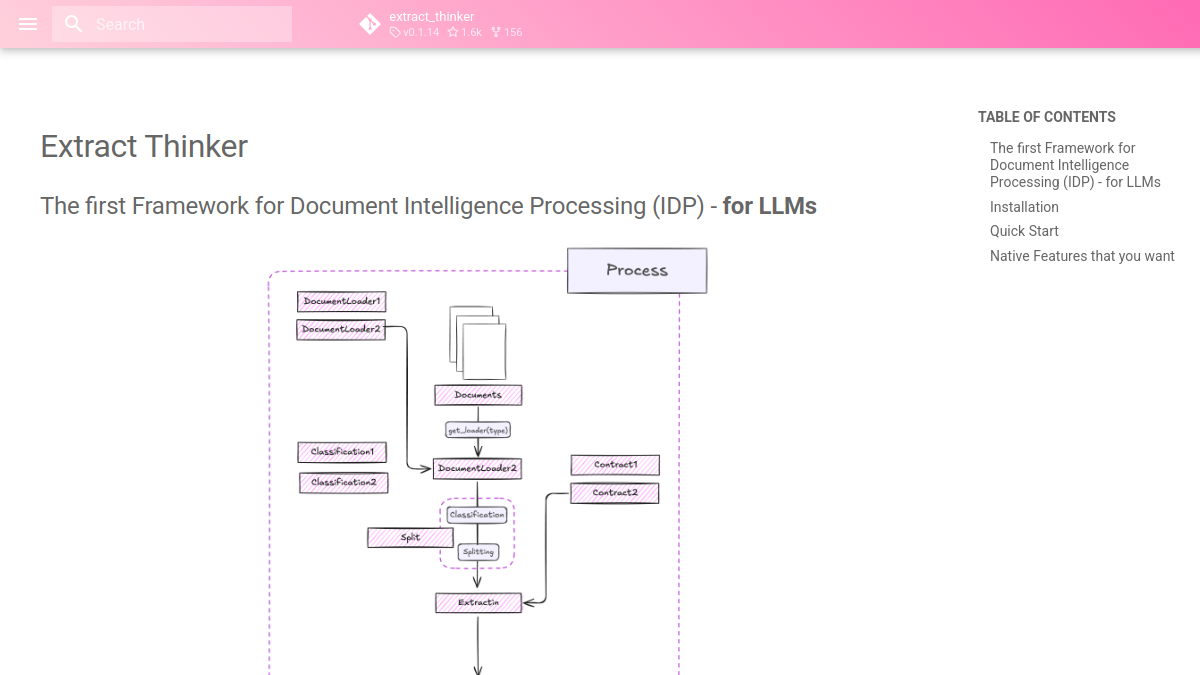
enoch3712.github.io
ExtractThinker是面向文档智能处理需求推出的灵活开发框架,核心定位是为大语言模型在文档处理场景提供标准化的工作流封装,被业内称为“智能文档处理的LangChain”。核心功能包括多格式文档结构化提取、自定义分类规则配置、大体积文档智能分段三大模块,适配科研、办公、政务等多个领域的文档处理需求。目标用户覆盖后端开发人员、AI应用开发者、企业文档系统搭建者,可用于批量合同信息提取、学术文献内容汇总、政务材料自动归档、企业知识库内容结构化等多种场景,降低开发者从零搭建文档处理链路的技术成本。

orquesta.cloud
Orquesta AI Prompts是专注于大语言模型提示词全生命周期管理的云服务平台,核心定位是为AI应用开发相关团队提供标准化的提示词管理解决方案。平台支持提示词集中存储与版本追溯,可开展多模型提示词效果对比实验,还能接入生产环境实现动态提示词调用与效果反馈收集,主要面向AI工程师、产品经理、大模型应用开发者等用户,适用于AI应用迭代、多提示词效果验证、企业级提示词资产沉淀等场景,助力团队降低提示词管理成本,提升大语言模型应用的落地效率。
queryfanout.io
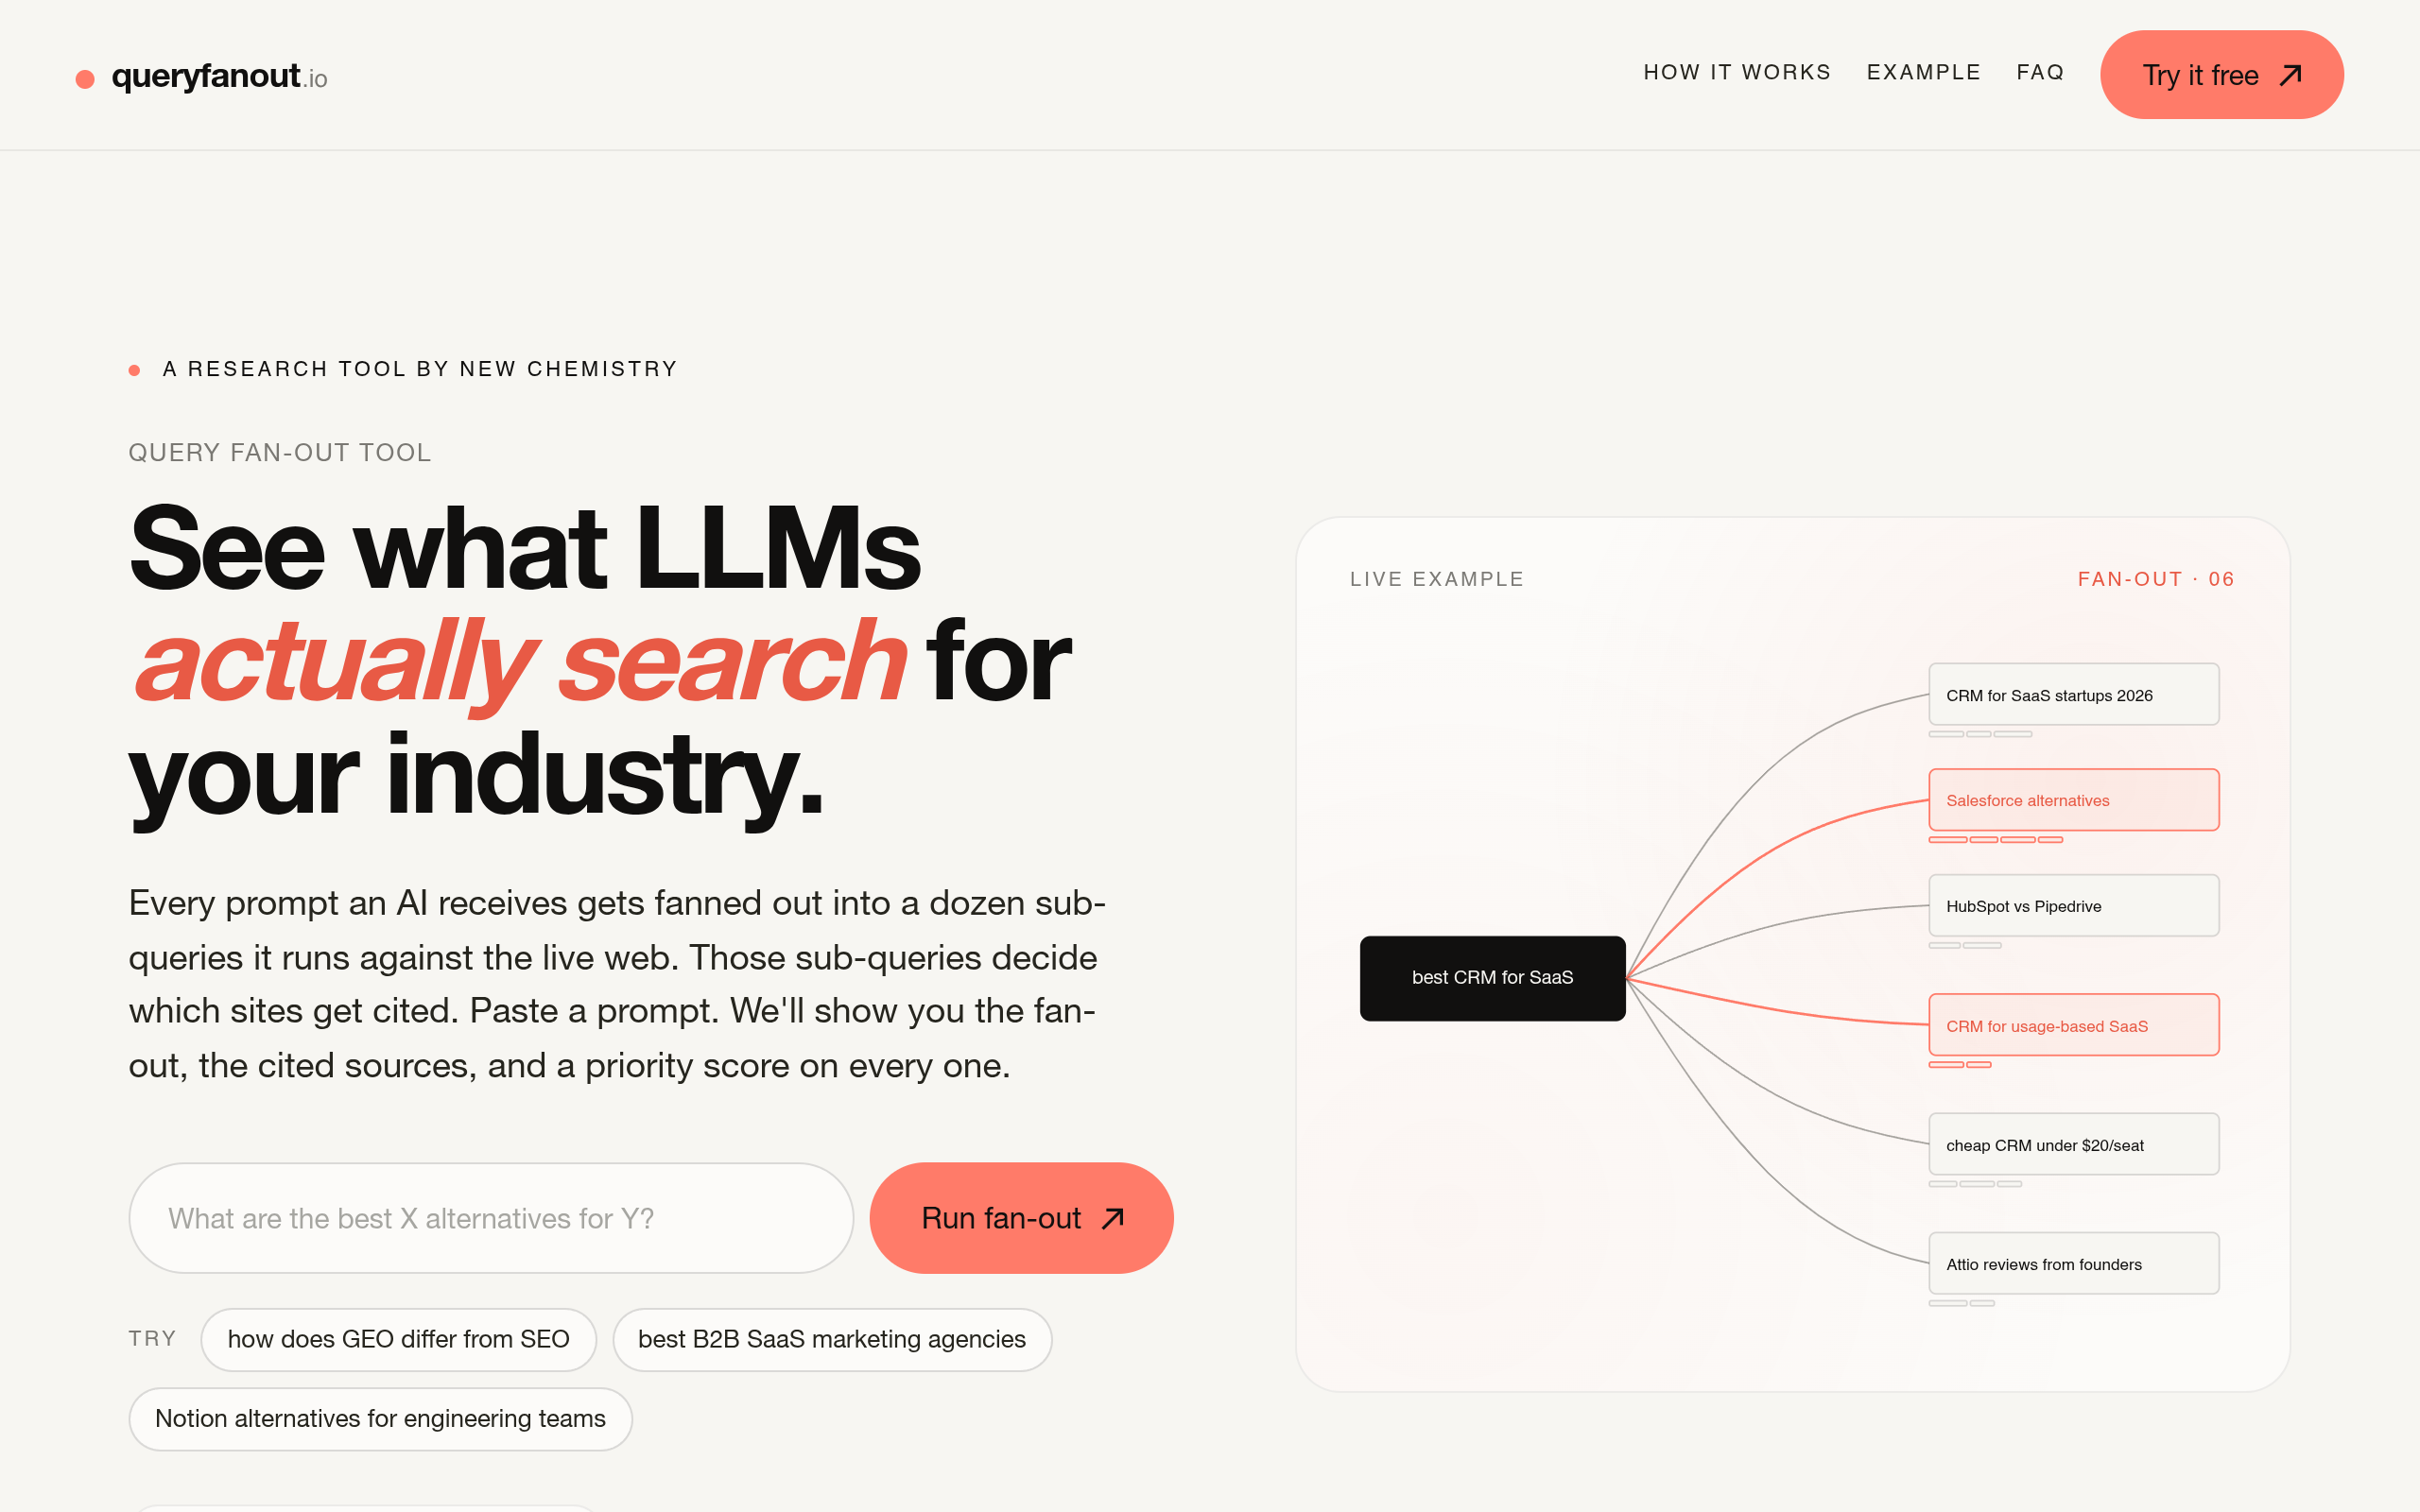
Query Fan-Out Optimizer是一款针对大语言模型搜索引用流程进行分析优化的技术工具,核心定位是拆解大语言模型在查找和引用网页来源过程中生成的隐藏子查询,帮助用户直观了解LLM的搜索推理路径。它支持子查询可视化展示、搜索流程优化分析、引用溯源验证、路径断点定位、结果偏差分析等核心功能,主要面向AI研究人员、大语言模型开发者、搜索引擎优化从业者、检索增强生成技术研发人员以及AI技术爱好者等用户群体,可应用于大语言模型推理逻辑研究、搜索生成内容准确性验证、检索增强生成技术优化、大模型搜索流程调试等多种场景,帮助相关从业者梳理大模型搜索环节的逻辑,发现现有流程中的潜在问题。

vitral.ai
Vitral是集成人工智能能力的在线工作区中心,核心定位是为需要与大语言模型互动、开展协作式AI工作的用户提供统一的AI工作管理平台。其核心功能包含多模型统一访问入口,无需在不同大语言模型平台间切换即可调用不同模型能力;团队协作内容管理模块,支持多人共享对话记录、协作编辑AI生成内容;自定义工作流搭建功能,可根据自身业务需求串联不同AI工具和操作步骤。目标用户覆盖研究人员、开发人员、内容创作者、企业运营团队、产品设计人员等群体,可适用于集中管理多平台LLM对话记录、团队协同创作AI相关内容、搭建专属AI工作流程、对比不同大模型输出效果等多种使用场景,帮助用户整合分散的AI工具资源,统一开展各类AI相关工作。
githubtollm.replit.app
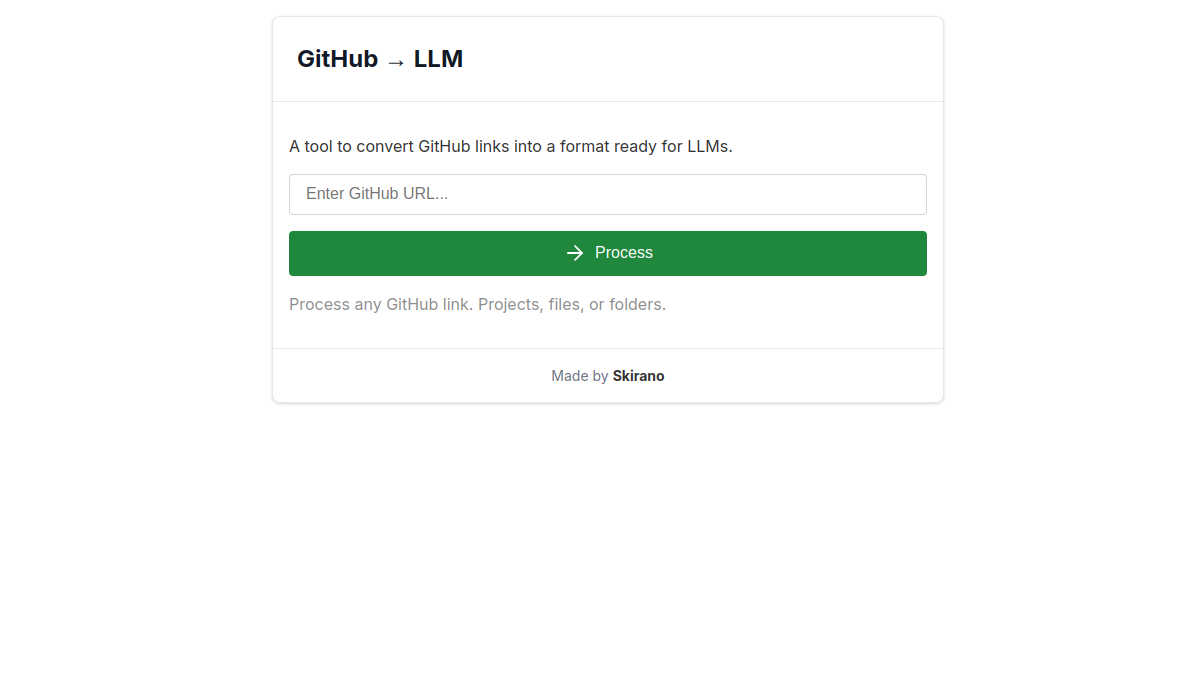
GitHub to LLM Converter是一款专注于GitHub资源格式转换的在线工具,核心定位是将GitHub平台的项目、文件、文件夹内容转换为适配大语言模型处理的结构化文本格式。其核心功能包括GitHub链接一键解析、内容结构化整合、自定义内容筛选导出,目标用户覆盖AI开发者、代码研究员、技术文档撰写者、大模型训练师等群体,可用于大模型代码数据集准备、代码逻辑问询前的内容预处理、开源项目文档批量整理、代码片段批量导出分析等多种场景,帮助用户减少手动复制整理代码的重复性工作,提升数据准备阶段的效率。

kel.qainsights.com
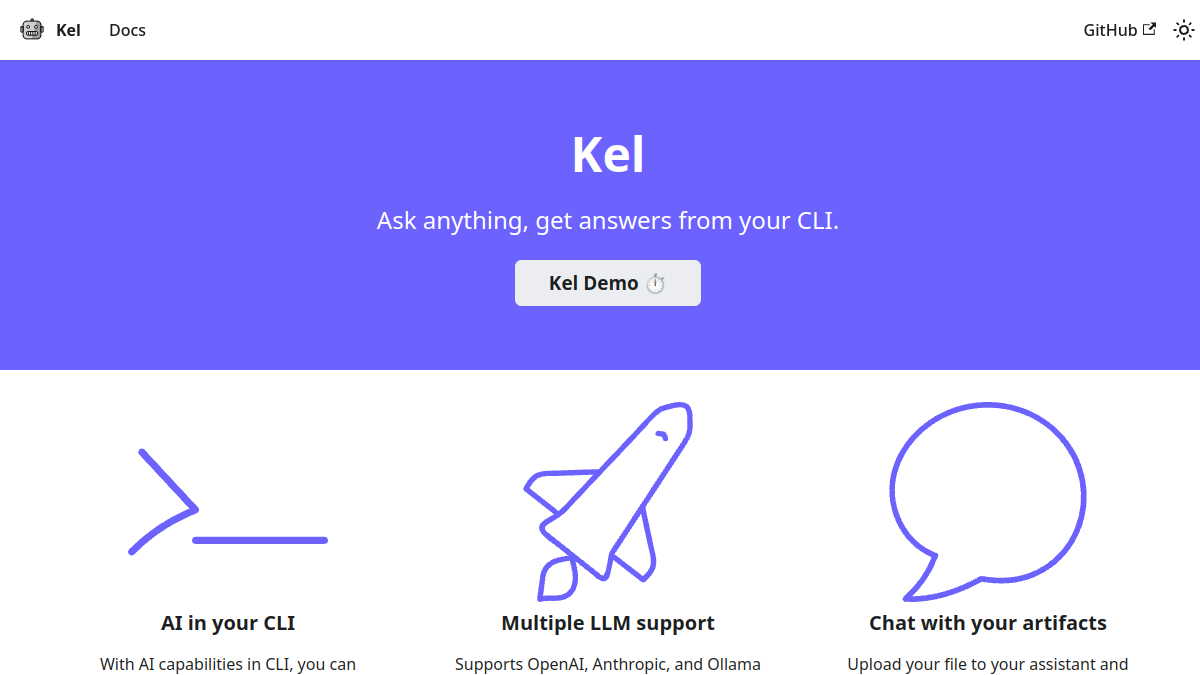
Kel是一款集成AI能力的命令行助手工具,核心定位是为命令行界面赋予大语言模型交互能力,帮助用户优化命令行操作流程。核心功能包括多LLM厂商支持、文件上传交互对话、重复任务自动化执行三类,支持接入OpenAI、Anthropic、Ollama等主流大模型及OpenAI助手服务。目标用户覆盖后端开发人员、运维工程师、CLI工具使用者、技术运维从业者等,可应用于日常命令调试、批量脚本生成、日志内容分析、重复操作自动化等场景,帮助用户降低命令行操作门槛,提升工作执行效率。


docetl.org
DocETL是面向文本数据处理场景的LLM驱动数据处理系统,核心定位是帮助用户高效完成非结构化文本的结构化转换、信息提取与分析工作。核心功能包括基于YAML声明式配置的工作流定义、LLM与传统数据操作的混合编排、交互式playground提示工程调试。目标用户覆盖数据分析师、AI工程师、科研人员、内容运营等需要处理批量文本的群体,可应用于学术文献批量分析、客服工单信息提取、媒体内容标签化、多源文档信息整合等场景,降低复杂文本处理流程的搭建与调试成本。

notdiamond.ai
Not Diamond是一款专注于优化大语言模型选择的AI模型路由器,核心定位为通过动态路由机制为用户请求匹配最合适的大语言模型。支持根据请求内容特征自动选择模型,提供混合调用方案,同时兼顾输出准确性与使用成本效率。目标用户包括AI应用开发者、企业AI部署团队、独立开发者以及AI服务提供商,适合在AI应用集成、批量文本处理、多场景生成任务等场景中使用,帮助用户平衡输出质量与调用成本。
tweet.md
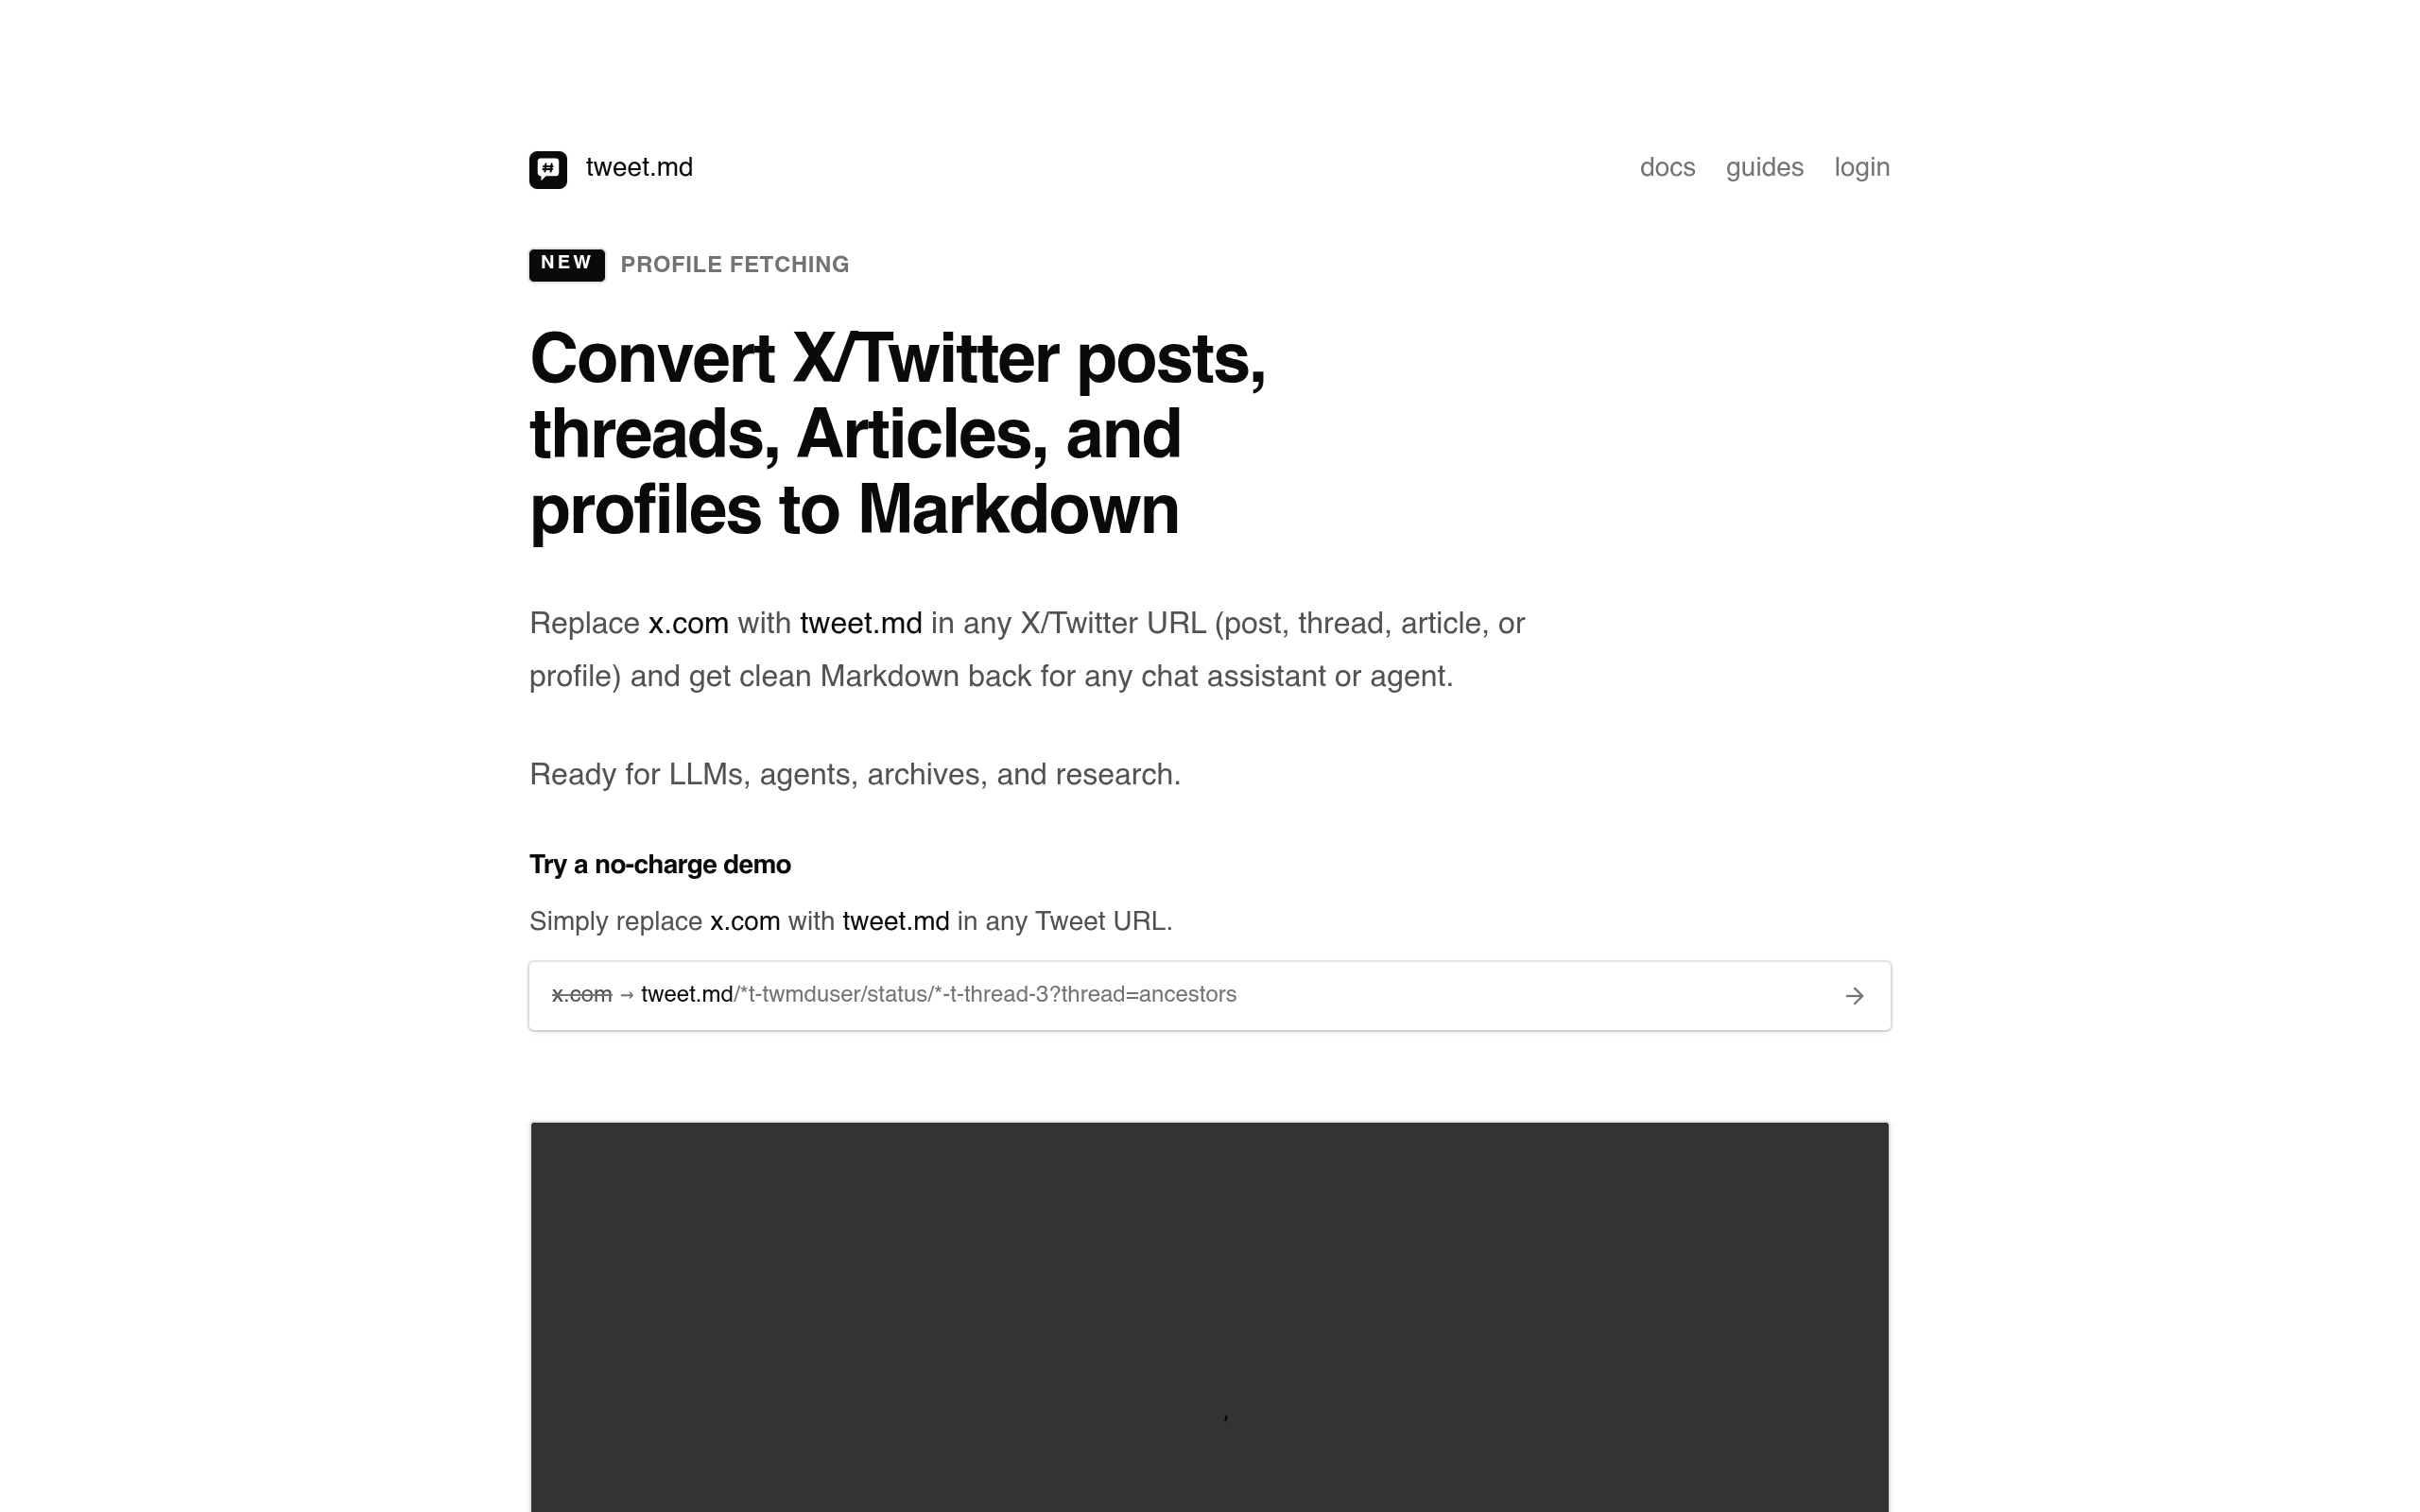
tweet.md 是一款专注于 X(原Twitter)内容格式转换的在线工具,核心定位是将平台上的单条帖子或推文线程转换为规范的Markdown格式文本。核心功能包括一键URL输入转换、多格式导出适配、API接口调用支持,能够自动保留原文的层级结构、媒体链接和互动数据。目标用户覆盖内容创作者、学术研究者、AI应用开发者等群体,适用于内容二次整理、研究资料归档、AI训练语料预处理等多种场景,无需登录即可快速完成转换操作。

promptpoint.ai
PromptPoint是专注于大语言模型提示语全生命周期管理的平台,核心面向需要批量使用提示词的企业及开发团队,支持提示语的协作设计、自动化效果测试、多环境部署、性能成本监控、版本回滚等全流程功能。团队可通过平台统一管理不同业务场景的提示语库,无需复杂技术操作即可完成提示语效果验证,降低业务需求与技术落地之间的信息差,适用于AI应用开发、客服话术优化、内容生成批量生产、企业内部AI工具搭建等多种场景,帮助团队提升提示语迭代效率,保障大模型输出的稳定性。

freshfeed.io
FreshFeed是面向大语言模型(LLM)及相关开发者设计的实时信息搜索引擎,核心定位是为AI模型提供时效性强的互联网信息补充,解决大模型训练数据截止导致的信息滞后、内容幻觉问题。平台具备多源信息实时抓取能力,可追踪全球范围内的新闻、行业博客、公共资讯平台等公开信息源,同步完成信息结构化处理与可信度标注;支持API接口直接调用,可快速嵌入GPT、Claude等主流大模型的响应流程,在模型生成回答前完成相关事实的交叉核验。目标用户覆盖AI应用开发者、大模型训练团队、智能客服研发人员等群体,适用于AI问答系统事实校验、实时资讯类AI工具开发、大模型训练时效性数据补充等多种场景。

l1m.io
l1m是Inferable公司开发的非结构化数据结构化提取工具,核心通过代理调用大型语言模型,支持从文本、图像两类非结构化内容中提取符合自定义格式的结构化数据,无需用户编写复杂提示词即可完成提取任务。核心功能包括多LLM模型适配、内置数据缓存、自定义输出 schema 配置、跨格式内容解析、提取结果校验。目标用户覆盖企业数据运营人员、AI应用开发者、数据分析人员、内容管理从业者、学术研究人员、金融合规专员。可应用于批量文档信息提取、多模态内容结构化入库、客户反馈数据归类、纸质文件电子化转结构化数据、合规文档信息抽取等多种场景,帮助用户降低非结构化数据处理的技术门槛,提升数据提取的准确性与处理效率。

openplugin.io
OpenPlugin是专注于大语言模型插件生态的开源服务平台,核心定位是降低ChatGPT等大语言模型插件的开发与使用门槛,帮助用户拓展AI工具的应用边界。平台提供插件集市检索、一键接入适配、开发文档支持、插件效果测试、跨模型兼容调度五大核心功能,面向大语言模型使用者、AI应用开发者、企业技术团队等群体,可满足个人用户拓展AI对话能力、开发者快速迭代插件产品、企业搭建专属AI工具矩阵等多场景需求。
memorilabs.ai
Memori是Memori Labs推出的大语言模型无关的代理状态管理层工具,核心定位是为AI代理的执行过程与对话内容提供结构化、持久化的状态存储方案,帮助开发者搭建更加稳定的生产级AI应用。其核心功能包括多LLM兼容的状态统一管理、代理执行过程的全链路可追溯、对话上下文的结构化持久化,同时支持自定义状态字段与查询规则,可适配不同业务场景的状态管理需求。目标用户覆盖AI应用开发者、企业AI技术团队、AI代理研发人员、大模型应用运维人员等群体,适用于智能客服系统开发、企业级AI代理部署、多轮对话应用搭建、AI工作流生产落地等多种场景,降低AI应用生产过程中的状态混乱、上下文丢失等问题的出现概率。
anycrawl.dev
AnyCrawl是一款专注于网页数据结构化提取的高性能API服务,核心定位是将任意网页内容转换为适配AI与大语言模型的规整结构化数据。其核心功能包括全类型网页内容爬取、结构化数据自动格式化、LLM友好的数据输出优化,支持静态网页、动态渲染页面、登录态页面等多种复杂网页场景的内容提取。目标用户覆盖AI应用开发者、数据分析师、内容运营人员、科研人员等群体,可用于大语言模型训练数据采集、行业情报批量整理、公开内容合规汇总、学术研究数据获取等多个使用场景,帮助用户减少网页爬虫开发与数据清洗的工作量。
litellm.ai
LiteLLM是Berri AI推出的大语言模型网关工具,核心定位是帮助开发者统一对接不同厂商的大语言模型服务,适配OpenAI接口格式。核心功能包括跨100+大模型的统一请求适配、调用权限与身份校验管理、多模型负载均衡调度、调用消费明细追踪统计。目标用户覆盖AI应用开发者、企业AI技术团队、MLOps运维人员、AI产品研发团队等,可应用于多模型融合应用开发、企业大模型调用统一管控、AI服务稳定性运维、研发成本核算统计等场景,降低开发者对接不同大模型的适配成本,提升大模型调用的管控效率。
getbind.co
Bind是一款协作式生成式AI应用开发平台,面向有AI应用构建需求的开发团队与个人开发者,提供从提示词调试到生产部署的全流程工具支持。平台核心功能包含多角色协作的提示词场景测试、低代码LLM应用编排、一键生产环境部署能力,可满足团队协作开发AI客服、智能助手、内容生成工具等多类型LLM应用的需求,降低生成式AI应用的开发与落地门槛,帮助开发者将大语言模型能力快速整合到实际业务场景中。
urlparser.online
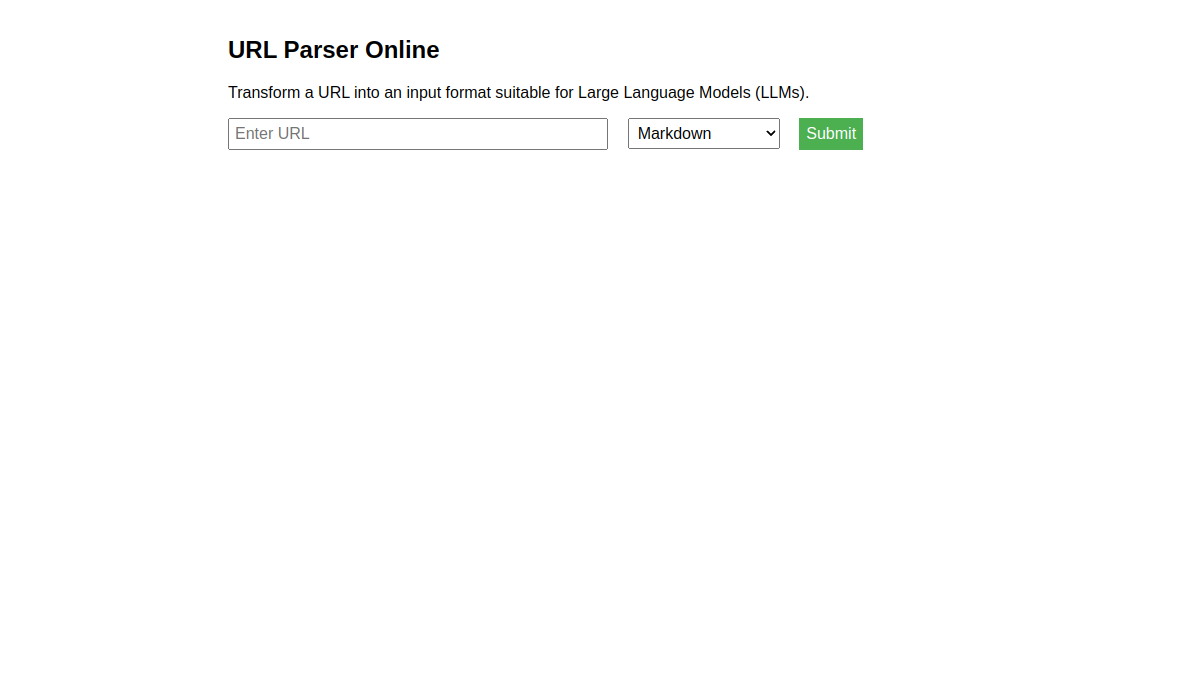
URL Parser Online是一款专注于URL结构化解析的在线工具,核心定位是将URL拆解为标准化的组成部分,同时支持转换为适配大语言模型的输入格式。其核心功能包括URL多维度字段拆分、LLM友好格式导出、批量URL解析处理,主要面向开发者、数据分析师、AI应用研究人员、网络安全从业者、内容运营人员等群体,可应用于网页爬虫数据预处理、大模型URL相关prompt构建、网络请求异常排查、域名合规性检测、URL参数批量调整等场景,无需安装客户端即可直接在浏览器中完成解析操作。