语音技术研究
homebrew.ltd
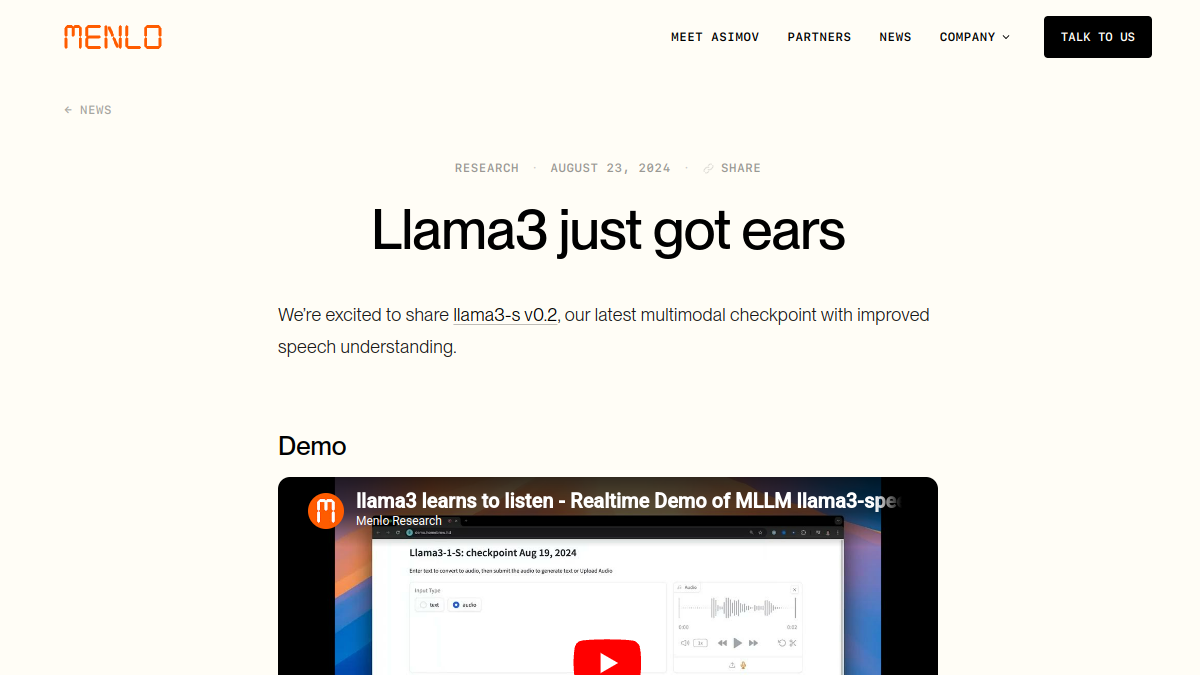
Llama3-s v0.2是由Homebrew Computer Company开发的多模态模型检查点,核心定位为专注语音理解能力优化的开源模型版本。该模型采用语义标记早期融合技术,可实现更稳定的语音特征提取,同时支持用户通过页面内置的实时演示功能直接上传音频测试识别效果,还提供完整的模型迭代日志与技术原理说明。目标用户覆盖AI语音技术开发者、多模态模型研究人员、语音应用产品经理、相关专业高校学生等群体,可用于语音识别效果验证、多模态模型结构调研、语音应用原型开发测试等多个场景。
safeearweb.github.io
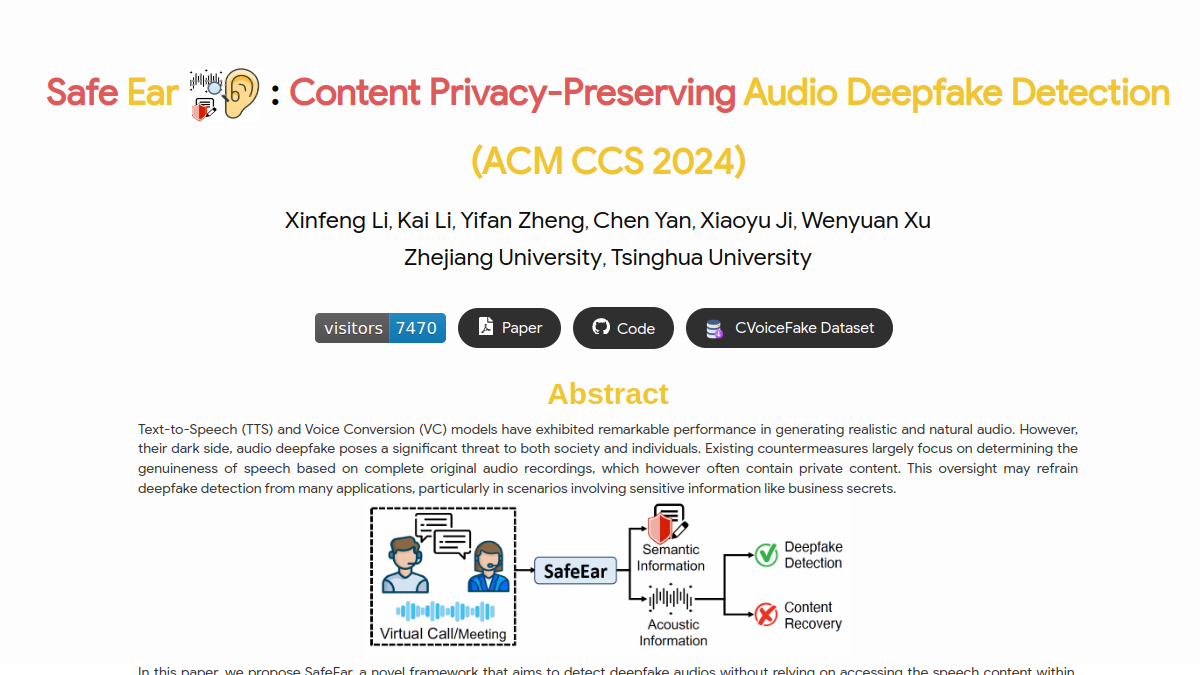
SafeEar是聚焦隐私保护的音频深度伪造检测工具,核心定位为兼顾音频伪造识别与语音内容隐私防护的技术框架。核心功能包含基于声学特征的深度音频检测,无需解析语音语义内容即可识别伪造音频;语义与声学信息分离机制,通过专属神经音频编解码器拆分两类信息,避免语音内容泄露;多语言隐私防护能力,支持多种语言的语音内容加密,抵御机器与人工的内容破译。目标用户覆盖网络安全从业者、音频内容平台运营人员、语音技术研究人员、政企信息安全管理岗位、司法取证技术人员、普通个人用户等。适用场景包括线上语音内容平台的伪造内容筛查、政企内部语音会议的内容安全防护、司法场景下音频证据的真伪核验、个人用户语音社交场景下的隐私保护、音频技术研究中的伪造检测基准测试等。
speechresearch.github.io
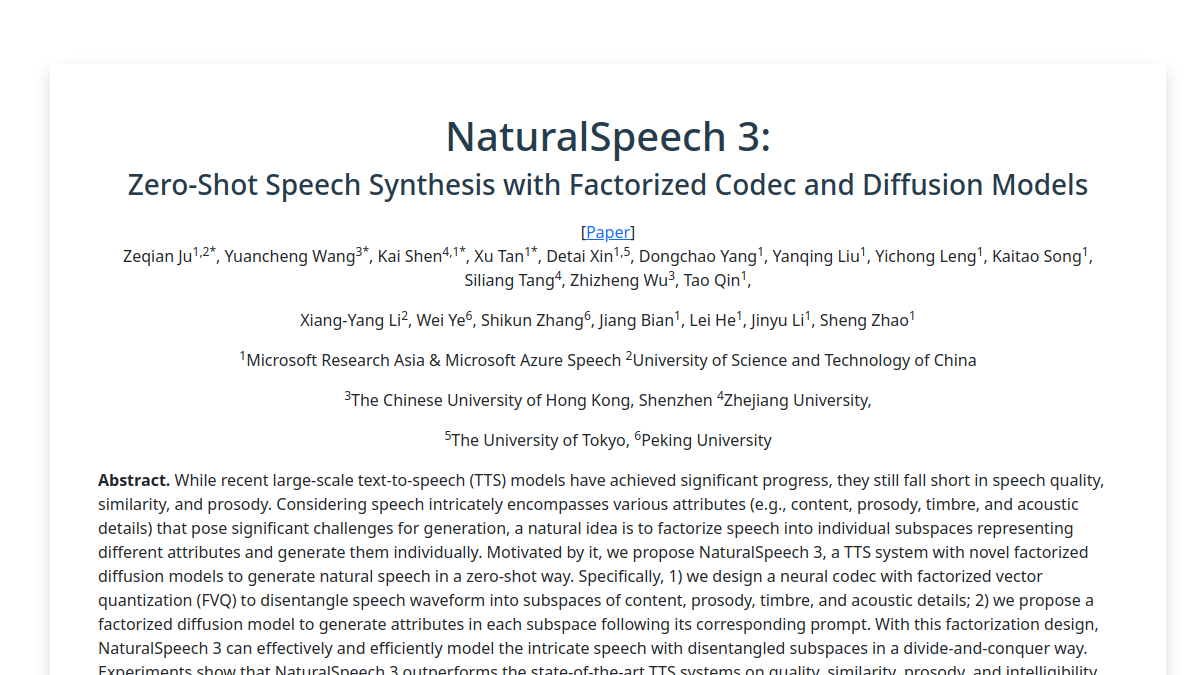
NaturalSpeech 3是由字节跳动Speech Research团队研发的零样本语音合成研究项目,核心定位是通过分解式语音建模技术生成高自然度的合成语音。其核心功能包括语音属性分解建模、零样本语音克隆、多风格语音生成,能够将语音的内容、音色、韵律、情感等属性解耦处理,无需大量训练数据即可复刻目标发音人的语音特征。该项目面向语音研究人员、AI开发人员、内容创作从业者、多媒体制作人员等群体,可应用于有声内容制作、虚拟人语音配置、语音辅助工具开发、多语言语音内容生成等场景,为语音合成相关的研究与应用提供技术参考与方案支撑。