自动驾驶
shlab.org.cn
GenAD是上海人工智能实验室联合香港科技大学、德国图宾根大学、香港大学共同研发的早期大规模自动驾驶视频生成模型,核心定位是为自动驾驶技术研究与落地提供场景模拟支撑。该模型可通过语言指令或行车轨迹参数生成符合真实交通逻辑的动态驾驶场景,也可对现有驾驶场景进行变量修改模拟突发情况,还能输出多视角同步的行车视频数据供算法训练使用。核心目标用户涵盖自动驾驶算法研发人员、高校智能交通研究团队、车企测试部门人员等,可应用于自动驾驶感知算法训练、极端场景安全测试、行车规划逻辑验证等多个专业场景,助力自动驾驶技术的迭代与落地。

aionlinecourse.com
AI Online Course是聚焦人工智能领域的在线互动学习平台,核心定位是为不同基础的学习者提供系统化、重实践的AI知识学习服务。平台核心功能包括结构化AI知识体系讲解、配套实操案例演练、学习进度动态追踪、行业应用场景解析、知识点测试巩固,覆盖机器学习、深度学习、计算机视觉、自动驾驶、聊天机器人等多个细分方向,将复杂的AI概念拆解为易懂的内容模块。目标用户涵盖在校学生、技术从业者、产品经理、行业转型人员、AI兴趣爱好者等群体,可满足日常知识补充、职业技能提升、项目落地参考、兴趣探索等不同场景的学习需求。
revisit-anything.github.io
Revisit Anything 是基于视觉位置识别技术搭建的图像检索系统,核心定位是实现跨图像的位置匹配与识别。核心功能包括图像片段位置检索、SAM与DINO技术融合识别、多场景视觉特征比对。目标用户覆盖计算机视觉研究人员、机器人开发从业者、自动驾驶技术测试人员、空间测绘工程师等。适用于机器人自主导航场景的位置重定位、自动驾驶车载视觉的场景匹配、多视角图像的相同位置识别、视觉SLAM系统的闭环检测等工作场景,能够帮助用户快速完成不同图像中相同位置的匹配验证,提升视觉识别相关项目的研发效率。
tsinghua-mars-lab.github.io
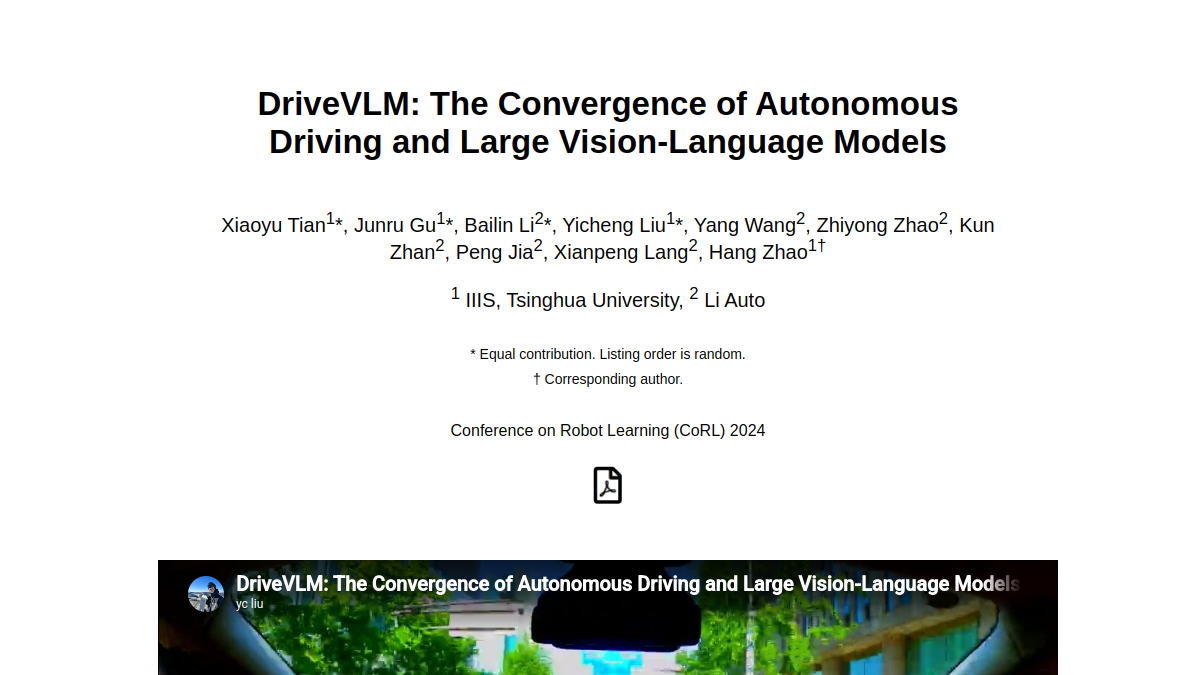
DriveVLM是清华大学MARS实验室推出的自动驾驶研发系统,核心定位是将视觉语言模型能力融入自动驾驶流程,提升复杂场景下的感知与决策表现。该系统具备场景语义描述、多维度场景分析、分层驾驶规划三类核心功能,同时推出混合架构的DriveVLM-Dual版本,平衡大模型推理能力与传统自动驾驶系统的空间计算、实时响应优势。目标用户覆盖自动驾驶领域研究人员、高校相关专业师生、自动驾驶企业技术研发团队,可用于自动驾驶算法迭代、长尾场景处理方案验证、大模型在自动驾驶领域的落地研究等场景,相关实验成果已在nuScenes、SUP-AD公开数据集以及量产实车环境中完成验证。
depth-anything.github.io
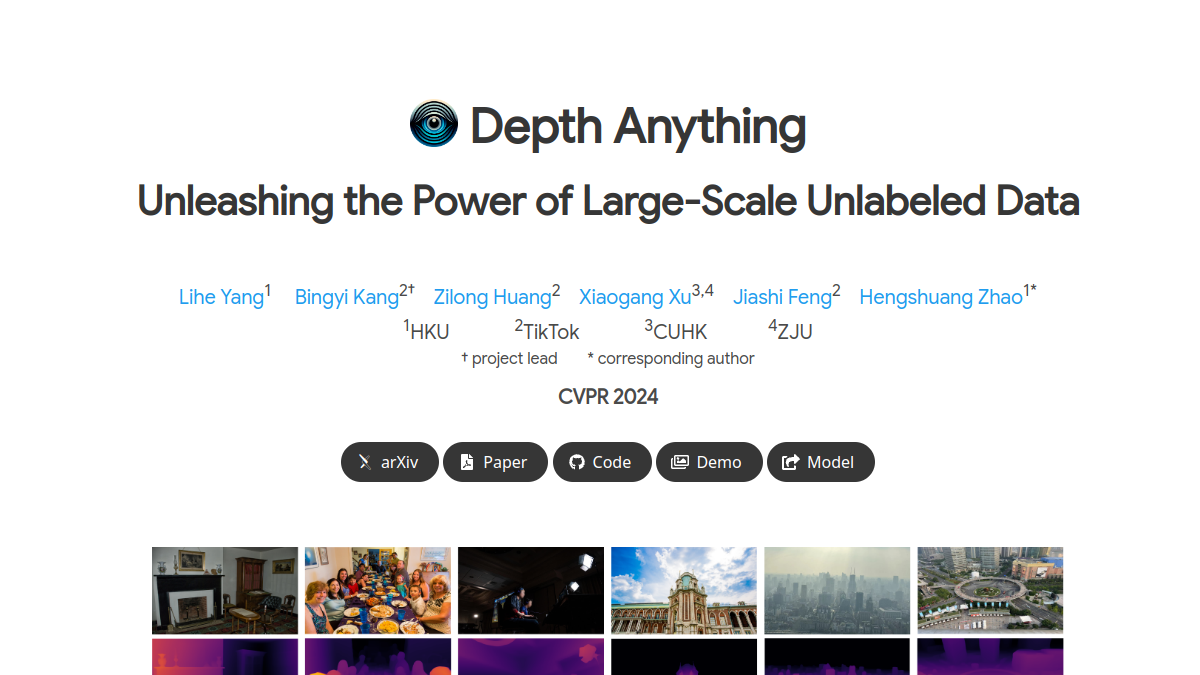
Depth Anything是专注于单目深度估计的技术项目官网,核心定位是提供可泛化的单目视觉深度估计基础模型。核心功能包括开源模型资源下载、零样本深度估计效果演示、不同微调版本的效果对比展示,同时提供配套的技术论文、训练数据说明文档。目标用户覆盖计算机视觉研究人员、自动驾驶算法开发人员、AR/VR内容创作者、影视后期制作人员等,可应用于3D场景重建、自动驾驶环境感知、AR虚实融合效果调校、影视景深特效生成等多个场景,为需要从单张图像获取深度信息的工作提供模型支撑。

tesla.com
We, Robot是特斯拉官方展示自动驾驶与机器人技术布局的专题页面,核心定位为公开特斯拉在智能出行、人形机器人领域的技术路线与长期愿景。核心功能包含自动驾驶技术路线解读、未来智能出行产品矩阵介绍、人形机器人Tesla Bot应用场景展示三类。目标用户覆盖汽车行业从业者、科技领域爱好者、新能源与AI技术研究者、特斯拉潜在用户等群体,适用于用户了解特斯拉前沿技术规划、行业人士分析智能交通发展方向、科技爱好者追踪前沿AI落地应用等多种场景。