学术研究
chineselaw.com
元典智库是面向中文法律领域的专业法律研究与案例分析平台,依托国内法律数据库资源,为法律从业者、学术研究人员提供法律条文检索、司法案例查询、裁判规则分析等核心功能。平台覆盖现行有效法律法规、司法解释、各级法院裁判文书等多类法律数据资源,可满足诉讼策略制定、学术研究论证、法律实务问题查证等多场景使用需求,帮助用户高效完成法律信息的整合与分析工作。

wispaper.ai
WisPaper是一个基于人工智能的学术论文筛选分析平台,核心定位是帮助学术研究者快速从大量论文中定位符合研究方向的核心文献。平台支持批量上传论文列表,通过AI算法快速分析论文主题、研究贡献和相关性,完成大规模论文的初筛工作。核心功能包含AI驱动的论文筛选、核心研究内容提取、研究脉络梳理、相关性排序、文献标签分类等,主要面向高校科研人员、研究生、文献综述撰写者等用户,适用于开题前文献调研、综述撰写文献整理、领域研究现状梳理等场景。
researchgoat.com
ResearchGoat是一个AI驱动的自动化定性研究与面试分析平台,核心定位是帮助研究人员、企业团队简化定性研究数据处理流程,提升分析效率。平台支持从访谈转录、主题编码到生成研究报告的全流程自动化处理,核心功能包含AI辅助主题分析、自动化转录与编码、协作研究管理、访谈方案生成、结果可视化输出。目标用户覆盖学术研究者、市场调研团队、人力资源从业者、用户体验设计师等需要处理定性数据的群体,适用于学术访谈研究、用户需求调研、招聘面试评估、焦点小组讨论分析等多种场景。
video-language-planning.github.io
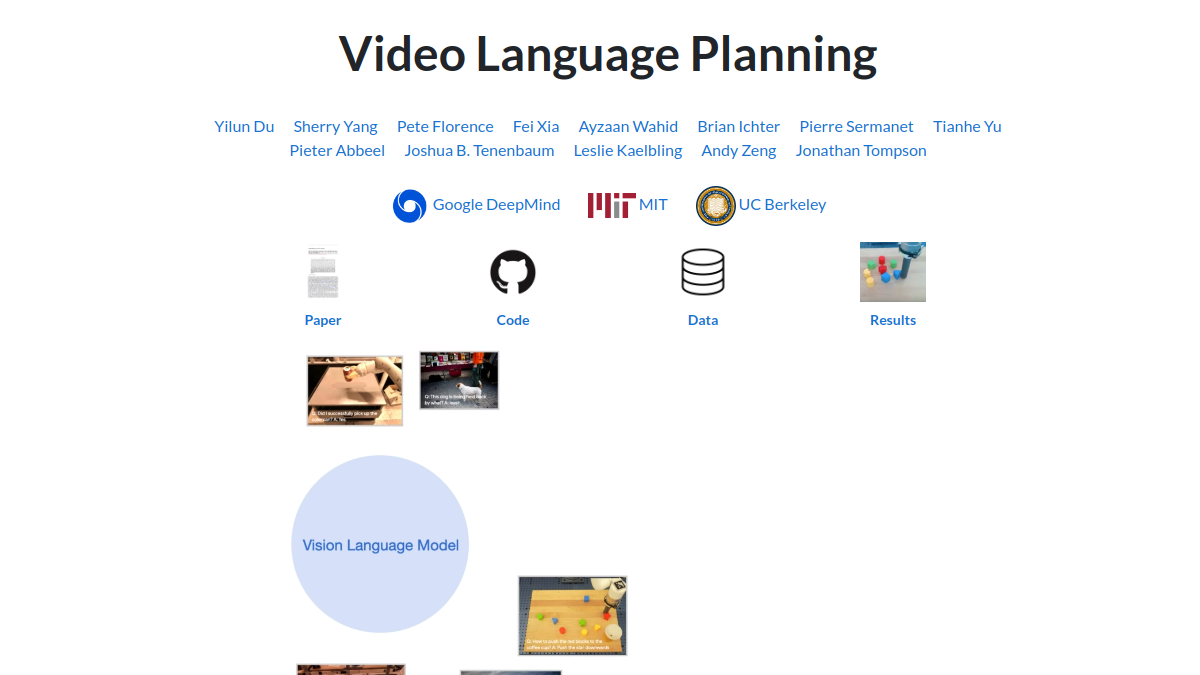
Video Language Planning(简称VLP)是面向机器人任务规划领域的算法展示与技术说明站点,核心定位是展示基于视觉语言模型与文本到视频模型结合的长期任务视觉规划方案。站点核心功能包括算法原理的可视化讲解、不同应用场景的实验结果展示、可复现的技术实现文档开放,目标用户覆盖机器人研发人员、多模态AI研究者、高校自动化相关专业师生,可用于机器人任务规划算法调研、多模态模型落地机器人场景的技术参考、相关领域学术研究的案例参考等场景。
rf-inversion.github.io
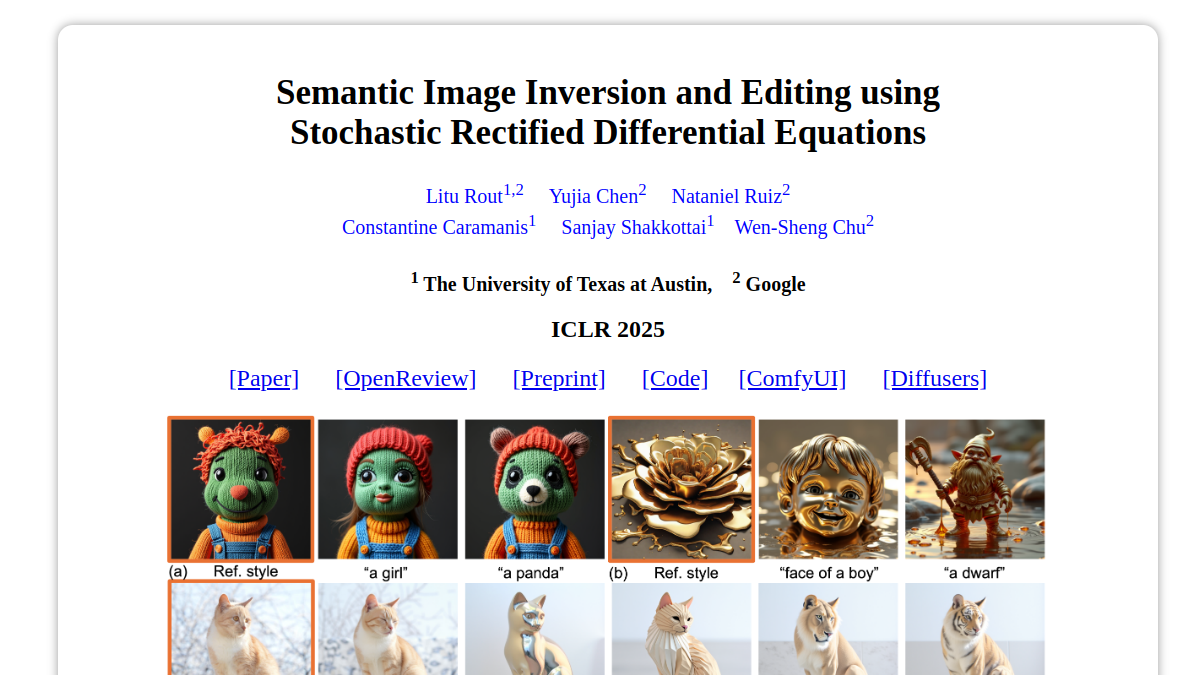
RF-Inversion是由德克萨斯大学奥斯汀分校与谷歌研究人员联合开发的图像生成与编辑技术展示平台,核心基于随机微分方程(SDE)实现图像反转与编辑操作,无需额外模型训练、潜在空间优化、提示词调整或复杂注意力处理器即可完成相关任务。平台核心功能包括零样本图像反转、笔画转图像合成、语义图像编辑三类,主要面向计算机视觉研究人员、AI图像技术开发者、数字内容创作者、高校图像处理相关专业学生等群体,可应用于学术研究效果复现、创意图像内容生成、图像属性定向调整、手绘内容数字化转换等多种场景。

gaussiancube.github.io
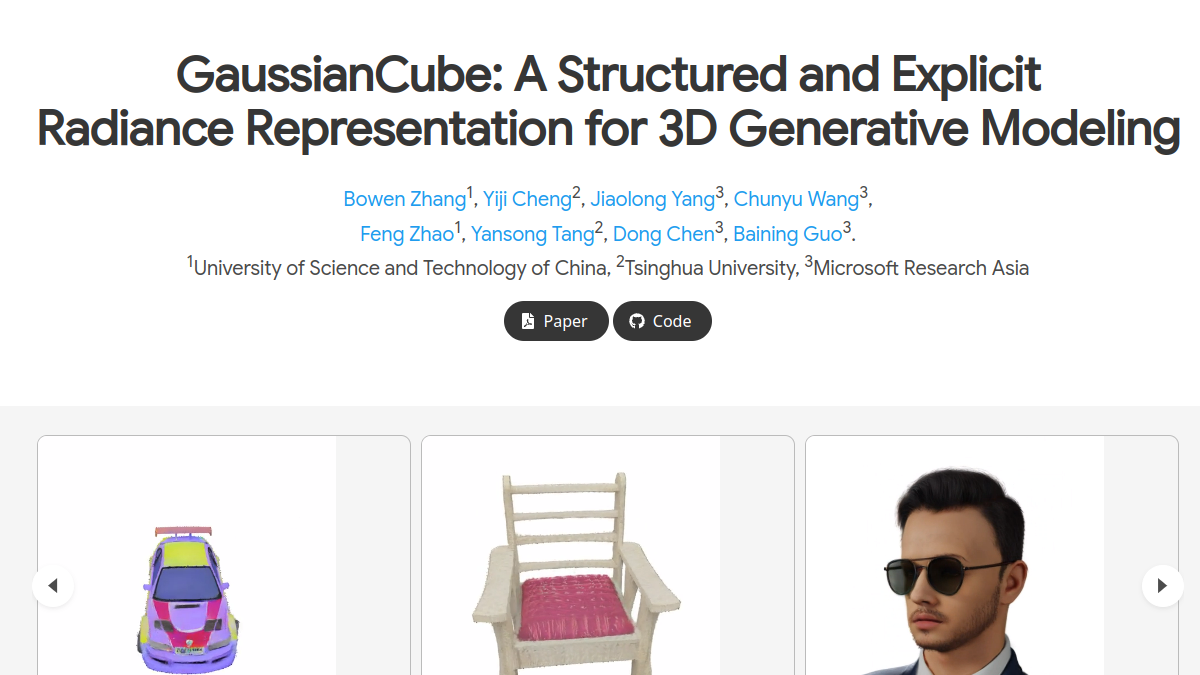
GaussianCube是一个专注于3D辐射表示技术的学术项目网站,核心定位是展示结构化显式3D辐射表示的相关研究成果与应用资源。核心功能包括提供结构化高斯表示技术的完整技术文档、开源算法代码包下载、3D重建与生成效果演示案例、相关研究论文与实验数据下载、开发者使用教程与常见问题解答。目标用户覆盖计算机视觉领域研究人员、3D内容开发工程师、图形学方向高校师生、元宇宙内容创作者、3D建模从业者。适用场景包括3D内容生成模型研发、高精度3D场景重建、游戏与影视3D资产制作、AR/VR场景内容构建、3D测量与数字孪生建模等多个领域,帮助相关从业者降低3D生成建模的开发门槛,提升3D内容的制作效率与呈现质量。
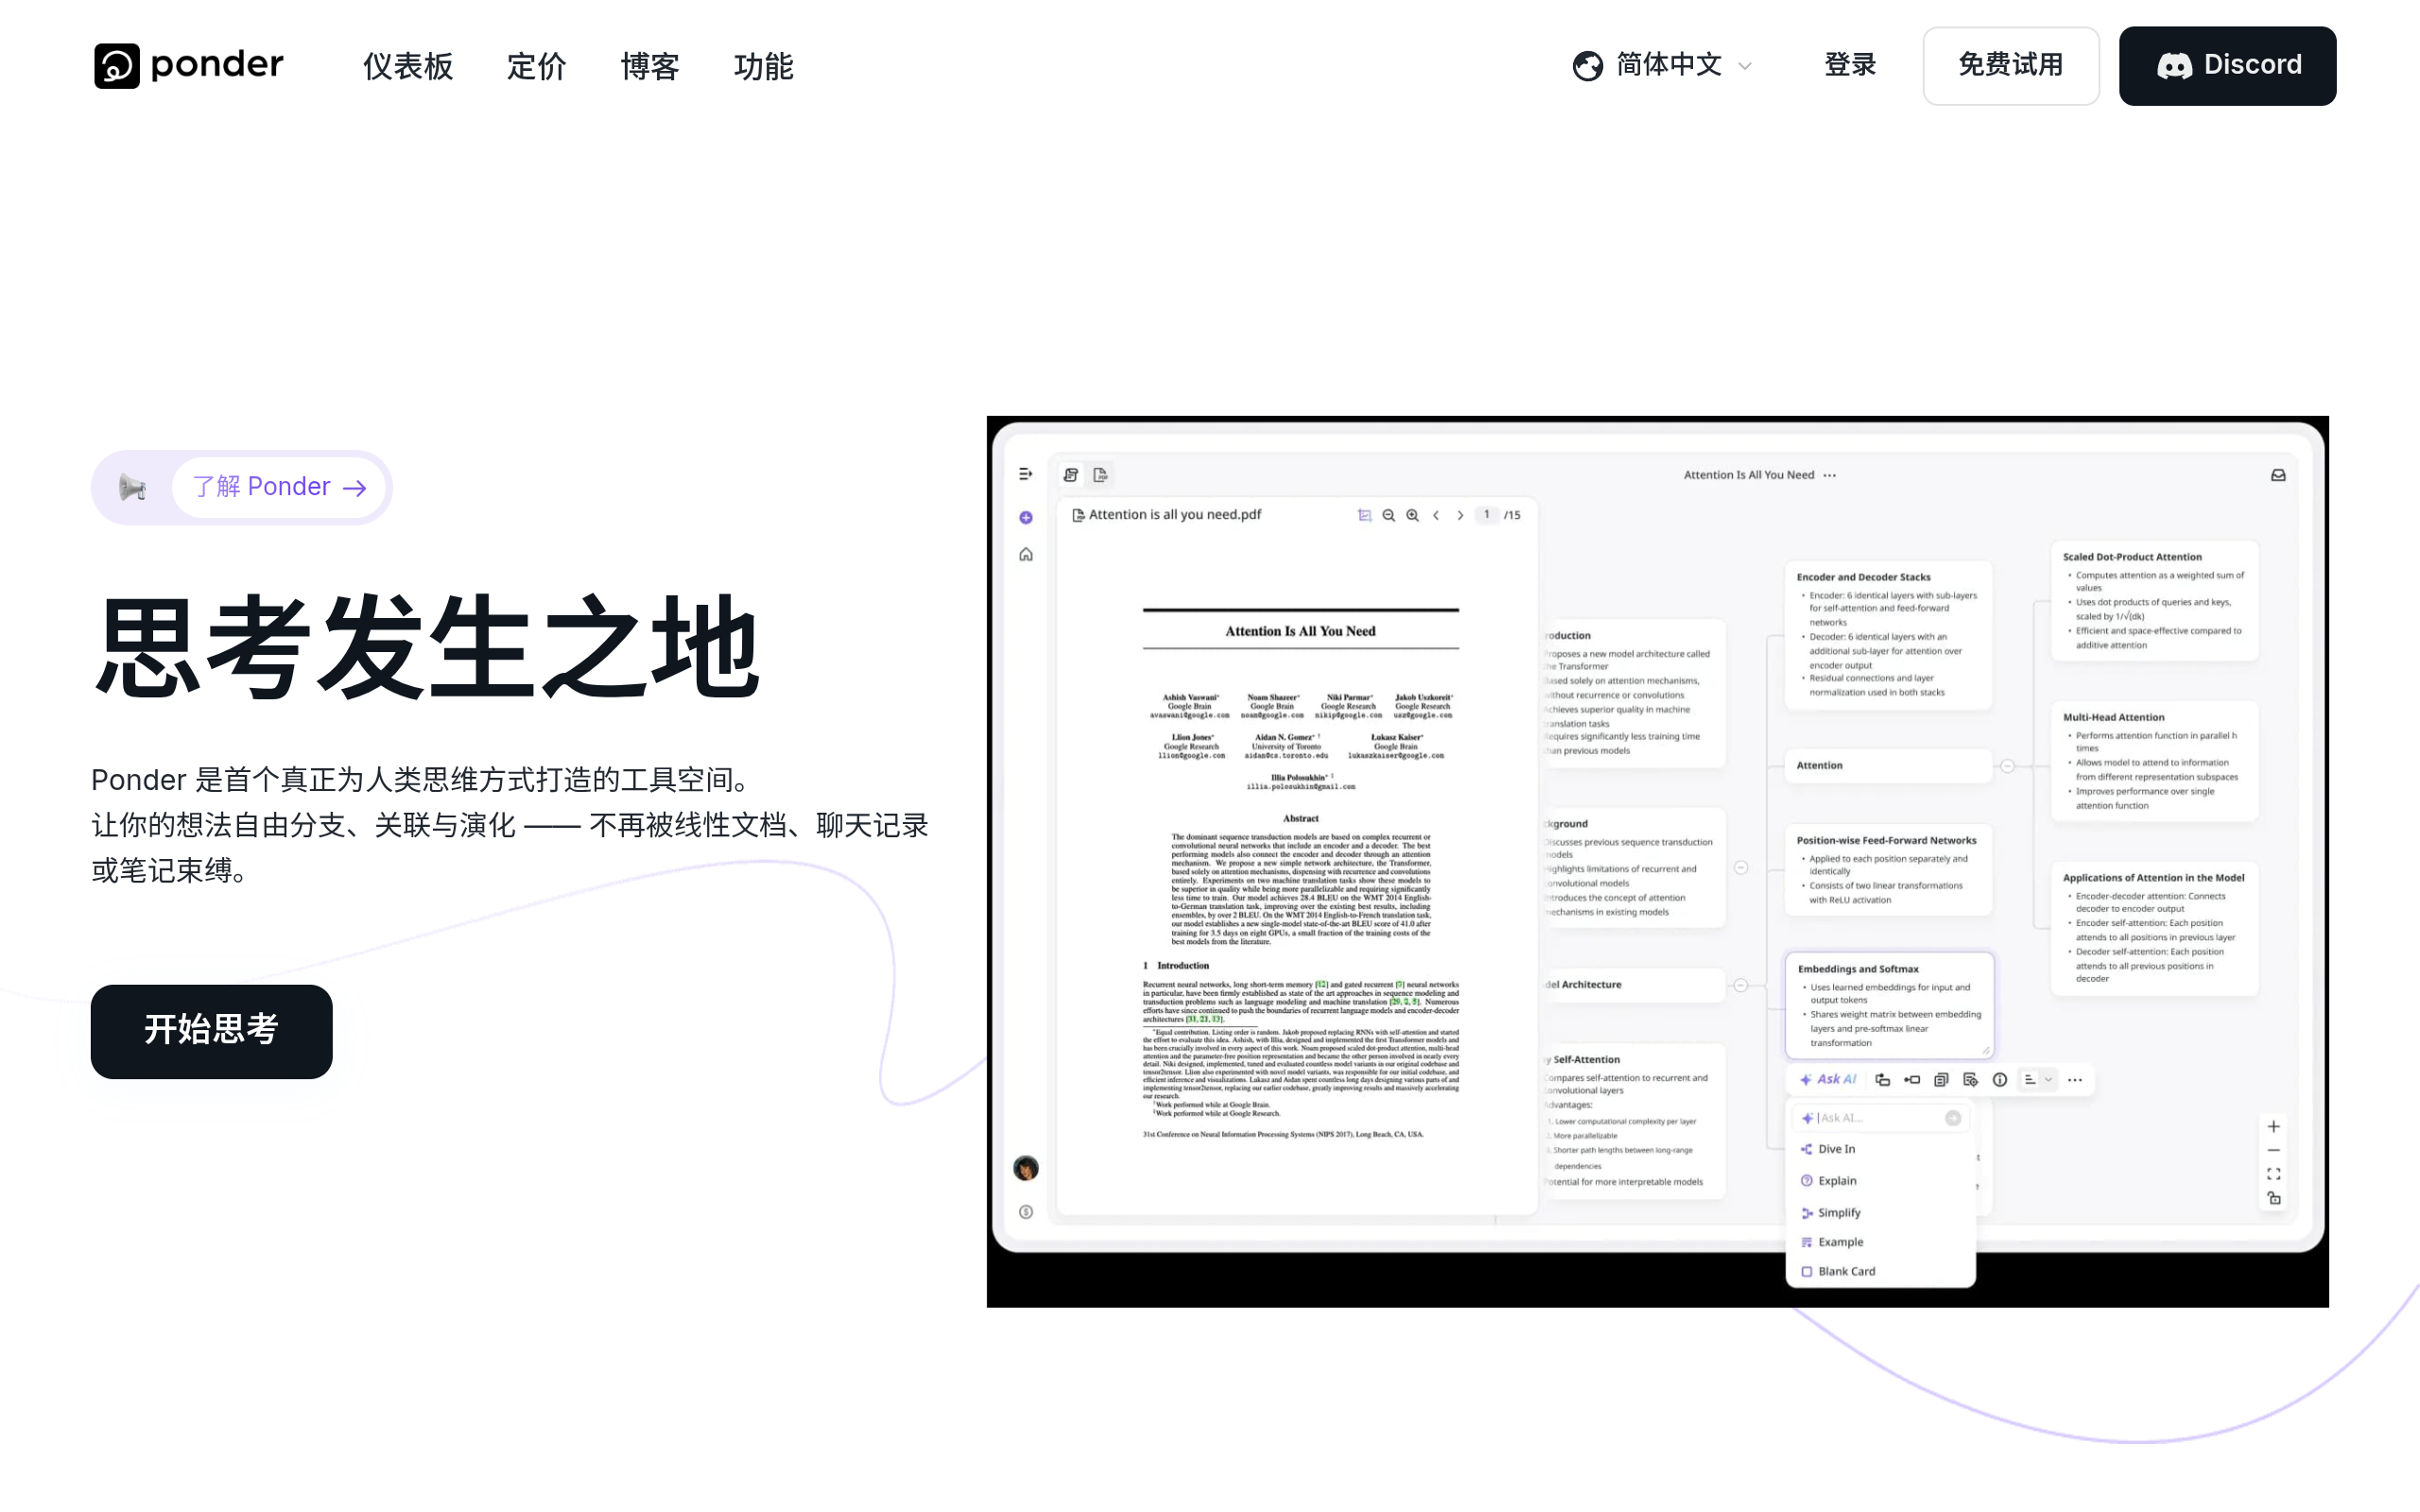

rflow.ai
ResearchFlow是一款由人工智能驱动的学术研究引擎,核心定位是为学术研究相关群体提供智能化的文献处理与知识梳理服务。核心功能包括AI学术搜索、可视化知识图谱生成、多文档对比整合,目标用户覆盖高校学生、科研人员、教育工作者、企业分析师等群体。可应用于论文文献综述梳理、课题研究知识点整理、跨学科研究资料整合、行业报告数据解析等多个场景,能够帮助用户简化学术研究中的信息收集、分析、可视化流程,提升研究过程的效率。
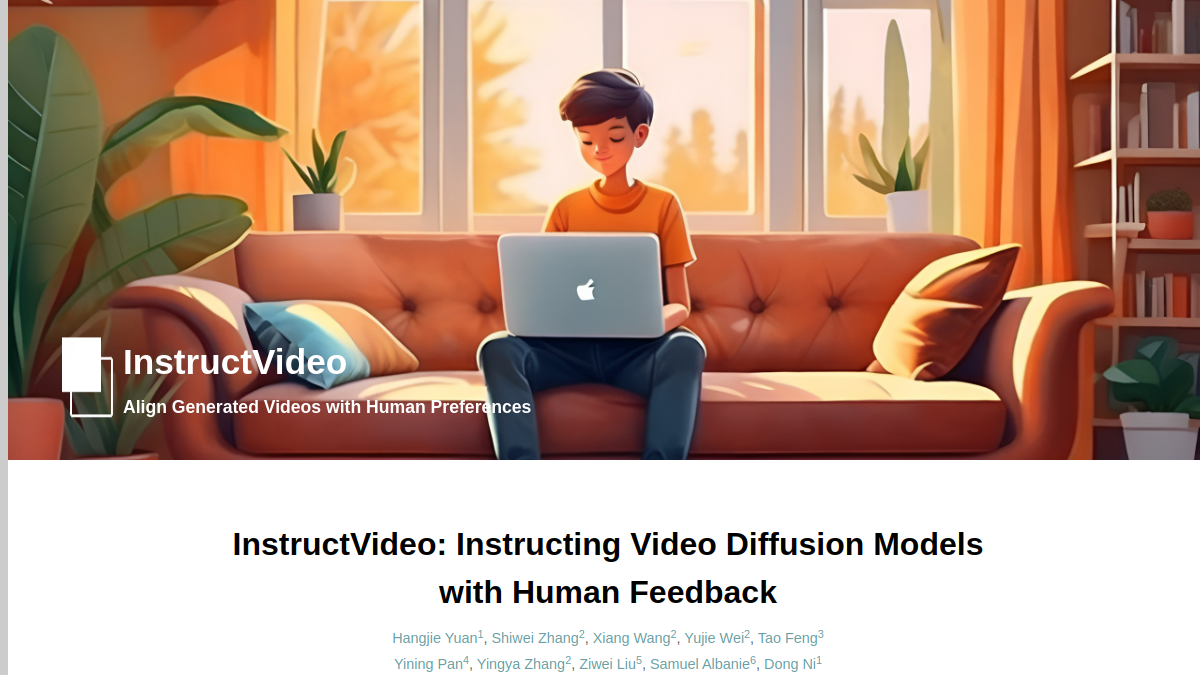
instructvideo.github.io
InstructVideo是基于人类反馈奖励微调机制的文本生成视频技术研究展示平台,核心定位为公开文本到视频扩散模型的优化方案及相关技术成果。平台提供技术论文原文查阅、核心算法原理演示、生成效果对比样例查看三大核心功能,面向AI视频生成领域的研究人员、算法开发工程师、相关专业高校学生,以及AI内容创作从业者,支持技术学习、算法参考、效果验证、研究选题参考等多种场景使用。

liuff19.github.io
Video-T1是基于测试时间缩放技术(TTS)构建的开源视频生成模型演示站点,核心定位是为视频生成领域的相关从业者提供高质量视频生成效果的测试与技术验证平台。站点支持文本转视频生成、生成参数自定义调整、传统方法效果对比、生成结果下载、TTS技术原理说明等核心功能,目标用户涵盖人工智能领域研究人员、视频生成方向开发者、数字内容创作者、高校计算机相关专业学生等群体。可应用于视频生成技术学术研究验证、技术选型前的效果测试、数字内容原型创作、教学过程中的技术演示等多种场景,帮助用户直观了解测试时间缩放技术对视频生成质量的提升效果。
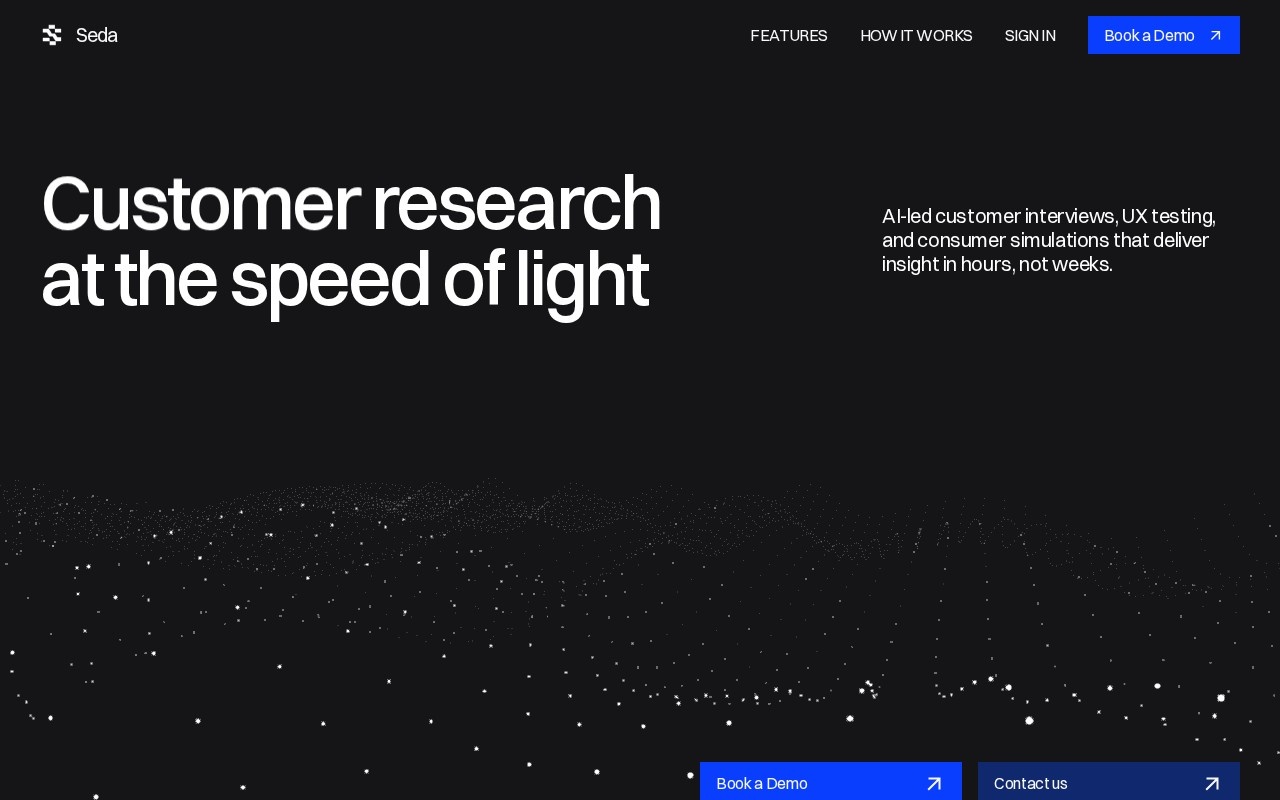
getseda.com
Seda是AI驱动的社交媒体协作平台,核心定位是服务于需要开展事实型内容创作与研究协作的用户群体,支持多人围绕共同主题开展在线研究、内容梳理与结构化发布。平台集成AI辅助能力,可以帮助用户快速整合分散信息、验证内容来源,支持公开内容分享和私密团队协作,满足学术调研、行业分析、内容创作等多场景的信息整合与协作需求。

diffusion-vas.github.io
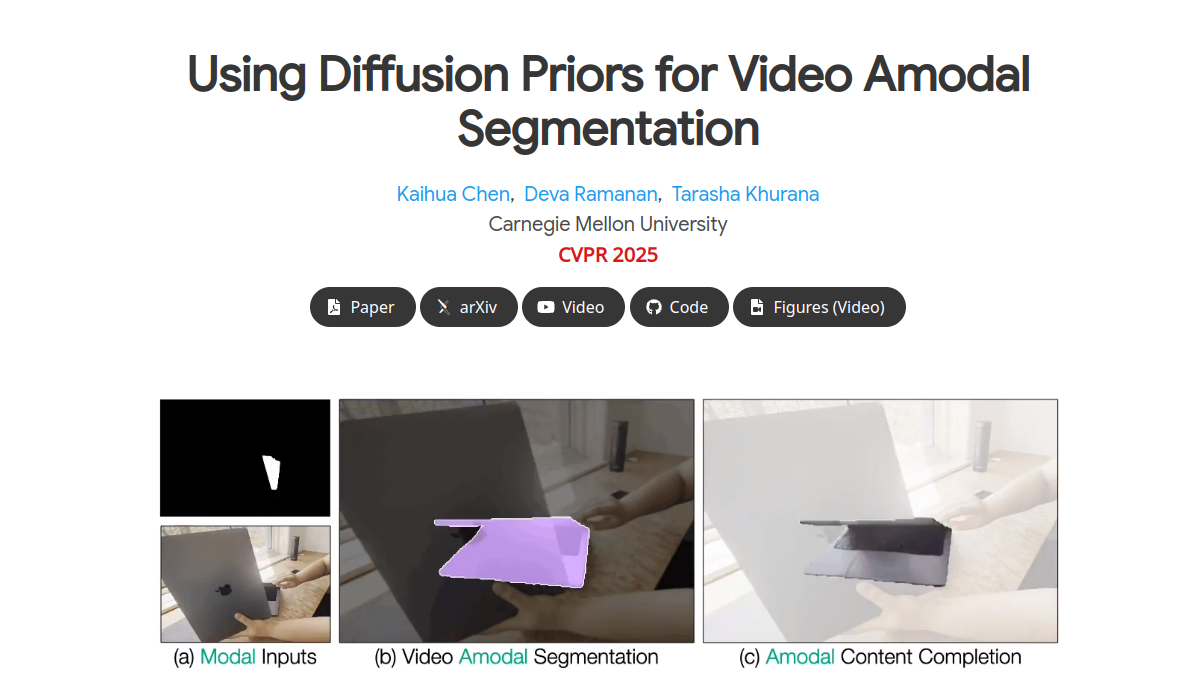
Diffusion-Vas是由卡内基梅隆大学提出的视频非可见物体分割与内容补全技术的官方展示站点,核心定位是面向计算机视觉领域的技术交流与效果演示平台。该站点提供模型技术原理详解、多场景效果可视化演示、论文成果下载三大核心功能,服务于计算机视觉研究者、视频处理开发人员、高校相关专业师生等群体,可用于视频分析算法研究、特效制作中的物体补全开发、视频修复场景的技术选型参考等场景,帮助用户直观理解非可见物体分割技术的实现逻辑与应用价值。
yukangcao.github.io
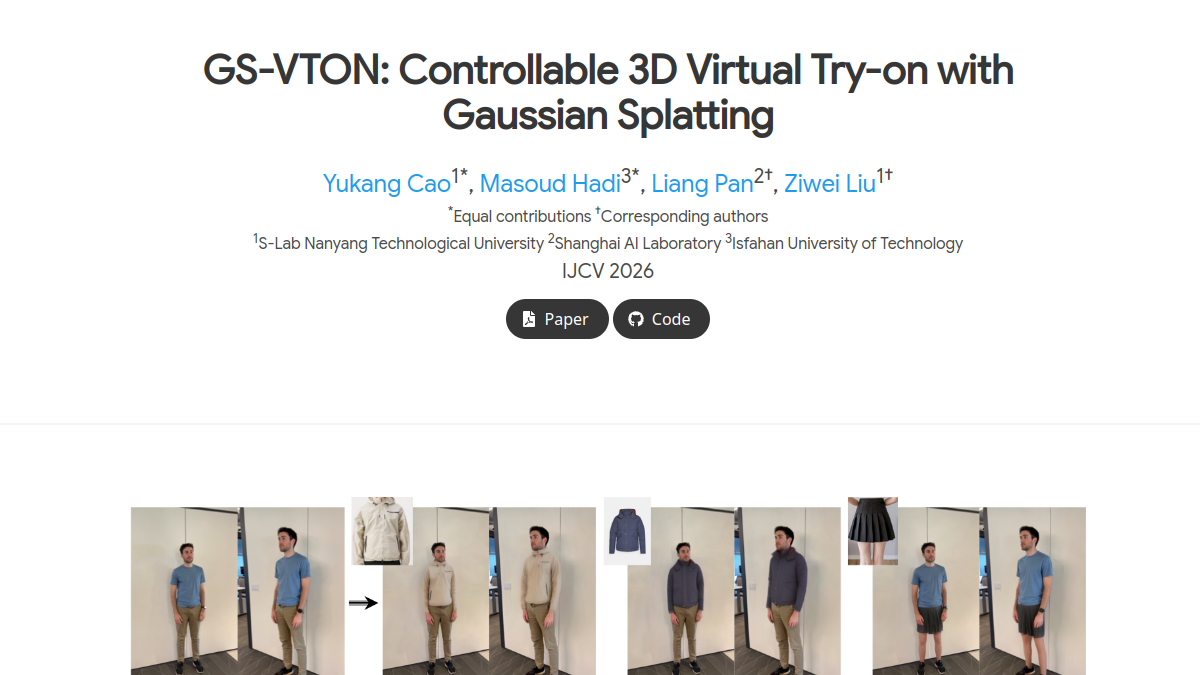
GS-VTON是基于高斯散射技术的3D虚拟试衣学术研究项目站点,核心定位是展示2D到3D虚拟试衣知识迁移的技术方案。站点核心功能包括3D试衣效果多视角可视化、技术原理细节解读、相关实验对比数据展示。目标用户覆盖计算机视觉领域研究者、服装行业技术开发人员、虚拟内容创作从业者,可用于技术选型参考、学术研究调研、相关产品开发方向验证等场景,帮助用户直观了解基于3DGS的虚拟试衣技术实现逻辑与应用潜力。
arxiv.org
Pixel-Aware Stable Diffusion(简称PASD)是发表于arXiv的学术研究成果网站,核心定位为面向计算机视觉领域的扩散模型优化方案,聚焦真实图像超分辨率与个性化风格化任务。核心功能包括像素感知交叉注意力计算、降级不敏感特征提取、现有扩散模型无缝集成三大模块,可帮助相关研究人员与开发者提升图像生成与重建任务的表现。目标用户涵盖计算机视觉领域研究者、AI图像算法开发工程师、图像处理相关从业人员、高校计算机相关专业学生等,适用于图像超分辨率算法迭代、个性化图像风格化工具开发、扩散模型性能优化、学术研究复现验证等多种场景。
personalized-restoration.github.io
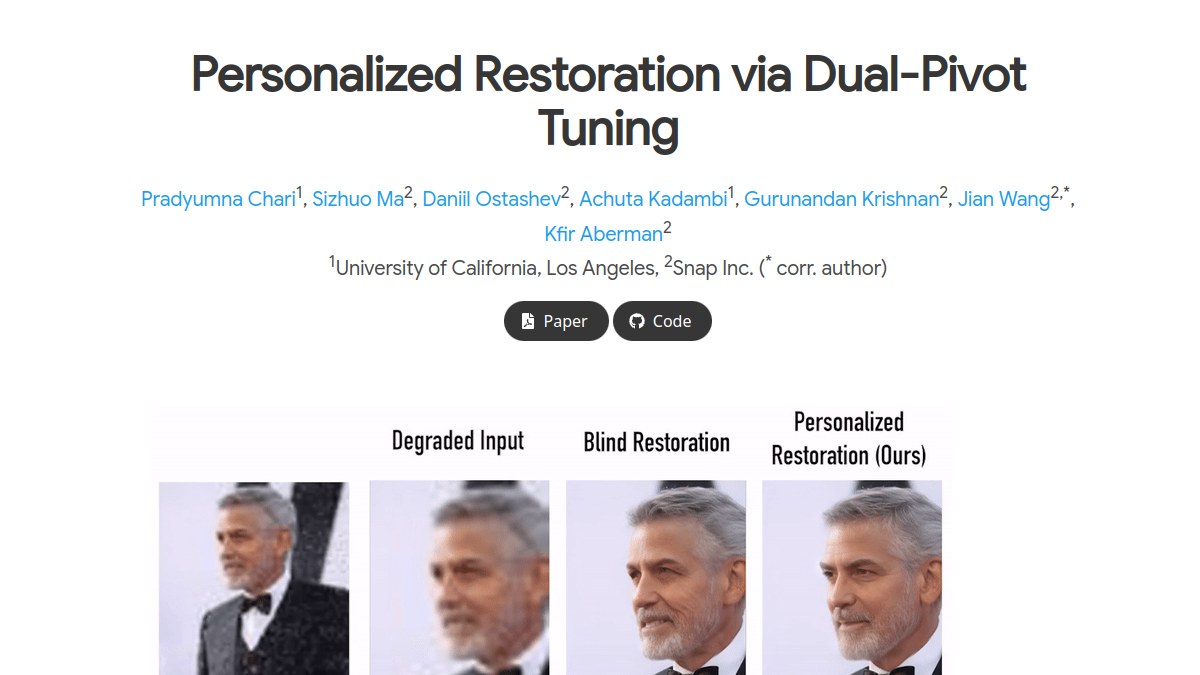
Personalized Restoration via Dual-Pivot Tuning是双枢纽调谐个性化图像复原技术的官方演示与论文资源站点,核心定位为学术研究成果的可视化展示与技术落地参考。站点核心功能包括双枢纽调谐算法原理可视化展示、个性化面部复原效果对比演示、完整论文与开源代码资源下载。目标用户覆盖计算机视觉领域研究人员、图像修复算法开发者、数字影像处理从业人员、高校相关专业师生。可用于学术研究参考、算法选型对比、课程案例学习、实际图像复原业务的技术迭代参考等场景。

ai.meta.com
Imagine Flash是Meta Research推出的扩散模型加速技术研究站点,核心定位是公布基于后向蒸馏的扩散模型优化方案。核心功能包括后向蒸馏框架的技术原理展示、动态知识转移机制的实验数据公开、噪声校正技术的效果对比,目标用户覆盖AI图像生成领域的研究人员、算法开发工程师、高校计算机专业师生,使用场景包括优化现有文生图模型的生成效率、低步骤图像生成方案的学术研究、扩散模型落地应用的性能提升参考。