
ManyPI
ManyPI是一款专注于网页转API的AI工具,核心定位是帮助用户快速将任意网站转换为结构清晰、类型安全的编程接口,无需复杂的后端开发流程。其核心功能包括网页智能识别解析、自动生成多语言类型定义、API请求一键调试,目标用户覆盖前端开发人员、数据分析师、产品原型开发人员等群体,可应用于快速搭建第三方数据对接接口、批量获取公开网页数据、快速验证产品数据链路等场景,降低开发者获取结构化网页数据的技术门槛。

Browse AI
Browse AI 是一款无需代码能力即可使用的网页数据自动化采集与监测平台,核心定位是降低网页数据获取的技术门槛,帮助用户完成各类网页信息的批量提取与动态追踪。平台支持自定义数据提取规则、定时监测网页内容变化、API对接数据导出三大核心功能,面向商业分析人员、市场调研人员、内容运营人员、中小商家等群体,可应用于竞品价格追踪、公开行业数据收集、资讯内容聚合、招聘信息汇总等多种场景,无需编写爬虫代码即可完成传统需要技术团队支持的数据获取工作。

AnyCrawl
AnyCrawl是一款专注于网页数据结构化提取的高性能API服务,核心定位是将任意网页内容转换为适配AI与大语言模型的规整结构化数据。其核心功能包括全类型网页内容爬取、结构化数据自动格式化、LLM友好的数据输出优化,支持静态网页、动态渲染页面、登录态页面等多种复杂网页场景的内容提取。目标用户覆盖AI应用开发者、数据分析师、内容运营人员、科研人员等群体,可用于大语言模型训练数据采集、行业情报批量整理、公开内容合规汇总、学术研究数据获取等多个使用场景,帮助用户减少网页爬虫开发与数据清洗的工作量。
ScrapeOps
ScrapeOps是面向爬虫开发人员的网页抓取辅助平台,可帮助开发者完成爬虫的构建、测试与全生命周期管理。平台内置AI驱动的数据提取工具,支持动态网页反爬应对、爬虫运行状态实时监控、抓取数据质量校验等核心能力,可覆盖从爬虫原型开发到大规模部署运维的全流程需求,为网页数据采集项目提供标准化的技术支撑方案,适合各类需要开展网页数据抓取工作的开发团队与个人开发者使用。
CragData
CragData是面向AI开发场景的网页数据采集与结构化处理平台,核心定位是为AI智能体和RAG检索增强生成 pipeline 提供可直接调用的高质量网页数据源。平台支持大规模动态网页实时爬取、网页链接关系图谱构建,同时内置反爬绕过机制,可将非结构化网页内容转换为标准化JSON格式并通过REST API输出。目标用户覆盖AI应用开发者、大模型训练数据运营人员、RAG系统搭建工程师等群体,可应用于大模型训练数据集扩充、RAG知识库实时更新、行业情报动态监测、网页内容批量结构化存储等多个场景,降低开发者在网页数据采集环节的技术投入成本。
Damn Good Search
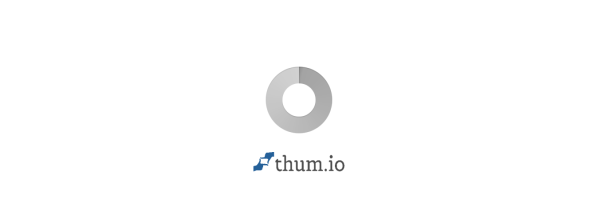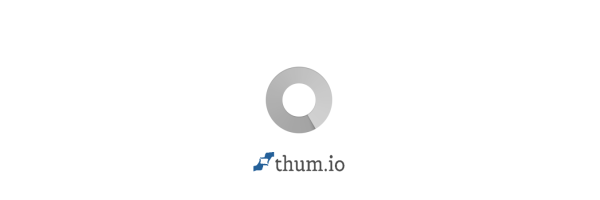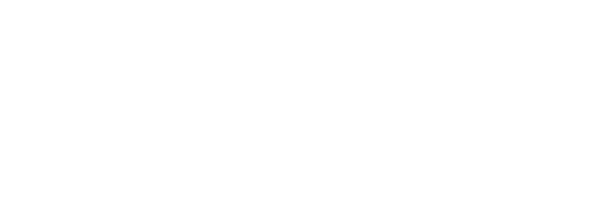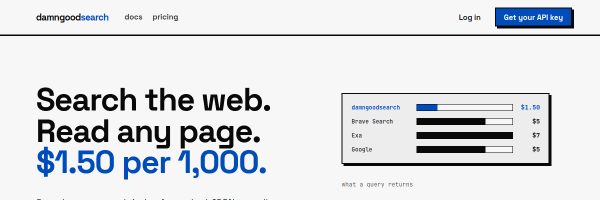
Damn Good Search 是面向AI开发场景的网页检索API服务平台,核心定位是为AI智能体、RAG系统开发者提供稳定的网页数据获取与处理能力。平台拥有自主搭建的网页索引库,支持直接返回排序后的结构化JSON检索结果,同时可将任意网页内容转换为纯净的Markdown格式,定价低于Brave、Exa、Google等同类检索API服务。适合AI应用开发者、大模型应用搭建团队、数据分析师等群体,在搭建RAG知识库、AI智能体网页搜索模块、批量网页内容采集等场景下使用。
Firecrawl
Firecrawl 是由 Mendable 推出的网页上下文API服务,核心定位是为AI智能体提供网页数据获取与处理能力,可将任意网页资源转换为格式规整的Markdown内容或结构化数据。其核心功能包括全链路网页搜索爬取、智能内容解析转换、实时网页交互数据采集,目标用户覆盖AI应用开发者、数据分析师、内容运营人员、学术研究人员等群体,可应用于AI知识库构建、市场竞品数据采集、学术文献内容整理、内容聚合平台素材获取等多种场景,帮助用户降低网页数据处理的技术门槛,提升数据获取效率。
Browser Use
作为开源AI浏览器自动化框架,专注于为开发者和RPA场景提供AI驱动的浏览器操作能力,支持自主导航网页、表单填写、数据提取等功能,搭配反检测、多LLM适配、全球代理等特色能力,广泛用于网页搜索、在线购物、数据采集、网站测试等场景。
TikTok Captcha Solver API
SadCaptcha是专注于TikTok场景验证码识别服务的API工具,核心定位是为开发者、自动化运维人员提供稳定的验证码解析接口支持。核心功能包括TikTok旋转验证码识别、TikTok滑动拼图验证码识别、TikTok 3D形状验证码识别三类主流验证码解析服务,支持多端适配与不同屏幕分辨率兼容。目标用户覆盖跨境运营从业者、自动化测试工程师、爬虫开发人员、电商数据采集人员等群体,可应用于TikTok账号批量管理、平台数据合规采集、自动化流程测试、多账号批量运维等需要高频处理验证码的场景,帮助减少人工操作成本,提升自动化流程的运行稳定性。
Autotab
Autotab是专注于浏览器自动化流程搭建的工具,基于Python语言开发,可帮助用户完成各类网页操作的自动化配置。核心功能包含可视化流程录制、多场景网页操作自动化、自定义Python脚本扩展三大模块,面向需要重复执行网页操作的个人开发者、企业运营、数据分析人员等群体,适用于数据采集、表单批量填写、网页功能测试、内容定期巡检等工作场景,无需编写复杂代码即可完成自动化流程的部署。
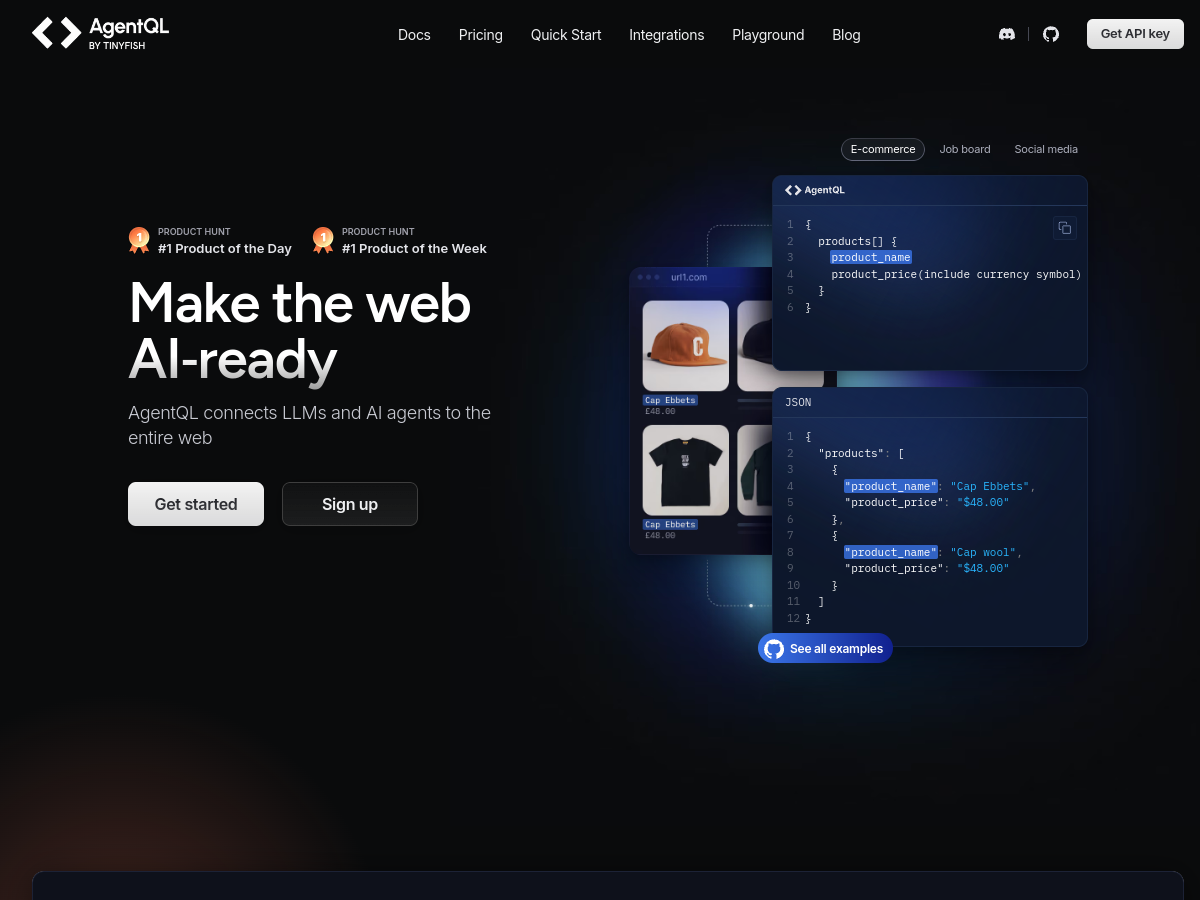
AgentQL
AgentQL是面向网页数据提取与自动化操作场景的AI开发工具,核心通过自研的AgentQL查询语言,降低网页交互开发的技术门槛。其核心功能包括自然语言网页元素定位、多端开发接口支持、Chrome扩展可视化操作,目标用户覆盖web开发人员、数据分析师、自动化测试工程师等群体,可用于电商商品信息爬取、业务流程自动化搭建、web应用端到端测试等多个场景,无需依赖复杂的DOM结构分析即可完成网页操作开发。

Keet
Keet是专注于网页操作自动化的API服务平台,核心定位是帮助开发者无需依赖浏览器扩展即可实现跨网站的操作自动化与数据获取。平台支持用户账号关联授权、RESTful API标准化集成、自定义场景适配三大核心功能,面向需要跨站数据整合、业务流程自动化的开发者、企业技术团队与 SaaS 服务商,可应用于跨平台用户数据同步、企业内部多系统工作流串联、第三方服务功能扩展等多种场景,降低自动化方案的开发与维护成本。
WebscrapeAi
Webscrape Ai是一款无代码自动化网页数据采集工具,核心定位是降低数据抓取的技术门槛,帮助用户快速获取结构化网页数据。其核心功能包括AI智能字段识别、批量网页采集、自定义采集规则配置,目标用户覆盖市场调研人员、电商运营、行业分析师、学术研究者等群体,可应用于竞品价格监测、公开资讯收集、电商商品信息汇总、行业数据统计等多种场景,无需掌握编程技能即可完成数据采集工作。

Steel
Steel是一个开源的无头浏览器API服务,核心定位是为开发者提供云端浏览器集群调度能力,支持用户通过API调用快速创建浏览器会话,内置验证码自动处理、代理管理、浏览器指纹自定义等功能,面向需要开展网页数据采集、自动化测试、业务流程模拟的开发者与技术团队,可应用于大规模网页内容抓取、自动化功能测试、跨站业务批量操作等场景,降低云端浏览器自动化任务的部署与运维成本。

SingleAPI
SingleAPI是一款基于GPT技术驱动的API生成工具,核心定位是帮助用户快速将任意网页转换为结构化API接口。其核心功能包括无选择器网页数据抽取、自动API生成、实时数据同步,支持用户无需编写复杂的网页解析代码即可获取目标站点的结构化数据。目标用户覆盖后端开发人员、数据分析师、产品运营、市场调研人员等群体,可应用于竞品数据采集、行业信息汇总、业务数据补全、内容聚合平台搭建等多个场景,降低网页数据获取的技术门槛,提升数据采集效率。


x-crawl
x-crawl是一款基于Node.js开发的AI辅助爬虫库,核心定位是为开发者提供高效智能的网页与数据爬取解决方案。其核心功能包括多类型数据源爬取、页面自动化操作控制、多场景爬取策略适配三类,支持静态页面、动态渲染页面、API接口、文件等多种数据源的爬取,同时提供页面点击、键盘输入、事件触发等交互控制能力,还内置设备指纹模拟、失败重试、代理轮换等实用机制。该工具面向Node.js技术栈开发者、数据分析师、企业技术团队等用户,可满足市场调研数据采集、公开信息汇总、内容库搭建、业务数据监控等多种场景的爬取需求。
No-Code Scraper
No-Code Scraper是一款面向无代码基础用户的网页数据提取工具,核心定位是降低网页数据采集的技术门槛,让用户无需编写爬虫代码即可完成多类型网页数据的收集工作。平台核心功能包括基于大语言模型的智能字段识别、自定义数据导出规则、动态网页内容适配、定时采集任务调度、采集结果云端存储等。工具面向市场调研人员、内容创作者、电商运营从业者、学术研究人员、数据分析人员等群体,可应用于竞品价格监测、公开信息汇总、行业研究数据收集、电商商品信息整理、内容素材批量采集等多种场景,用户仅需通过简单的可视化操作即可完成整个数据采集流程。
Hyperbrowser
Hyperbrowser是面向AI智能体与Web自动化场景打造的云浏览器平台,基于安全隔离的容器架构提供无头浏览器运行与扩展能力。平台核心功能包括大规模会话快速部署、多AI框架原生适配、内置反检测绕过机制,目标用户为AI开发者、后端工程师、数据采集从业者,可应用于AI智能体网页交互训练、公开网络数据抓取、Web应用自动化测试、批量数据预处理等场景,帮助用户省去本地浏览器基础设施搭建与运维成本,聚焦核心业务逻辑开发。
关于AI 网络爬虫
AI网络爬虫类工具是融合人工智能技术的自动化网页数据采集工具,主要解决传统爬虫面临的反爬拦截、非结构化数据提取效率低、动态页面渲染适配难等问题,典型使用场景涵盖电商竞品价格监控、行业公开资讯聚合、学术研究数据批量采集、公共舆情信息汇总等,能大幅降低人工复制整理网页信息的时间成本。
这类工具的形态和能力存在明确差异,部分通用型产品主打低代码可视化配置,适配多数普通网页的基础采集需求,操作门槛较低;垂直类产品则针对特定场景优化,比如侧重验证码自动破解、分布式代理IP调度、大语言模型驱动的语义化数据提取等专项能力。定价模式上多数工具提供基础免费额度供用户测试单页采集、少量数据爬取的功能,进阶的高并发爬取、海量数据导出、专属代理池等能力则需开通付费权限。
选型时可参考三条可操作建议:若仅需采集少量静态公开网页数据,优先选择支持可视化配置的轻量工具,无需额外学习代码即可快速上手;若目标站点存在高强度反爬机制,可优先匹配集成验证码破解、代理调度能力的专项爬虫工具,降低爬取失败概率;若需要从非结构化网页内容中直接提取结构化业务数据,可选择搭载大模型语义解析能力的产品,减少后续数据清洗的工作量。
AI 网络爬虫常见问题
AI爬虫工具怎么选
可按自身爬取需求匹配,轻量采集选可视化低代码款,遇强反爬选带验证码破解、代理调度的专项款,需直接输出结构化数据选搭载大模型语义解析的产品。
AI爬虫工具免费还是收费
多数AI网络爬虫工具提供基础免费额度,可满足少量静态页面爬取、功能测试的需求,高并发、海量采集、专属代理池等进阶能力需开通付费权限使用。
AI爬虫工具适合谁用
适合电商运营人员做竞品价格监控、科研人员批量采集公开研究数据、内容运营人员聚合行业资讯、数据分析师快速获取公开维度的行业参考数据使用。