
Browserbear
Browserbear是一款基于人工智能技术的网页自动化操作工具,核心定位是帮助用户无需编写复杂代码即可完成网页数据抓取、流程自动化执行等操作。其核心功能包括无代码自动化任务搭建、网页内容批量截取提取、多应用生态集成对接,面向商业分析师、运营人员、测试工程师、内容创作者等群体,可应用于竞品数据定期收集、业务表单自动提交、网站功能回归测试、公开信息批量整理等多种场景,帮助用户降低网页操作类工作的人力投入,提升重复任务的执行效率。

Keet
Keet是专注于网页操作自动化的API服务平台,核心定位是帮助开发者无需依赖浏览器扩展即可实现跨网站的操作自动化与数据获取。平台支持用户账号关联授权、RESTful API标准化集成、自定义场景适配三大核心功能,面向需要跨站数据整合、业务流程自动化的开发者、企业技术团队与 SaaS 服务商,可应用于跨平台用户数据同步、企业内部多系统工作流串联、第三方服务功能扩展等多种场景,降低自动化方案的开发与维护成本。

Hexomatic
Hexomatic是一款主打网络爬虫与工作流自动化的云服务平台,核心定位是帮助用户将互联网作为可调用的数据源,一站式完成多类数字化任务。平台内置100+预制自动化模板,支持无代码网页数据抓取、结构化数据提取、多规则数据清洗,以及跨工具工作流串联功能。目标用户覆盖市场调研人员、销售获客从业者、电商运营人员、内容创作者、学术研究者以及中小团队运营管理者。可应用于竞品公开信息收集、目标客户线索批量获取、电商商品价格动态监测、公开内容批量整理、行业研究数据汇总等多种场景,减少重复手动操作,提升任务处理效率。

Handinger
Handinger是专注于网页内容结构化提取的云服务平台,核心定位为开发者提供低门槛、高可用的网页数据采集接口。核心功能包括多格式网页内容提取、高并发请求支持、全类型网站适配,可满足不同场景下的网页数据获取需求。目标用户覆盖后端开发人员、AI训练数据运营人员、内容存档从业者、数据分析人员等,适用于大语言模型训练数据集构建、网页内容批量存档、行业资讯定向采集、竞品公开信息汇总等多种场景,无需复杂配置即可快速接入使用。
WebscrapeAi
Webscrape Ai是一款无代码自动化网页数据采集工具,核心定位是降低数据抓取的技术门槛,帮助用户快速获取结构化网页数据。其核心功能包括AI智能字段识别、批量网页采集、自定义采集规则配置,目标用户覆盖市场调研人员、电商运营、行业分析师、学术研究者等群体,可应用于竞品价格监测、公开资讯收集、电商商品信息汇总、行业数据统计等多种场景,无需掌握编程技能即可完成数据采集工作。

GoLess Extension Automation
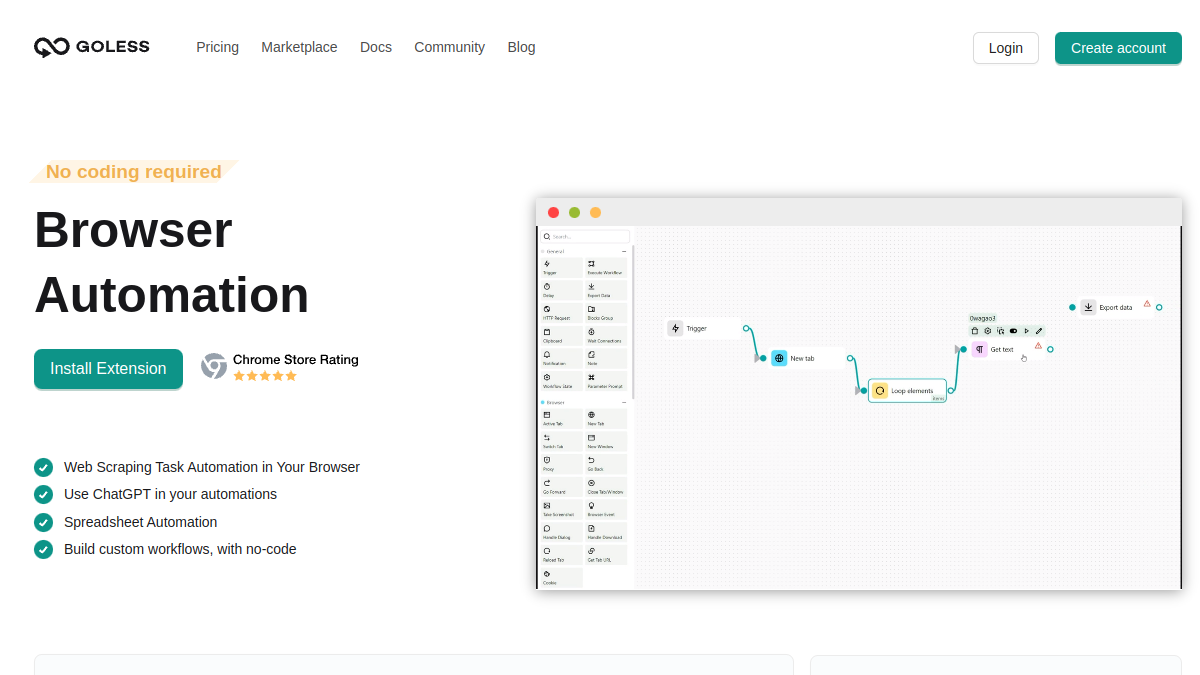
GoLess Extension Automation 是一款面向浏览器场景的无代码Web自动化工具,以浏览器插件为载体,用户无需掌握编程技能即可配置各类重复浏览器操作的自动化流程。其核心功能包含可视化流程编排、网页数据爬取、多系统任务联动,适合职场办公人员、数据采集从业者、新媒体运营人员等群体使用,可应用于批量表单填写、竞品数据定期采集、跨平台内容同步发布、日常打卡签到等多种需要重复操作浏览器的场景,帮助用户减少机械操作时长,提升工作效率。


FlowScraper
FlowScraper是一款面向无编程基础用户的网页数据抓取工具,核心定位是降低网页数据采集的技术门槛,帮助不同领域的用户高效获取公开网页数据。其核心功能包括拖放式工作流编辑器、自动化数据采集调度、内置反机器人规避机制,无需掌握代码知识即可完成复杂的抓取任务。该工具面向市场研究人员、内容创作者、电商运营者、数据分析从业者、中小企业管理者等群体,可用于竞品价格监测、公开信息汇总、行业数据调研、内容素材收集、商机线索获取等多个场景,帮助用户解决数据采集效率低、数据可靠性不足的问题。

Steel
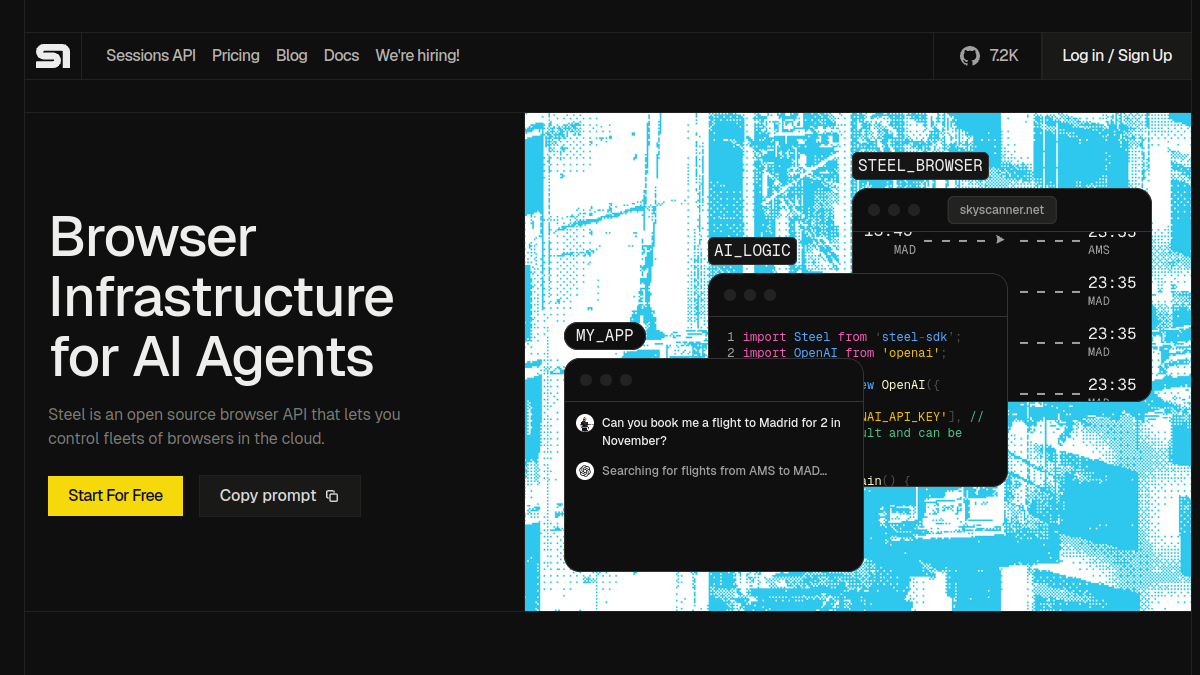
Steel是一个开源的无头浏览器API服务,核心定位是为开发者提供云端浏览器集群调度能力,支持用户通过API调用快速创建浏览器会话,内置验证码自动处理、代理管理、浏览器指纹自定义等功能,面向需要开展网页数据采集、自动化测试、业务流程模拟的开发者与技术团队,可应用于大规模网页内容抓取、自动化功能测试、跨站业务批量操作等场景,降低云端浏览器自动化任务的部署与运维成本。
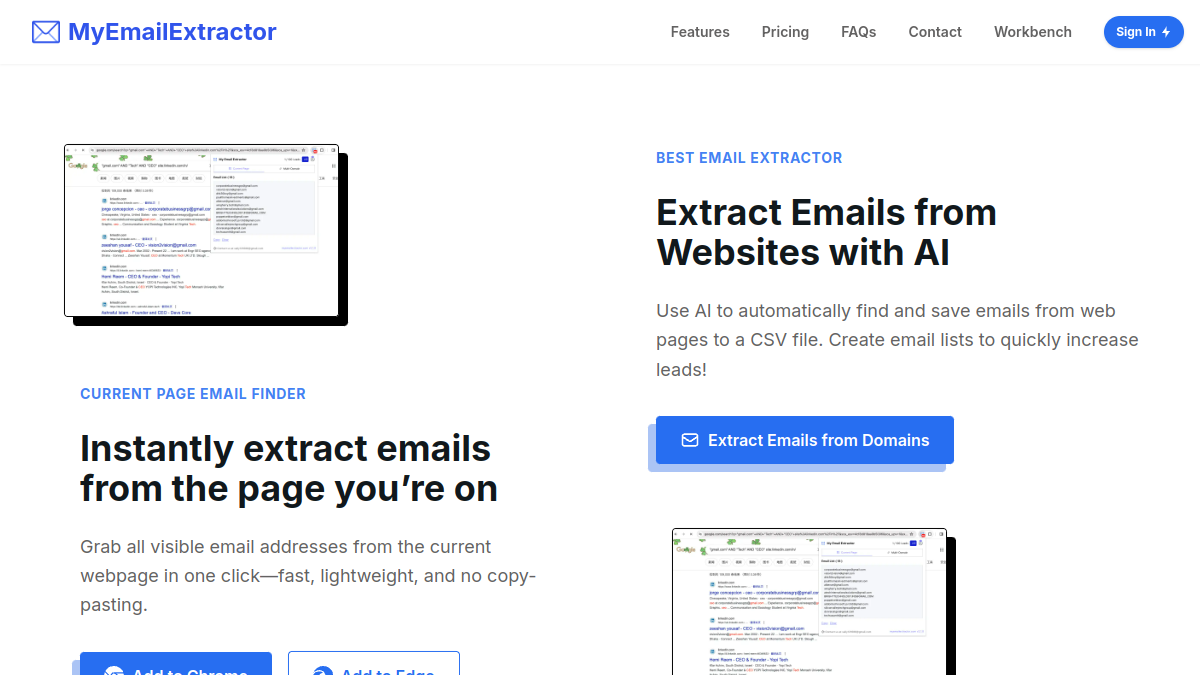
Free Email Extractor from Website
Free Email Extractor from Website是一款专注于网页信息提取的在线工具,核心定位为帮助用户从指定网页中批量获取有效联系方式。其核心功能包括网页邮箱地址批量提取、电话号码识别抓取、社交平台账号信息采集,同时支持输入域名进行全域联系方式检索。目标用户覆盖市场营销人员、商务拓展从业者、客户关系管理人员、学术调研人员等群体,可用于潜在客户线索收集、行业调研联系方式汇总、商务合作资源整理、调研对象联络信息采集等多个场景,无需下载客户端,打开浏览器即可使用。

SingleAPI
SingleAPI是一款基于GPT技术驱动的API生成工具,核心定位是帮助用户快速将任意网页转换为结构化API接口。其核心功能包括无选择器网页数据抽取、自动API生成、实时数据同步,支持用户无需编写复杂的网页解析代码即可获取目标站点的结构化数据。目标用户覆盖后端开发人员、数据分析师、产品运营、市场调研人员等群体,可应用于竞品数据采集、行业信息汇总、业务数据补全、内容聚合平台搭建等多个场景,降低网页数据获取的技术门槛,提升数据采集效率。


x-crawl
x-crawl是一款基于Node.js开发的AI辅助爬虫库,核心定位是为开发者提供高效智能的网页与数据爬取解决方案。其核心功能包括多类型数据源爬取、页面自动化操作控制、多场景爬取策略适配三类,支持静态页面、动态渲染页面、API接口、文件等多种数据源的爬取,同时提供页面点击、键盘输入、事件触发等交互控制能力,还内置设备指纹模拟、失败重试、代理轮换等实用机制。该工具面向Node.js技术栈开发者、数据分析师、企业技术团队等用户,可满足市场调研数据采集、公开信息汇总、内容库搭建、业务数据监控等多种场景的爬取需求。
Scrapegraph-ai
Scrapegraph-ai是基于Python开发的网络抓取库官方文档站,核心定位是帮助开发者借助大语言模型与图逻辑能力,快速构建网站、文档、XML类文件的自动化数据抓取管道。核心功能包括多源数据源的智能抓取适配、自定义抓取规则的灵活配置、抓取结果的结构化输出。目标用户覆盖数据分析师、爬虫开发工程师、学术研究人员等群体,可应用于市场调研数据采集、公开数据集整理、竞品信息合规收集等场景,降低传统爬虫开发的代码编写成本,提升数据提取的匹配精度。

Kadoa
Kadoa是基于生成式AI技术的无代码网页数据采集工具,核心定位是降低网页数据抓取的技术门槛,帮助用户无需编写代码即可快速获取网页结构化数据。核心功能包括AI自动识别网页数据结构、自定义采集规则配置、采集数据自动格式化导出。目标用户覆盖运营人员、市场调研人员、数据分析从业者、中小企业管理者等群体,适用于竞品信息收集、公开市场数据调研、内容素材汇总、行业动态监测等多种场景,可大幅缩短传统数据采集的流程周期。
WebWalker
WebWalker是由阿里巴巴集团通义实验室开发的多智能体框架,核心定位是评估大型语言模型在网页遍历任务中的表现,可模拟人类浏览网页的行为逻辑,通过探索与评估相结合的范式系统提取高质量网页数据,支持深入挖掘多层级网页信息,可帮助研究人员优化大模型信息检索能力,适用场景包括大模型开放域问答能力优化、多步骤信息检索场景模拟、网页数据结构化提取研究等,目标用户覆盖大模型研发人员、自然语言处理研究者、信息检索领域从业者等群体。

Stagehand.dev
Stagehand.dev是一个面向开发者的AI网页自动化框架平台,核心是为Playwright网页自动化工具提供自然语言交互扩展能力。平台支持自然语言指令转网页操作、智能页面元素识别、自动化流程生成、错误自动重试、操作日志回溯等功能,主要服务于前端开发、测试工程师、RPA开发人员、运维人员、产品经理等群体,可应用于网页自动化测试脚本开发、重复性网页操作批量处理、网页数据抓取、多场景页面功能验证、网页操作流程复刻等场景,帮助使用者降低网页自动化开发的代码编写成本,提升自动化流程的搭建效率。
FetchFox
FetchFox 是一款基于人工智能技术的网页数据抓取工具,以Chrome浏览器插件为载体,支持用户通过自然语言指令完成网页数据提取工作。其核心功能包括AI驱动的非结构化文本提取、复杂网页结构自动解析、反爬机制绕过适配,主要面向有网页数据收集需求的职场人士、研究人员、创业者等群体,适用于潜在客户列表搭建、行业研究数据采集、细分市场调研、竞品信息汇总等多种场景,无需用户掌握专业爬虫开发技能,即可完成多类型网页的数据提取任务。
rtrvr.ai
rtrvr.ai 是一款AI驱动的网页自动化工具,核心定位是为用户简化网页操作与数据处理流程。核心功能包括自然语言驱动网页导航、网页内容结构化提取、多工具集成任务执行、隐私安全沙盒运行。目标用户覆盖数据分析师、运营人员、开发者、内容创作者、市场调研人员等群体。适用场景包含批量网页数据采集、重复性网页操作自动执行、网页内容结构化整理、跨工具网页任务联动等,帮助用户减少手动网页操作的时间投入。

Firecrawl LLMs.txt generator
Firecrawl LLMs.txt generator是由Firecrawl提供支持的在线llms.txt文件生成工具,核心定位是帮助用户快速从目标网站的结构化文本内容,适配大语言模型训练、RAG系统构建、智能体知识库搭建等场景需求。核心功能包括全站内容自动爬取、内容结构化清洗、llms.txt格式自动适配、自定义内容范围筛选、生成文件一键导出。目标用户覆盖AI开发者、大模型训练研究人员、RAG应用搭建者、网站运营人员等,可用于快速获取特定领域模型训练数据准备、知识库内容结构化处理、智能问答系统内容导入等场景,帮助用户降低内容采集和整理的成本。
Reworkd
Reworkd是基于自研应用层LLM代理技术打造的无代码网页数据提取工具,核心定位是降低网页数据抓取的技术门槛,简化数据采集全流程。它支持自动扫描目标网站结构、智能生成抓取代码、自动运行提取任务并校验数据结果,可适配多数静态及动态网页的数据采集需求。目标用户覆盖需要批量获取网页数据的企业运营人员、数据分析从业者、开发者、市场调研人员等,可应用于竞品信息采集、公开行业数据汇总、内容素材收集、市场舆情监测、供应链信息整理等多个场景,减少手动编写、维护爬虫脚本的工作量。

Forloop
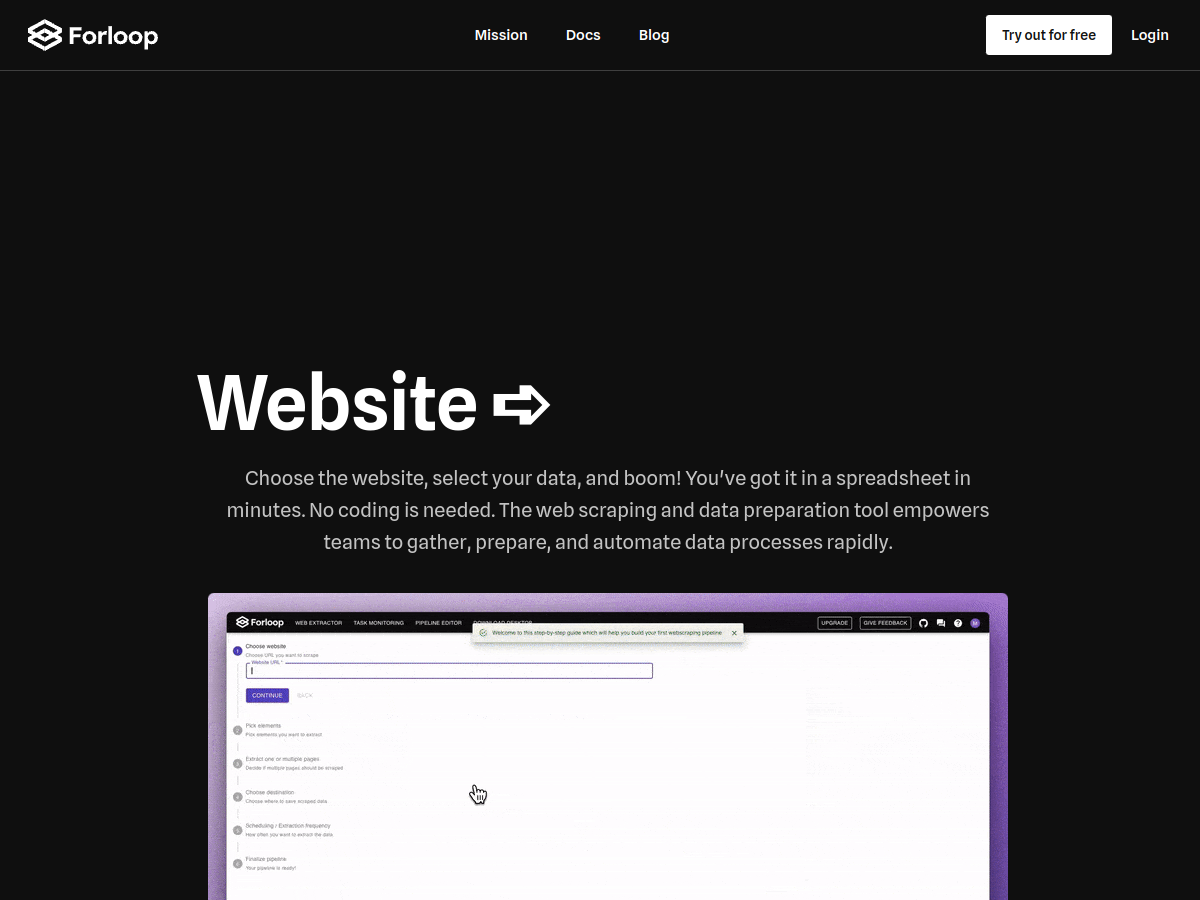
Forloop 是面向数据团队的无代码网页抓取与数据自动化平台,核心定位是降低数据采集和流程搭建的技术门槛。平台支持多数据源接入、可视化数据管道编排、AI 辅助数据清洗三类核心功能,主要服务于 AI 初创企业、具备机器学习产品的企业、数据分析师团队、市场调研团队等用户,可应用于公开信息采集、业务数据集搭建、日常数据报表自动更新、竞品信息动态追踪等多种场景,无需复杂代码开发即可完成端到端的数据处理流程搭建。