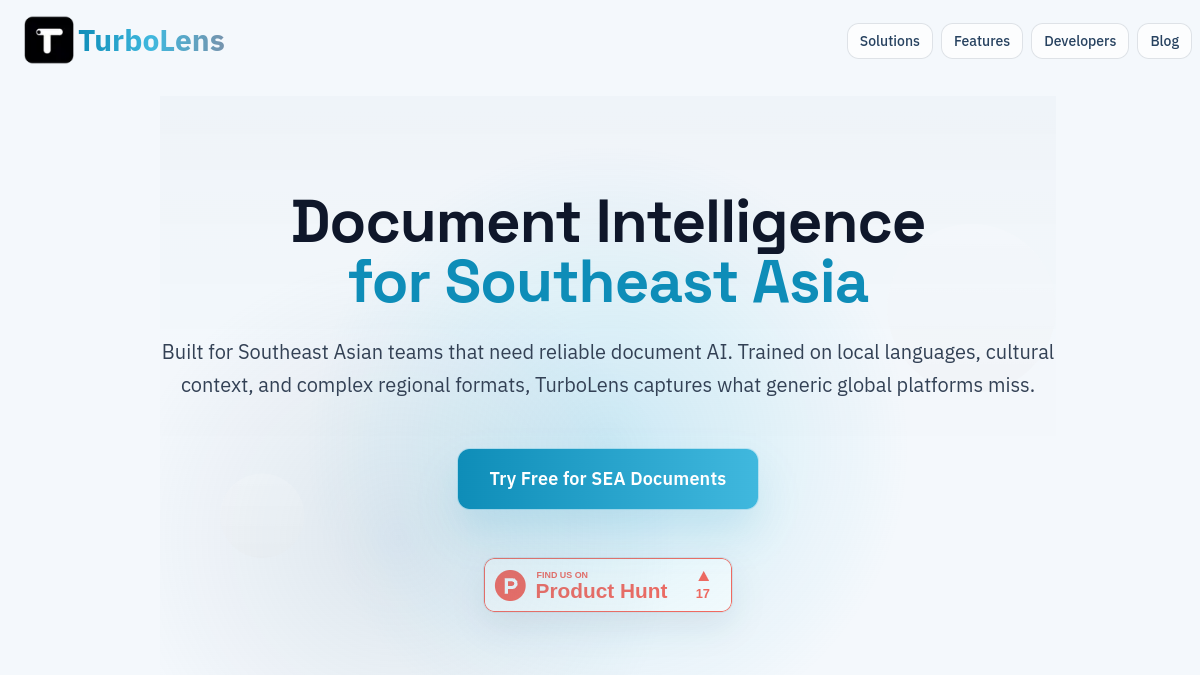
TurboLens是集成OCR、计算机视觉与生成式AI的图像内容处理平台,核心定位为将非结构化图像中的信息转化为可复用结构化数据。核心功能包含多类型文档识别、结构化内容转换、多语言翻译分析三个模块,支持印刷文本、手写文档、数学公式、表格等多种图像内容的解析。目标用户覆盖学术研究者、办公人员、学生、内容编辑等群体,可满足文献整理、办公文档数字化、作业公式转换、多语言资料翻译等多场景使用需求,帮助用户减少手动录入工作量,优化信息处理流程。
- 运营状态
- 正常运营
- 地址
- turbolens.io
- 定价模式
- 基础功能免费
- 支持平台
- Web 网页
- 是否开源
- 闭源
- 适合人群
- 学术研究者、高校学生、企业办公人员、翻译工作者
- 收录时间
- 2026/6/14
- 访问量
- 0 次
编辑点评
在图像内容结构化处理类工具中,这款产品的综合能力表现突出,它没有将功能局限在常规的文字OCR识别,而是覆盖了办公、学习中常见的多种非结构化图像处理需求。对于学术群体来说,手写公式识别转LaTeX的功能可以解决很多论文写作中的录入难题,识别准确率在同类产品中处于前列,复杂公式的结构还原度较高。对于办公群体来说,表格识别直接导出Excel的功能可以省去大量手动重建表格的时间,尤其是合并单元格、多表头的复杂表格也能较好还原。同时它集成的生成式AI分析功能,可以直接对识别后的内容进行翻译、摘要,不需要用户再切换到其他工具处理,整个流程连贯度较高。另外它支持批量处理功能,对于有大量资料需要数字化的用户来说,能够有效降低重复操作的工作量,不同档位的付费计划也可以满足个人、团队等不同规模的使用需求,适合有高频图像内容处理需求的用户选择。
核心功能
使用指南
- 1
打开TurboLens官网https://turbolens.io,点击页面首页的注册/登录按钮,使用邮箱账号完成账号注册并登录,新用户可先查看平台的功能演示示例了解基础操作。
- 2
根据需要处理的内容类型选择对应功能入口,可选文本识别、公式识别、表格识别、批量处理等不同功能模块,进入对应处理页面。
- 3
点击页面上传按钮,选择需要处理的图像或PDF文件上传,支持JPG、PNG、PDF等常见格式,上传时可调整图像的旋转角度、裁剪不需要的区域。
- 4
等待系统完成处理,处理完成后可在线预览识别结果,核对内容准确性,若存在识别误差可手动编辑修正,也可选择AI翻译、摘要等附加处理功能。
- 5
确认结果无误后,选择需要的导出格式,点击导出按钮即可下载处理后的文件,也可将处理记录保存在账号云端,后续可随时查看调用。
优势与不足
优点4 项
"支持手写公式、复杂表格等非常规内容的识别,覆盖更多细分场景需求"
"识别后可直接进行AI翻译、摘要分析,无需跳转其他工具即可完成全流程处理"
"支持批量上传多页PDF或多张图像,可批量导出结果,提升大量资料处理效率"
"导出格式丰富,文本、LaTeX、Excel、CSV等格式均可直接导出,适配不同工具需求"
不足4 项
"免费版的单日处理次数和单文件大小有较多限制,仅适合低频轻度使用"
"手写内容识别准确率受字迹工整度影响较大,潦草手写内容的识别误差较高"
"自定义识别规则功能仅向高端付费计划开放,普通付费用户无法使用该功能"
"部分小语种的识别支持不足,小语种手写内容基本无法准确识别"
定价说明
TurboLens采用免费加付费的订阅模式,免费版用户单日最多可处理5个文件,单文件大小不超过10MB,仅支持基础的文本、简单公式和表格识别,无批量处理和AI分析功能,适合低频轻度使用的个人用户。付费版分为基础版、专业版和团队版三个档位,基础版月付12美元,年付108美元,单日可处理50个文件,单文件支持最大50MB,开放AI翻译和摘要功能,适合普通学生和办公人员使用;专业版月付29美元,年付261美元,无单日处理数量限制,单文件最大200MB,支持批量处理功能,适合高频处理资料的学术研究者和内容从业者;团队版价格根据团队人数自定义,开放自定义识别规则和团队共享空间,适合企业和机构用户选购。
价格和授权政策可能变化,请以官网最新信息为准
适合人群与场景
- 学术研究者
文献资料数字化场景
- 高校学生
作业公式编辑场景
- 企业办公人员
文档表格转换场景
- 翻译工作者
多语言图像资料翻译场景
- 档案管理员
纸质档案批量录入场景
- 内容编辑
纸质素材内容提取场景
- 教师
课件制作公式编辑场景
- 财务人员
票据表格识别导出场景
常见问题
深度了解
在日常学习和工作中,很多用户都会遇到需要将图像中的内容转化为可编辑数据的场景,比如文献中的公式需要录入到论文里、纸质表格需要转换成电子表格、手写笔记需要整理成电子文档等,手动录入不仅耗时还容易出错,TurboLens就是针对这类需求推出的综合处理平台。TurboLens的核心能力围绕非结构化图像的结构化处理展开,基础的OCR功能支持印刷文本、手写文本的多语种识别,可快速输出可编辑的文本内容;针对学术群体的需求,它支持手写和印刷公式的识别,直接转换为LaTeX代码,用户可直接导入论文编辑工具中使用,复杂公式的结构还原度较高,能够减少手动录入公式的工作量;针对办公场景,它的表格识别功能支持复杂表头、合并单元格的表格还原,直接导出为Excel或CSV格式,无需手动重建表格结构。同时TurboLens还集成了生成式AI能力,识别后的内容可直接进行多语种翻译、摘要提取、关键词梳理,不需要切换多个工具即可完成全流程处理。它支持批量上传多张图像或多页PDF,适合大量资料的数字化处理场景,用户可根据自身使用频率选择不同的订阅计划,免费版可满足低频轻度使用需求,付费版开放更多功能和更高额度,适配个人、团队等不同规模的使用需求。目前TurboLens可直接通过官网访问,无需下载安装客户端,浏览器打开即可使用,操作流程简单,上传文件后即可自动完成处理,适合有图像内容处理需求的各类用户使用。
Ready to try
准备好体验 TurboLens 了吗?
点击下方按钮在新标签页打开官网,开始探索它的全部功能。
相关工具

GPTOCR
免费GPTOCR是专注于文档结构化转换的自动化处理工具,核心定位是将非结构化的文档内容提取并转化为标准化JSON格式。其核心功能包括多格式文档识别、结构化字段自定义配置、批量文件处理,支持PDF、图片、扫描件等多种常见文档类型的内容解析,可根据用户需求设定需要提取的字段和输出结构。目标用户覆盖企业行政、财务、数据运营、法务等需要处理大量文档的岗位,适用于发票信息录入、合同字段提取、调研问卷数据汇总、业务表单数字化等场景,能够降低人工录入的出错概率,提升文档信息处理的效率。

Datalab.to
免费Datalab.to是专注于文档智能处理的开源AI工具平台,核心定位是为开发者、企业及相关从业者提供高性能的文档处理AI模型服务。平台核心功能包括高精度OCR识别、文档布局智能分析、PDF格式转Markdown导出,支持批量处理多类型文档文件。目标用户覆盖学术研究人员、企业办公人员、内容运营人员、前端开发人员、数据处理工程师等,可应用于学术文献批量整理、企业合同数字化归档、扫描文档内容提取、旧文档格式转换等多个场景,帮助用户降低文档处理的人力投入,提升内容流转效率。
TextIn
免费TextIn是面向企业及个人用户的智能文档处理平台,主打OCR文字识别、文档格式转换、内容结构化提取等核心能力。平台支持对图片、扫描件、PDF等多类型载体的文字信息进行提取转换,可处理发票、合同、证件、表格等多种形态的文档内容,帮助用户完成文档信息的高效录入、整理与分析,适用于办公场景信息提取、批量文档数字化、财务票据核验、档案归档整理等多种使用场景。
Doc2X
免费Doc2X是专注于多格式文档智能解析与转换的在线AI工具,核心定位为低门槛文档结构化处理平台。核心功能包括支持扫描件、PDF、图片类文档的文字与版式识别,可将非结构化文档转换为可编辑的Word、Markdown、Excel等格式,同时支持公式、表格、复杂排版的精准还原。目标用户覆盖学生、科研人员、办公职员、内容编辑等需要处理各类文档的群体,可应用于文献整理、办公文档编辑、扫描件信息提取、课件内容二次编辑等多种场景,无需复杂配置即可在线完成文档处理操作。
llama-ocr
免费llama-ocr是一款开源npm库,核心定位为基于Llama 3.2 Vision模型的光学字符识别工具,可帮助开发者快速集成文本识别能力到项目中。核心功能包括支持本地与远程图像的OCR识别、提供免费与付费两种接口调用方案、后续规划支持PDF格式文件的内容提取,项目设计受Zerox启发,整体结构轻量化易集成。目标用户覆盖前端开发人员、Node.js后端开发者、小型工具开发团队等,可应用于文档数字化、图像内容转写、批量文本提取、小票信息录入等多种开发场景,降低OCR功能的接入门槛。

imagetotext.cc
imagetotext.cc是一款专注于在线OCR文本提取的服务网站,核心定位是为用户提供无需下载安装的网页端图像转文字处理服务。网站支持从各类常规图像格式中提取可编辑文本,同时支持转换为多种可导出格式,满足不同用户的文本提取需求。网站支持批量上传处理,支持多语言识别,无需注册即可使用基础功能。目标用户包括内容创作者、办公行政人员、在校学生、数据整理人员、文案编辑、科研工作者等,适用于扫描文档文字提取、图片截图文字转写、手写笔记数字化、书籍内容整理、会议截图文字归档等多种使用场景。

UBIAI
免费UBIAI是专注于文本领域的数据标注平台,支持多类型文本数据的标注、模型训练与部署全流程管理。平台内置OCR文本提取能力,可从扫描件、图片类文档中识别文本内容;搭载自动化标注功能,可通过学习用户标注习惯降低重复工作量;支持多语言标注,覆盖希伯来语、日语、阿拉伯语、印地语等数十种语言。平台面向NLP算法工程师、数据标注团队、行业数据分析人员,适用于医疗记录分析、金融文档处理、多语种内容审核、智能客服语料标注等多个场景,帮助用户标准化文本数据处理流程,提升标注效率。
Image to text
Image to text是专注于图片文本提取的在线工具,核心定位为用户提供无需下载安装的轻量OCR识别服务。它支持多格式图片上传识别,可自动识别多国语言文本内容,还能对识别结果进行在线编辑校对。目标用户覆盖办公人群、学生群体、内容创作者、档案整理人员等,适用于纸质文档电子化、截图信息提取、印刷资料转录、外文内容识别等多种场景,能够帮助用户降低手动录入文本的时间成本,提升信息整理效率。
你是 TurboLens 的开发者或团队吗?
认领后可编辑工具信息、获取真实点击数据,并在页面上展示官方认证徽章。
访问第三方工具时,请注意账号、隐私与支付安全
用户评论
0· 0 条