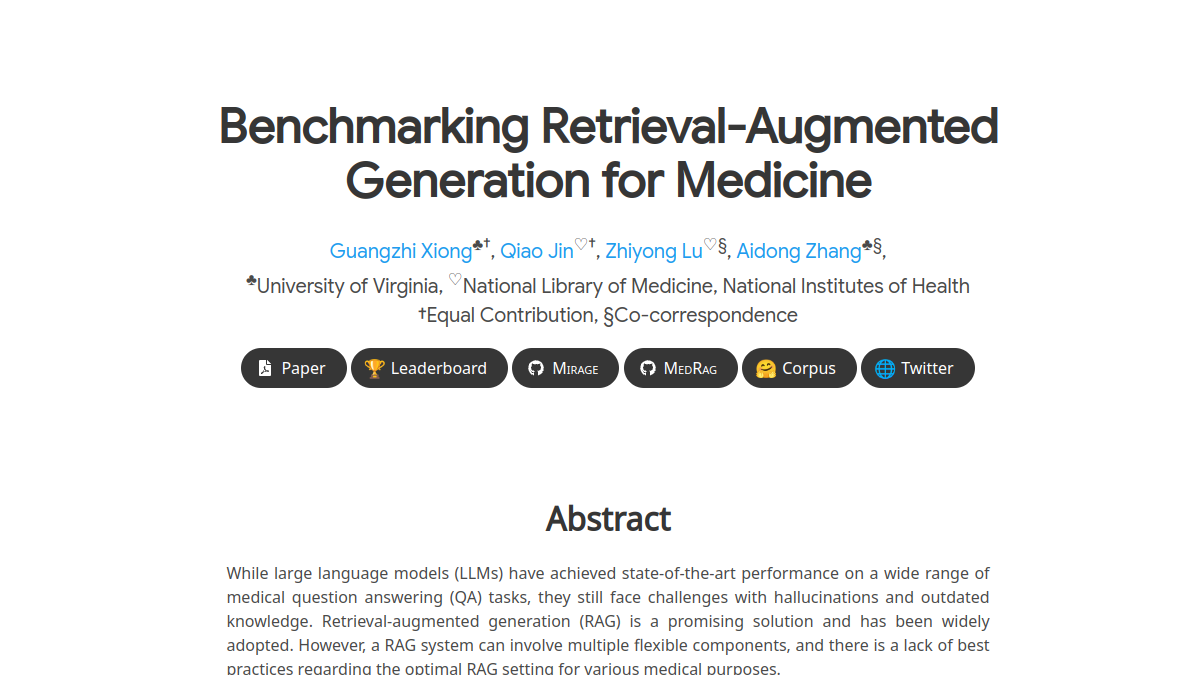
Benchmark Medical RAG是聚焦医疗领域的检索增强生成(RAG)基准测试平台,核心定位是为医疗大模型研发提供标准化的效果评测支撑。平台内置多场景医疗问答数据集,覆盖常见疾病、临床指南、医学术语等多个专业领域,同时提供自动化评测工具,可从检索准确率、生成内容合规性、事实一致性等多个维度输出量化评估结果。目标用户包括高校医学人工智能方向研究者、医疗大模型研发团队、医疗AI应用开发企业,可用于医疗RAG系统迭代优化、模型性能横向对比、学术研究实验验证等多个场景。
- 运营状态
- 正常运营
- 地址
- teddy-xionggz.github.io
- 定价模式
- 该平台所有公开功能均向用户免费开放,免费
- 是否开源
- 闭源
- 适合人群
- 高校医学人工智能研究者、医疗大模型研发团队、医疗AI应用开发企业、医疗机构信息化部门
- 收录时间
- 2026/6/14
- 访问量
- 0 次
编辑点评
在医疗大模型落地过程中,效果的标准化评测一直是行业痛点,尤其是检索增强生成方案在医疗场景下的表现,需要兼顾事实准确性、医学合规性、回答实用性等多个维度,缺少统一的评测基准会导致不同研究和产品的性能无法横向对比,也难以精准定位模型优化方向。这个平台的出现刚好填补了这一领域的空白,它没有做通用的大模型评测,而是完全聚焦医疗RAG场景,数据集经过专业医师校验,评测指标也充分考虑了医疗领域的特殊要求,相比通用评测基准更适配医疗场景的实际需求。同时平台提供的公开基线数据和自定义评测功能,既可以满足学术研究的标准化对比需求,也可以适配企业不同业务场景的个性化评测需要,对于整个医疗AI领域的研发和落地都有实际的支撑价值。
核心功能
使用指南
- 1
访问Benchmark Medical RAG官网,在首页导航栏找到「数据集」板块,浏览平台提供的不同场景、不同难度的医疗评测数据集,根据自身研究或研发需求下载对应的数据集文件。
- 2
若需要使用自定义数据集,可进入「自定义评测」板块,按照平台要求的格式上传自有标注数据集,设置对应的评测维度和指标权重,保存专属的评测方案。
- 3
使用下载或上传的数据集运行自身的医疗RAG系统,将模型输出的回答结果按照平台指定的格式整理为可上传的文件,确保文件内字段与数据集的问题ID一一对应。
- 4
进入「开始评测」板块,选择对应的评测方案,上传整理好的模型回答文件,提交后等待系统自动完成评测,评测时长根据数据集规模一般在数分钟到数十分钟不等。
- 5
评测完成后在「我的报告」板块查看详细的评测结果,可在线查看各维度得分、错误案例分析,也可将完整评测报告导出到本地,用于后续的模型优化或研究记录。
优势与不足
优点5 项
"数据集经过专业医师标注校验,医疗领域专业性强,避免通用数据集的医学错误问题"
"评测指标针对医疗RAG场景专门设计,覆盖事实一致性、合规性等医疗场景核心需求"
"提供多款主流大模型的公开基线数据,方便用户进行模型性能的横向对比"
"支持自定义数据集和评测规则,适配不同细分医疗场景的个性化评测需求"
"所有工具和公开数据集均可免费使用,无访问门槛,适合研究者和中小团队使用"
不足4 项
"目前公开数据集主要覆盖中文常见疾病场景,罕见病、专科类的数据集覆盖较少"
"自动化评测仅支持结构化的结果输出,复杂临床决策类问题的人工复核功能缺失"
"平台没有配套的模型部署工具,用户需要自行完成RAG系统的搭建和推理过程"
"英文医疗评测数据集的数量较少,不太适配英文医疗大模型的评测需求"
定价说明
该平台所有公开功能均向用户免费开放,免费版可无限制下载所有公开的医疗评测数据集,使用全部预设评测指标和主流模型基线对比功能,自定义评测和报告导出功能也无使用次数限制,没有付费会员版本。如果有大规模私有化部署、专属数据集标注协作等定制化需求,可通过页面提供的联系方式与开发团队沟通,根据具体需求评估合作方案,适合所有从事医疗RAG相关研究和研发的用户免费使用。
价格和授权政策可能变化,请以官网最新信息为准
适合人群与场景
- 高校医学人工智能研究者
开展医疗RAG相关学术研究
- 医疗大模型研发团队
迭代优化医疗领域生成模型性能
- 医疗AI应用开发企业
测试智能问诊、医学知识库等产品效果
- 医疗机构信息化部门
评估智能辅助诊断系统的可靠性
- 医学信息学专业学生
学习医疗大模型评测相关实践知识
- 医疗AI行业评测机构
开展医疗大模型性能横向对比测试
- 医药企业数字化部门
测试药物咨询、患者教育类AI工具效果
常见问题
深度了解
随着医疗人工智能技术的快速发展,检索增强生成(RAG)架构已经成为医疗大模型落地的主流方案,能够有效缓解大模型幻觉问题,提升医疗回答的事实准确性,而标准化的评测基准是推动医疗RAG技术迭代的核心基础。Benchmark Medical RAG作为聚焦医疗领域的RAG评测平台,针对医疗场景的特殊需求设计了完整的评测体系,所有公开数据集均经过专业医师标注校验,覆盖普通内科、外科、儿科、药学等多个科室,包含单跳事实查询、多跳推理查询、临床决策支持查询等不同难度的测试样本,能够全面验证医疗RAG系统在不同场景下的表现。平台内置20余项细分评测指标,可从检索相关性、生成内容事实准确性、医学合规性、回答完整性、幻觉发生率等多个维度输出量化评估结果,同时提供GPT-4、Claude 3、文心一言、通义千问等多款主流大模型的公开基线数据,方便用户进行横向对比。除此之外,平台还支持用户上传自有私有数据集,自定义评测指标权重和规则,适配智能问诊、临床辅助决策、医学知识库、患者教育等不同细分医疗场景的个性化评测需求。平台所有公开功能均免费开放,无需付费即可使用全部数据集和评测工具,同时提供开源本地评测包,满足高数据安全需求的用户使用。目前Benchmark Medical RAG已经被多个高校和医疗AI企业用于研究和研发工作,是医疗RAG领域的专业评测支撑平台。
Ready to try
准备好体验 Benchmark Medical RAG 了吗?
点击下方按钮在新标签页打开官网,开始探索它的全部功能。
相关工具

InternThinker
免费InternThinker是上海人工智能实验室研发的强推理AI模型服务平台,核心定位是为用户提供具备长思维链路、自我纠错能力的通用推理服务。平台核心功能包括复杂数学问题求解、多场景代码编写调试、逻辑推理谜题解答三类,可支持用户完成从学术科研到工程开发等多领域的推理类任务。其目标用户覆盖科研人员、开发工程师、在校学生、行业分析师等群体,适用于科研项目数据验证、代码项目逻辑调试、课程作业难题拆解、商业决策逻辑推演等多元场景,能够辅助用户提升复杂问题的处理效率。
AutoGLM沉思
免费AutoGLM沉思是智谱AI推出的面向学术研究与复杂推理场景的AI深度思考工具,核心定位是为用户提供长链路、高精度的逻辑推演服务。核心功能包括分步骤深度推理演算、多维度论点交叉验证、研究思路自动溯源复盘,支持用户上传文献、研究问题、方案框架等素材,工具会模拟人类深度思考的路径逐步推导结论。目标用户覆盖科研人员、高校学生、行业分析师、方案策划人员等,可应用于学术论文论证、复杂问题拆解、行业报告逻辑校验、商业方案可行性推演等场景,帮助用户梳理思考脉络,降低逻辑疏漏的概率。
知网研学AI
免费知网研学AI是中国知网旗下面向学术研究场景的智能化辅助平台,依托知网海量学术文献资源库与大语言模型技术,为用户提供文献解析、内容生成、知识问答等学术相关服务。核心功能包括文献智能解读、学术内容辅助创作、专业知识精准检索,主要面向高校师生、科研人员、学术编辑等群体,可应用于文献精读、论文撰写、课题调研、学术笔记整理等多种学术研究场景,帮助用户降低学术信息获取与内容生产的门槛。
OpenCompass 2.0 Large Language Model Leaderboard
OpenCompass 2.0 Large Language Model Leaderboard是面向大语言模型领域的专业性能评估平台,核心定位是提供中立、多维度的大模型能力评测结果展示。平台支持全球主流大语言模型的多维度能力评估,覆盖语言理解、知识储备、逻辑推理、数学计算、代码开发等多个技能维度,可生成模型综合排名与单项能力得分对比,支持不同模型的横向能力对标。目标用户包含大模型研发人员、AI领域研究者、企业技术选型负责人、AI应用开发者、高校计算机专业师生等群体,可用于大模型研发效果验证、学术研究性能参照、企业落地模型选型、AI应用开发模型匹配等多种场景,为大模型相关的研发、选型、研究工作提供客观的数据参考。

星火科研助手
免费星火科研助手是科大讯飞联合中科院文献情报中心推出的AI科研辅助平台,依托认知智能大模型与海量科技文献资源,面向科研全流程提供智能化支持。核心功能包括多源文献检索与汇总、长文档分模块精准解读、学术写作辅助与格式规范校验,同时支持文献综述生成、引用格式自动匹配等实用功能。目标用户覆盖高校学生、科研院所研究人员、企业研发从业者等群体,可应用于课题立项前期的文献调研、论文撰写过程中的内容打磨、海量文献批量研读等多个科研场景,帮助科研人员降低信息梳理成本,提升科研工作的推进效率。
Kaggle
免费Kaggle是谷歌旗下的数据科学与机器学习社区平台,核心定位为连接全球数据从业者,提供竞赛、学习、协作一体化服务。核心功能包括数据科学竞赛举办、公开数据集共享、在线代码运行环境支持。目标用户覆盖学生、数据分析师、算法工程师、高校科研人员等群体,可满足竞赛练手、项目数据集获取、算法模型打磨、专业技能学习、同行业协作交流等多场景需求,用户可在平台内完成从数据获取、模型开发到成果验证的全流程数据科学工作。
OpenCompass司南
免费OpenCompass司南是由上海人工智能实验室联合多家机构发起的开源大语言模型评测平台,核心定位为提供中立、可复现的大模型能力评测服务。平台支持超100个主流基准数据集,覆盖知识推理、数学计算、代码生成、语言理解、多模态处理等二十余个能力维度,可满足不同场景下的模型性能核验需求。平台面向大模型研发团队、AI领域研究者、企业技术选型人员、高校相关专业学生等群体,可用于模型研发过程中的能力迭代验证、学术研究中的性能对比、企业落地场景下的模型选型参考等多个场景,同时所有评测流程与数据完全开源,支持用户自定义评测任务配置。
Connected Papers
免费Connected Papers是一款面向学术研究领域的文献可视化分析工具,核心定位是帮助科研人员梳理领域文献脉络、快速建立知识体系。核心功能包括文献引用关系图谱生成、领域文献趋势统计、相似文献智能推荐,支持用户通过DOI、论文标题、PubMed ID等多种方式检索目标文献。目标用户涵盖高校硕博研究生、科研机构研究员、高校教师、企业研发人员、期刊审稿人等群体,可应用于文献综述撰写、新研究领域入门、研究热点追踪、参考文献筛选、科研选题调研等多个学术场景。
你是 Benchmark Medical RAG 的开发者或团队吗?
认领后可编辑工具信息、获取真实点击数据,并在页面上展示官方认证徽章。
访问第三方工具时,请注意账号、隐私与支付安全
用户评论