Open LLM Leaderboard
由 open-llm-leaderboard 团队创建
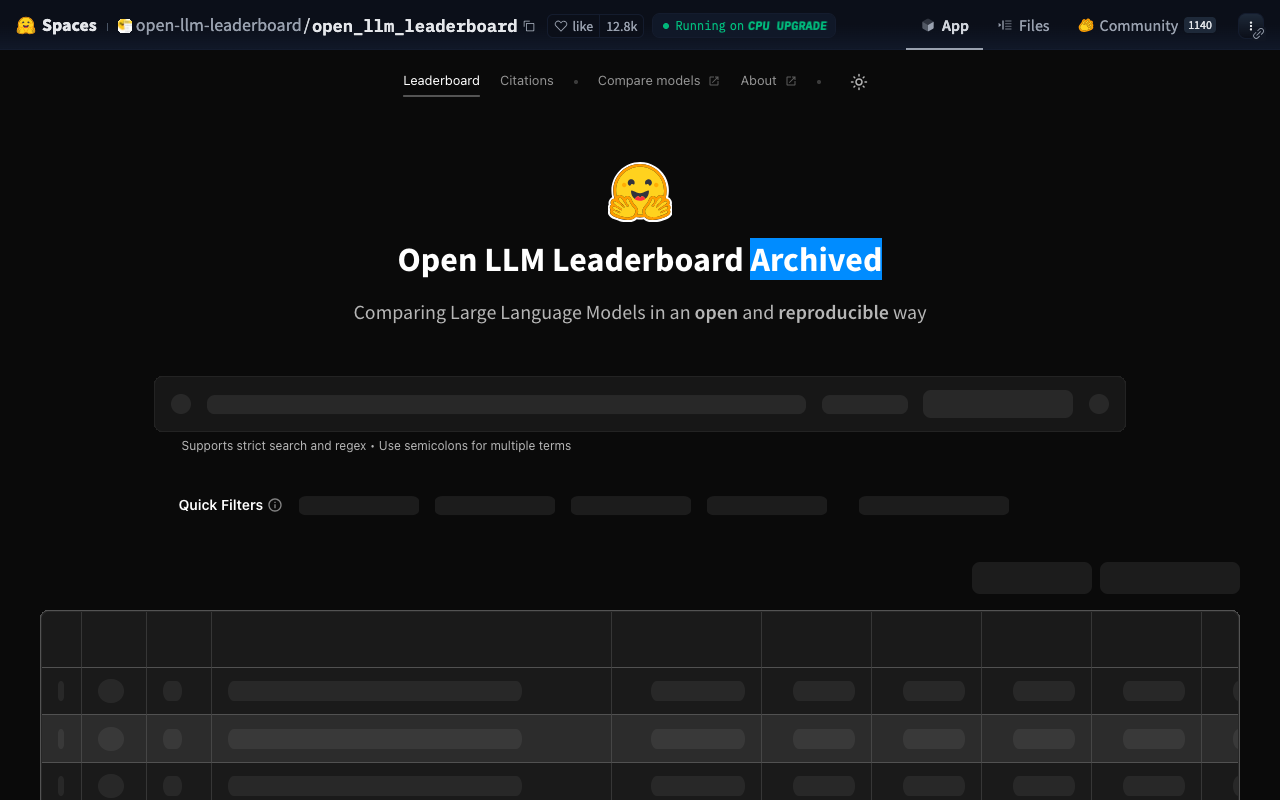
由 open-llm-leaderboard 团队创建。它的主要目的是跟踪、排名和评估开源大语言模型(LLMs)和聊天机器人,为用户提供一个透明、可比较的平台,以了解不同模型的性能表现。
- 适用对象
- AI研发人员 选型开源大模型用于本地部署测试
- 主要功能
- 开源模型性能排名、透明评测结果公示
- 已收录
- 2026.10.18(22 天)
阅读目录
编辑评测与站内热度
全站热度排名
待评估
分类内排名
待评估
累计站内点击
3
近 7 日点击
3
排名与点击为站内真实统计口径,反映 Toolifai 用户行为,非编辑评分。
Open LLM Leaderboard是什么,怎么使用?
约 5 分钟Open LLM Leaderboard,由 open-llm-leaderboard 团队创建。它的主要目的是跟踪、排名和评估开源大语言模型(LLMs)和聊天机器人,为用户提供一个透明、可比较的平台,以了解不同模型的性能表现。
Open LLM Leaderboard是由open-llm-leaderboard团队搭建的开源大语言模型公共评测平台,面向所有关注开源LLM性能的用户,解决了不同开源模型性能维度分散、缺乏统一透明对比基准的痛点。平台基于公开的评测维度对提交的开源大语言模型、聊天机器人进行统一测算,输出可横向对照的排名结果,所有评测过程和得分数据均对外公开,避免非公开评测带来的信息差。
它覆盖主流开源LLM的多维度性能排名展示,不提供自定义模型微调、专属定制评测等付费增值服务,所有公开数据均可自由浏览。如果你正在选型开源大模型用于本地部署、项目测试,或是需要了解当前开源LLM的整体性能梯队,这个平台能帮你快速缩小候选模型范围,省去自行搭建复杂评测环境的冗余步骤。
主要功能
- 开源模型性能排名:汇总所有提交的开源大模型得分,按综合维度排序,帮用户快速定位性能靠前的候选模型。
- 透明评测结果公示:完整展示每款模型的各项评测细分得分,所有数据公开可查,避免信息不对称带来的判断偏差。
- 聊天机器人专项评估:针对开源类聊天机器人产品做定向性能核验,区分通用大模型与对话类模型的适配表现。
- 跨模型横向对比:支持同维度下不同参数规模、不同训练方向的开源LLM直接对照,降低用户选型的信息收集成本。
怎么使用
- 通过浏览器访问工具官方Web站点,进入Open LLM Leaderboard的主展示页面。
- 浏览首页的默认综合排名列表,查看各开源大模型的基础得分与排名位次。
- 点击任意目标模型条目,展开查看该模型的各项细分评测维度的具体得分数据。
- 对照不同模型的得分差异,筛选出符合自身使用需求的候选开源大语言模型。
适合什么人群
- AI研发人员 选型开源大模型用于本地部署测试
- AI产品经理 调研开源LLM梯队做项目方案参考
- 技术爱好者 对比不同开源大模型的实际性能表现
- 高校相关专业学生 了解开源LLM行业的性能基准
Open LLM Leaderboard 是什么
官网称,Open LLM Leaderboard 是由 open-llm-leaderboard 团队创建的 Web 工具,核心功能为跟踪、排名和评估开源大语言模型及聊天机器人。它解决的核心问题是,开源大模型的性能缺乏统一透明的比较标准,不同模型的测试结果分散在各类文档中,普通用户难以快速判断模型的实际适配性。官网将自身定位为开源大模型的透明可比较平台,为用户提供直观的模型性能参考依据。
核心能力
它能实现开源大模型的自动性能排名,运作逻辑是基于统一的测试基准集对模型进行标准化评估,无需用户手动测试不同模型。该能力依赖 Hugging Face 的开源模型库数据,可实时同步新提交的模型评估结果。它无法针对特定场景定制测试,仅提供通用性能维度的排名,无法替代垂直领域的专业评估工具。它支持按模型类型、参数规模筛选结果,能快速定位不同量级模型的性能差异,仅覆盖公开可获取的开源模型,不包含闭源模型的评估数据。
工作方式
用户进入官网后,可通过页面筛选栏选择模型类型、参数规模等条件,系统自动加载对应模型的评估结果。用户可查看每个模型的各项性能指标及排名,还能导出评估数据的 CSV 文件。产出物为结构化的模型排名列表,包含每个模型的核心性能指标、参数信息及测试基准的具体表现,所有数据均基于统一测试流程生成,确保排名的横向可比性。
典型场景与产出
AI 项目开发者在选型开源大模型时,会使用该工具对比不同参数规模的模型性能,产出的是可直接用于选型的性能对比表格,帮助开发者快速缩小候选模型范围。高校研究人员在开展开源大模型性能分析研究时,会借助该工具获取标准化的评估数据,产出的是可用于论文或报告的模型性能统计结果,无需自行搭建测试环境。企业技术团队在评估开源模型的部署可行性时,会参考该工具的排名结果,产出的是适配业务需求的模型选型清单,降低选型的时间成本。
适用边界
它不适合需要针对特定业务场景定制评估的用户,仅提供通用性能维度的排名,无法覆盖垂直领域的专业需求。它的已知局限是仅支持公开可获取的开源模型,不包含闭源模型的评估数据,且测试基准固定,无法灵活调整评估维度。用户若需特定场景的评估结果,需结合其他专业评估工具补充数据,或直接联系模型开发者获取定制测试信息。
编辑点评
该工具为开源大模型领域提供了统一的性能评估标准,解决了模型性能对比分散的痛点,是选型和研究的实用参考工具。它的短板是缺乏垂直场景的定制评估能力,仅覆盖公开开源模型,无法满足特定业务的深度测试需求。涉及定价的部分,官网未标注具体费用,用户可查看官网定价页或帮助中心获取最新信息,建议在使用前确认工具的免费功能范围。内容基于官方公开材料整理,功能与价格以官网公示为准。
优点与不足
优点
- 所有开源模型评测数据完全公开,无隐藏的非透明加权规则。
- 覆盖的开源LLM数量较多,更新频率能跟上主流新模型发布节奏。
- 无需注册登录即可查看全部公开排名数据,访问门槛极低。
不足
- 仅支持Web端访问,无移动端独立应用或桌面客户端。
- 未提供中文界面选项,所有操作与说明文字均为英文展示。
能帮你做的 5 件事
- 01开源模型性能排名
- 02透明评测结果公示
- 03聊天机器人专项评估
- 04跨模型横向对比
- 05AI研发人员 选型开源大模型用于本地部署测试的日常效率工具
更新历史
- Open LLM Leaderboard 收录进 Toolifai 目录
- 页面资料核验与信息更新
常见问题
新手没评测经验能直接用吗
可以直接上手,平台所有排名和得分均为可视化展示,无需用户自行配置评测环境,只需进入站点浏览数据即可,没有额外操作门槛,按页面指引查看对应模型信息即可。
使用平台需要支付费用吗
该平台定价类型未标注,当前公开的基础排名浏览功能可正常免费访问,具体的特殊服务收费规则以官网公示为准,建议进入官网帮助中心查看最新说明。
平台会留存我的提交数据吗
平台相关数据隐私规则可查看官网公示的隐私政策,普通浏览用户无需上传个人数据,若提交自定义模型参与评测,相关数据处理规则以官网对应说明为准。
它能评测闭源商用大模型吗
不能,平台的核心服务范围仅覆盖开源大语言模型与开源聊天机器人,闭源商用模型不在其收录和评测的范围内,无法在该平台查询对应排名数据。
有同类工具替代它吗
有其他开源LLM评测站点可作为补充,但该平台的评测数据集与排名逻辑有自身独立性,可交叉对照多个平台的结果,获取更全面的模型性能参考信息。
开始使用 Open LLM Leaderboard
从官方入口了解最新功能与使用方式。
由 Toolifai 编辑维护
欢迎产品方补充截图、功能介绍与官方资料。更新和纠错由编辑审核后发布。