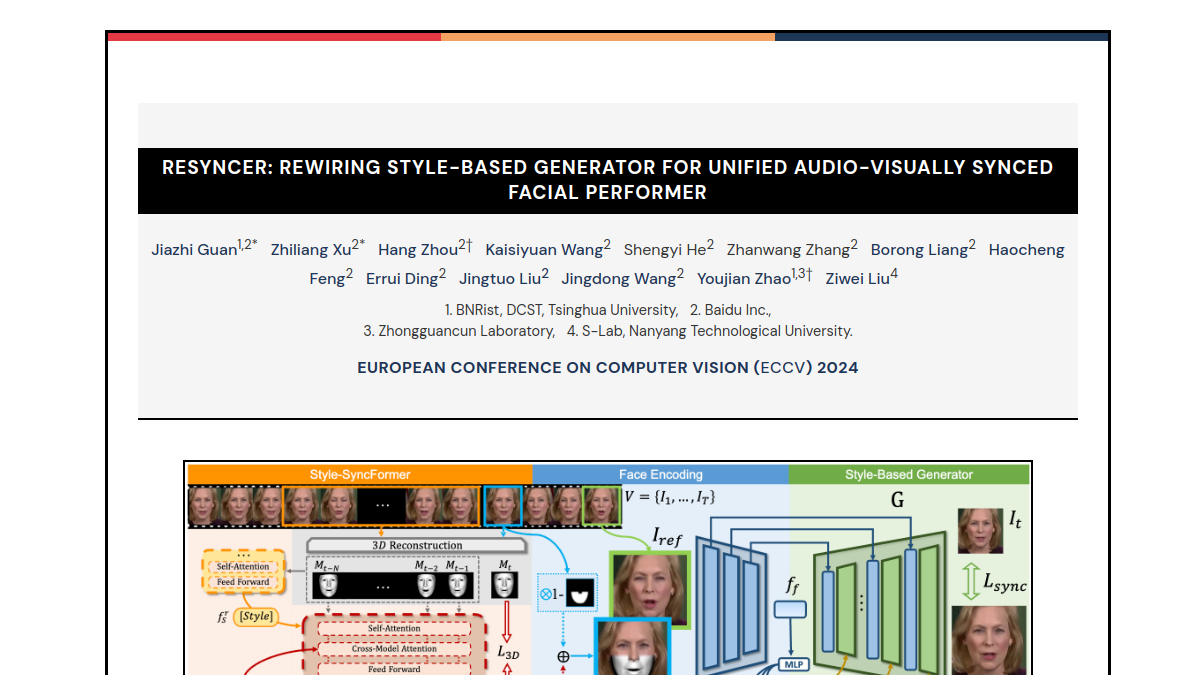
ReSyncer是一款专注于音视频同步处理的AI框架工具,核心依托风格注入Transformer技术,为音视频内容创作提供唇形同步、风格迁移相关的技术支持。其核心功能包括高保真唇形同步生成、说话风格自定义转换、视频驱动的面部动作复刻三个方向,主要面向音视频创作者、虚拟内容开发人员、短视频制作团队等用户群体,可应用于虚拟主持人内容制作、多语言译制片口型对齐、数字人内容生成等多个场景,帮助降低音视频同步内容的制作门槛,提升输出内容的自然度。
- 运营状态
- 正常运营
- 地址
- guanjz20.github.io
- 定价模式
- 免费
- 支持平台
- API 接口
- 是否开源
- 开源
- 适合人群
- 短视频创作者、虚拟数字人开发者、译制片制作团队、课程制作团队
- 收录时间
- 2026/6/14
- 访问量
- 0 次
编辑点评
这是一款聚焦音视频同步领域的AI框架工具,和同类工具相比,它最大的特点是在唇形同步的基础上新增了风格注入的能力,不只是单纯让口型对上语音,还能保留人物特有的说话习惯和面部特征,避免生成的内容出现千篇一律的AI感。它支持的视频驱动同步、说话风格转换、面部交换等组合功能,让用户不需要在多个工具之间切换处理素材,一站式即可完成从动作复刻到身份替换的全流程操作。对于有虚拟内容制作需求的用户来说,它的个性化微调功能门槛较低,仅需要少量样本即可完成特定人物的适配,不需要用户具备深厚的AI模型训练基础,按照指引操作即可完成适配。目前项目页面提供了完整的部署教程和效果演示案例,用户可以先查看演示案例确认效果是否符合自身需求,再进行部署使用,整体实用性较强,适合有相关音视频处理需求的用户尝试。
核心功能
使用指南
- 1
访问ReSyncer的项目页面,查看页面中的功能说明与环境配置指引,根据指引在本地部署对应的运行环境,安装所需的依赖包与模型文件,确认框架运行所需的硬件配置满足要求。
- 2
准备需要处理的基础素材,包括待同步的视频文件、匹配的音频文件或驱动用的参考视频,确保视频画面清晰、人物面部无大面积遮挡,音频文件无明显杂音,提升处理效果。
- 3
在框架界面选择需要使用的功能模块,比如唇形同步、风格转换或面部交换,按照提示上传对应的素材文件,根据自身需求调整处理参数,比如风格匹配度、输出分辨率等选项。
- 4
提交处理任务后等待框架运行,处理过程中可查看进度条了解处理状态,小体积素材通常数分钟即可完成,长视频可在后台运行处理,无需持续停留操作界面。
- 5
处理完成后预览生成的视频内容,确认唇形同步效果、风格呈现是否符合预期,若效果不满意可调整参数重新生成,确认无误后导出视频文件到本地即可使用。
优势与不足
优点4 项
"支持风格注入技术,生成的唇形同步视频可保留人物特有说话特征,自然度表现较好"
"功能覆盖全面,同时支持唇形同步、风格转换、面部交换、视频驱动等多个相关功能"
"个性化微调门槛较低,仅需少量目标人物素材即可完成适配,不需要复杂的训练操作"
"支持批量处理多组素材,适合有大量内容生产需求的团队使用,提升处理效率"
不足4 项
"需要用户自行在本地部署运行环境,对没有相关部署经验的新手有一定操作门槛"
"处理高分辨率长视频时对硬件性能要求较高,普通配置的设备运行耗时较长"
"目前没有在线运行版本,无法直接在网页端完成所有操作,需要占用本地设备资源"
"面部交换功能在处理侧脸、大角度运动的画面时,容易出现边缘衔接不自然的情况"
定价说明
ReSyncer是开源免费的框架项目,所有核心功能均无需付费即可使用,没有功能使用次数、素材处理时长的限制,用户可直接获取项目代码自行部署使用。项目目前没有设置付费版本,也不提供付费的云端处理服务,所有运行资源均需要用户自行准备。对于有二次开发需求的用户,可在开源协议范围内对代码进行修改适配,建议普通用户先查看项目页面的演示效果,确认符合自身需求后再进行部署使用,避免不必要的配置成本。
价格和授权政策可能变化,请以官网最新信息为准
适合人群与场景
- 短视频创作者
口型对齐修正场景
- 虚拟数字人开发者
数字人内容生成场景
- 译制片制作团队
多语言版本口型匹配场景
- 课程制作团队
网课内容口型修正场景
- 虚拟主播运营团队
虚拟主持人内容生产场景
- 影视后期人员
影视片段口型调整场景
- AI内容研究人员
音视频同步技术研究场景
- MCN机构
批量短视频内容制作场景
常见问题
深度了解
在音视频内容制作领域,唇形同步一直是耗时长、对人工经验要求高的工作,ReSyncer作为专注于音视频同步的AI框架,为相关从业者提供了更高效的解决方案。该框架基于先进的风格注入Transformer技术开发,不只是实现基础的音视频时间线对齐,还能精准匹配语音特征与唇形运动规律,生成的同步视频自然度更高,避免出现生硬的AI感。
ReSyncer的核心功能覆盖了音视频同步相关的多个需求场景,用户不仅可以上传音视频素材生成唇形同步的视频,还可以实现说话风格转换,调整人物的表达状态适配不同的内容场景;支持视频驱动的唇形同步,可将源视频的动作复刻到目标人物身上;还支持面部交换功能,在同步的同时完成人物身份替换,一站式满足虚拟内容制作的多项需求。
对于有特定IP制作需求的用户,ReSyncer的个性化微调功能仅需要少量目标人物的说话素材,即可完成特征适配,保留人物独有的唇形运动习惯和微表情特征,适合虚拟IP、固定主持人的内容生产。同时框架支持批量处理多组素材,适合有大量内容生产需求的团队使用,有效提升制作效率。目前项目页面提供了完整的部署教程和效果演示,用户可以先查看演示案例确认效果,再按照指引完成部署使用,适配不同层级用户的使用需求。
Ready to try
准备好体验 ReSyncer 了吗?
点击下方按钮在新标签页打开官网,开始探索它的全部功能。
相关工具
Wav2Lip
Wav2Lip是一款基于AI技术,实现音频驱动人物唇形同步的工具,核心定位是通过输入目标音频和人物图像,自动生成唇形与音频内容精准匹配的视频内容。它支持多种语言、多种人物形象的唇形合成,可处理包含遮挡的面部图像,也能适配不同分辨率的输入素材。核心功能包括音频唇形同步生成、多语种适配、遮挡场景处理、视频批量处理和风格输出调整,目标用户覆盖内容创作者、影视后期从业者、配音行业从业者、教育内容制作者、短视频创作者和广告营销人员,适用于视频配音修正、多语言内容本地化、虚拟数字人内容制作、教学视频配音更新等多种场景。
Seedance 2 Video Generator
Seedance 2 Video Generator是字节跳动推出的AI视频生成平台,核心定位是通过AI技术将文本描述或输入图像生成符合创作需求的视频内容。平台支持文本生成视频、图像参考生成视频、画面风格自定义、视频时长调整、镜头运镜设置等功能,面向内容创作者、影视创作者、新媒体运营人员、产品设计师、营销策划人员、教育工作者提供视频创作服务,可应用于短视频内容创作、影视概念片制作、营销广告片生成、课程演示视频制作等多种场景,帮助创作者降低视频制作门槛,提升内容产出效率。

audio2face
Audio2Face是NVIDIA推出的基于AI的音频转面部动画技术服务,核心定位是为创作者提供音频驱动的高精度面部表情生成能力。核心功能包括实时音频流唇形同步、多语言面部动画适配、自定义面部绑定输出三类,可自动匹配音频内容生成对应的唇部动作、面部肌肉微表情及头部微动作,无需手动逐帧调整。该服务面向数字人开发者、影视动画制作者、游戏内容创作者、VR/AR内容从业者等群体,适用于虚拟主播实时驱动、影视角色动画制作、虚拟偶像内容生产、元宇宙场景数字人交互等多个场景,能够有效降低面部动画制作的人力与时间成本。
LipsyncX
LipsyncX是一款专注于AI写实对口型生成的在线工具,支持长视频处理与多语言配音适配,可精准匹配原视频人物口型与输入语音内容。核心功能包含AI对口型生成、多语言语音适配、长视频分段处理、自定义语音输入、视频分辨率导出。目标用户覆盖内容创作者、本地化运营人员、视频剪辑师、自媒体博主、跨境内容从业者,适合用于影视内容本地化翻译、短视频口型修改、多语言内容出海制作、错口型视频修正等场景。
LipSync.video
LipSync.video是一款在线AI口型同步生成工具,核心定位为通过AI技术实现音频驱动视频人物口型匹配,自动生成符合音频内容的口型同步视频。该工具支持上传自定义视频与音频文件,可快速完成口型对齐处理,支持多种语言语音识别匹配,无需本地安装复杂软件,通过浏览器即可完成操作。核心功能包含AI口型同步生成、多格式文件支持、在线预览处理结果、自定义分辨率导出、无水印基础输出等,适合内容创作者、视频剪辑师、本地化内容运营者等用户使用,可应用于外语视频配音本地化、教学视频口型修正、短视频口型调整等多种场景。
Hedra
免费Hedra是面向视频创作领域的AI唇形同步视频生成平台,核心能力是通过静态人像素材与音频内容匹配生成动态对口型视频。平台支持多格式人像素材上传,可实现唇形与音频的高精度匹配,同时提供基础的视频参数调整功能。目标用户覆盖内容创作者、自媒体运营者、教育从业者、品牌营销人员等群体,可用于口播视频制作、多语言课程译制、虚拟主播内容产出、品牌宣传素材迭代等场景,降低对口型视频的制作门槛,减少实拍成本。
Lipsync AI
Lipsync AI是一款依托人工智能技术,专注生成逼真口型同步动画的在线工具,核心功能包括生成口型同步虚拟人视频、上传本地素材编辑、批量生成动画、自定义模型参数和导出多格式文件。面向内容创作者、新媒体运营人员、教育课件开发者、广告制作团队等用户,可以满足短视频制作、在线课程开发、品牌宣传视频制作、有声内容可视化等场景下的口型动画制作需求。

LipDub AI
LipDub AI是专注于AI对口型视频生成的在线工具,核心定位是为用户提供多语言口型匹配的视频合成服务,支持输入音频或文本自动匹配人物口型、适配不同面部特征。平台核心功能包含口型智能对齐、多语言支持、自定义人物素材上传三类,可实现高精度的面部动作与语音内容匹配,降低对口型视频的制作门槛。目标用户覆盖内容创作者、跨境电商运营者、影视后期从业人员、教育内容开发者等群体,适用于多语言版本短视频制作、海外产品宣传视频本地化、教育课程多语种配音匹配、虚拟数字人内容产出等场景。
你是 ReSyncer 的开发者或团队吗?
认领后可编辑工具信息、获取真实点击数据,并在页面上展示官方认证徽章。
访问第三方工具时,请注意账号、隐私与支付安全
用户评论
0· 0 条