开源AI框架
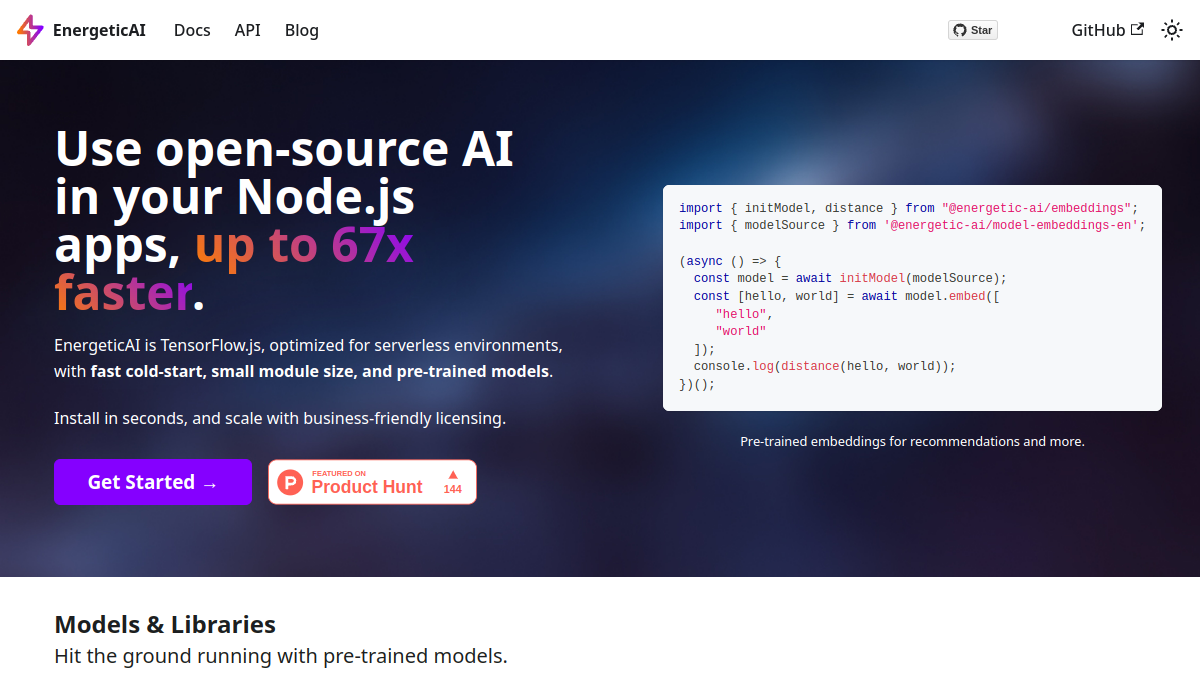
energeticai.org
EnergeticAI是专为无服务器运行环境优化的TensorFlow.js衍生工具,核心定位是帮助开发者在无服务器架构中快速部署轻量AI能力。它支持预训练嵌入模型调用,可直接用于推荐系统、语义检索等场景;提供极小体积的模块化安装包,降低无服务器环境的加载资源消耗;采用商业友好的开源许可协议,允许企业商用无需额外授权。该工具面向全栈开发、AI应用开发、后端架构师等用户,适用于无服务器函数部署AI能力、边缘端轻量AI功能开发、低成本AI服务搭建等场景。
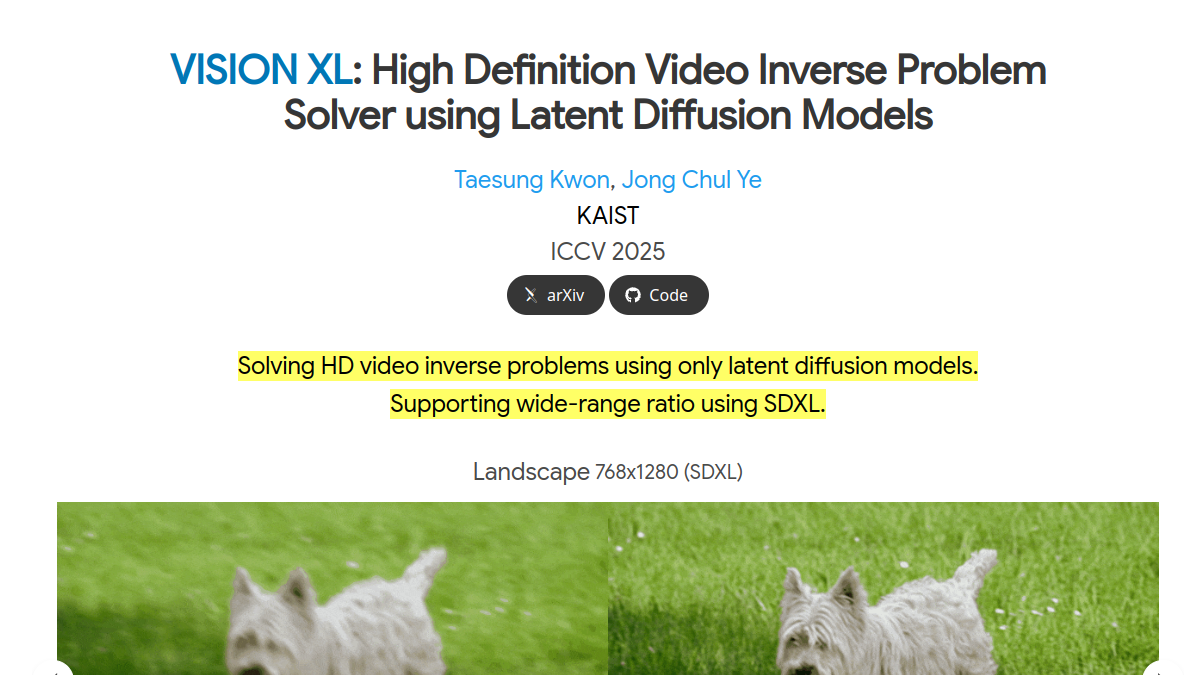

vision-xl.github.io
VISION XL是基于潜在扩散模型打造的高清视频逆问题处理框架,核心定位是为视频修复与画质提升场景提供技术解决方案。核心功能包括多比例高分辨率视频重建、伪批量一致性采样优化、批量一致性反演计算,能够适配去模糊、超分辨率、视频修复等多种场景。目标用户覆盖计算机视觉研究人员、视频制作从业者、AI算法开发工程师等群体,可应用于学术研究实验、老旧视频画质修复、专业影视内容后期处理、监控视频内容增强等多个场景,依托开源SDXL模型的技术底座,实现稳定的视频重建效果。
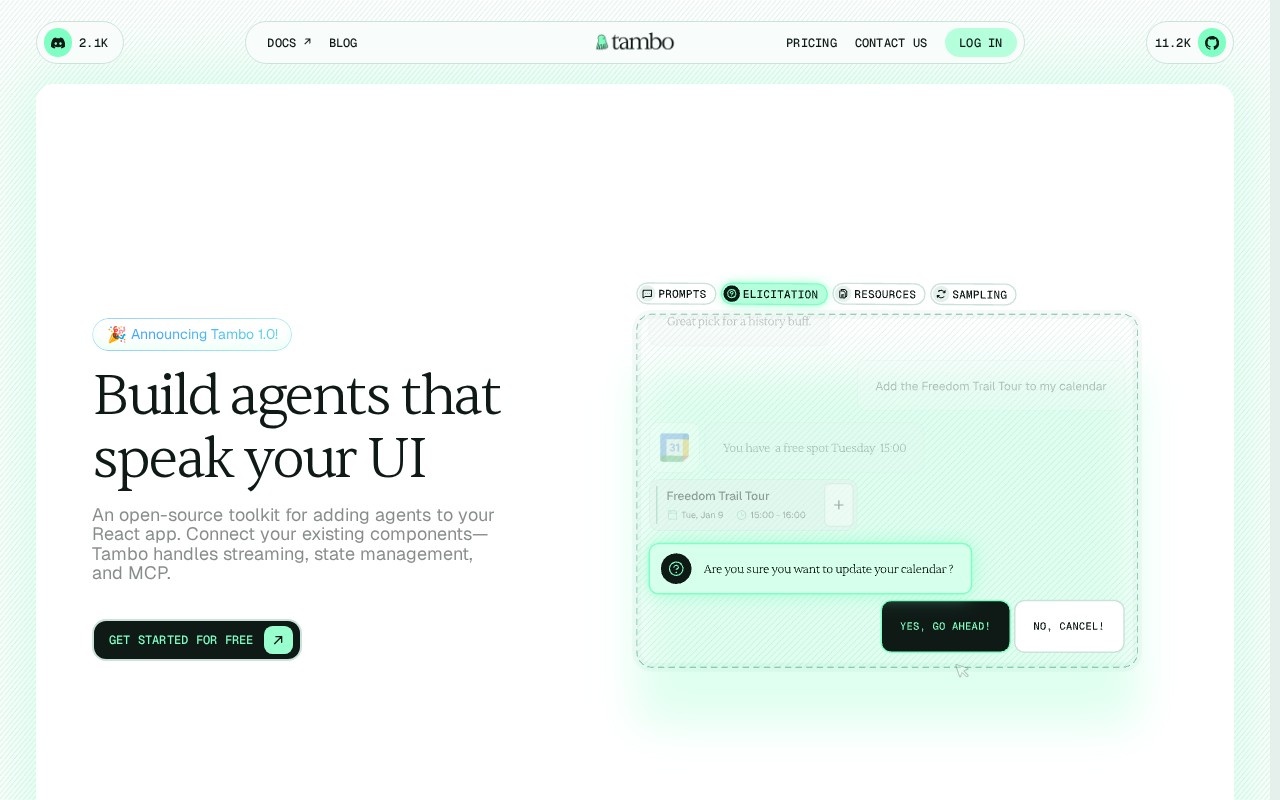
tambo.co
Tambo AI是面向React前端开发领域的开源AI调度框架,为开发人员提供AI功能与现有React项目集成的基础设施支持。核心功能包括AI组件调度、上下文管理、工具调用集成,支持开发人员在React应用中快速接入AI能力,无需从零搭建AI交互的底层架构。该框架适配各类需要嵌入AI交互功能的React前端项目,目标用户为前端开发人员、全栈开发工程师、开源项目维护者,适用场景包括开发AI聊天应用、AI辅助开发工具、智能客服前端模块等。

x-lance.github.io
AniTalker是由X-Lance团队开源的肖像动画生成框架,主打从单张肖像图片生成自然的对话式面部动画效果。核心功能包括单图驱动对话面部动画生成、自监督动作表现力增强、身份特征精准保留三大能力,面向计算机视觉研究者、数字内容创作者、虚拟形象开发人员等群体,可应用于虚拟主播形象制作、短视频角色动画生成、数字人交互系统开发等场景,降低面部动画制作的技术门槛与数据依赖。

mastra.ai
Mastra是由Gatsby团队打造的面向TypeScript开发者的开源智能体框架,核心定位是通过统一API和工具链,帮助开发者快速构建、测试、部署具备记忆、工具调用、工作流编排等能力的AI应用。核心功能包括统一模型路由,支持一键切换多家大模型无需改动业务逻辑;内置完整RAG链路,可一站式实现文档向量化与检索;配套本地Playground支持实时调试,还能一键部署到多个Serverless平台。目标用户为TypeScript全栈开发者、AI应用开发人员、企业技术团队,可应用于企业知识问答机器人搭建、SaaS产品AI助理嵌入、多步骤业务流程自动化等多个场景。
openclaw.im
Openclaw是一款面向技术开发者的开源AI自动化框架,核心定位为帮助开发者构建可编程、可自托管的AI工作流项目。框架支持自定义AI节点配置、多AI模型协同调度、本地数据处理存储,允许开发者根据自身业务需求灵活搭建各类自动化AI处理流程。核心目标用户包含AI应用开发者、后端开发工程师、数据处理工程师等技术人群,适用场景覆盖AI数据批量处理、私有AI服务搭建、自动化内容生成工作流构建、本地AI模型部署调试等多个技术开发场景。
xiaoyushi97.github.io
Motion-I2V是专注于图像到视频生成的技术框架展示站点,核心面向AI生成内容领域的研究者与开发者,提供可控且一致性更高的图像转视频方案。其核心功能包括两阶段式图像转视频生成,支持大运动与视角变化场景下的稳定输出;可配置的稀疏轨迹控制功能,允许用户自定义运动路径与作用区域;零样本视频到视频转换能力,无需额外训练即可完成视频风格或内容调整。适合AIGC从业者验证视频生成效果、计算机视觉研究者对比算法性能、内容创作者尝试静态素材动态化的各类场景。

stereocrafter.github.io
StereoCrafter是专注于2D视频转立体3D视频的技术框架官方站点,核心面向3D内容创作者、XR开发者、影视制作人员等群体。其核心功能包括基于基础模型先验的立体视频生成、自适应分块长视频处理、大规模3D视频数据集构建,可支持用户将普通2D视频素材转换为适配Apple Vision Pro、3D显示器等设备的沉浸式3D内容,适用于影视3D化制作、XR内容生态搭建、教学科普3D资源制作等多种场景,为3D数字内容生产提供可落地的技术路径。
yxbian23.github.io
ControlMM是一款面向AI运动生成领域的开源全身运动生成框架,核心定位为多模态驱动的人体运动生成工具。其核心功能包括多模态信号输入适配能力,支持文本、语音、音乐三类输入源转换为对应人体运动序列;内置运动合理性校验模块,可自动修正生成序列中的肢体穿插、动作脱节等问题;提供即插即用的接口设计,方便开发者快速集成到各类应用中。目标用户覆盖AI内容创作者、动画制作人员、游戏开发工程师、人机交互研究者、数字人开发团队等群体,可应用于数字人直播动作生成、3D动画角色动作制作、虚拟偶像舞蹈编排、人机交互场景动作匹配等多个场景,为不同领域的运动生成需求提供可落地的技术方案。
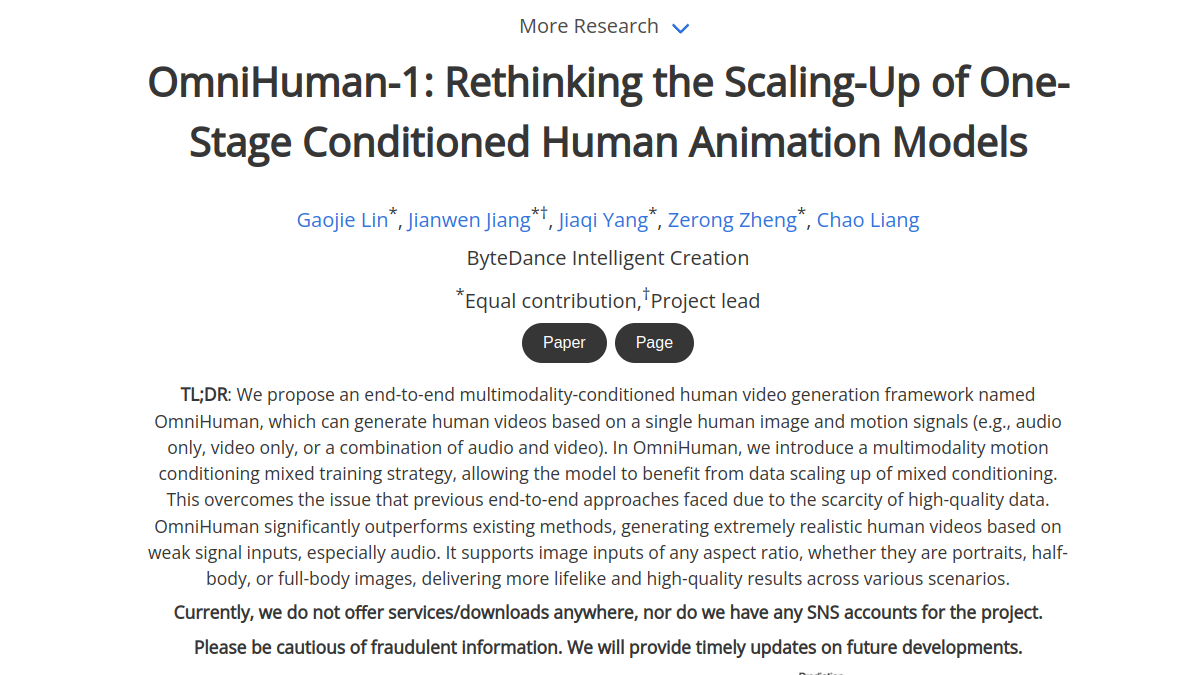

omnihuman-lab.github.io
OmniHuman-1 是专注于多模态条件人类视频生成的开源技术框架,核心定位是为内容创作与数字人开发领域提供可落地的视频生成技术支持。核心功能包括单张人像驱动视频生成、多模态运动信号输入适配、任意宽高比图像兼容三大模块,目标用户覆盖数字内容创作者、虚拟人开发者、影视后期从业者、AI技术研究人员等群体,可应用于虚拟主播内容制作、影视素材补全、数字人内容批量生产、AI 生成技术研发测试等多个场景,帮助用户降低真人拍摄成本,提升视频内容生产效率。

fun-audio-llm.github.io
FunAudioLLM是面向语音交互开发场景的开源技术框架,核心目标是优化人类与大语言模型的自然语音交互体验。框架内置SenseVoice多模态语音理解模型与CosyVoice语音生成模型,支持多语种语音识别、情绪识别、音频事件检测、可控语音合成等能力,相关代码与模型权重已开源开放。适合AI应用开发者、语音交互产品研发人员、学术研究人员使用,可应用于智能客服系统搭建、有声内容制作、多语种语音助手开发、语音类AI产品原型验证等多种场景,帮助降低语音交互相关功能的开发门槛。

dreamllm.github.io
DreamLLM是专注于多模态大语言模型研发的开源学习框架,核心定位是打破传统多模态模型的技术瓶颈,实现理解与创作能力的协同提升。核心功能包括原生多模态空间采样生成、无外部特征依赖的语义理解、跨模态联合分布建模三类,支持研究人员快速复现多模态生成实验,也可供AI开发人员搭建跨模态内容生成系统。目标用户覆盖AI领域研究学者、大模型开发工程师、高校计算机相关专业师生等群体,适用于多模态模型技术研发、跨模态内容生成工具开发、大模型相关学术实验验证等场景。
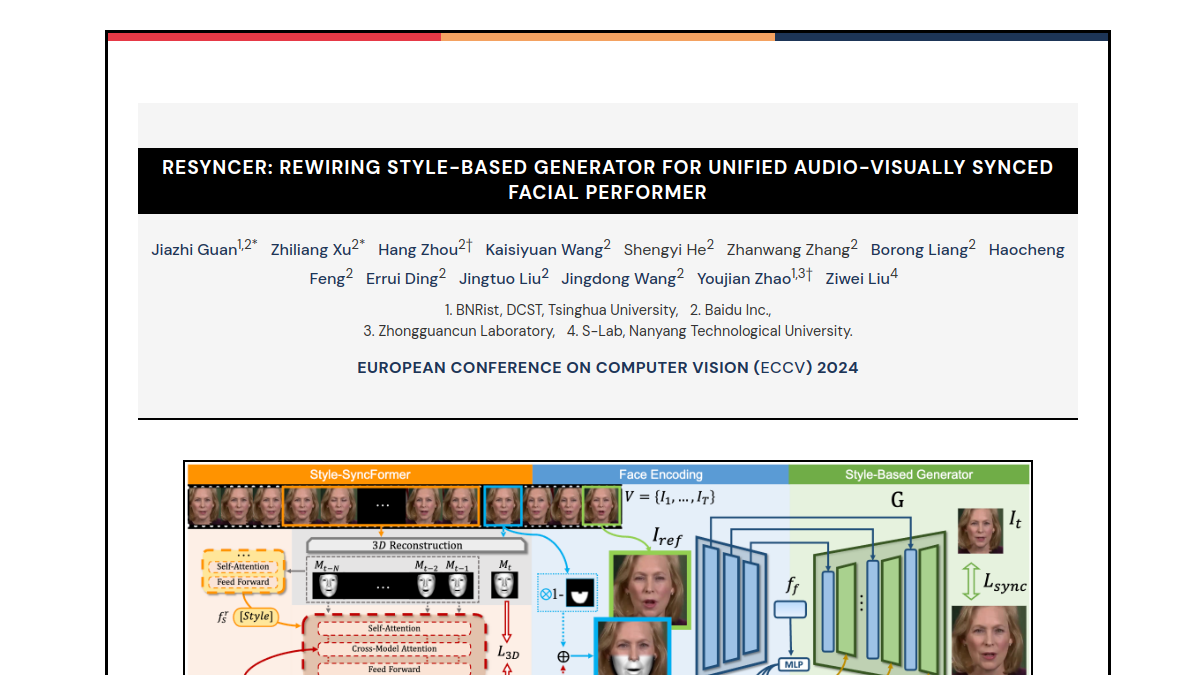
guanjz20.github.io
ReSyncer是一款专注于音视频同步处理的AI框架工具,核心依托风格注入Transformer技术,为音视频内容创作提供唇形同步、风格迁移相关的技术支持。其核心功能包括高保真唇形同步生成、说话风格自定义转换、视频驱动的面部动作复刻三个方向,主要面向音视频创作者、虚拟内容开发人员、短视频制作团队等用户群体,可应用于虚拟主持人内容制作、多语言译制片口型对齐、数字人内容生成等多个场景,帮助降低音视频同步内容的制作门槛,提升输出内容的自然度。

openchatkit.net
OpenChatKit是面向开发者、AI研究人员的开源聊天机器人开发框架站点,核心定位是为各类聊天机器人搭建提供可复用的技术基础。站点支持模型二次调优、检索增强生成、内容安全过滤等核心功能,覆盖对话交互、信息查询、内容处理等多类自然语言处理场景。适合需要快速搭建专属聊天机器人的开发团队、进行大语言模型应用研究的高校科研人员,以及希望在现有产品中集成AI对话能力的企业技术人员使用,可减少从零开发大语言模型对话系统的成本,降低自定义聊天机器人的开发门槛。
baai-agents.github.io
Cradle框架是由北京智源人工智能研究院推出的通用具身智能框架,核心定位为让大语言模型通过与人类一致的视觉和键鼠交互接口完成复杂计算机任务。其核心功能包括通用人机交互接口适配、复杂环境推理决策、多模态感知信息处理三大模块,支持多场景下的智能体自主操作。该框架面向人工智能研究者、游戏AI开发者、具身智能研究人员为主要目标用户,可应用于游戏AI开发、自动化办公流程研发、通用具身智能算法验证、复杂软件自动化测试等多个场景,目前已通过《荒野大镖客2》游戏任务执行案例验证了其环境泛化与自适应能力。