虚拟人制作
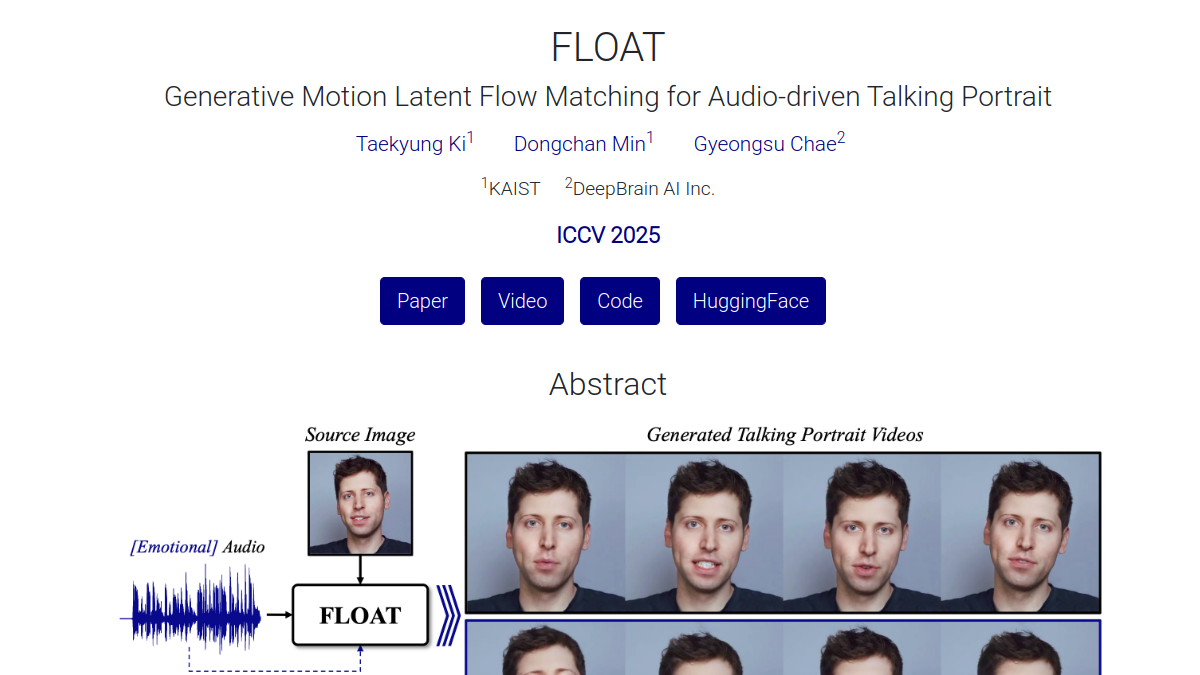

deepbrainai-research.github.io
FLOAT是由深度脑AI研究团队推出的音频驱动人像视频生成技术演示站点,核心定位为基于流匹配生成模型的专业说话人视频生成工具。站点核心功能包括音频驱动的人像视频生成、情感增强运动渲染、多风格运动模式适配,可实现时间一致性的人脸运动合成。目标用户覆盖AI视频研发人员、数字内容创作者、虚拟人开发从业者等,适用于虚拟人直播内容生成、短视频口播素材制作、数字人互动场景开发、学术研究效果验证等多种场景,帮助用户降低说话人视频的制作门槛,提升动态内容生成效率。

syncanimation.github.io
SyncAnimation是基于NeRF技术打造的音频驱动数字人生成框架网站,核心面向数字内容创作、虚拟人开发等领域用户,支持实时生成与音频同步的说话头像及上半身动作。平台内置预训练模型适配不同人像风格,支持自定义3D人像素材导入,还可生成高分辨率的动作序列直接导出使用。适合虚拟主播制作、短视频内容生产、线上会议虚拟形象生成、教育类数字人内容开发等场景,降低实时数字人驱动的技术门槛,帮助用户快速产出符合需求的音画同步数字人内容。

vidboard.ai
vidBoard.ai是由印度vidBoard.ai Pvt Ltd团队开发的生成式AI在线视频创作平台,依托自然语言处理、语音合成、数字人驱动与视觉生成技术,可将多格式内容快速转化为适配不同场景的视频内容。核心功能包含多格式输入自动转视频、AI虚拟形象口播支持、多语言配音与字幕同步,无需专业剪辑设备或经验,即可完成营销、培训、教育、社媒等场景的视频制作,目标用户覆盖企业运营人员、内容创作者、教育工作者、电商从业者等群体,适合需要批量产出视频、降低内容生产成本的各类场景。
fudan-generative-vision.github.io
Hallo2是复旦大学生成视觉团队研发的人像图像动画技术演示站点,核心基于优化后的潜在扩散生成模型,可实现音频驱动的静态人像动效生成。核心功能包括音频驱动长时人像视频生成、4K分辨率视频输出、文本提示辅助表情控制三类,面向AI视频创作者、数字内容制作从业者、高校相关领域研究人员开放,可应用于虚拟数字人内容制作、老照片人像动态化还原、短视频个性化动效创作、学术技术效果验证等多个场景。

synclabs.so
Sync Labs是专注于AI唇形同步技术的技术服务平台,核心为开发者与内容创作团队提供高精度、低延迟的唇形同步API接口。平台支持将任意语言的音频与现有视频人物唇形自动匹配,适配真人实拍、3D动画、2D手绘等多种视频类型,同时提供预处理优化、批量任务调度等配套工具。主要面向影视制作团队、动画创作者、游戏开发厂商、多语言内容发行方等用户,可应用于海外影视译制、虚拟人内容生产、多语言播客视频化、游戏角色配音适配等场景,助力降低内容二次制作的人力与时间成本。
freelipsync.com
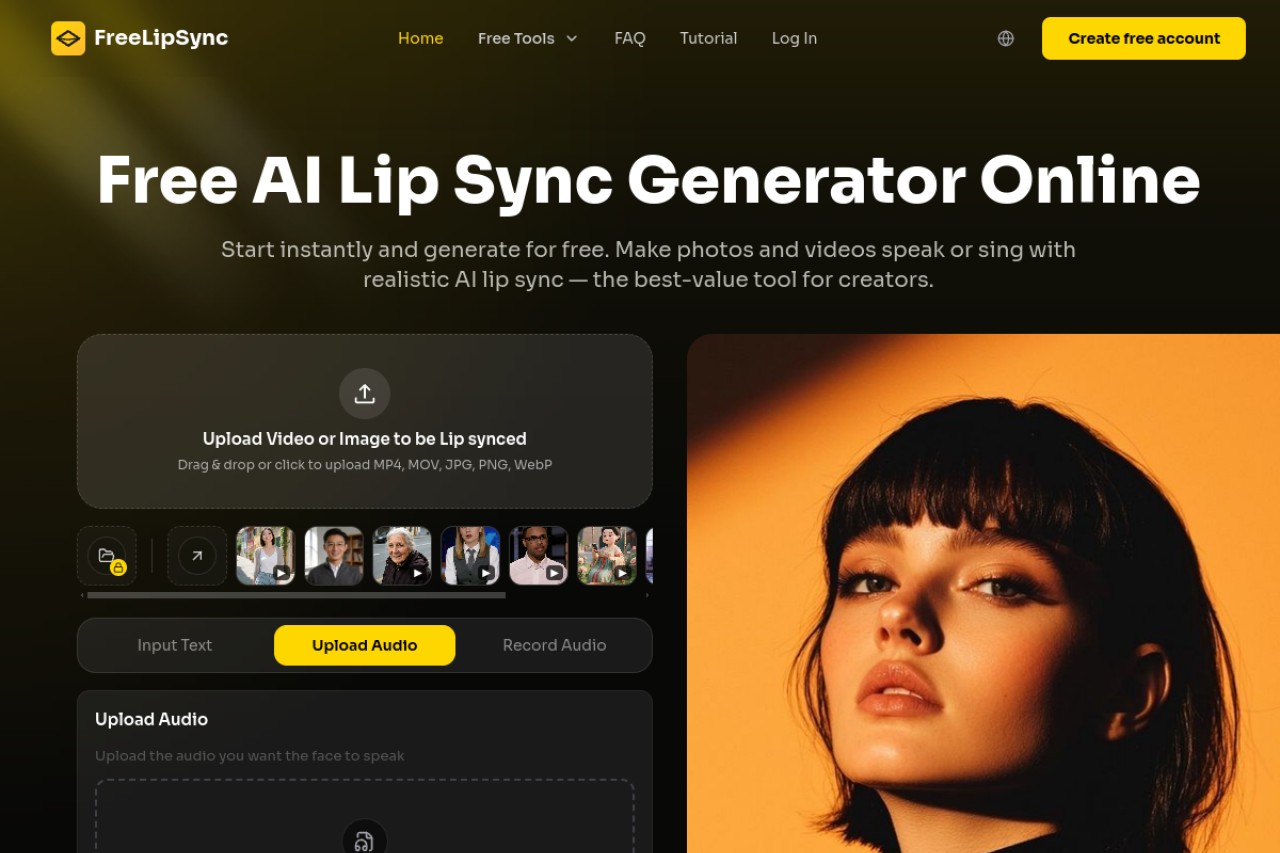
FreeLipSync是一款在线AI口型同步生成工具,核心定位是为用户提供低门槛的音视频口型匹配服务。其核心功能包括文本驱动口型生成、音频匹配口型同步、声音克隆个性化定制三类,支持用户上传静态照片、动态人脸视频作为素材,输入文本或上传音频后即可生成对应口型的说话、唱歌类视频内容。目标用户覆盖内容创作者、教育工作者、短视频运营者、多媒体设计人员等群体,适用于制作科普讲解视频、虚拟人物出镜内容、多语言配音口型匹配、创意短视频产出等多个场景,使用过程无需注册账号、无需绑定信用卡,生成内容无水印。

movmi.co
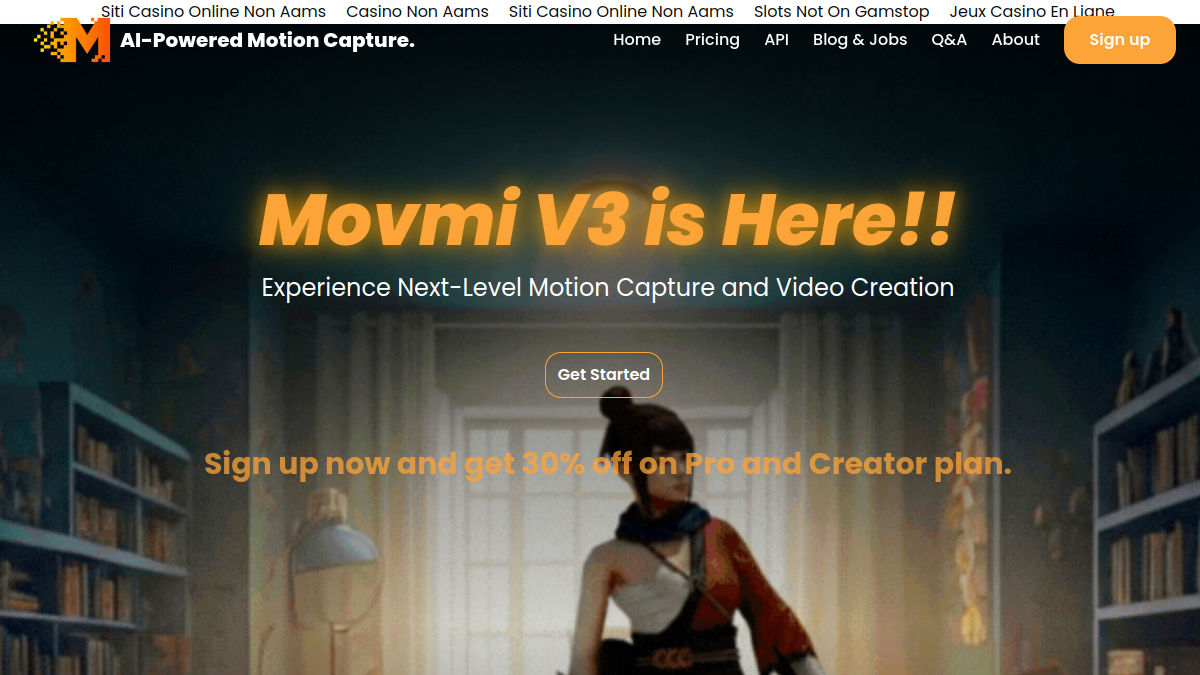
Movmi是一款基于AI技术的云端动作捕捉工具,核心定位是为内容创作者与开发人员提供无需高端硬件的人体动作捕捉解决方案。其核心功能包括通过普通2D图像或视频完成人体动作捕捉、支持多人场景动作识别、配套可商用角色素材库,用户无需购置动捕服、深度摄像头等专业设备,仅需普通拍摄设备采集的素材即可完成动捕流程。目标用户覆盖3D动画制作者、游戏开发者、虚拟内容创作者、影视后期人员等群体,可应用于独立动画项目制作、游戏角色动作导入、虚拟主播动作驱动、短视频3D内容创作等多个场景,输出的FBX格式文件可适配各类主流3D创作环境。
wav2lip.org
Wav2Lip是一款基于AI技术,实现音频驱动人物唇形同步的工具,核心定位是通过输入目标音频和人物图像,自动生成唇形与音频内容精准匹配的视频内容。它支持多种语言、多种人物形象的唇形合成,可处理包含遮挡的面部图像,也能适配不同分辨率的输入素材。核心功能包括音频唇形同步生成、多语种适配、遮挡场景处理、视频批量处理和风格输出调整,目标用户覆盖内容创作者、影视后期从业者、配音行业从业者、教育内容制作者、短视频创作者和广告营销人员,适用于视频配音修正、多语言内容本地化、虚拟数字人内容制作、教学视频配音更新等多种场景。

apparate.ai
PROTEUS是Apparate Labs推出的AI实时人脸表情生成基础模型,核心定位为语音驱动的视觉交互接口解决方案。其核心功能包括实时高帧率表情生成、多大型语言模型兼容、自定义应用适配,依托Transformer架构的潜在扩散模型技术,可实现低延迟的人脸动态表情输出。目标用户覆盖AI虚拟人开发者、智能客服服务商、线上教育平台运营者、互动娱乐内容制作方等群体,可应用于虚拟主播直播、AI助手可视化交互、线上课程数字讲师搭建、元宇宙虚拟角色互动等多种场景,为人工对话实体提供直观的视觉呈现载体。
jshilong.github.io
FlashFace是一款基于人工智能技术的人脸图像生成与编辑工具,核心定位为面向创作者和技术使用者的人脸内容生成平台,依托特征图编码人脸身份技术与解耦集成策略,可实现高还原度的人脸特征保留,同时支持语言提示驱动的人脸内容调整。核心功能包括提示词驱动人脸交换、人脸身份特征保留生成、多风格人脸图像输出三大类,目标用户覆盖AI图像创作者、影视后期制作人员、数字内容开发人员等群体,适用于短视频内容创作、虚拟数字人形象定制、影视角色换脸测试、数字艺术创作、科研人脸数据集生成等多种场景,能够帮助用户快速生成符合需求的人脸类图像内容。
facy.ai
Facy是一款以AI技术为核心的人脸与虚拟形象生成平台,专注为各类创意项目提供合规可用的虚拟人脸素材。平台支持自定义人脸属性参数生成、风格化虚拟形象制作、批量素材导出等功能,可满足用户无需拍摄即可获取多样面部素材的需求。目标用户覆盖平面设计师、市场营销从业者、内容创作者、游戏开发人员、UI设计师等群体,适用于广告海报人物设计、虚拟IP形象制作、游戏角色面部建模、测试样本素材生成、数字内容配图等多种场景,帮助用户降低素材获取成本,规避真人肖像权使用风险。

teditcam.vistring.com
说得相机是面向口播视频创作者打造的智能拍摄工具,核心围绕口播拍摄的全流程需求设计,具备智能自适应提词、无绿幕实时抠像、虚拟演员拍摄三大核心功能,覆盖短视频博主、知识内容创作者、企业营销人员、自媒体从业者等用户群体,可满足知识口播视频制作、产品宣传视频拍摄、企业内部培训素材产出、个人短视频账号内容创作等多个场景的使用需求,帮助用户降低口播视频拍摄的操作门槛,减少拍摄及后期处理的时间投入。

cyberhost.github.io
CyberHost是一个端到端音频驱动的人体动画生成框架,核心定位是为音频内容匹配符合逻辑的人体全身动态效果。其核心功能包括基于区域码本注意力机制的人体动作生成,可保障手部动作完整性与人物身份一致性;采用双U-Net架构作为基础结构,配合运动帧策略实现动画的时间延续性;支持零样本音频驱动人体视频生成,无需针对特定人物提前训练即可输出自然动态。目标用户覆盖计算机视觉研究人员、动画制作从业者、数字内容创作者、人机交互开发人员等,可应用于虚拟人直播动作生成、短视频数字人内容制作、元宇宙虚拟形象驱动、动画前期动作预演等多种场景。
loopyavatar.github.io
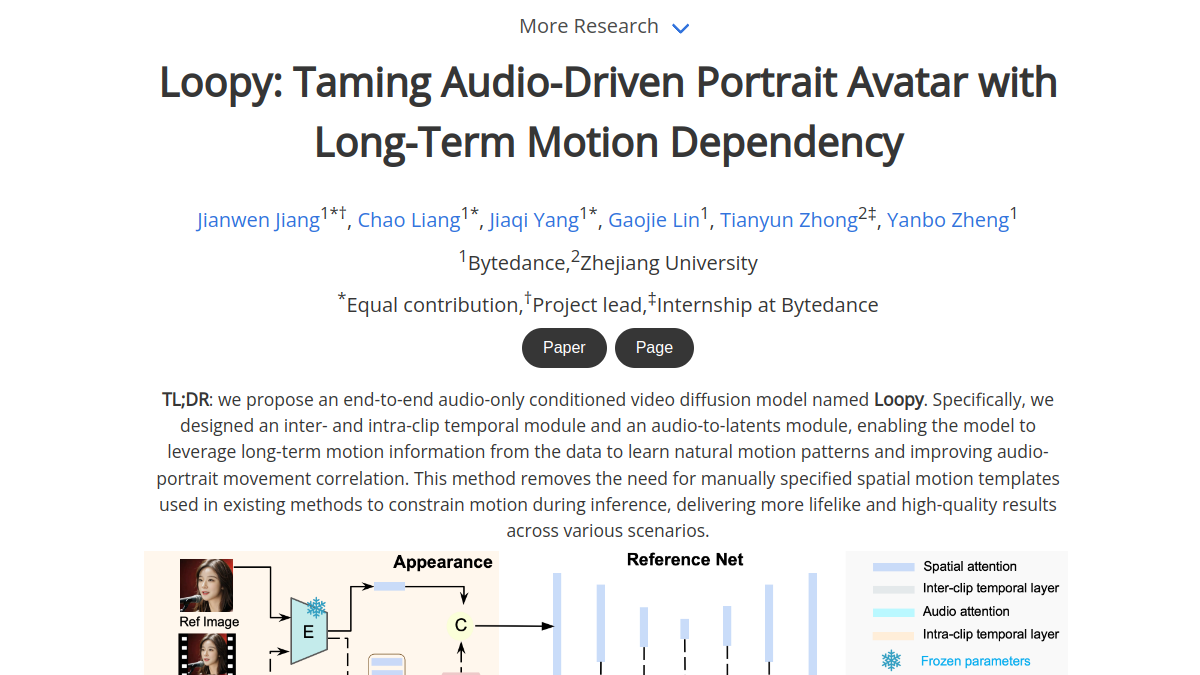
Loopy model是专注于音频驱动肖像视频生成的AI工具站点,核心基于端到端的音频驱动视频扩散模型架构,可实现音频与面部动作的精准匹配。核心功能包括支持用户上传肖像图片与对应音频文件生成同步口型与面部表情的动态视频,内置跨剪辑与内部剪辑时间模块保障长视频动作连贯性,无需手动设置空间运动模板即可输出自然的动态肖像效果。面向的目标用户包含AI内容创作者、数字人开发从业者、短视频制作人员、动画设计人员等,适用于数字人主播视频制作、虚拟角色配音动效生成、个人纪念动态肖像制作、教学类口播视频批量生产等多种场景。
buaavrcg.github.io
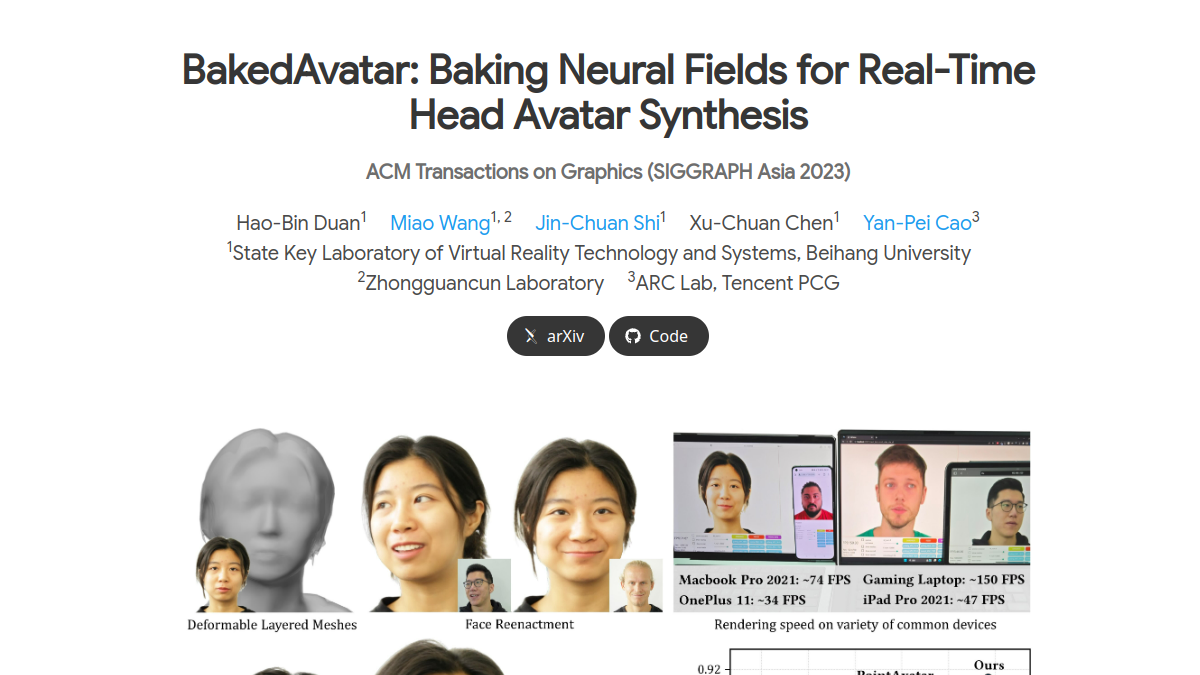
BakedAvatar是面向实时神经头像合成领域的技术项目站点,核心是可兼容标准多边形光栅化流水线的神经头像表示方案。该项目提供了完整的三阶段神经头像合成技术框架,支持从单眼视频生成4D动态头像,可实现表情编辑、视角合成等操作。目标用户覆盖计算机图形学研究人员、游戏开发人员、虚拟人制作从业者、数字内容创作者、高校计算机相关专业学生等群体,可应用于实时虚拟人驱动、影视角色制作、VR/AR虚拟形象生成、人脸动画效果研发等多种场景,为降低实时神经头像的部署门槛提供了技术路径。

innaio.com
InnAIO是聚焦AIGC领域的视频创作综合服务平台,核心定位为文字生成视频、虚拟人内容生产、AI直播一体化的创作工具。核心功能包括文本驱动的AI视频生成、自定义虚拟人形象克隆、多语言语音复刻、多平台无人直播部署,目标用户覆盖内容创作者、企业营销人员、教育讲师、跨境电商从业者等群体,可应用于产品宣传视频制作、知识科普内容产出、跨境多语种视频分发、虚拟人直播带货等多个场景,帮助用户降低视频生产的人力和时间成本。
yukun-huang.github.io
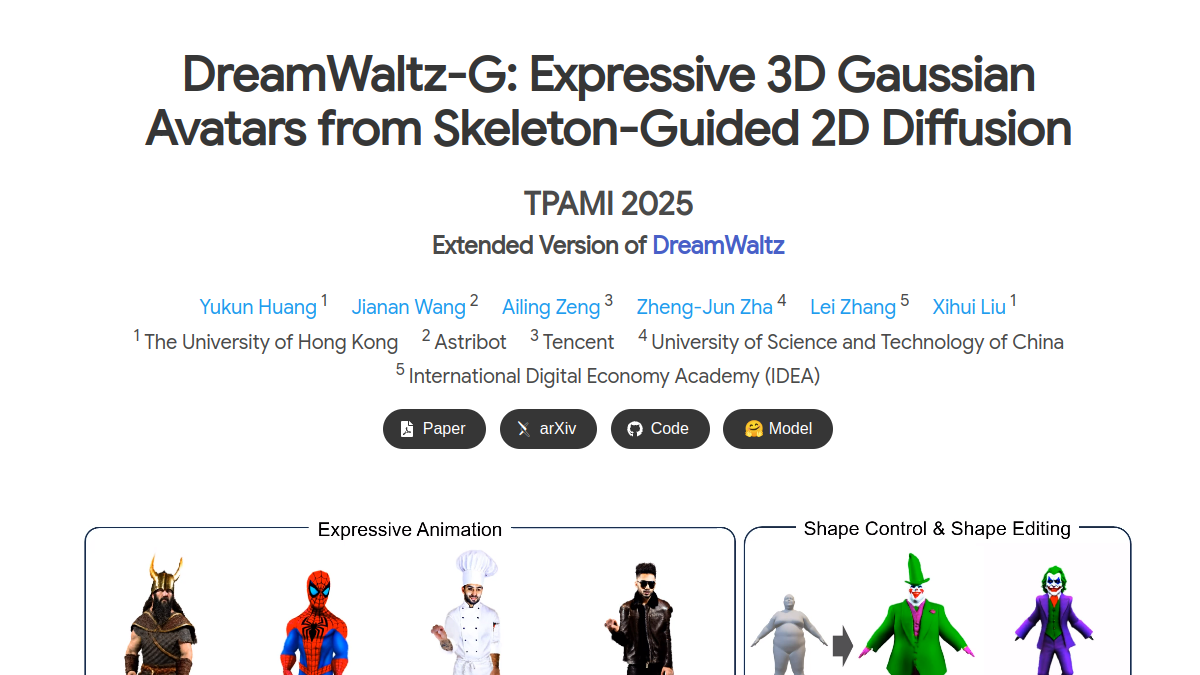
DreamWaltz-G是一款面向3D内容创作领域的文本驱动3D头像与全身动画生成框架官网,核心定位是为3D创作者、研究人员提供可控性强的3D数字人生成解决方案。核心功能包括文本驱动3D头像生成、骨架引导的全身动画制作、混合3D高斯实时渲染,目标用户覆盖计算机图形学研究人员、游戏3D美术设计师、虚拟数字人创作者、动画制作从业者等群体,可应用于虚拟偶像内容制作、游戏角色原型设计、学术3D生成方法验证、短视频虚拟角色动画创作等多种场景,帮助用户降低3D数字人内容的制作门槛,提升生成内容的视角与姿势一致性。

xg-chu.site
GAGAvatar是基于高斯模型的3D头像重建与动画生成技术服务站点,核心定位是为有3D数字头像制作需求的用户提供单图驱动的头像生成与动画方案。核心功能包括单张图片快速生成3D高保真头像、实时面部表情动画驱动、跨身份面部特征泛化适配,目标用户覆盖数字内容创作者、游戏开发人员、虚拟人从业者、计算机视觉研究者等,可应用于虚拟主播形象制作、游戏角色自定义、影视数字替身快速生成、学术研究数据集构建等多个场景,降低3D头像制作的技术门槛与时间成本。
act-one.org
Act-One.org是RunwayML推出的AI角色动画生成平台,核心定位是通过AI技术降低专业面部动画制作门槛。平台支持普通视频输入转化为高保真角色动画、多角色对话场景自动生成、自定义角色形象适配三大核心功能,面向动画创作者、影视后期人员、游戏开发团队、内容创作者等群体,可应用于独立动画制作、虚拟人内容产出、游戏角色动效设计、影视预演场景搭建等多种场景,无需专业动捕设备即可完成具有真实表现力的角色表演制作。