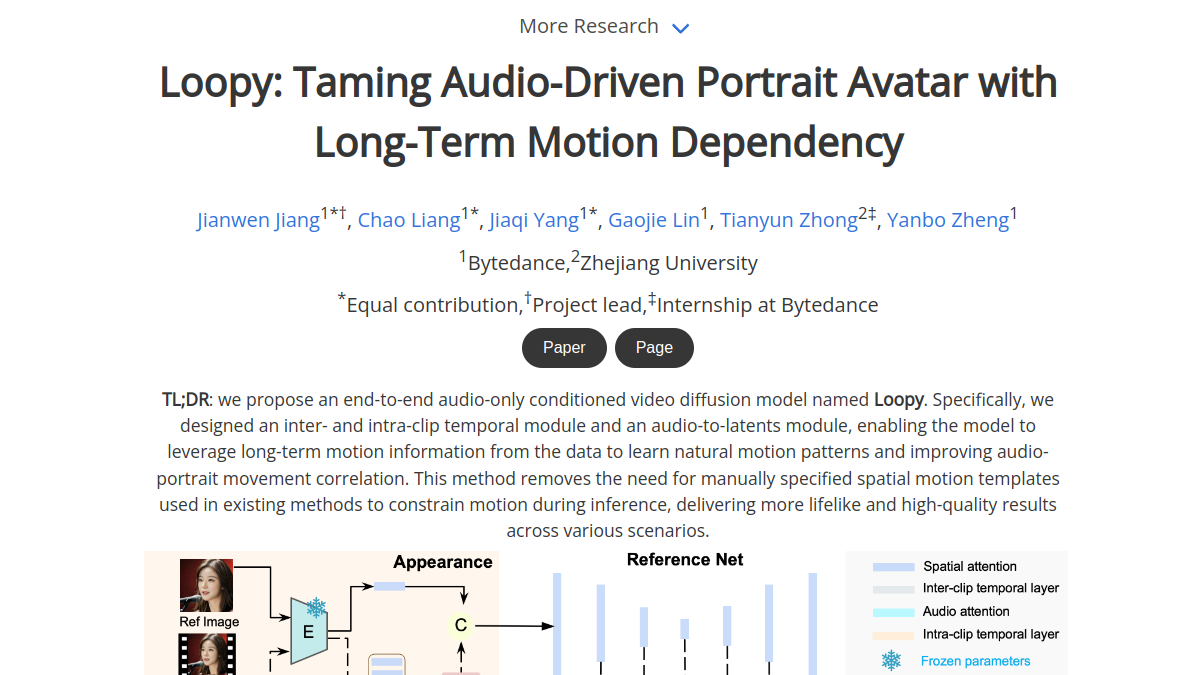
Loopy model是专注于音频驱动肖像视频生成的AI工具站点,核心基于端到端的音频驱动视频扩散模型架构,可实现音频与面部动作的精准匹配。核心功能包括支持用户上传肖像图片与对应音频文件生成同步口型与面部表情的动态视频,内置跨剪辑与内部剪辑时间模块保障长视频动作连贯性,无需手动设置空间运动模板即可输出自然的动态肖像效果。面向的目标用户包含AI内容创作者、数字人开发从业者、短视频制作人员、动画设计人员等,适用于数字人主播视频制作、虚拟角色配音动效生成、个人纪念动态肖像制作、教学类口播视频批量生产等多种场景。
- 运营状态
- 正常运营
- 地址
- loopyavatar.github.io
- 定价模式
- 基础功能免费
- 支持平台
- Web 网页
- 是否开源
- 闭源
- 适合人群
- AI内容创作者、短视频运营人员、数字人开发从业者、动画设计人员
- 收录时间
- 2026/6/14
- 访问量
- 0 次
编辑点评
这是一个在音频驱动肖像生成领域颇具特点的AI工具站点,和同类工具相比,它最大的特点是不需要手动设置复杂的面部锚点和运动模板,对于没有专业动效制作基础的用户也能上手使用。其内置的时间模块解决了很多同类工具生成长视频时动作跳变的问题,在几分钟长度的视频生成场景下,动作连贯性表现突出,同时音频和表情的匹配度也较高,不仅能匹配口型,还能对应音频的情绪呈现对应的微表情。目前站点的使用流程比较简洁,上传素材后即可自动生成,适合需要批量制作数字人口播视频的内容创作者使用,也适合数字人相关的开发人员作为效果参考工具,输出的视频画质可以满足大多数线上发布场景的需求,不需要额外做太多后期调整。
核心功能
使用指南
- 1
打开Loopy model官网首页,浏览站点的功能说明与效果展示案例,确认生成效果符合自身的使用需求,准备好需要使用的静态肖像图片与对应音频文件。
- 2
点击页面中的上传入口,依次上传准备好的静态肖像图片,需保证图片中面部清晰无遮挡,再上传需要匹配的音频文件,支持常见的MP3、WAV等音频格式。
- 3
在参数设置区域根据自身需求调整视频时长、分辨率等可选参数,若没有特殊需求可直接使用系统默认参数,确认上传的素材与参数无误后提交生成请求。
- 4
等待系统完成生成过程,期间可查看页面上的进度提示,生成时长根据视频长度有所区别,通常数分钟内即可完成处理。
- 5
生成完成后可在线预览生成的动态肖像视频,确认效果符合预期即可下载视频文件到本地,若效果不满意可调整素材或参数后重新提交生成。
优势与不足
优点5 项
"无需手动设置空间运动模板与面部锚点,降低了动态肖像制作的操作门槛"
"内置双重时间模块,长视频生成时动作过渡自然,无明显跳变问题"
"音频到潜在表示模块提升了音频与面部动作、表情的关联度,匹配度较高"
"支持写实人像、二次元形象等多种类型的肖像素材,适配范围较广"
"输出视频画质清晰,无明显生成伪影,可直接用于多数线上发布场景"
不足4 项
"目前站点没有提供内置的肖像编辑功能,上传前需要用户自行处理图片素材"
"生成长视频时的等待时间较长,大体积音频文件处理效率有待提升"
"暂不支持实时生成与直播推流对接,无法直接用于实时直播场景"
"没有提供多人物同时生成的功能,单次只能处理单张肖像的生成需求"
定价说明
当前Loopy model处于公开测试阶段,所有用户均可免费使用基础生成功能,免费版支持生成最高1080P分辨率、时长5分钟以内的动态肖像视频,单日单用户最多可提交5次生成请求,无水印与商用限制。后续预计会推出付费版本,针对有更高清分辨率、更长时长、更多生成次数需求的用户提供专属服务,付费版价格暂未公布,建议有高频使用需求的用户可以先使用免费版测试效果,后续关注站点的付费功能更新公告。
价格和授权政策可能变化,请以官网最新信息为准
适合人群与场景
- AI内容创作者
制作数字人短视频内容
- 短视频运营人员
批量生产口播类视频
- 数字人开发从业者
测试音频驱动肖像效果
- 动画设计人员
制作虚拟角色动效内容
- 教育行业工作者
制作课程讲解口播视频
- 电商从业者
制作商品讲解数字人视频
- 个人用户
制作纪念类动态肖像内容
- 游戏开发者
制作游戏角色配音动效
常见问题
深度了解
在数字人内容创作需求快速增长的当下,音频驱动肖像生成工具成为很多内容创作者的刚需,Loopy model作为一款基于端到端视频扩散模型的AI工具,为用户提供了低门槛的动态肖像生成方案。用户无需掌握专业的动效制作技术,也不需要手动设置复杂的面部锚点与运动模板,只需上传静态肖像图片与对应音频,即可生成口型、表情与音频高度匹配的动态视频。
Loopy model专门设计的跨剪辑和内部剪辑时间模块,解决了同类工具生成长视频时动作跳变、连贯性差的问题,即使是数分钟长度的口播视频,也能保持动作过渡自然,符合真实人物的运动规律。其音频到潜在表示模块,还能深度解析音频中的情绪特征,匹配对应的微表情,让生成的动态肖像更具真实感,不仅适配写实类人像,也支持二次元虚拟形象、手绘肖像等多种素材类型,覆盖更多创作场景。
不管是需要批量制作口播视频的短视频运营者,还是开发数字人产品的技术人员,或是想要制作动态纪念肖像的普通用户,都可以通过Loopy model满足自身的动态肖像生成需求。目前站点处于测试阶段,所有用户都可以免费使用基础功能,生成的视频无水印可商用,能够满足大多数用户的创作需求。
Ready to try
准备好体验 Loopy model 了吗?
点击下方按钮在新标签页打开官网,开始探索它的全部功能。
相关工具
Wav2Lip
Wav2Lip是一款基于AI技术,实现音频驱动人物唇形同步的工具,核心定位是通过输入目标音频和人物图像,自动生成唇形与音频内容精准匹配的视频内容。它支持多种语言、多种人物形象的唇形合成,可处理包含遮挡的面部图像,也能适配不同分辨率的输入素材。核心功能包括音频唇形同步生成、多语种适配、遮挡场景处理、视频批量处理和风格输出调整,目标用户覆盖内容创作者、影视后期从业者、配音行业从业者、教育内容制作者、短视频创作者和广告营销人员,适用于视频配音修正、多语言内容本地化、虚拟数字人内容制作、教学视频配音更新等多种场景。
Prism
Prism是集成多种AI模型,面向内容创作者的短视频生成、管理与编辑AI平台,支持从文本提示生成完整短视频内容,也可对已有素材进行AI辅助编辑,还提供云端内容管理存储服务。核心功能包含AI文本生视频、智能素材剪辑、自动字幕生成、云端素材管理、视频风格迁移等,适合自媒体创作者、营销人员、短视频博主、教育内容开发者等用户使用,可满足短视频内容快速产出、社交媒体内容更新、商业营销视频制作、课程短视频开发等多种场景需求。
FreeLipSync
FreeLipSync是一款在线AI口型同步生成工具,核心定位是为用户提供低门槛的音视频口型匹配服务。其核心功能包括文本驱动口型生成、音频匹配口型同步、声音克隆个性化定制三类,支持用户上传静态照片、动态人脸视频作为素材,输入文本或上传音频后即可生成对应口型的说话、唱歌类视频内容。目标用户覆盖内容创作者、教育工作者、短视频运营者、多媒体设计人员等群体,适用于制作科普讲解视频、虚拟人物出镜内容、多语言配音口型匹配、创意短视频产出等多个场景,使用过程无需注册账号、无需绑定信用卡,生成内容无水印。

Sync Labs
Sync Labs是专注于AI唇形同步技术的技术服务平台,核心为开发者与内容创作团队提供高精度、低延迟的唇形同步API接口。平台支持将任意语言的音频与现有视频人物唇形自动匹配,适配真人实拍、3D动画、2D手绘等多种视频类型,同时提供预处理优化、批量任务调度等配套工具。主要面向影视制作团队、动画创作者、游戏开发厂商、多语言内容发行方等用户,可应用于海外影视译制、虚拟人内容生产、多语言播客视频化、游戏角色配音适配等场景,助力降低内容二次制作的人力与时间成本。
Seedance 2 Video Generator
Seedance 2 Video Generator是字节跳动推出的AI视频生成平台,核心定位是通过AI技术将文本描述或输入图像生成符合创作需求的视频内容。平台支持文本生成视频、图像参考生成视频、画面风格自定义、视频时长调整、镜头运镜设置等功能,面向内容创作者、影视创作者、新媒体运营人员、产品设计师、营销策划人员、教育工作者提供视频创作服务,可应用于短视频内容创作、影视概念片制作、营销广告片生成、课程演示视频制作等多种场景,帮助创作者降低视频制作门槛,提升内容产出效率。

audio2face
Audio2Face是NVIDIA推出的基于AI的音频转面部动画技术服务,核心定位是为创作者提供音频驱动的高精度面部表情生成能力。核心功能包括实时音频流唇形同步、多语言面部动画适配、自定义面部绑定输出三类,可自动匹配音频内容生成对应的唇部动作、面部肌肉微表情及头部微动作,无需手动逐帧调整。该服务面向数字人开发者、影视动画制作者、游戏内容创作者、VR/AR内容从业者等群体,适用于虚拟主播实时驱动、影视角色动画制作、虚拟偶像内容生产、元宇宙场景数字人交互等多个场景,能够有效降低面部动画制作的人力与时间成本。
LipsyncX
LipsyncX是一款专注于AI写实对口型生成的在线工具,支持长视频处理与多语言配音适配,可精准匹配原视频人物口型与输入语音内容。核心功能包含AI对口型生成、多语言语音适配、长视频分段处理、自定义语音输入、视频分辨率导出。目标用户覆盖内容创作者、本地化运营人员、视频剪辑师、自媒体博主、跨境内容从业者,适合用于影视内容本地化翻译、短视频口型修改、多语言内容出海制作、错口型视频修正等场景。
LipSync.video
LipSync.video是一款在线AI口型同步生成工具,核心定位为通过AI技术实现音频驱动视频人物口型匹配,自动生成符合音频内容的口型同步视频。该工具支持上传自定义视频与音频文件,可快速完成口型对齐处理,支持多种语言语音识别匹配,无需本地安装复杂软件,通过浏览器即可完成操作。核心功能包含AI口型同步生成、多格式文件支持、在线预览处理结果、自定义分辨率导出、无水印基础输出等,适合内容创作者、视频剪辑师、本地化内容运营者等用户使用,可应用于外语视频配音本地化、教学视频口型修正、短视频口型调整等多种场景。
你是 Loopy model 的开发者或团队吗?
认领后可编辑工具信息、获取真实点击数据,并在页面上展示官方认证徽章。
访问第三方工具时,请注意账号、隐私与支付安全
用户评论
0· 0 条