大模型测试

epochai.org
FrontierMath是专注于人工智能数学推理能力评估的基准测试平台,由60余位数学家联合打造,核心用于衡量大语言模型等AI系统解决前沿复杂数学问题的能力上限。平台覆盖代数几何、数论、拓扑学、Zermelo-Fraenkel集合论等现代数学全领域问题,所有测试题均为未公开发表的原创内容,可规避训练数据泄露导致的测试结果失真问题。其目标用户包括AI研发团队、数学研究人员、高校AI相关专业师生,适用于AI数学推理能力迭代测试、前沿数学问题研究辅助、AI大模型能力横向对比评估等场景。

gradientj.com
GradientJ是面向自然语言处理场景的应用开发管理平台,基于GPT-4等主流大语言模型能力,为用户提供NLP应用全生命周期管理服务。平台支持提示词版本迭代、应用多场景效果测试、生产环境一键部署三大核心功能,主要服务有NLP应用开发需求的个人开发者、企业技术团队、AI产品经理等群体,可应用于智能客服聊天机器人搭建、企业内部问答系统开发、自定义内容生成工具落地等场景,帮助用户降低大模型应用落地的技术门槛,提升NLP项目开发效率。
parea.ai
Parea AI是面向大语言模型应用开发场景的LLM全流程管理平台,核心定位是为开发者提供标准化的LLM应用性能优化解决方案。平台支持多版本提示词并行实验、自动化测试用例评估、一键式提示词调优三大核心功能,面向LLM应用开发者、AI产品经理、算法测试人员等群体,可应用于AI对话系统开发、智能客服模型迭代、内容生成工具优化等多种场景,帮助使用者建立规范化的LLM开发流程,降低反复调试模型的时间成本。
llm-playground-ten.vercel.app
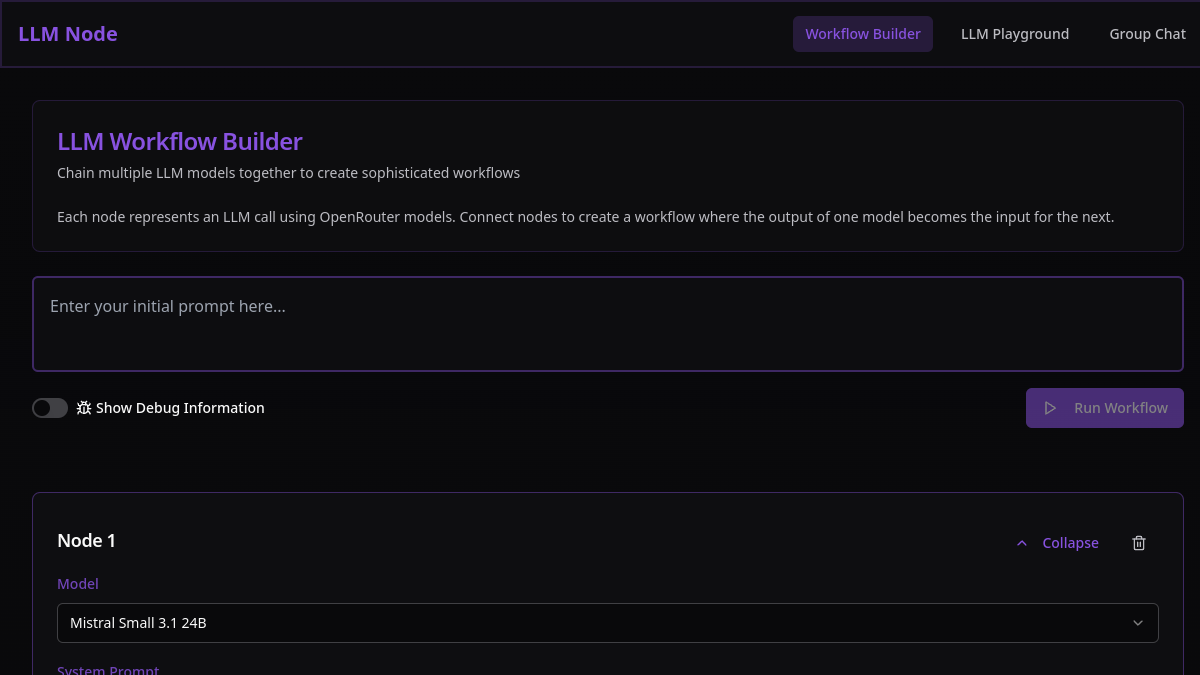
LLM Playground是专注于大语言模型在线测试与对比的开放实验平台,核心定位是为AI领域相关人群提供无本地部署成本的大模型交互环境。平台支持多模型并行对比测试、自定义参数调试、对话历史记录导出三大核心功能,面向AI开发者、算法研究者、产品经理、高校AI专业学生等人群,可应用于模型选型评估、参数调优实验、prompt效果验证、教学演示等多种场景,帮助用户直观了解不同大语言模型的能力差异与适配场景。
alle-ai.com
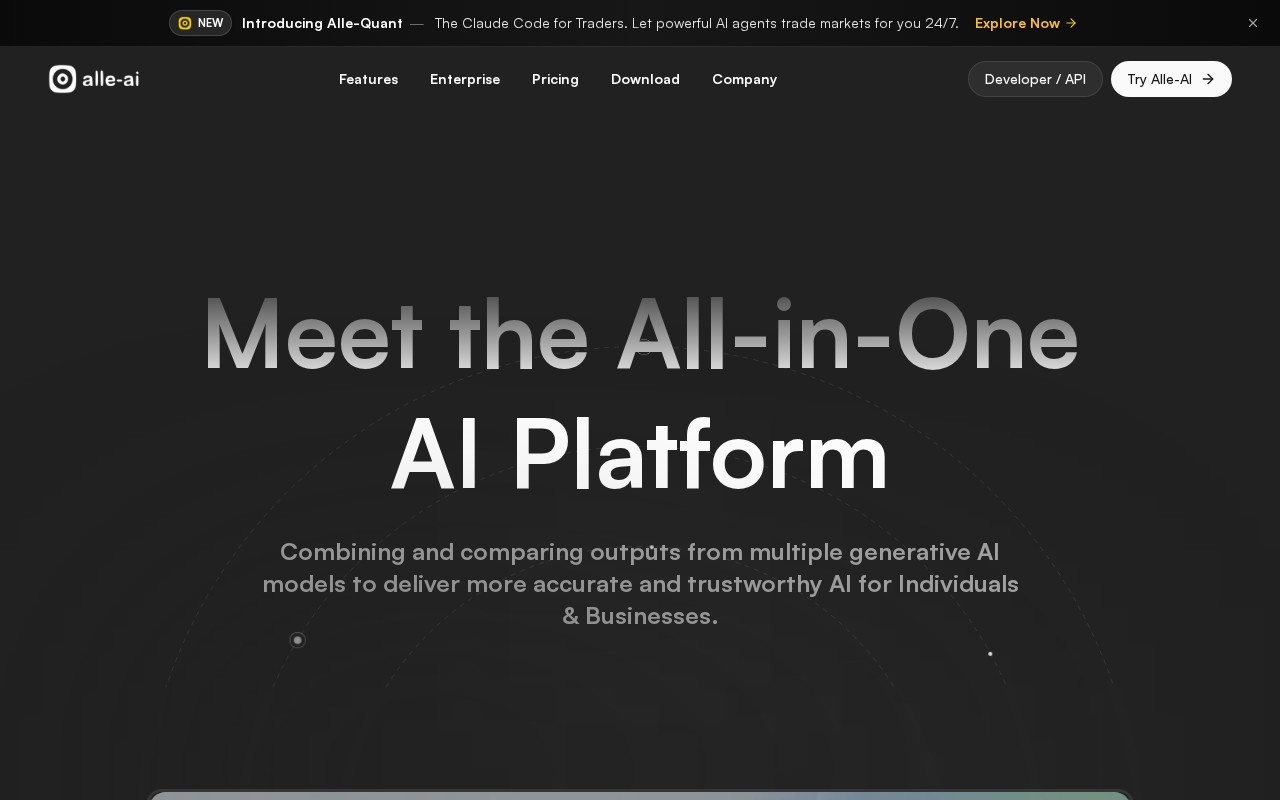
Alle-AI是一个一体化人工智能对比测试平台,核心定位为帮助用户完成不同生成式AI模型的横向对比测试与结果整合处理。平台支持同时调用多个主流大语言模型与图像生成模型,一次性获取多个模型的输出结果,方便用户直观对比不同模型的输出差异。用户可在此基础上对多个模型的输出内容进行结合编辑,生成符合自身需求的最终内容。核心功能包含多模型同步调用、结果对比展示、输出整合编辑、自定义模型配置等,面向AI研究者、内容创作者、产品开发人员、AI测评爱好者等群体,适用于模型效果测试、多维度内容生成、创意灵感搜集、AI工具选型等场景。

atla-ai.com
Selene API是Atla AI推出的人工智能评估模型服务平台,核心定位是为AI应用开发者提供专业的模型效果评估能力。平台搭载LLM-as-a-Judge技术,可对各类AI应用输出内容进行多维度评分,同时生成可落地的优化反馈意见,还支持自定义评估规则适配不同业务场景。目标用户覆盖AI产品开发者、算法工程师、AI产品经理、AI安全研究人员等群体,可应用于AI模型上线前效果校验、迭代版本效果对比、AI生成内容合规性检测、模型回答质量日常巡检等多个场景,帮助开发者降低人工评估成本,提升AI应用的落地质量。

gentrace.ai
Gentrace是一款面向生成式AI全生命周期管理的协作评估与观测平台,核心定位为帮助团队系统性把控生成式AI应用的输出质量、运行效率与资源成本。平台支持AI自动评估与自定义启发式规则评估结合的质量校验体系,可对生产环境中AI应用的响应速度、调用成本进行实时追踪,还能支持多人协作标注评估结果沉淀团队校验标准。其目标用户覆盖AI产品经理、算法工程师、测试工程师、业务运营等不同角色,适用于大语言模型应用上线前的效果验证、上线后的运行状态观测、迭代版本的效果对比、异常输出的根因定位等多个场景,助力团队降低生成式AI应用的落地风险,提升迭代效率。

generatedby.com
Generatedby.com是专注于AI提示词全生命周期管理的在线服务平台,核心定位是为提示词相关从业者提供从创作到落地的一站式工具支持。其核心功能包含提示词编辑优化模块,支持多维度调整提示词参数适配不同大模型;多模态与多LLM兼容模块,可同时适配文本、图像、音频类生成模型的提示词调试;轻量应用生成模块,支持将成熟提示词快速封装为可直接使用的表单、聊天交互应用。目标用户覆盖AI提示工程师、内容创作从业者、企业数字化运营人员等,可满足日常提示词调试、团队内部提示词共享复用、轻量AI工具快速落地等多种场景需求。

ntwind.com
PromptSense是ntwind推出的跨平台AI提示词管理测试优化工具,核心定位是帮助用户系统化处理各类AI场景下的提示词资产,提升大模型输出效果。其核心功能包含多端同步的提示词版本管理、多模型并行的Prompt效果对比测试、基于调用数据的提示词参数优化,适合AI从业者、内容创作者、产品研发人员等群体,可应用于日常AI内容生成、AI产品功能调试、企业级Prompt资产沉淀等多种场景,帮助用户搭建标准化的提示词工作流程,降低重复调试的时间成本。

langtail.com
Langtail是专注于大语言模型提示全生命周期管理的协作平台,核心定位为帮助开发团队、产品团队降低LLM应用落地的流程成本。平台支持提示词版本迭代管理、多模型效果对比测试、调用数据全链路追踪三大核心功能,同时内置团队权限分配、环境隔离发布等配套能力。主要面向AI应用开发者、产品经理、AI项目运营人员、算法调优工程师等用户,可应用于对话机器人开发、AIGC内容生成系统搭建、企业内部AI助手落地、大模型应用性能优化等多种业务场景,帮助团队建立标准化的LLM应用迭代流程,减少跨部门沟通成本,提升提示词迭代的透明度与可追溯性。
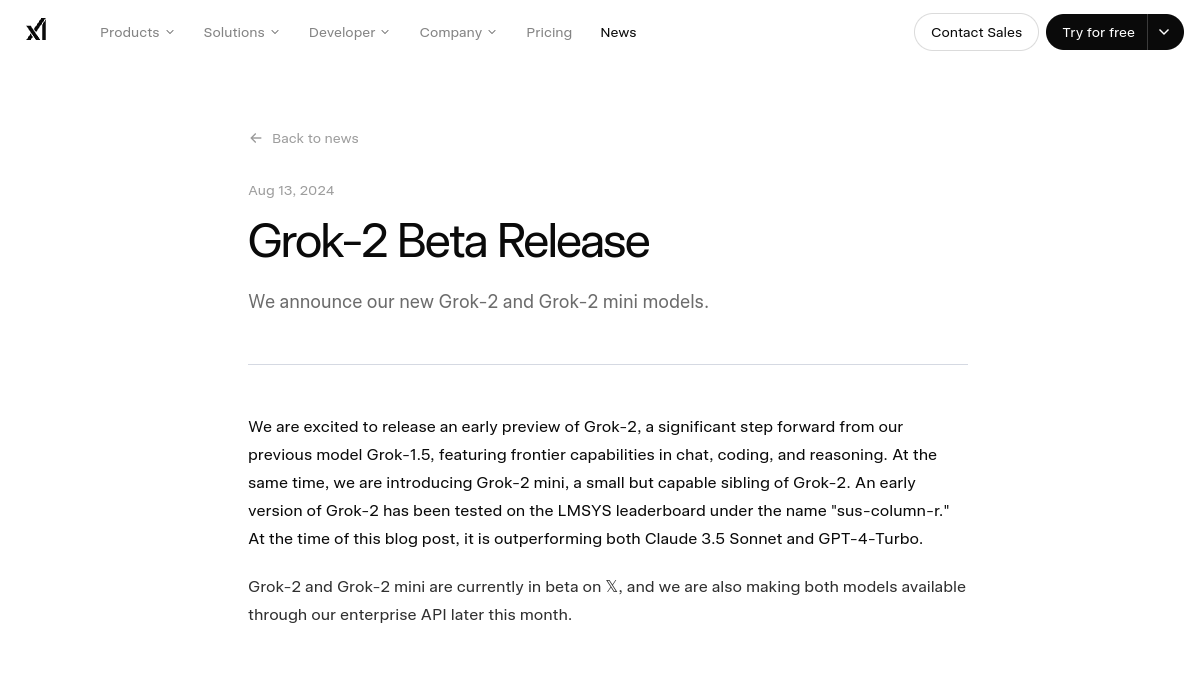

Grok-1.5 Vision Preview是X.AI推出的多模态模型官方介绍页面,核心定位为展示新一代多模态大模型的技术特性与能力边界。页面公开了模型在文本与多模态信息处理上的核心表现,包括复杂文档内容解析、多类型图表数据解读、现实场景视觉信息理解三大核心功能,面向AI技术研究者、企业技术开发人员、多模态应用从业者、普通AI产品用户,可用于了解模型技术参数、评估模型适配场景、申请测试资格、获取后续版本更新信息。

lastexam.ai
Humanity's Last Exam 是面向大型语言模型学术能力评估的多模态基准测试平台,由全球多领域专家联合开发。核心功能包括覆盖100余个学科的标准化试题库、支持多模态模型的统一测试流程、自动化生成详细学术能力评估报告。目标用户覆盖AI模型研发团队、高校人工智能研究人员、AI行业评测机构、科技企业算法开发部门等,可用于大模型学术能力摸底测试、不同模型学术能力横向对比、模型迭代效果验证、AI学术评测相关研究等场景,为人工智能技术在学术领域的性能优化提供参考依据。
llmplayground.net
LLMPlayground是一个聚合多类大型语言模型的在线测试平台,核心定位为供开发者、研究人员以及AI爱好者集中测试不同大语言模型的交互表现。平台支持自定义模型参数调整、多模型并行对比测试、prompt模板分享存储、对话历史管理等核心功能,无需本地部署环境,用户可直接在线调用各类主流开源与闭源大语言模型,降低了多模型测试的门槛。目标用户涵盖AI开发从业者、大模型研究人员、AI产品测试人员以及AI爱好者,适合用于大模型能力对比测试、prompt效果验证、新模型体验评估、AI应用原型开发调试等使用场景。

evalmy.ai
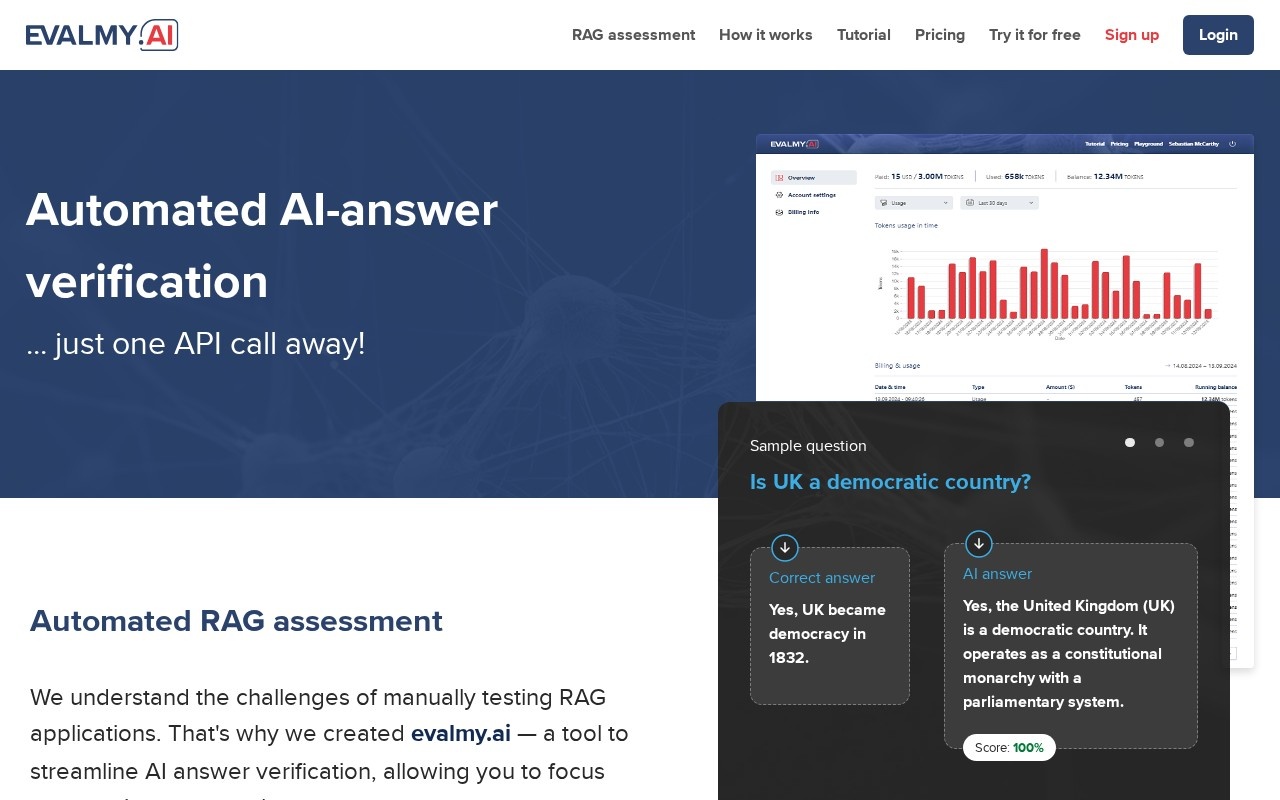
EvalMy.AI是一款专注于人工智能生成内容答案验证的在线服务平台,依托C3-score评价体系实现自动化验证流程,帮助相关从业者校验AI生成内容的准确性与合理性。平台核心功能包含C3-score自动化验证、批量内容处理、验证报告生成、自定义验证规则配置、结果数据导出等,面向AI模型开发者、内容审核团队、大语言模型研究人员、AI应用测试工程师等用户,可满足AI生成内容准确性校验、模型输出效果对比测试、批量AI内容审核等多种使用场景。
klu.ai
Klu是面向大语言模型应用开发全流程的工作平台,核心定位是帮助开发者完成LLM应用的设计、部署与效果优化工作。平台支持多模型并行对比测试,可实时采集用户交互数据完成模型效果调优,还内置应用快速部署能力无需额外搭建服务器。目标用户覆盖AI应用开发者、产品经理、算法工程师等群体,可用于企业级AI客服系统开发、智能问答工具搭建、内容生成类应用迭代等多种场景,帮助团队降低LLM应用的开发门槛,缩短上线周期。

latitude.so
Latitude是专注于大语言模型应用开发与落地的协作平台,核心定位是为AI项目团队提供从prompt迭代、模型效果测试到应用部署的全流程支持。平台支持多模型并行对比测试,用户可同时调用GPT、Claude、Gemini等主流大模型输出结果,快速筛选适配业务场景的模型方案;内置prompt版本管理功能,支持记录每一次修改内容与对应测试效果,方便团队回溯优化路径;还提供协作评论功能,团队成员可直接在测试结果下标注问题、提出调整建议,降低跨角色沟通成本。平台面向AI产品经理、prompt工程师、后端开发人员、企业AI项目负责人等用户,可应用于AI客服话术打磨、AIGC内容生成模板开发、企业内部智能助手搭建等多种场景。
moonvy.com
Open Prompt Studio是面向AI应用创作者的提示词开发与管理平台,核心定位为提示词全生命周期运维工具,支持多模型提示词测试、版本迭代追踪、批量效果验证等核心功能,服务于AI内容创作者、大模型应用开发者、企业AI落地运营人员等群体,可应用于AI对话系统开发、批量内容生成脚本调试、企业级AI工作流搭建、AIGC内容生产标准化等场景,帮助用户降低提示词调试成本,提升AI输出结果的稳定性。
promptmetheus.com
Promptmetheus是专门针对大语言模型提示词开发的全流程管理与优化平台,核心定位是帮助用户提升AI交互效率、优化提示词输出质量。平台支持多模型提示词对比测试,可同时将同一提示词发送给GPT、Claude、Gemini等多个主流大模型,直观对比不同模型的输出差异;还支持提示词版本迭代管理,用户可记录每一次修改的调整点和测试效果,回溯优化路径;同时提供提示词效果评分体系,可从相关性、准确性、流畅性等多个维度对输出结果进行量化评估。平台面向AI产品经理、内容创作者、开发人员、运营人员等群体,适用于AI内容生成场景调优、AI应用开发提示词调试、批量提示词效果测试等多种场景,帮助用户构建适配自身需求的高质量提示词库。
zhongshsh.github.io
CLoT是一款聚焦大型语言模型创意能力探索的交互工具,核心定位为帮助用户直观感知大语言模型的创意输出边界。其核心功能包括幽默内容定向生成、发散性创意任务响应、交互过程可追溯记录三类,用户可通过简单的prompt输入触发对应输出。主要面向AI技术爱好者、内容创作者、高校AI相关专业学生、产品研发人员等群体,可用于日常创意灵感收集、大模型能力测试实验、教学演示场景互动、创意类内容辅助生产等多个场景,无需复杂的技术配置即可快速上手体验。

inductor.ai
Inductor是面向LLM应用开发团队的质量管控平台,核心定位是帮助开发者在全生命周期内提升大语言模型应用的稳定性与成本合理性。平台提供多维度自动化评估能力,可对LLM应用的输出准确性、合规性、相关性等指标进行批量校验;内置生产环境实时监控模块,可捕捉异常输出、调用成功率波动等问题并触发告警;还支持跨角色协作流程,方便不同岗位成员共同参与应用质量优化。目标用户覆盖LLM应用开发工程师、测试人员、产品经理、运维人员等,适用于LLM应用原型验证、上线前测试、上线后运维、版本迭代效果核验等多个场景,可兼容各类主流大模型与LLM应用开发框架,支持本地部署与云端部署两种部署模式。