向量检索
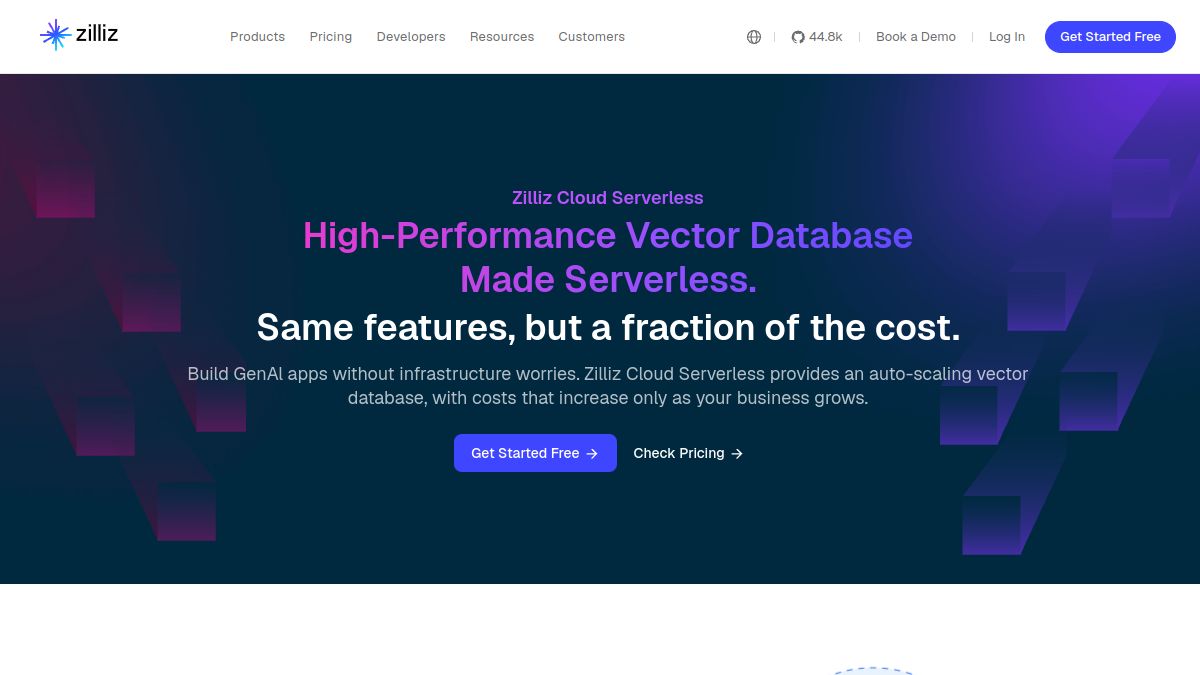

zilliz.com
Zilliz Cloud Serverless是面向生成式AI应用打造的向量数据库服务,核心定位是为向量数据存储与检索场景提供免运维的弹性算力支持。核心功能包括:第一,自动弹性扩缩容,可根据实际请求量与数据量动态调整算力与存储资源,无需用户手动配置集群参数;第二,分层存储优化,通过DRAM、SSD与对象存储的组合架构自动调度数据存储位置,平衡访问速度与存储成本;第三,多维度向量检索支持,兼容多种主流向量索引类型,适配不同精度与延迟的查询需求。目标用户覆盖AI算法工程师、大模型应用开发者、企业AI业务负责人等群体,可应用于检索增强生成(RAG)系统搭建、多模态内容检索、推荐系统向量召回、异常检测等多个AI落地场景。

milvus.io
Milvus是面向AI开发者的开源向量数据库,核心定位是为大规模高维向量提供相似性搜索与存储解决方案。核心功能包括十亿级向量分布式扩展能力、多语言SDK适配、兼容主流AI生态工具、毫秒级低延迟向量检索、多模态向量统一管理。目标用户覆盖AI算法工程师、后端开发人员、计算机视觉研究者、大语言模型应用开发者等。使用场景涵盖图像检索系统搭建、大模型RAG知识库构建、推荐系统召回模块开发、音频指纹匹配、生物特征识别等AI应用开发环节,可降低向量数据管理的技术门槛,提升AI应用的检索效率与稳定性。
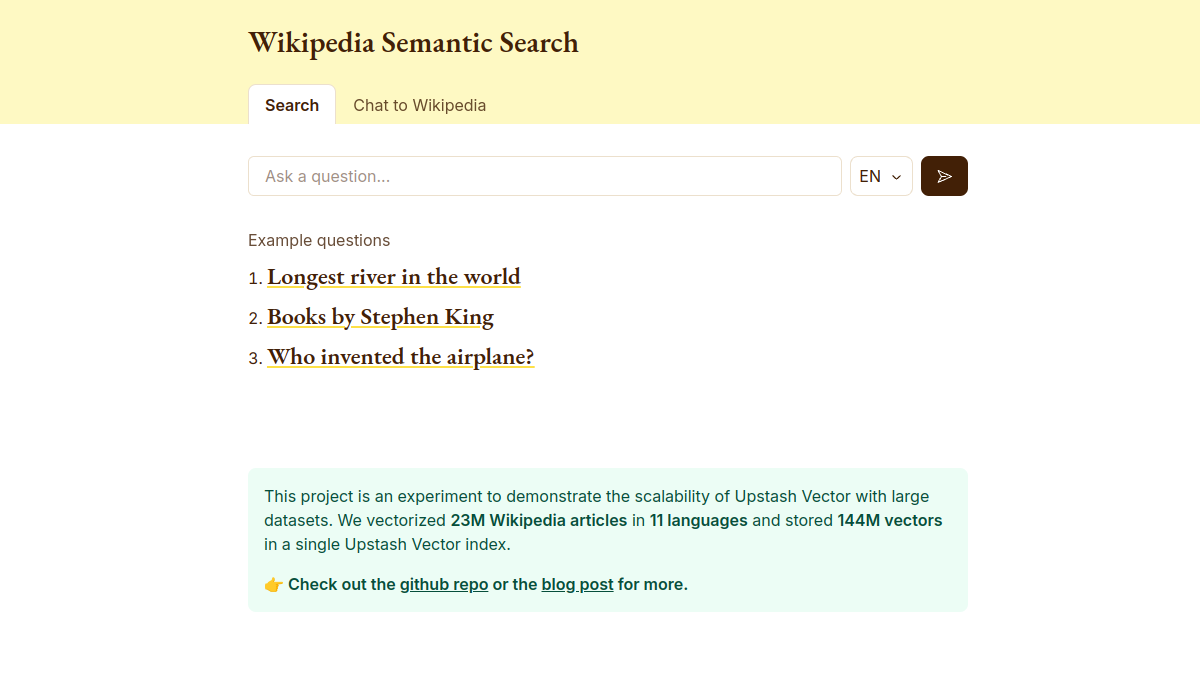
wikipedia-semantic-search.vercel.app
Wikipedia Semantic Search 是基于向量化技术打造的维基百科语义检索工具,核心定位是突破传统关键词搜索的局限,帮助用户通过语义关联获取维基百科相关内容。核心功能包括多语言语义匹配检索、内容关联度排序、跨语言内容召回,支持用户输入自然语言描述而非精确关键词,即可找到相关的维基百科条目。该工具面向研究人员、内容创作者、学生等群体,适用于学术资料检索、主题内容溯源、跨语言信息查询等场景,无需记忆精确词条名称即可快速定位相关维基百科资源。
keylightai.com
Keylight AI是一款人工智能驱动的私有文档搜索与信息检索工具,面向拥有大量电子文档的用户,提供私有文档向量检索、多格式文档兼容、问答式信息提取、检索结果引用标注、云端文档存储同步等功能,可应用于学术文献整理、企业内部资料查询、个人知识归档检索、项目资料信息提取等场景,帮助用户在海量零散文档内容中定位目标信息,梳理文档中的关联内容。

ducky.ai
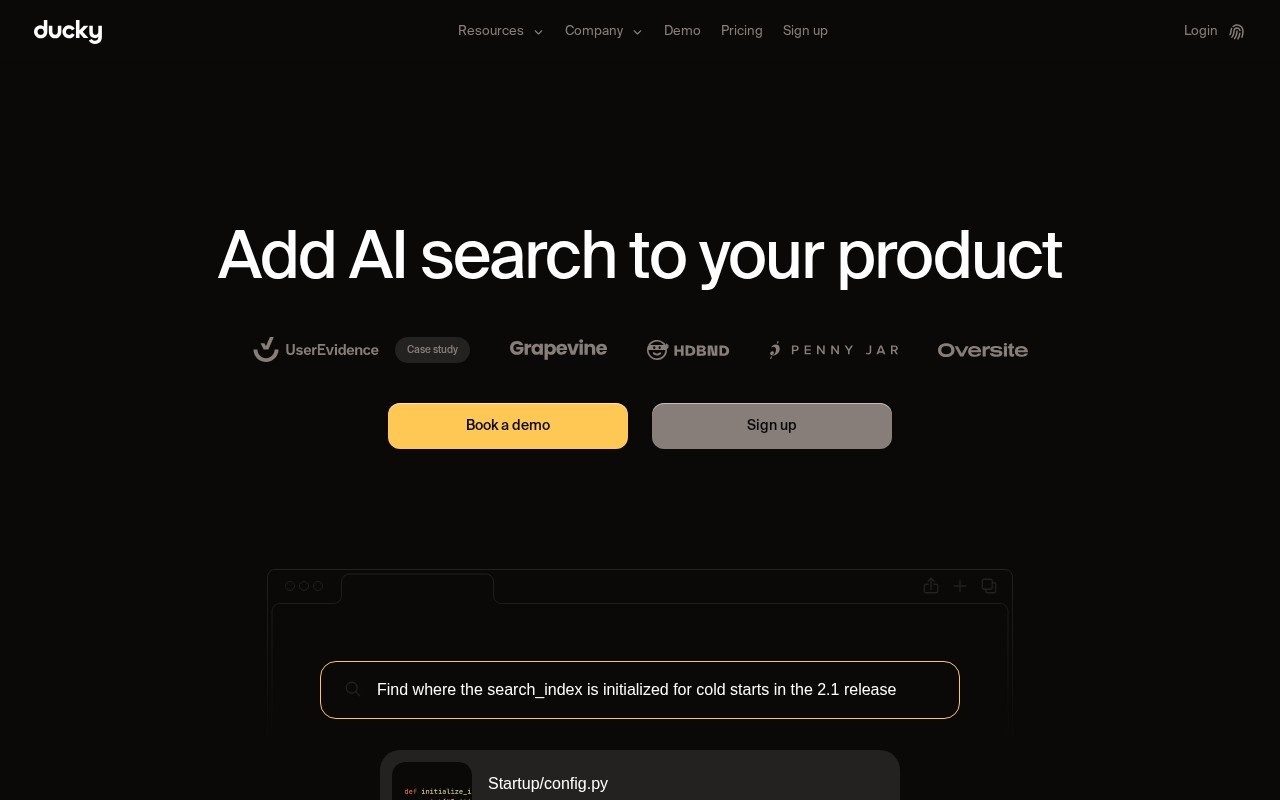
Ducky是一款面向开发者群体,提供全面托管的支持RAG技术的人工智能搜索基础设施服务平台。平台核心定位是降低开发者构建AI搜索功能的开发门槛,帮助开发者无需从零搭建底层搜索框架,即可快速集成智能搜索能力到自有产品中。平台支持自定义数据源接入、向量存储与检索、自然语言问答生成等核心功能,可满足SaaS产品、内容平台、企业知识库等多场景下的智能搜索需求。

marqo.ai
Marqo是专注于向量嵌入模型训练、部署与向量搜索的端到端开发平台,面向AI应用开发者、数据团队与企业技术部门提供从向量生成到检索的全链路解决方案。平台核心功能包括多模态向量生成、多语言向量搜索、弹性架构部署,支持用户快速搭建跨模态检索系统、语义搜索服务、推荐算法模块等AI应用,帮助降低向量数据库与嵌入模型的开发门槛,满足从原型验证到大规模商用的不同阶段需求。

adithya-s-k.github.io
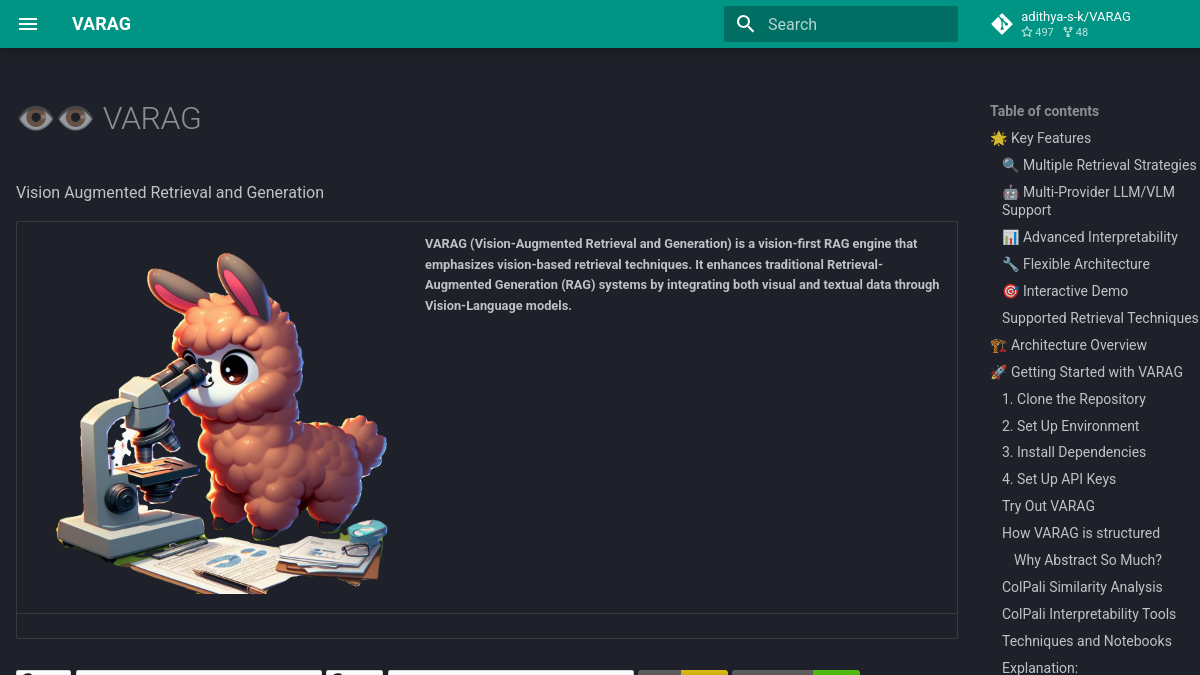
VARAG是一款聚焦多模态文档检索的开源技术系统,核心定位是优化文本、图像及混合类型文档的检索效率与准确率。它支持页面级图像嵌入编码,可直接将文档页面以图像形式纳入检索流程,无需复杂的内容拆分预处理;搭载视觉语言模型完成内容理解编码,能够识别文档中的图表、手写批注、版式元素等非结构化内容;支持检索结果的相关性排序与内容溯源,方便用户快速定位目标文档片段。该系统面向AI研发人员、文档管理从业者、多模态技术研究者等群体,适用于企业内部知识库检索、学术文献批量检索、扫描版文档内容查找、多模态数据集内容筛选等场景。


svectordb.com
SvectorDB是面向无服务器架构设计的向量数据库产品,核心定位是为AI应用开发提供轻量化的向量存储与检索服务。其支持多维度向量的实时写入与相似度查询,可根据访问负载自动弹性扩缩容,同时提供低延迟的向量检索能力。目标用户覆盖AI应用开发者、大模型应用搭建团队、推荐系统开发人员、多模态内容平台技术团队等,可应用于RAG检索增强生成系统搭建、个性化推荐召回模块开发、多模态内容相似性匹配、向量数据持久化存储等多种场景,帮助用户降低向量数据库的运维投入与使用成本。

supermemory.ai
supermemory™是面向开发者和AI应用构建者的AI通用记忆API服务平台,核心定位为大语言模型提供可扩展的个性化记忆存储与检索能力,支持开发者为LLM应用添加无限上下文窗口,简化向量检索和记忆召回的开发流程。平台提供标准化API接口,支持多模态记忆存储、自定义记忆分组、自动语义检索等核心功能,目标用户覆盖AI应用开发者、独立创业团队、AI研究人员等,适用于构建个性化AI聊天机器人、个人AI助手、企业知识库问答系统等需要长期记忆存储的AI应用场景。
clawhub.ai
ClawHub是面向AI代理的技能注册与检索平台,核心定位是为AI代理生态提供标准化的能力接入与调度支持。平台支持技能的结构化注册与版本管理,内置向量搜索引擎可快速匹配不同场景下的AI代理能力需求,同时提供统一的技能调用接口简化集成流程。目标用户覆盖AI代理开发者、自动化解决方案搭建者、企业AI应用落地团队等,可用于多代理协作系统搭建、行业AI应用功能扩展、自动化工作流能力补全等场景,帮助不同需求的用户降低AI代理能力整合的复杂度,提升开发与部署效率。

getlinq.com
Linq API for RAG是面向检索增强生成场景的企业级搜索引擎服务,核心为各类组织提供AI驱动的知识库构建与精准检索能力。其核心功能包括多源数据统一结构化处理、LLM增强向量检索、可视化知识库管理,支持企业将分散的文档、数据表、音视频转写文本等异构数据整合为可搜索的智能知识库,可服务于企业内部知识库搭建、AI客服问答系统支撑、企业内容检索效率提升等场景,面向企业技术开发人员、企业运营管理者、AI产品研发团队等用户群体提供服务。

epsilla.com
Epsilla是面向RAG应用开发需求推出的RAG即服务平台,无需用户编写复杂代码即可完成从数据接入到应用上线的全流程搭建。平台核心功能包含多源异构数据统一管理、自动化RAG pipeline配置、全链路效果评估体系三类,同时内置企业级安全管控能力,可帮助技术开发人员、AI产品经理、企业技术团队等群体,快速搭建基于内部文档、公开知识库、业务数据的问答机器人、智能客服、知识库检索等LLM应用,降低RAG应用的开发与运维成本,提升查询响应效率与内容准确性。

rockset.com
Rockset是面向大规模数据场景的实时搜索与分析数据库平台,核心定位是为开发者、数据团队提供低延迟、高并发的混合数据查询能力。平台支持向量、文本、地理空间、JSON等多类型数据统一索引,可实现混合搜索架构搭建,同时支持流式数据实时摄入,适配高QPS工作负载需求。目标用户覆盖互联网应用开发者、数据分析师、AI应用构建者、企业技术架构师等群体,可应用于实时用户行为分析、AI检索增强生成、电商商品搜索、系统运维监控、地理位置服务查询等多种业务场景,无需额外进行ETL处理、数据去规范化、分片管理等操作,即可快速落地数据查询相关业务。