动态网页抓取
xcrawl.com
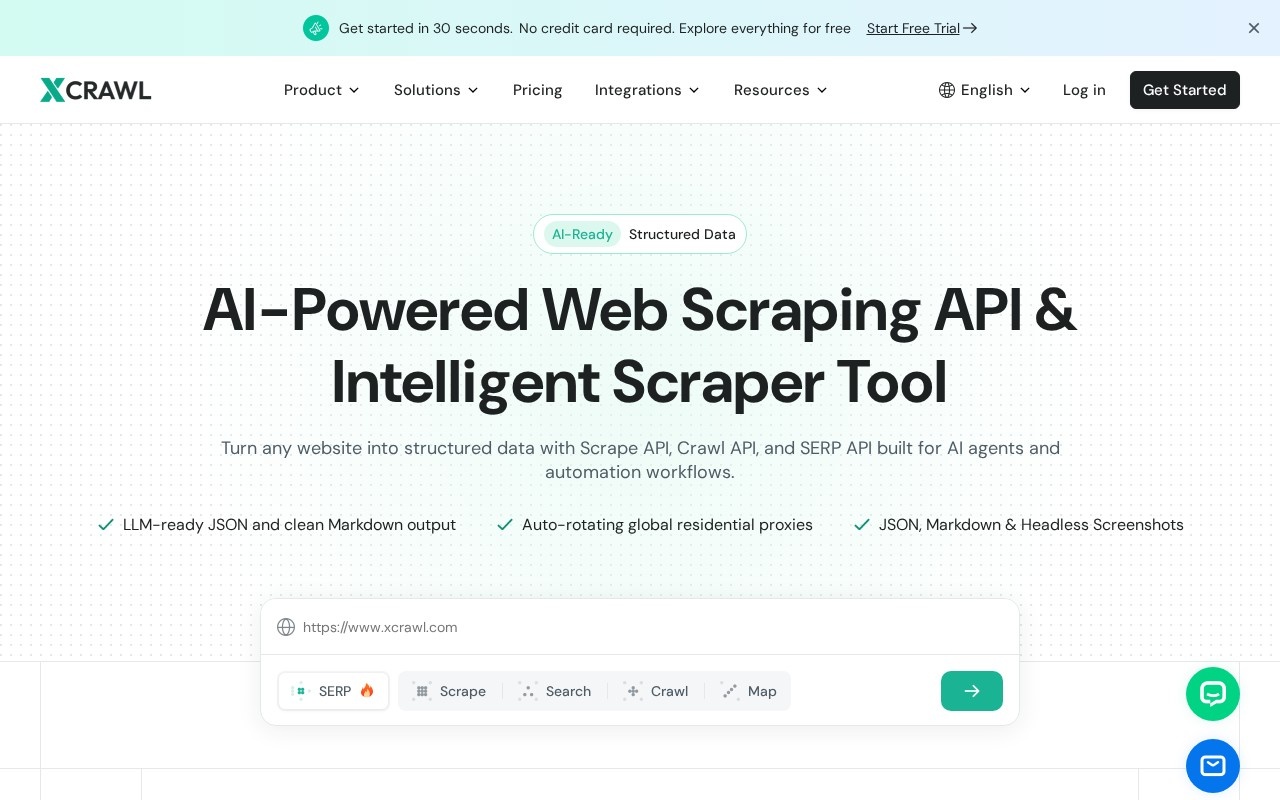
XCrawl是专为提取网页结构化数据设计的AI网页爬虫API服务,核心功能包括AI驱动的结构化数据提取、动态网页内容抓取、反爬机制绕过、自定义提取规则配置、多格式数据输出等,面向开发人员、数据分析师、产品研究人员、内容运营人员等群体,可满足竞品信息收集、公开数据整理、价格监控、内容聚合等多种业务场景的数据采集需求。

bytebot.ai
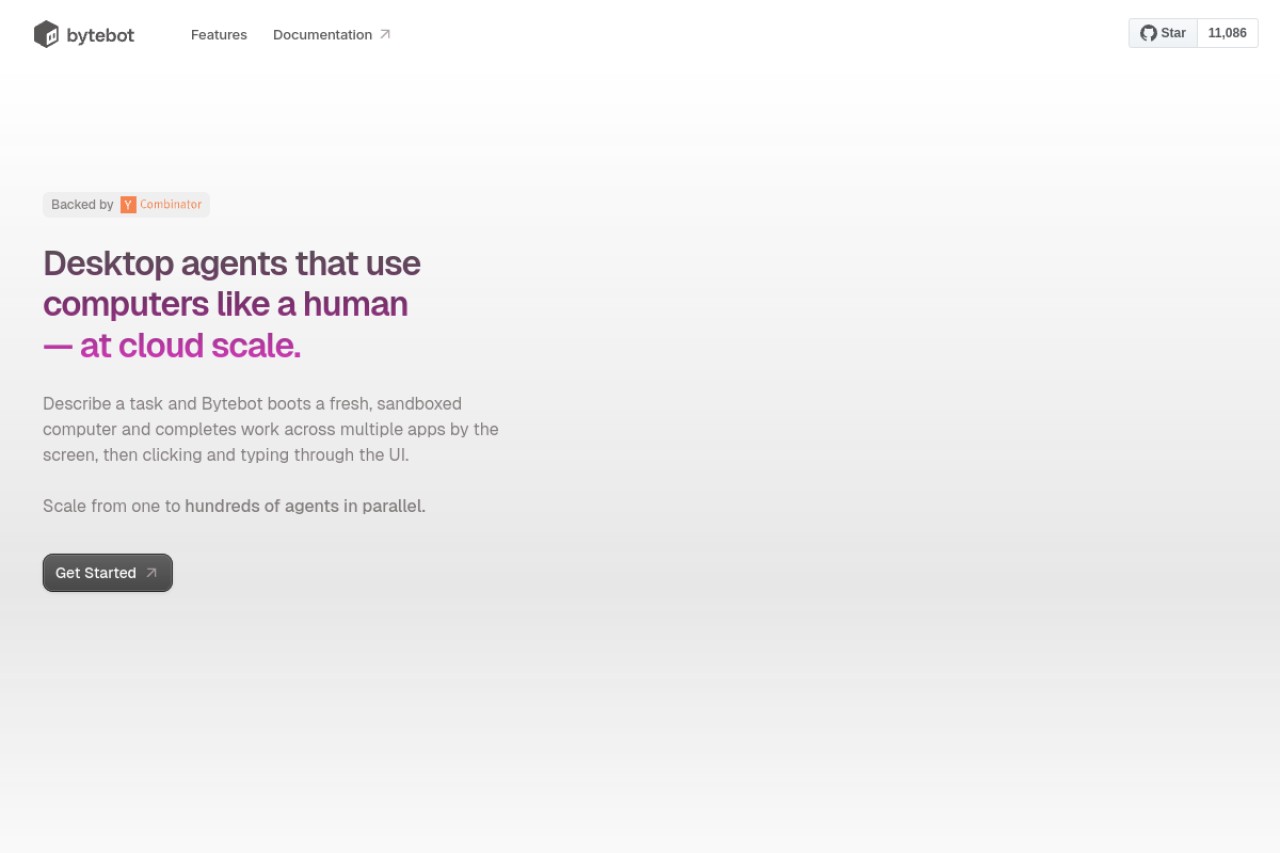
Bytebot是一款基于人工智能的网页抓取与网页自动化服务平台,核心定位是通过自然语言交互简化复杂的网页数据提取与流程自动化操作。平台支持用户使用日常自然语言描述需求,即可完成网页数据结构化提取、动态网页内容抓取、重复性网页操作自动化等任务,无需编写复杂的爬虫代码或自动化脚本。核心功能包含自然语言驱动的数据提取、动态网页内容抓取、网页流程自动化、验证码自动处理、自定义数据导出,目标用户包括数据分析师、产品经理、开发人员、市场研究人员、测试工程师、学术研究者等,适用场景涵盖竞品信息收集、公开数据整理、表单自动填写测试、动态内容监控、学术数据采集等多种需求场景。
rapture-parser.com
Rapture Parser是一款用于从网站提取结构化数据的网页抓取API服务,核心定位是为开发人员、数据分析师提供稳定便捷的网页数据获取方案。支持自定义请求配置、反爬绕过处理、多种数据格式导出,可自动解析网页节点生成规范结构化数据,无需用户自行维护抓取代理与解析规则。目标用户覆盖开发人员、数据分析师、产品调研人员、学术研究者等,适合用于竞品价格监控、公开信息采集、行业数据汇总、内容聚合等多种数据获取场景。
firecrawl.link
Firecrawl是一款面向大语言模型开发场景的网页数据爬取转换工具,核心定位是将任意公开网站内容转换为适配LLM使用的标准化结构化数据。它支持单页抓取和整站深度爬取,可自动清理网页无效内容、提取核心信息并输出多种适配格式,帮助开发人员快速获取训练数据、构建基于网页内容的大语言模型应用。目标用户包括大语言模型应用开发者、AI训练数据整理人员、内容调研人员、RAG系统开发人员等,适合用于构建AI知识库、训练自定义大模型、整理行业公开资料、开发网页内容问答系统等场景。