网页数据采集

browse.ai
Browse AI 是一款无需代码能力即可使用的网页数据自动化采集与监测平台,核心定位是降低网页数据获取的技术门槛,帮助用户完成各类网页信息的批量提取与动态追踪。平台支持自定义数据提取规则、定时监测网页内容变化、API对接数据导出三大核心功能,面向商业分析人员、市场调研人员、内容运营人员、中小商家等群体,可应用于竞品价格追踪、公开行业数据收集、资讯内容聚合、招聘信息汇总等多种场景,无需编写爬虫代码即可完成传统需要技术团队支持的数据获取工作。
alibaba-nlp.github.io
WebWalker是由阿里巴巴集团通义实验室开发的多智能体框架,核心定位是评估大型语言模型在网页遍历任务中的表现,可模拟人类浏览网页的行为逻辑,通过探索与评估相结合的范式系统提取高质量网页数据,支持深入挖掘多层级网页信息,可帮助研究人员优化大模型信息检索能力,适用场景包括大模型开放域问答能力优化、多步骤信息检索场景模拟、网页数据结构化提取研究等,目标用户覆盖大模型研发人员、自然语言处理研究者、信息检索领域从业者等群体。
rtrvr.ai
rtrvr.ai 是一款AI驱动的网页自动化工具,核心定位是为用户简化网页操作与数据处理流程。核心功能包括自然语言驱动网页导航、网页内容结构化提取、多工具集成任务执行、隐私安全沙盒运行。目标用户覆盖数据分析师、运营人员、开发者、内容创作者、市场调研人员等群体。适用场景包含批量网页数据采集、重复性网页操作自动执行、网页内容结构化整理、跨工具网页任务联动等,帮助用户减少手动网页操作的时间投入。
cragdata.com
CragData是面向AI开发场景的网页数据采集与结构化处理平台,核心定位是为AI智能体和RAG检索增强生成 pipeline 提供可直接调用的高质量网页数据源。平台支持大规模动态网页实时爬取、网页链接关系图谱构建,同时内置反爬绕过机制,可将非结构化网页内容转换为标准化JSON格式并通过REST API输出。目标用户覆盖AI应用开发者、大模型训练数据运营人员、RAG系统搭建工程师等群体,可应用于大模型训练数据集扩充、RAG知识库实时更新、行业情报动态监测、网页内容批量结构化存储等多个场景,降低开发者在网页数据采集环节的技术投入成本。
rapture-parser.com
Rapture Parser是一款用于从网站提取结构化数据的网页抓取API服务,核心定位是为开发人员、数据分析师提供稳定便捷的网页数据获取方案。支持自定义请求配置、反爬绕过处理、多种数据格式导出,可自动解析网页节点生成规范结构化数据,无需用户自行维护抓取代理与解析规则。目标用户覆盖开发人员、数据分析师、产品调研人员、学术研究者等,适合用于竞品价格监控、公开信息采集、行业数据汇总、内容聚合等多种数据获取场景。
damngoodsearch.com
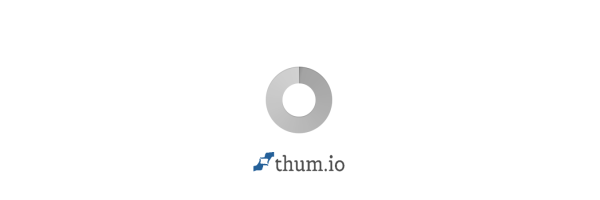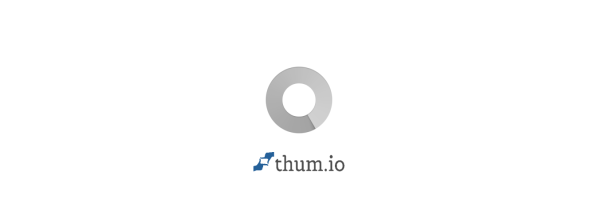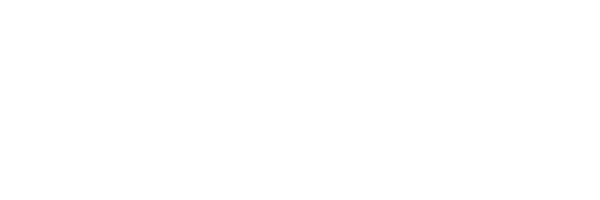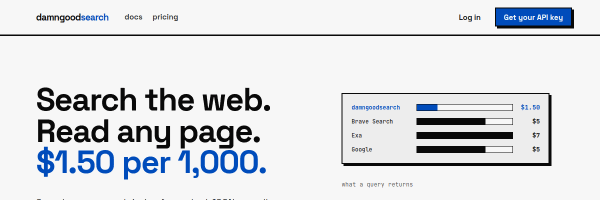
Damn Good Search 是面向AI开发场景的网页检索API服务平台,核心定位是为AI智能体、RAG系统开发者提供稳定的网页数据获取与处理能力。平台拥有自主搭建的网页索引库,支持直接返回排序后的结构化JSON检索结果,同时可将任意网页内容转换为纯净的Markdown格式,定价低于Brave、Exa、Google等同类检索API服务。适合AI应用开发者、大模型应用搭建团队、数据分析师等群体,在搭建RAG知识库、AI智能体网页搜索模块、批量网页内容采集等场景下使用。

singleapi.co
SingleAPI是一款基于GPT技术驱动的API生成工具,核心定位是帮助用户快速将任意网页转换为结构化API接口。其核心功能包括无选择器网页数据抽取、自动API生成、实时数据同步,支持用户无需编写复杂的网页解析代码即可获取目标站点的结构化数据。目标用户覆盖后端开发人员、数据分析师、产品运营、市场调研人员等群体,可应用于竞品数据采集、行业信息汇总、业务数据补全、内容聚合平台搭建等多个场景,降低网页数据获取的技术门槛,提升数据采集效率。

browser-use.com
作为开源AI浏览器自动化框架,专注于为开发者和RPA场景提供AI驱动的浏览器操作能力,支持自主导航网页、表单填写、数据提取等功能,搭配反检测、多LLM适配、全球代理等特色能力,广泛用于网页搜索、在线购物、数据采集、网站测试等场景。