


DoDoBoo
DoDoBoo是面向儿童群体的AI绘画创意平台,核心定位是将儿童手绘涂鸦转化为完整的数字艺术作品,帮助孩子释放创意表达能力。平台核心功能包括涂鸦生成优化、多风格画布适配、作品库云端存储三类,可支持不同年龄段儿童独立完成创作,也可作为家庭亲子互动的活动载体。用户只需上传孩子绘制的线条草稿,选择偏好的艺术风格,即可生成色彩饱满、元素完整的绘画作品,既能激发孩子的创作兴趣,也能留存儿童成长阶段的创意记录,适合日常家庭艺术启蒙、幼儿园创意活动、少儿绘画兴趣培养等多个场景使用。

PicSo.ai
PicSo.ai是专注于AI生成视觉内容的在线创作平台,核心定位为通过文本指令生成艺术作品与虚拟女性形象的AI创作工具。平台支持用户输入自然语言描述快速生成对应视觉内容,可对生成作品进行二次编辑调整参数,还设有社区板块展示其他用户的公开创作成果。目标用户覆盖数字艺术创作者、内容运营人员、游戏美术从业者、虚拟形象爱好者等群体,可满足原创插画制作、社交平台内容配图、虚拟角色原型设计、个人兴趣创作等多场景使用需求。

Lixel CyberColor
Lixel CyberColor(简称LCC)是XGRIDS公司研发的3D场景创建技术产品,聚焦于高精度3D重建与智能空间计算领域。核心功能包括基于Multi-SLAM与3DGS技术的超逼真大型3D模型自动生成、90%模型体积压缩的轻量化处理、多平台插件与SDK适配。目标用户覆盖游戏开发从业者、影视内容制作团队、虚拟现实内容创作者、城市规划设计师、工业仿真工程师等群体,可应用于开放世界游戏场景搭建、影视虚拟拍摄场景还原、VR/AR内容场景构建、城市数字孪生模型制作、工业产线三维仿真等多种工作场景,为3D内容生产提供技术支撑。

Super T
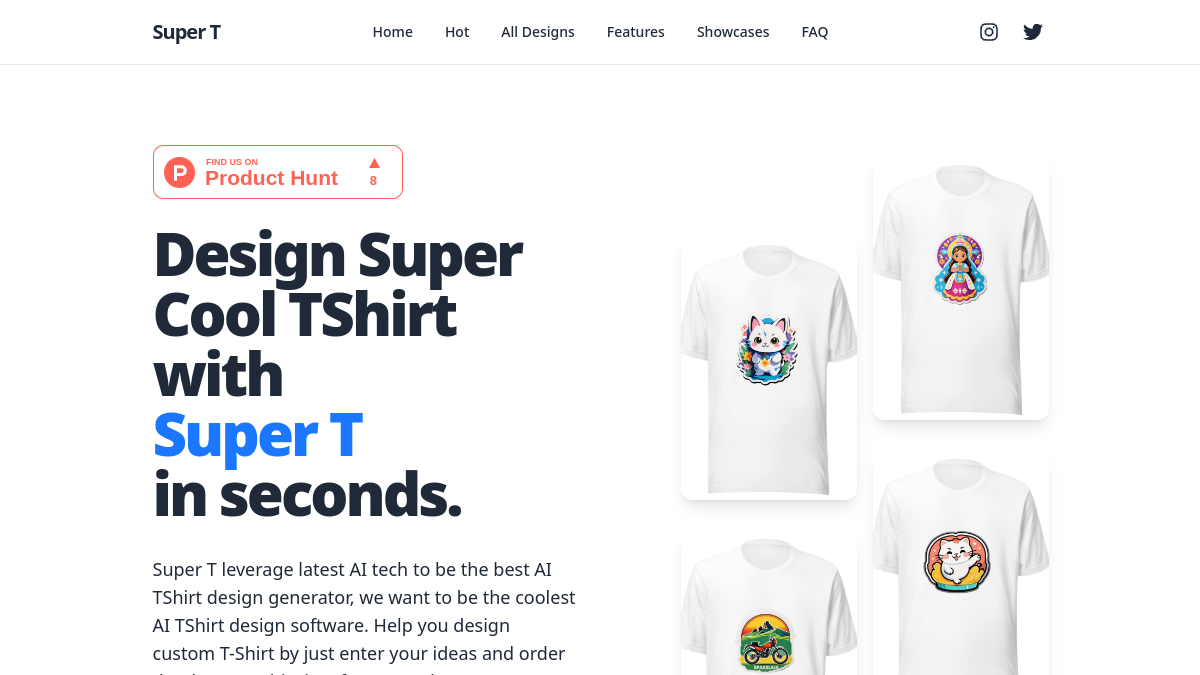
Super T 是基于人工智能技术的个性化T恤定制服务平台,核心定位是为用户提供AI驱动的图案生成+成品制作+配送的一站式定制服务。核心功能包括AI创意图案生成,用户输入文字描述即可生成对应设计图案;多版型尺码适配,覆盖日常休闲、街头潮流等多种T恤款式;快速下单生产服务,确认设计后可直接提交订单完成定制生产。目标用户包含年轻潮流爱好者、社团活动组织者、小众文化爱好者等,使用场景覆盖个人日常穿搭定制、团队集体服制作、小众文化周边创作、纪念活动礼品定制等多个领域,用户无需具备设计基础即可完成专属T恤的定制流程。

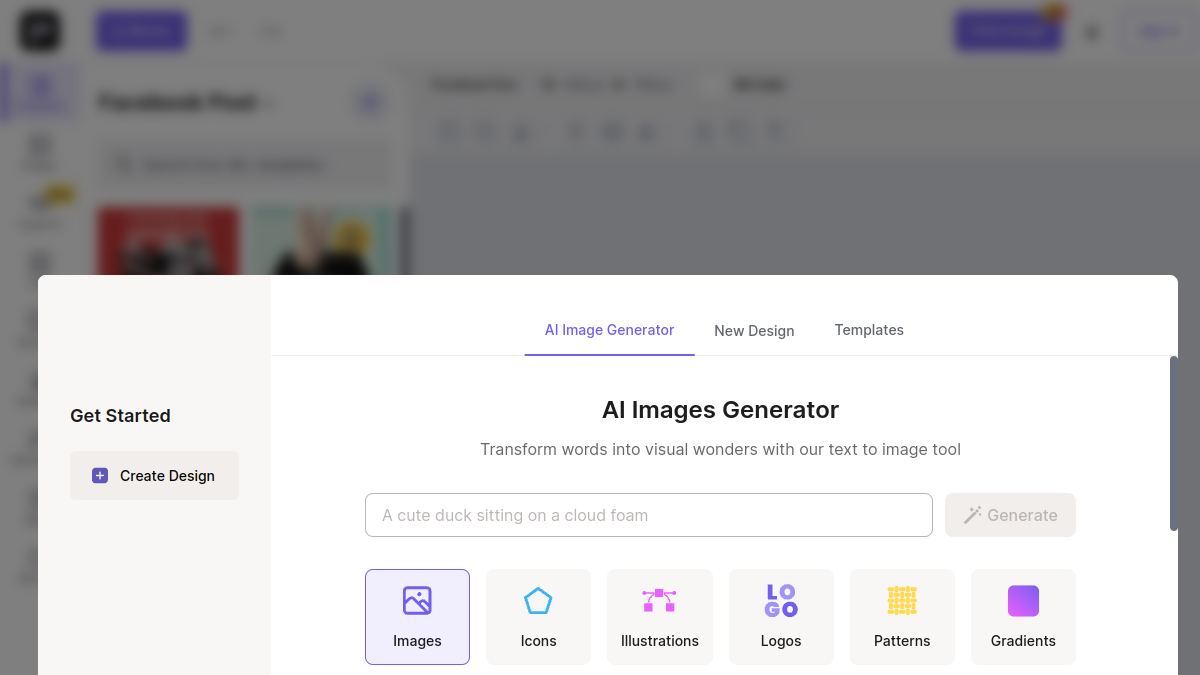
Pixelied Image AI
Pixelied Image AI 是一款面向创意设计领域的AI视觉生成工具,核心定位是帮助用户快速生成各类设计素材与视觉效果。其核心功能包括AI生成图标、插图、徽标等设计资源,支持文本描述生成自定义视觉内容,同时提供渐变、图案等辅助设计元素生成能力。目标用户覆盖电商运营、新媒体编辑、独立设计师、学生、小微企业宣传人员、个人博主等群体,可应用于社交媒体配图制作、品牌标识设计、产品宣传素材制作、课程演示物料制作、个人博客配图设计等多个场景,无需复杂的专业设计软件操作基础即可使用。
点点设计
点点设计是专注于AI图像生成的在线设计工具,核心定位是为不同创作需求的用户提供便捷的文生图服务。核心功能包括多风格AI绘画、智能参数调节、高清图像导出,支持用户通过文字描述快速生成对应视觉作品。目标用户覆盖内容创作者、电商运营人员、设计爱好者、教育从业者等群体,可应用于海报素材制作、产品概念图产出、插画创作、课件配图设计等多种场景,无需专业设计软件操作基础即可完成图像创作需求。
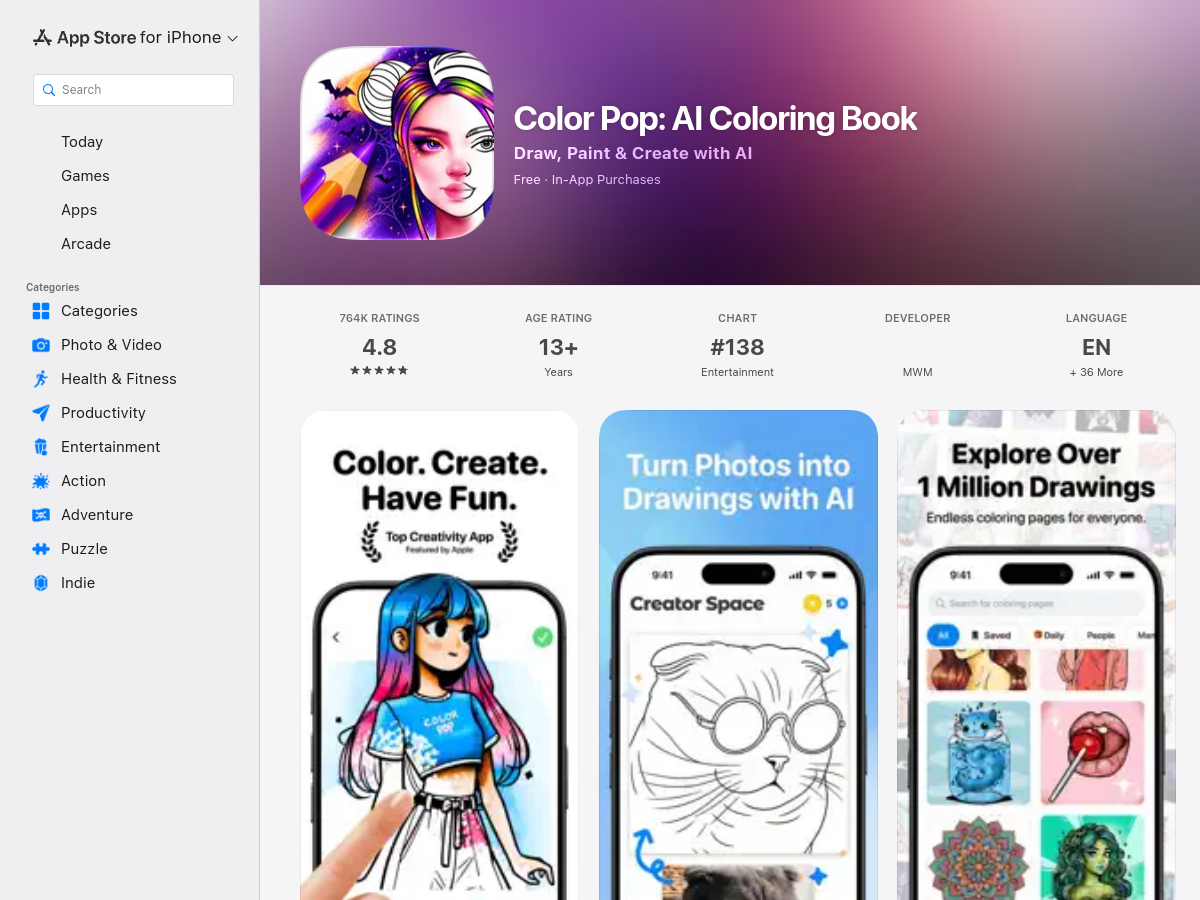
Color Pop - Coloring
Color Pop - Coloring是一款基于AI技术的涂色页生成工具,核心定位是帮助用户通过简单操作快速获取可打印的个性化涂色页。核心功能包括文字生成涂色页、预设模板调用、自定义参数调整三类,支持用户根据需求生成不同风格、不同主题的涂色作品,目标用户覆盖亲子家庭、手工爱好者、教育工作者、设计从业者等群体,可应用于儿童课后互动、手工创作活动、教学素材制作、休闲解压创作等多种场景。
Art Box A.I.
Art Box A.I.是一款主打WhatsApp端使用的AI艺术生成工具,核心定位是降低AI艺术创作的使用门槛,为不同背景的用户提供便捷的AI绘画服务。核心功能包括文本生成图像、风格迁移、多分辨率输出适配,目标用户覆盖艺术创作者、设计从业者、内容运营人员、普通兴趣爱好者等群体。使用场景涵盖社交媒体内容配图制作、个人艺术创作探索、设计初稿灵感参考、活动物料视觉原型绘制等多个领域,无需下载独立APP,通过常用的即时通讯工具即可完成创作操作,适配移动端碎片化的创作需求。
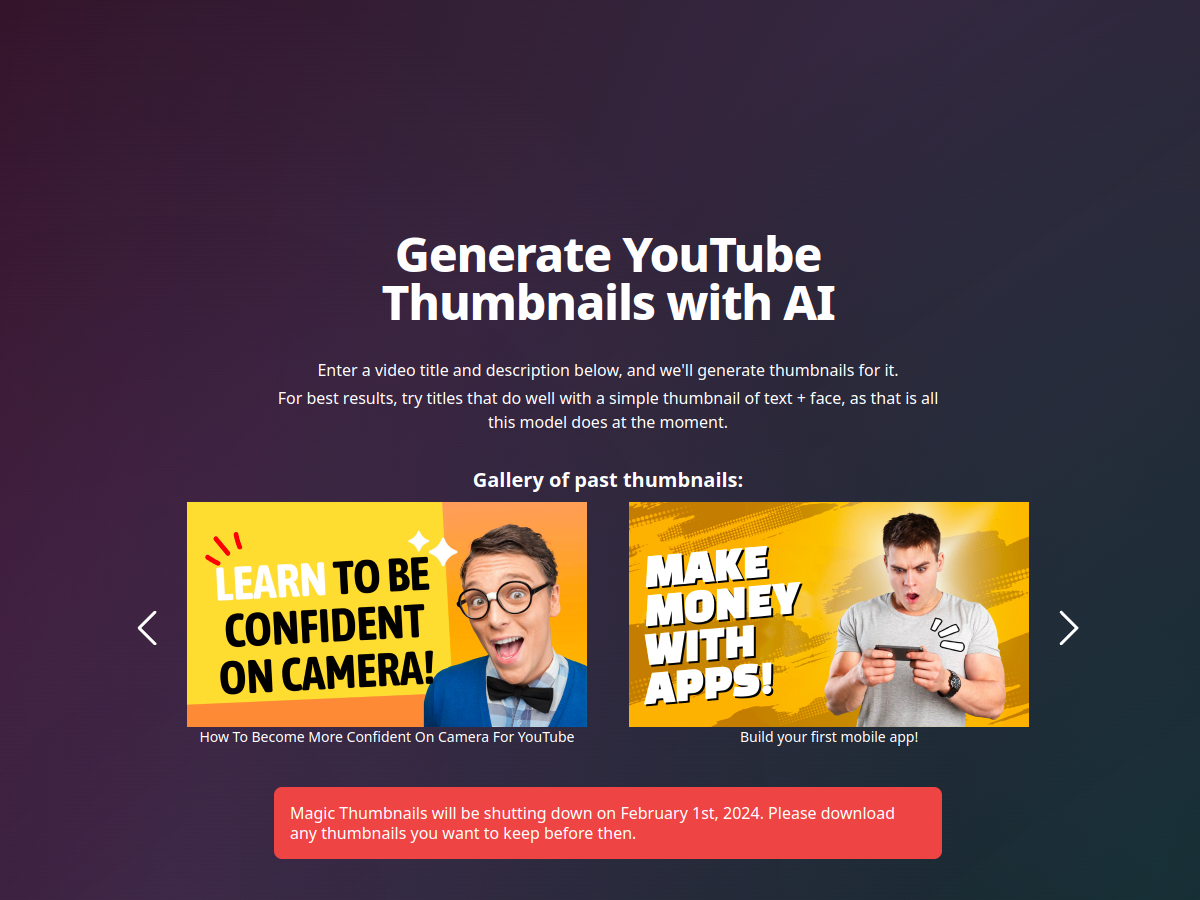
Magic Thumbnails
Magic Thumbnails是一款基于人工智能技术的YouTube缩略图生成工具,核心定位是帮助内容创作者快速生成适配YouTube平台的视频封面素材。其核心功能包括AI一键生成缩略图、历史作品画廊参考、生成结果筛选导出,支持用户仅输入视频标题与描述即可获得符合平台展示逻辑的封面方案。该工具面向YouTube内容创作者、新媒体运营人员、独立视频博主等群体,适用于日常视频更新、专栏内容制作、频道风格统一等场景,可帮助用户降低缩略图制作的时间成本,辅助提升视频曝光表现。

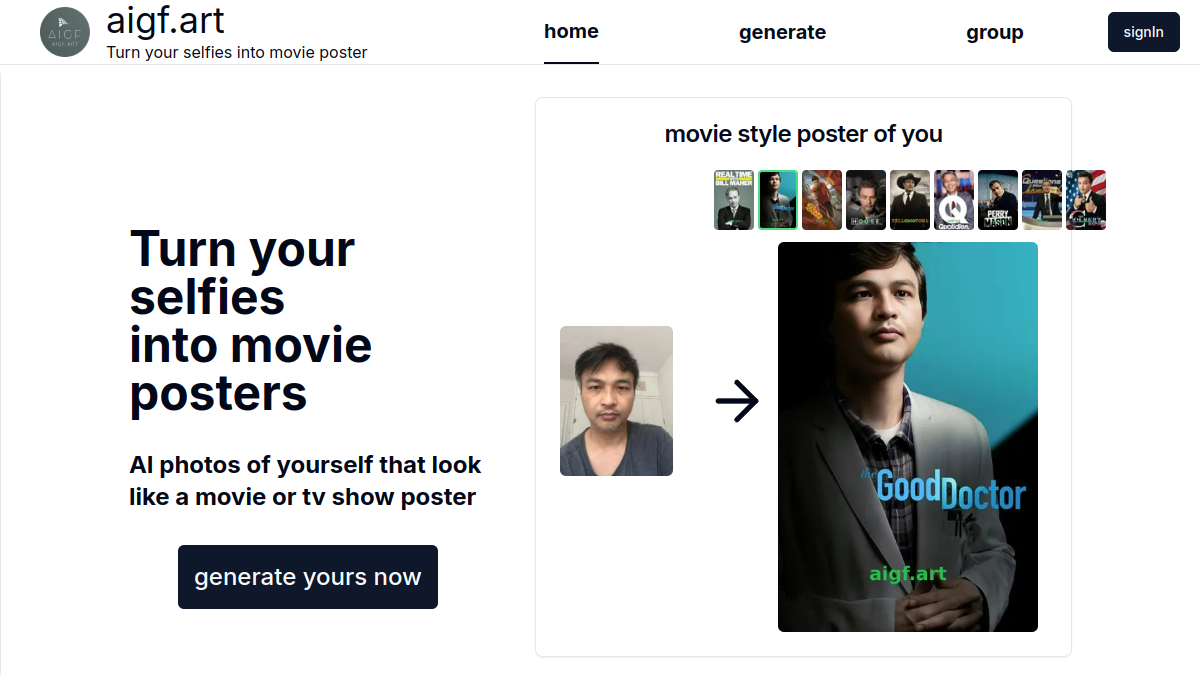
aigf
aigf(https://aigf.art)是一款综合类AI创作服务平台,核心定位是为用户提供多模态AI创作支撑,覆盖视觉、文本、语音三类创作需求。平台核心功能包括AI艺术图像生成、AI文本内容创作、AI语音朗读合成三类,支持用户通过自然语言指令快速获得对应创作产出,无需专业创作技能即可完成多样化内容制作。平台面向有创作需求的普通用户、内容创作者、教育从业者等群体,可应用于日常设计素材制作、文案撰写、有声内容制作、日常信息咨询等多个场景。
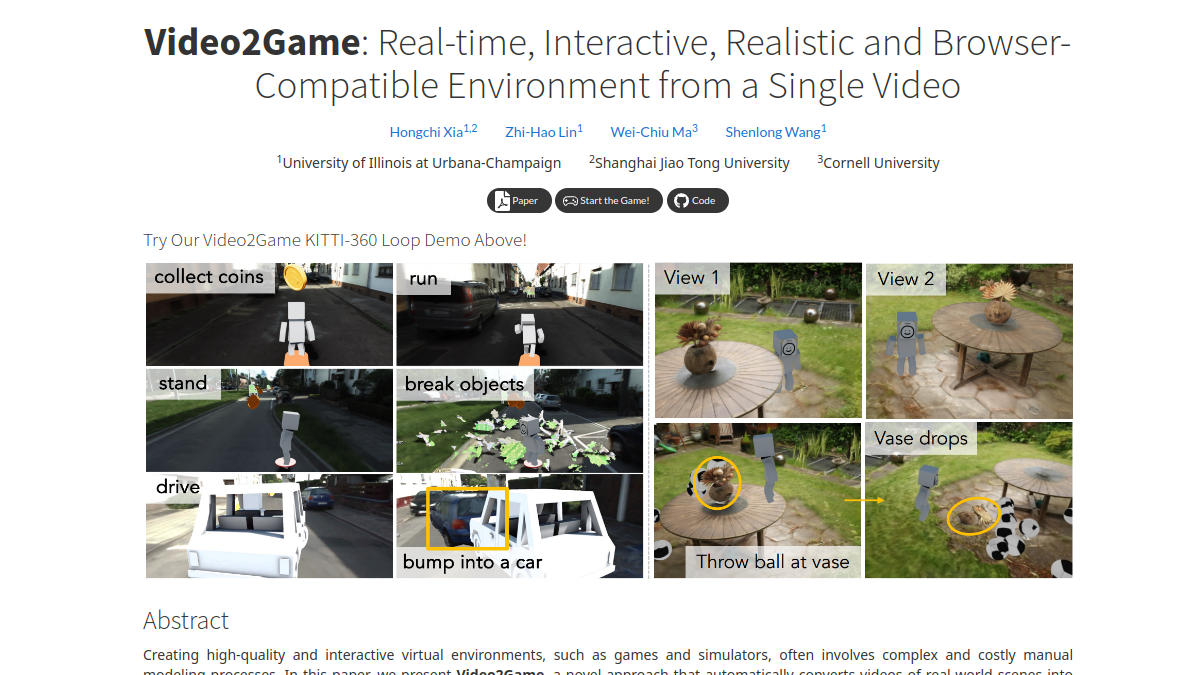
Video2Game
Video2Game是一款专注于视频转虚拟互动环境的在线技术工具,核心定位是将普通视频素材转化为支持实时交互的3D虚拟场景。其核心功能包括基于NeRF的3D场景重建、游戏引擎兼容的动力学网格生成、神经纹理UV映射处理三类,面向3D内容创作者、游戏开发人员、虚拟场景设计从业者、科研人员等群体,可应用于独立游戏场景快速搭建、虚拟展厅内容制作、VR场景内容生成、数字孪生场景还原等多种场景,无需复杂的专业建模流程即可完成从二维视频到可交互3D环境的转换,输出内容可直接在主流浏览器中正常加载运行。
Thumbnail.bot
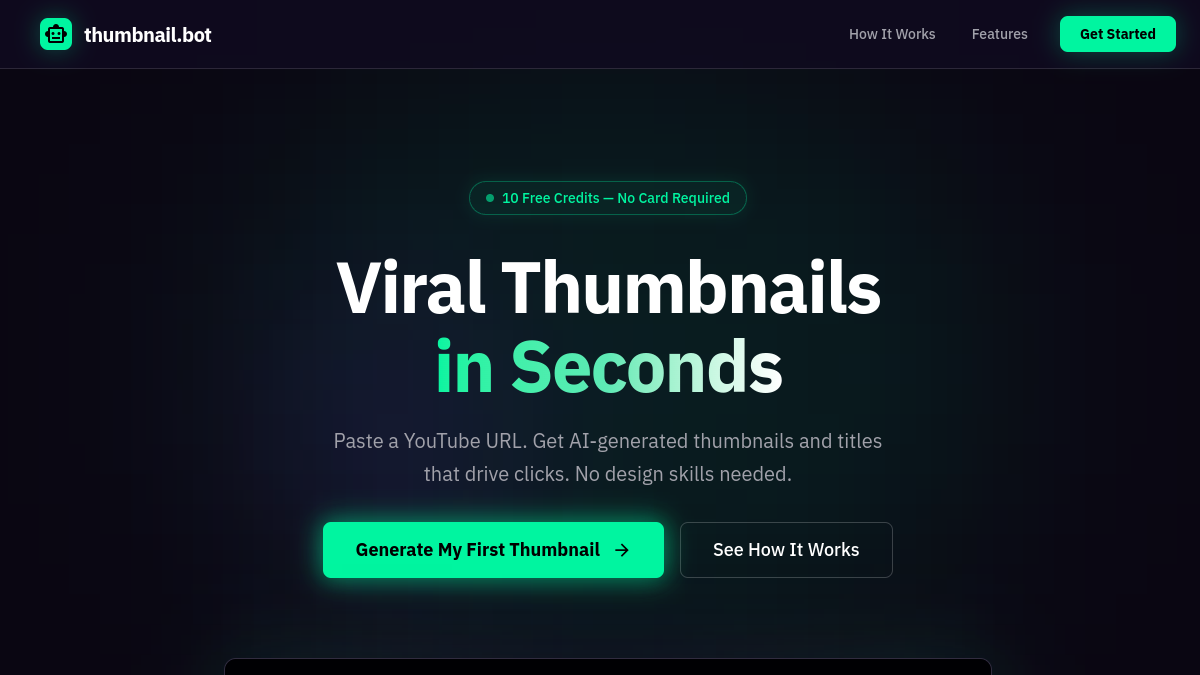
Thumbnail.bot是一款专注于缩略图智能生成的AI工具,核心定位为帮助用户快速产出适配不同传播平台的视觉物料。其核心功能包括基于标题内容的AI智能生成、可自定义元素的可视化编辑、无水印高清导出,目标用户覆盖内容创作者、营销从业者、教育工作者、电商运营等群体,可满足短视频平台封面制作、社交媒体推广图设计、课程内容封面制作、电商商品主图辅助设计等多场景使用需求,无需专业设计基础即可完成符合传播需求的缩略图制作。
Avatic
Avatic是专注于半写实风格3D头像定制的服务平台,核心定位是为用户打造适配多场景的个性化虚拟身份。平台支持用户上传照片生成专属3D头像,所有头像均由专业3D艺术家使用Blender、Photoshop等工具手工制作,带有独特的玩具质感。同时平台提供免费修改、不满意退款等保障服务,目标用户覆盖游戏玩家、社交平台用户、职场人士、内容创作者等群体,可满足游戏身份设置、社交账号头像替换、虚拟会议形象展示、内容创作IP打造等多场景使用需求,帮助用户在保护隐私的同时塑造独特的线上个人标识。

PSHuman
PSHuman是专注于单张图像3D人体重建的技术框架展示站点,核心基于多视图扩散模型与显式重构技术,可从普通单张人像照片生成高还原度的3D人体模型。站点核心功能包含单图3D人体重建演示、重建效果可视化对比、技术论文与开源代码资源下载,主要面向计算机视觉领域研究者、3D内容创作者、游戏动画开发人员等群体,可应用于数字人制作、影视角色建模、人体姿态分析等多个场景,无需多视角拍摄设备即可完成人体3D数据的快速生成,降低3D人体资源制作的前期采集成本。
CAT4D
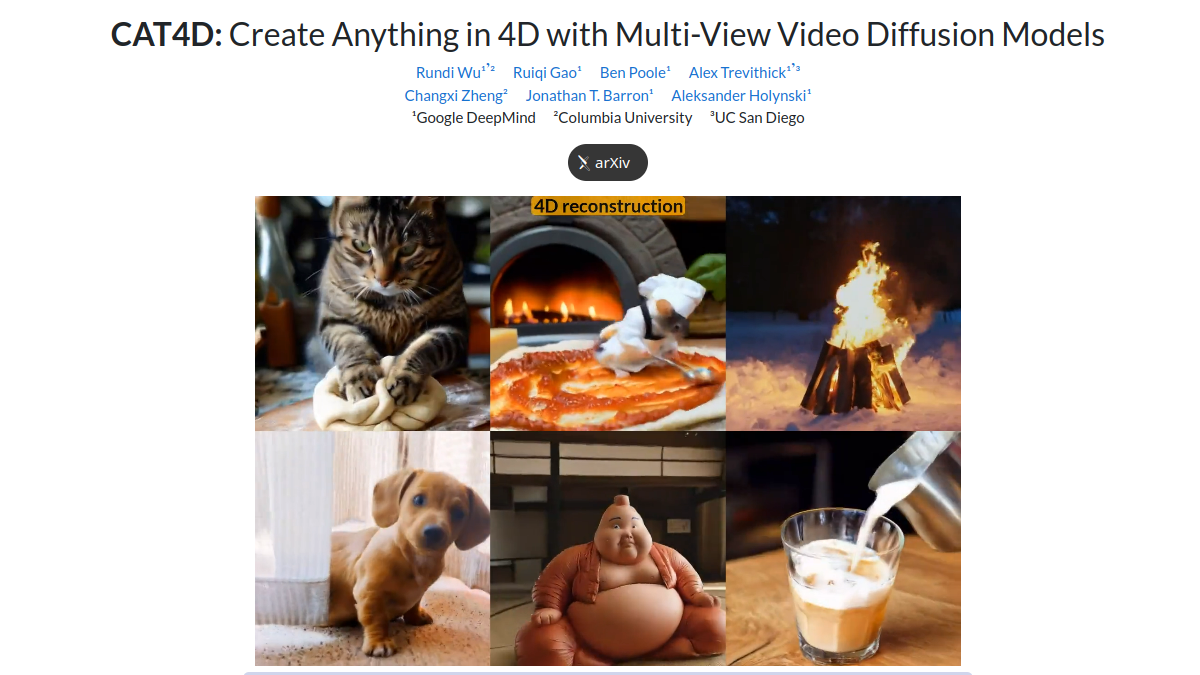
CAT4D是由Google DeepMind、哥伦比亚大学与加州大学圣地亚哥分校联合研发的4D场景生成技术官方站点,核心定位是为科研人员、内容创作者提供基于单目视频的4D场景重建服务。站点核心功能包括单目视频多视角生成、动态3D场景时序重建、4D结果可视化预览三类,目标用户覆盖计算机视觉研究者、AR/VR内容开发者、三维建模从业人员等,可应用于旧视频资源4D化转换、AR场景素材制作、动态三维资产生成等多个场景,帮助用户仅通过普通单视角视频即可完成包含时间维度的4D场景搭建,无需依赖多相机阵列等专业采集设备。
CHOIS
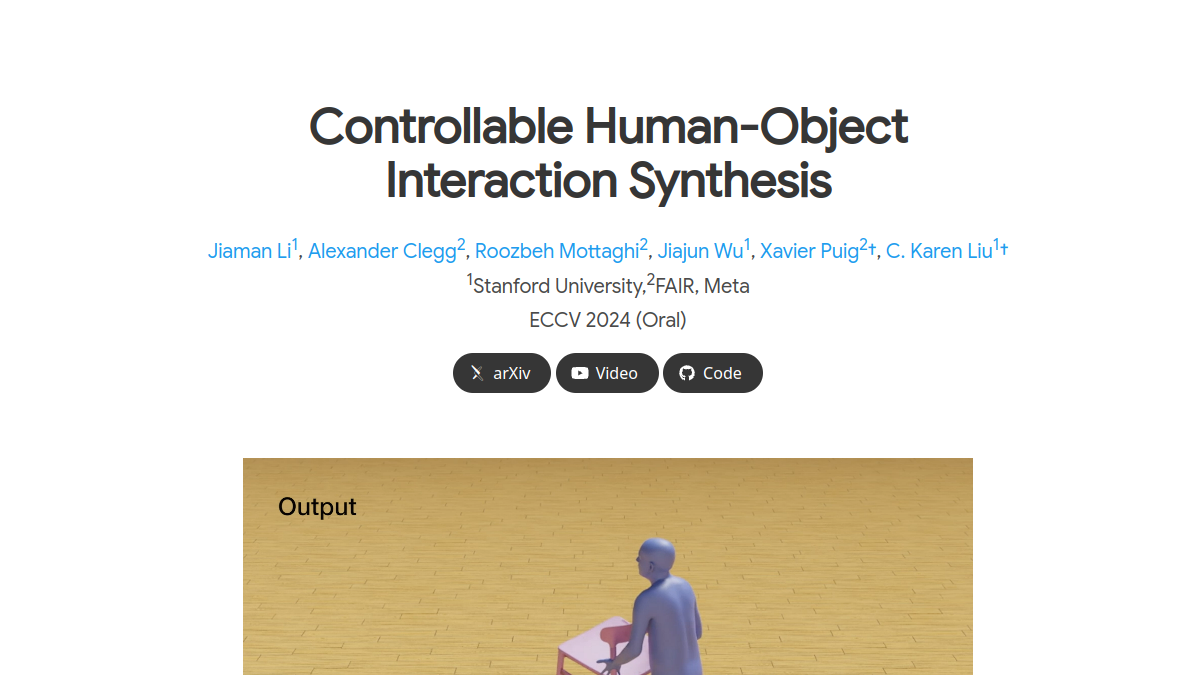
CHOIS全称为Controllable Human-Object Interaction Synthesis,是面向人机交互动作生成领域的开源技术项目,核心定位是可控的人与物体交互动作合成工具。核心功能包括根据自然语言描述生成对应的人与物体协同运动序列、结合初始状态与稀疏路径点约束输出符合物理规则的交互动作、通过接触约束保障手物交互与地面支撑的合理性。目标用户覆盖计算机图形学研究者、游戏动画开发人员、虚拟场景制作从业者、机器人运动规划研发人员等,可应用于3D动画内容制作、虚拟数字人交互动作开发、机器人行为模拟训练、元宇宙场景交互内容搭建等场景,帮助用户降低复杂交互动作的制作与研发成本。

BLENDERGPT
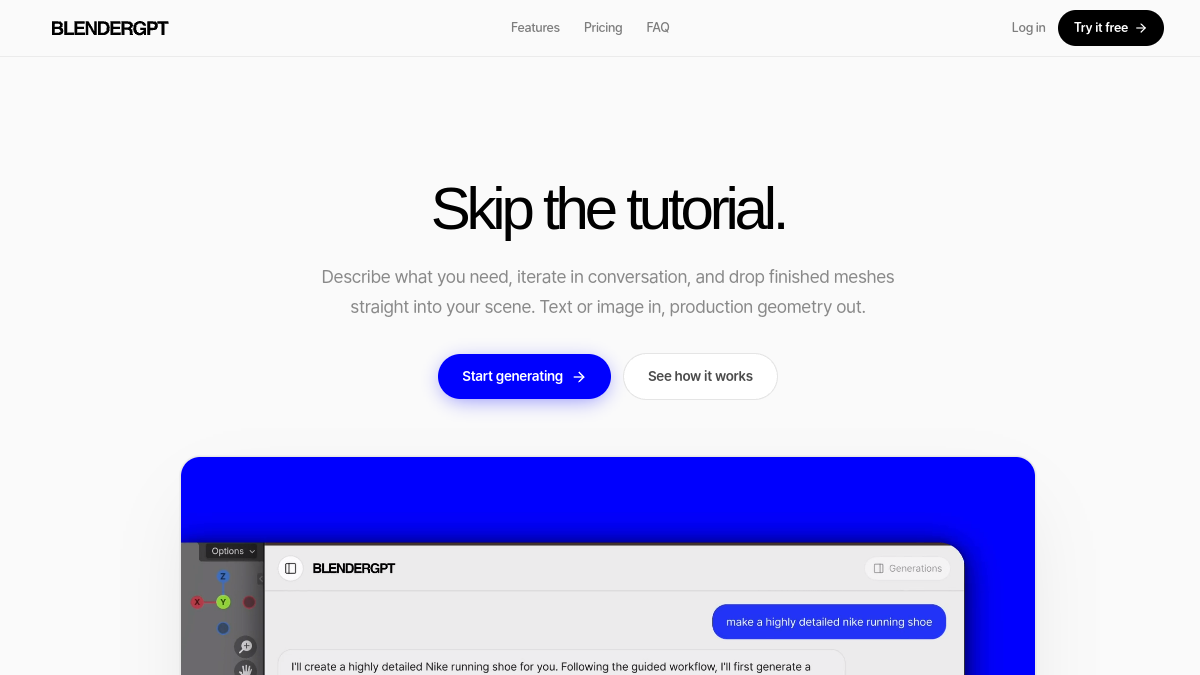
BLENDERGPT是一款专注于3D模型生成的AI工具网站,核心定位是通过自然语言或图像提示快速生成可直接用于Blender的3D资产。核心功能包括文本生成3D模型、图像转3D模型、自动生成带纹理的网格文件,支持直接导入Blender或下载通用格式源文件。目标用户覆盖3D设计师、游戏开发者、动画制作人员、建筑可视化从业者等相关创作人群。使用场景涵盖游戏角色原型制作、动画场景3D资产搭建、建筑效果图辅助建模、产品设计3D原型快速生成、数字藏品3D素材创作等多个领域,帮助用户降低3D建模的技术门槛,减少重复建模的时间投入。
The Language of Motion
The Language of Motion是斯坦福大学研究团队推出的多模态语言模型框架,核心定位是统一3D人体动作对应的言语与非言语语言体系。该框架支持文本、语音、动作三类模态数据的联合理解与生成,可实现手势生成、动作情感预测等跨模态任务,还具备低训练数据需求的特性。目标用户覆盖游戏内容开发者、影视动画制作人员、虚拟现实内容创作者、人机交互研究人员、虚拟角色开发工程师、多模态AI研究学者等群体,可应用于游戏NPC自然交互动作设计、影视虚拟角色多模态表达制作、VR场景中虚拟人物交流逻辑搭建、人机交互系统拟人化交互逻辑开发等场景,为数字虚拟角色的自然交流能力提供技术支撑。

潮际主设
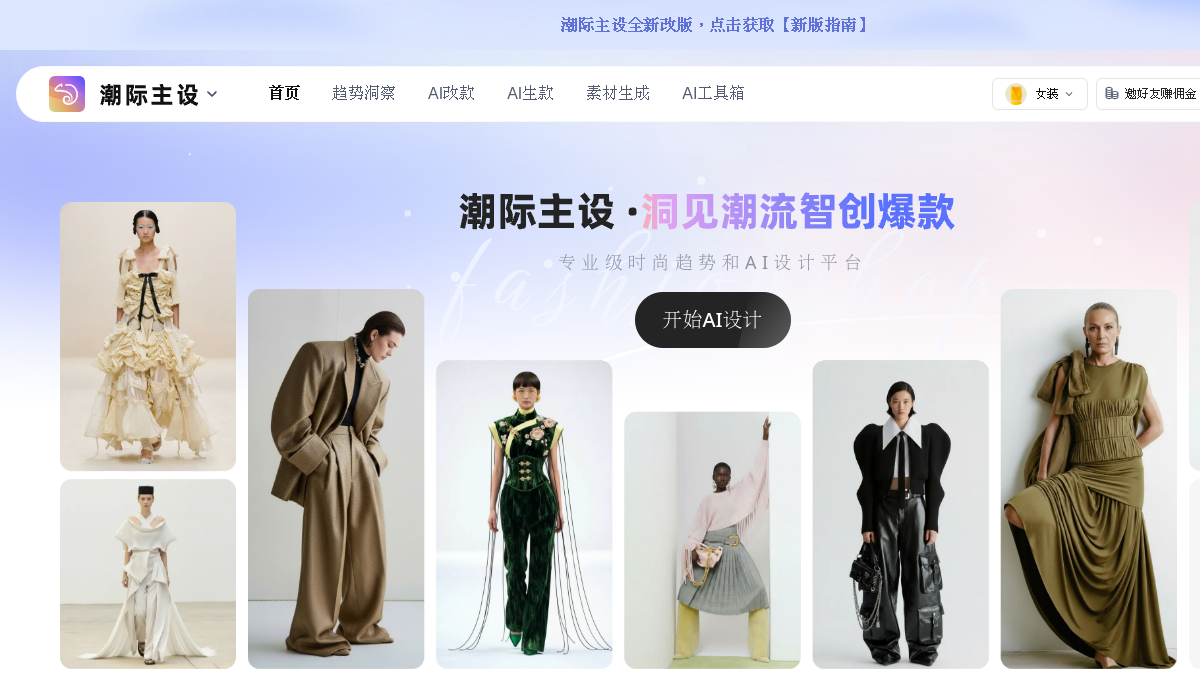
潮际主设是面向时尚设计领域的AI辅助设计平台,依托人工智能技术优化传统时尚设计流程。平台核心功能包含AI款式生成创新、智能图案创作、精细化二次编辑三大模块,可帮助服装设计师、服饰品牌企划人员、独立设计工作室从业者等群体,在已有设计稿或参考图的基础上,快速完成款式迭代、灵感落地、图案融合等工作,降低设计试错成本,缩短从创意到成品的开发周期,适用于服装新品开发、图案印花设计、旧款改版优化、联名款创意探索等多个时尚设计场景。
GenEx
GenEx是一款专注于单图转360°3D可交互世界的AI工具,核心定位为降低3D场景创建门槛的内容生成平台。其核心功能包括单张图像输入生成完整360°3D场景、生成场景可自由交互探索、支持导出场景数据用于二次开发。主要面向游戏开发者、内容创作者、VR/AR从业者、AI研究人员等群体,可应用于游戏原型快速搭建、虚拟展览内容制作、VR场景素材生成、具身AI训练场景构建等多种场景,无需复杂的3D建模基础即可获得可交互的3D空间内容。