

Kadoa
Kadoa是基于生成式AI技术的无代码网页数据采集工具,核心定位是降低网页数据抓取的技术门槛,帮助用户无需编写代码即可快速获取网页结构化数据。核心功能包括AI自动识别网页数据结构、自定义采集规则配置、采集数据自动格式化导出。目标用户覆盖运营人员、市场调研人员、数据分析从业者、中小企业管理者等群体,适用于竞品信息收集、公开市场数据调研、内容素材汇总、行业动态监测等多种场景,可大幅缩短传统数据采集的流程周期。

Stagehand.dev
Stagehand.dev是一个面向开发者的AI网页自动化框架平台,核心是为Playwright网页自动化工具提供自然语言交互扩展能力。平台支持自然语言指令转网页操作、智能页面元素识别、自动化流程生成、错误自动重试、操作日志回溯等功能,主要服务于前端开发、测试工程师、RPA开发人员、运维人员、产品经理等群体,可应用于网页自动化测试脚本开发、重复性网页操作批量处理、网页数据抓取、多场景页面功能验证、网页操作流程复刻等场景,帮助使用者降低网页自动化开发的代码编写成本,提升自动化流程的搭建效率。
FetchFox
FetchFox 是一款基于人工智能技术的网页数据抓取工具,以Chrome浏览器插件为载体,支持用户通过自然语言指令完成网页数据提取工作。其核心功能包括AI驱动的非结构化文本提取、复杂网页结构自动解析、反爬机制绕过适配,主要面向有网页数据收集需求的职场人士、研究人员、创业者等群体,适用于潜在客户列表搭建、行业研究数据采集、细分市场调研、竞品信息汇总等多种场景,无需用户掌握专业爬虫开发技能,即可完成多类型网页的数据提取任务。
rtrvr.ai
rtrvr.ai 是一款AI驱动的网页自动化工具,核心定位是为用户简化网页操作与数据处理流程。核心功能包括自然语言驱动网页导航、网页内容结构化提取、多工具集成任务执行、隐私安全沙盒运行。目标用户覆盖数据分析师、运营人员、开发者、内容创作者、市场调研人员等群体。适用场景包含批量网页数据采集、重复性网页操作自动执行、网页内容结构化整理、跨工具网页任务联动等,帮助用户减少手动网页操作的时间投入。

Firecrawl LLMs.txt generator
Firecrawl LLMs.txt generator是由Firecrawl提供支持的在线llms.txt文件生成工具,核心定位是帮助用户快速从目标网站的结构化文本内容,适配大语言模型训练、RAG系统构建、智能体知识库搭建等场景需求。核心功能包括全站内容自动爬取、内容结构化清洗、llms.txt格式自动适配、自定义内容范围筛选、生成文件一键导出。目标用户覆盖AI开发者、大模型训练研究人员、RAG应用搭建者、网站运营人员等,可用于快速获取特定领域模型训练数据准备、知识库内容结构化处理、智能问答系统内容导入等场景,帮助用户降低内容采集和整理的成本。
Reworkd
Reworkd是基于自研应用层LLM代理技术打造的无代码网页数据提取工具,核心定位是降低网页数据抓取的技术门槛,简化数据采集全流程。它支持自动扫描目标网站结构、智能生成抓取代码、自动运行提取任务并校验数据结果,可适配多数静态及动态网页的数据采集需求。目标用户覆盖需要批量获取网页数据的企业运营人员、数据分析从业者、开发者、市场调研人员等,可应用于竞品信息采集、公开行业数据汇总、内容素材收集、市场舆情监测、供应链信息整理等多个场景,减少手动编写、维护爬虫脚本的工作量。
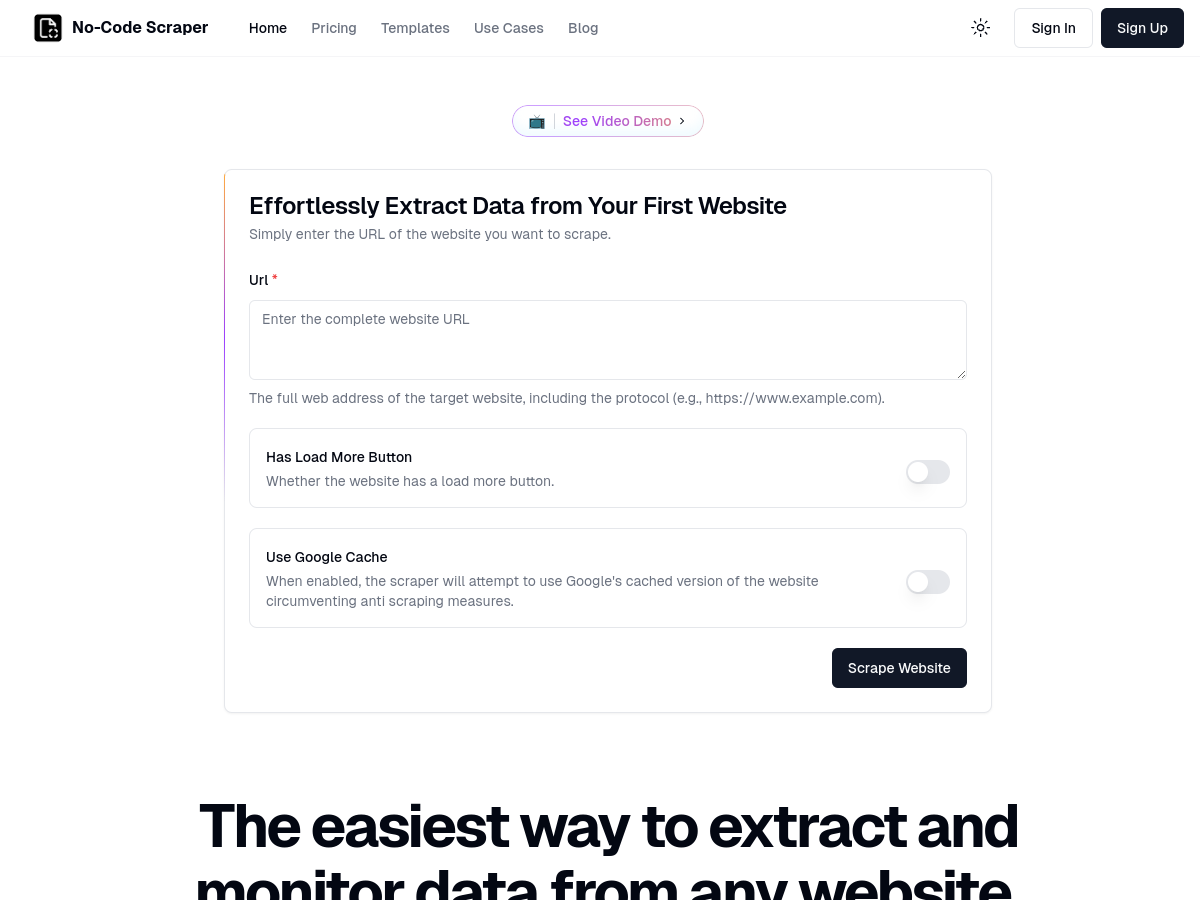
No-Code Scraper
No-Code Scraper是一款面向无代码基础用户的网页数据提取工具,核心定位是降低网页数据采集的技术门槛,让用户无需编写爬虫代码即可完成多类型网页数据的收集工作。平台核心功能包括基于大语言模型的智能字段识别、自定义数据导出规则、动态网页内容适配、定时采集任务调度、采集结果云端存储等。工具面向市场调研人员、内容创作者、电商运营从业者、学术研究人员、数据分析人员等群体,可应用于竞品价格监测、公开信息汇总、行业研究数据收集、电商商品信息整理、内容素材批量采集等多种场景,用户仅需通过简单的可视化操作即可完成整个数据采集流程。
Hyperbrowser
Hyperbrowser是面向AI智能体与Web自动化场景打造的云浏览器平台,基于安全隔离的容器架构提供无头浏览器运行与扩展能力。平台核心功能包括大规模会话快速部署、多AI框架原生适配、内置反检测绕过机制,目标用户为AI开发者、后端工程师、数据采集从业者,可应用于AI智能体网页交互训练、公开网络数据抓取、Web应用自动化测试、批量数据预处理等场景,帮助用户省去本地浏览器基础设施搭建与运维成本,聚焦核心业务逻辑开发。

BrowserAct
BrowserAct是一款基于AI技术的云浏览器自动化工具,核心定位是帮助用户实现网页数据提取与自动化任务执行,无需用户具备编程基础。工具支持模拟人工操作完成网页交互,可提取多格式结构化数据,支持自定义任务配置,同时可为AI大模型提供网页数据支持。目标用户包括数据分析师、产品运营、AI开发人员、办公人员等,适用场景包含竞品信息采集、公开数据整理、网页表单批量填写、AI训练数据集构建等。
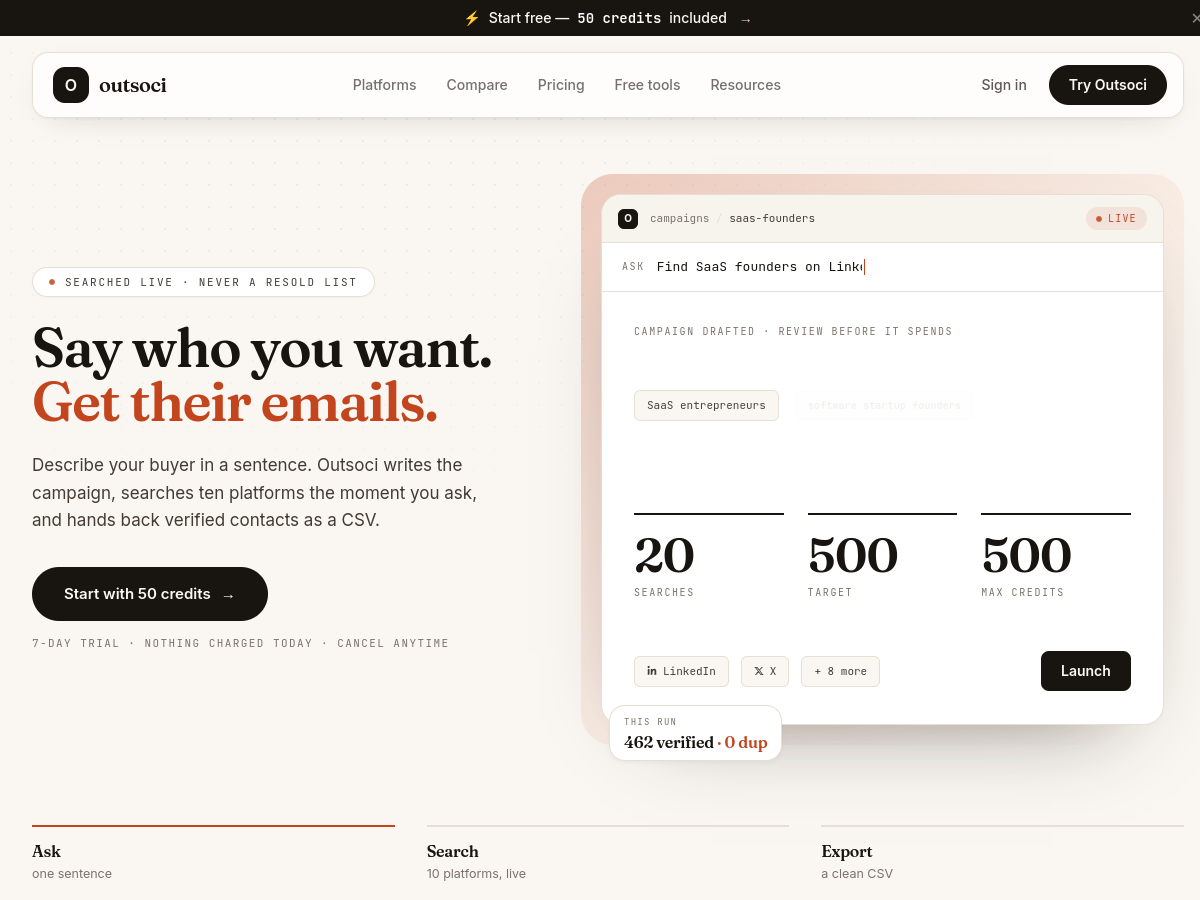
Outsoci
Outsoci是一款面向B端营销从业者的潜在客户生成工具,支持合法抓取社交媒体平台与在线地图中的公开联系信息,核心功能包括多平台信息抓取、数据筛选整理、批量导出、邮箱验证、自定义搜索规则等,目标用户覆盖To B销售团队、数字营销人员、本地商户拓展人员、市场调研人员等,可用于开发潜在客户线索、整理目标区域商户信息、完成行业市场调研数据收集等场景,帮助相关从业者获取合规可用的商业联系信息。
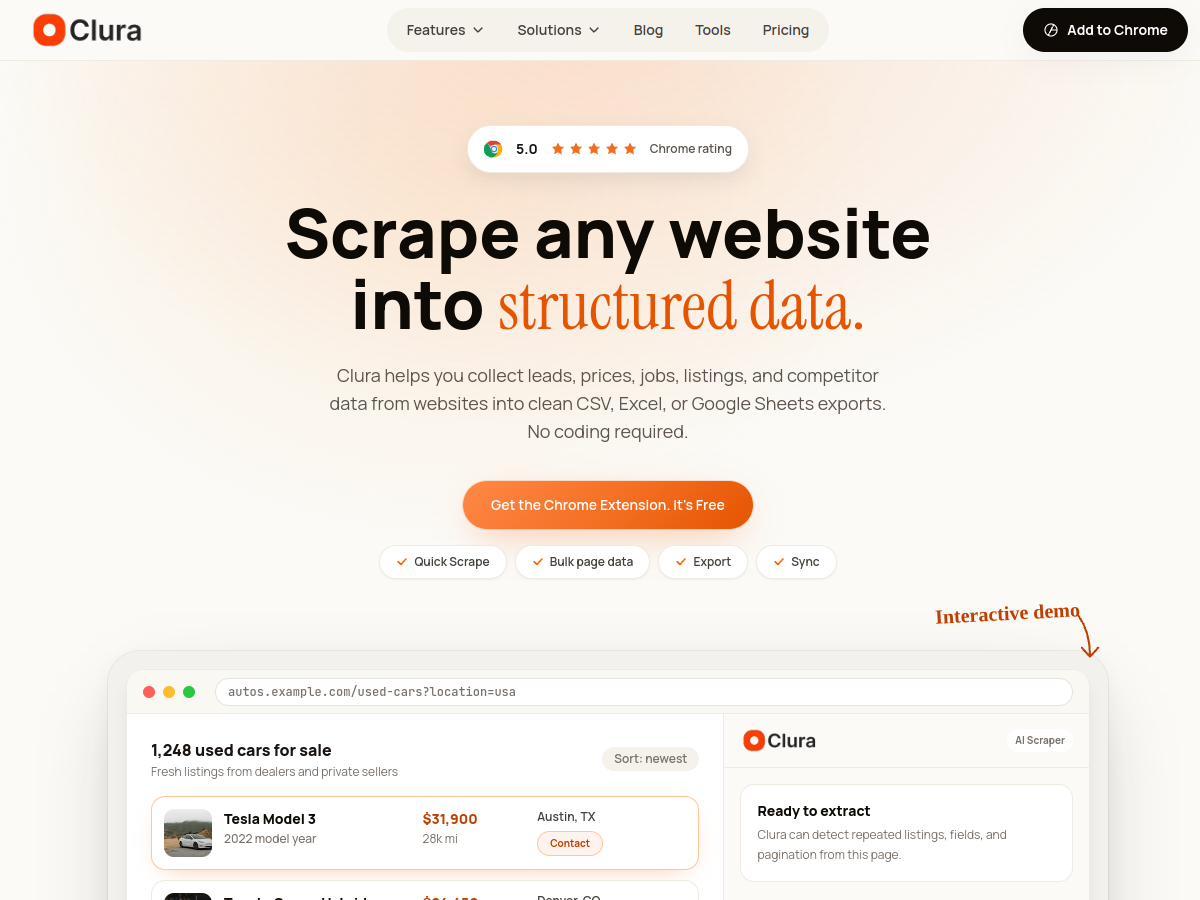
Clura
Clura是一款依托人工智能技术的网页数据提取整理工具,以Chrome浏览器插件形式提供服务,支持用户无需编写代码即可完成网页数据的抓取与规整。核心功能包含可视化数据选取、自动格式整理、多页面批量爬取、导出多种格式文件、数据实时预览,面向数据分析师、市场调研人员、内容创作者等人群,可用于电商商品信息收集、学术文献数据整理、行业信息汇总、公开内容归档等多种使用场景。
Thordata
Thordata是一家提供网络数据抓取代理服务的平台,拥有覆盖全球多个国家和地区的代理网络资源。平台核心功能包括静态住宅代理、动态住宅代理、数据中心代理、定向区域代理选择、代理流量统计管理等服务,面向需要开展网络数据采集、市场调研、价格监控、内容聚合等业务的企业与开发者,可满足不同规模数据抓取业务的代理需求,适用于跨境电商信息收集、搜索引擎抓取、社交媒体数据采集等多种使用场景,能够帮助用户解决网络访问限制、IP被封等常见数据采集问题。
Google Maps Scraper
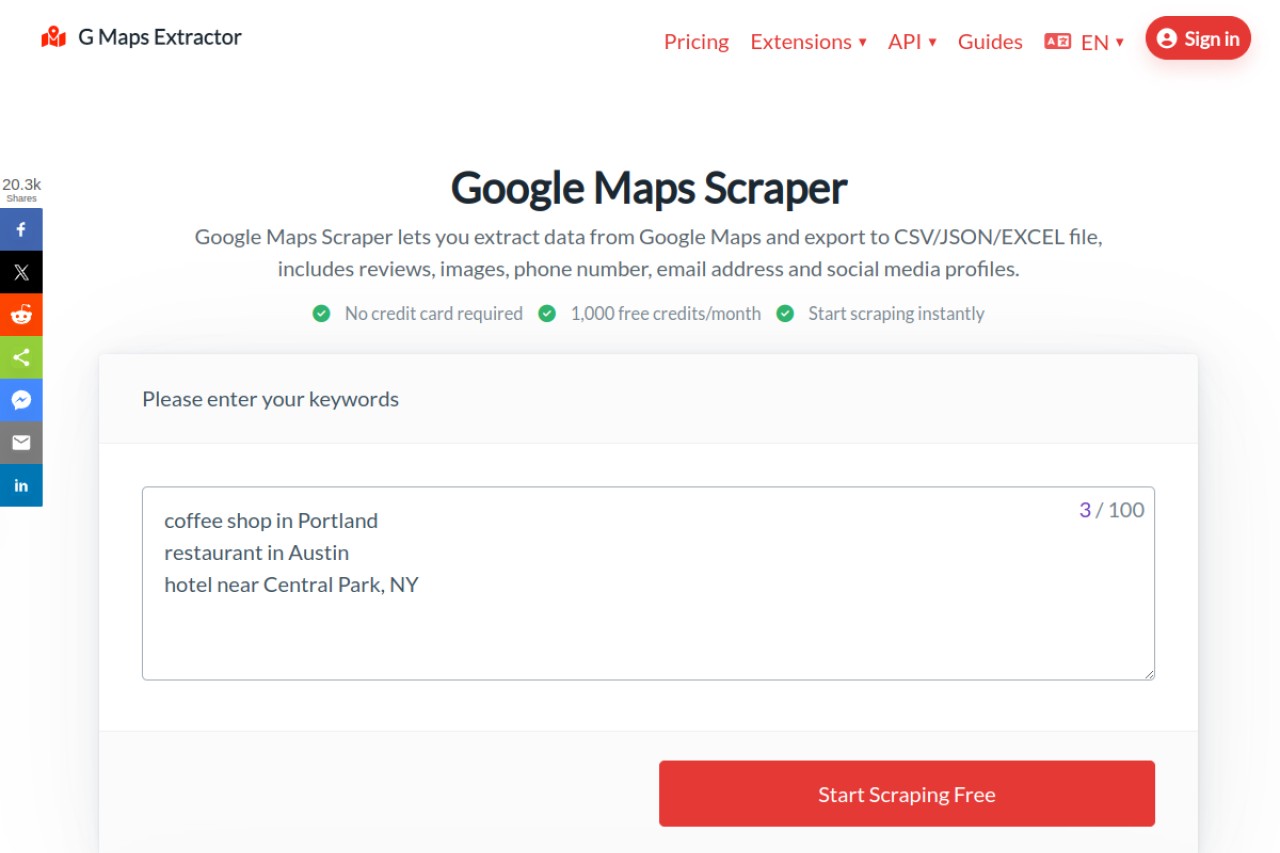
Google Maps Scraper是一款基于网页端的Google地图企业数据采集工具,核心定位是帮助有数据获取需求的用户,从Google地图中批量提取目标区域、目标品类的商业信息。工具支持自定义筛选条件采集,可导出标准化的结构化数据,无需安装本地软件,直接在浏览器中即可完成全部操作。核心功能包含关键词批量搜索采集、自定义区域范围提取、数据导出下载、重复数据去重、联系人信息匹配等,适合市场调研人员、销售开发人员、商业分析人员使用,可用于获取目标区域潜在客户信息、绘制商业版图、开展竞品分析等场景。
Scrapybara
Scrapybara是面向开发者与AI项目构建者的AI代理远程桌面实例服务平台,提供统一API接口与底层系统控制能力,支持开发者快速部署可被AI代理操作的虚拟桌面环境。核心功能包含按需创建虚拟桌面实例、提供多系统版本选择、支持自定义环境配置、开放底层控制权限、提供会话持久化存储,面向AI代理开发团队、自动化测试工程师、AI研究人员等用户,可用于AI代理交互环境搭建、自动化流程测试、AI行为实验等多种开发场景。
GMapsScraper.AI
GMapsScraper.AI是一个基于人工智能技术的Google地图商业信息抓取平台,核心定位为帮助用户批量获取Google地图上的公开商业数据线索。平台支持用户通过自定义关键词、地理位置范围筛选目标商业主体,批量提取包括联系方式、经营信息在内的多种公开数据,并支持导出为CSV、JSON等常用格式,满足不同数据分析和使用需求。核心功能涵盖AI驱动的精准搜索抓取、多维度数据提取、多种格式导出、数据去重清洗、批量任务处理。目标用户包括市场调研人员、销售开发人员、数字营销人员等,适用于拓客线索整理、区域市场分析、商业竞品调研等多种场景。

Datatera.ai
Datatera.ai是一个基于人工智能的无代码数据提取与结构化处理平台,可帮助用户从非结构化的文件、网页内容中快速提取目标数据并整理为规范结构化格式。核心功能支持多种格式文件数据提取、网页内容结构化转换、批量数据处理、自定义数据提取规则与导出下载,适用于需要收集整理外部数据但无编程基础的办公人员、市场研究人员、内容运营人员等。可应用于竞品信息收集、公开市场数据整理、调研资料汇总、文档内容批量提取等多种工作场景。

Webtap.ai
Webtap.ai是一款依托AI技术打造的网页数据提取工具,核心定位为无需代码即可完成网页内容抓取与结构化整理的在线服务。工具支持用户通过自然语言输入需求,自动识别不同网页结构提取目标内容,可处理新闻资讯、商品信息、公开资料等多种类型网页内容。面向有网页数据获取需求的用户,适用于市场调研、内容整理、竞品分析、学术资料收集等多种场景,帮助用户降低数据提取门槛,完成网页信息的收集整理工作。

InstantAPI.ai
InstantAPI.ai是一款AI驱动的网页数据提取工具,核心定位是帮助用户无需编写代码即可将任意公开网页转换为可用的个性化API。它依托AI技术自动识别网页内容结构,支持自定义提取规则,可生成标准化的API接口供用户调用。核心功能包含网页结构智能解析、自定义数据提取、API接口生成、接口调用监控、多格式数据导出,面向开发人员、数据分析师、产品运营人员等有网页数据获取需求的用户,适用于快速获取竞品公开数据、搭建数据监控体系、快速开发数据应用原型等场景,降低网页数据采集与接口开发的门槛。

Rapture Parser
Rapture Parser是一款用于从网站提取结构化数据的网页抓取API服务,核心定位是为开发人员、数据分析师提供稳定便捷的网页数据获取方案。支持自定义请求配置、反爬绕过处理、多种数据格式导出,可自动解析网页节点生成规范结构化数据,无需用户自行维护抓取代理与解析规则。目标用户覆盖开发人员、数据分析师、产品调研人员、学术研究者等,适合用于竞品价格监控、公开信息采集、行业数据汇总、内容聚合等多种数据获取场景。

SearchCans
SearchCans是一款面向AI开发者与RAG应用构建者的API服务平台,核心提供专为AI智能体和RAG管道设计的并行SERP搜索与网页转文本服务,具备高并发处理能力,且无小时频率限制。核心功能包含并行SERP结果获取、网页内容提取转结构化文本、高并发请求处理、自定义搜索参数配置、流式内容输出。适合AI开发者构建RAG知识库、AI智能体实时信息获取、内容聚合平台数据爬取、大语言模型外部信息检索等场景使用。