
Magic Hour
Magic Hour是一个专注于AI视频创作的在线平台,核心定位是为创作者提供低门槛的视频生成与编辑能力。平台支持文本生成视频、图片动效转化、视频风格重绘等核心功能,还提供多类垂直场景的创作模板。目标用户覆盖内容创作者、营销从业者、设计师、影视制作人员等群体,可用于短视频制作、营销物料产出、创意视觉演示、影视作品前期试拍等多种场景,帮助用户降低视频创作的技术门槛与时间成本。

模力视频
模力视频是专注于AI驱动的视频创作与处理工具平台,核心定位是降低视频制作的技术门槛,提升内容生产效率。平台核心功能包括AI数字人视频生成、AI视频智能剪辑、AI图文转视频三类,支持用户无需复杂专业操作即可完成不同类型视频内容的制作。目标用户覆盖内容创作者、企业营销人员、教育从业者、电商运营者等群体,可应用于短视频创作、品牌宣传物料制作、教学课程录制、电商商品展示视频制作等多个场景,适配不同行业的视频内容生产需求。
Stable Video
Stable Video是聚焦AI视频生成领域的在线创作工具,核心定位是为用户提供文生视频、图生视频、视频风格迁移等AI视频创作能力。平台支持用户通过文本描述、上传参考图片的方式快速生成符合需求的动态视频内容,还可对已有视频进行画面风格替换、动态效果增强等二次编辑操作。目标用户覆盖内容创作者、设计人员、市场营销人员、自媒体运营者等群体,适用于短视频内容制作、广告素材创作、产品演示视频生成、创意内容demo制作等多个场景,降低视频创作的技术门槛与时间成本。
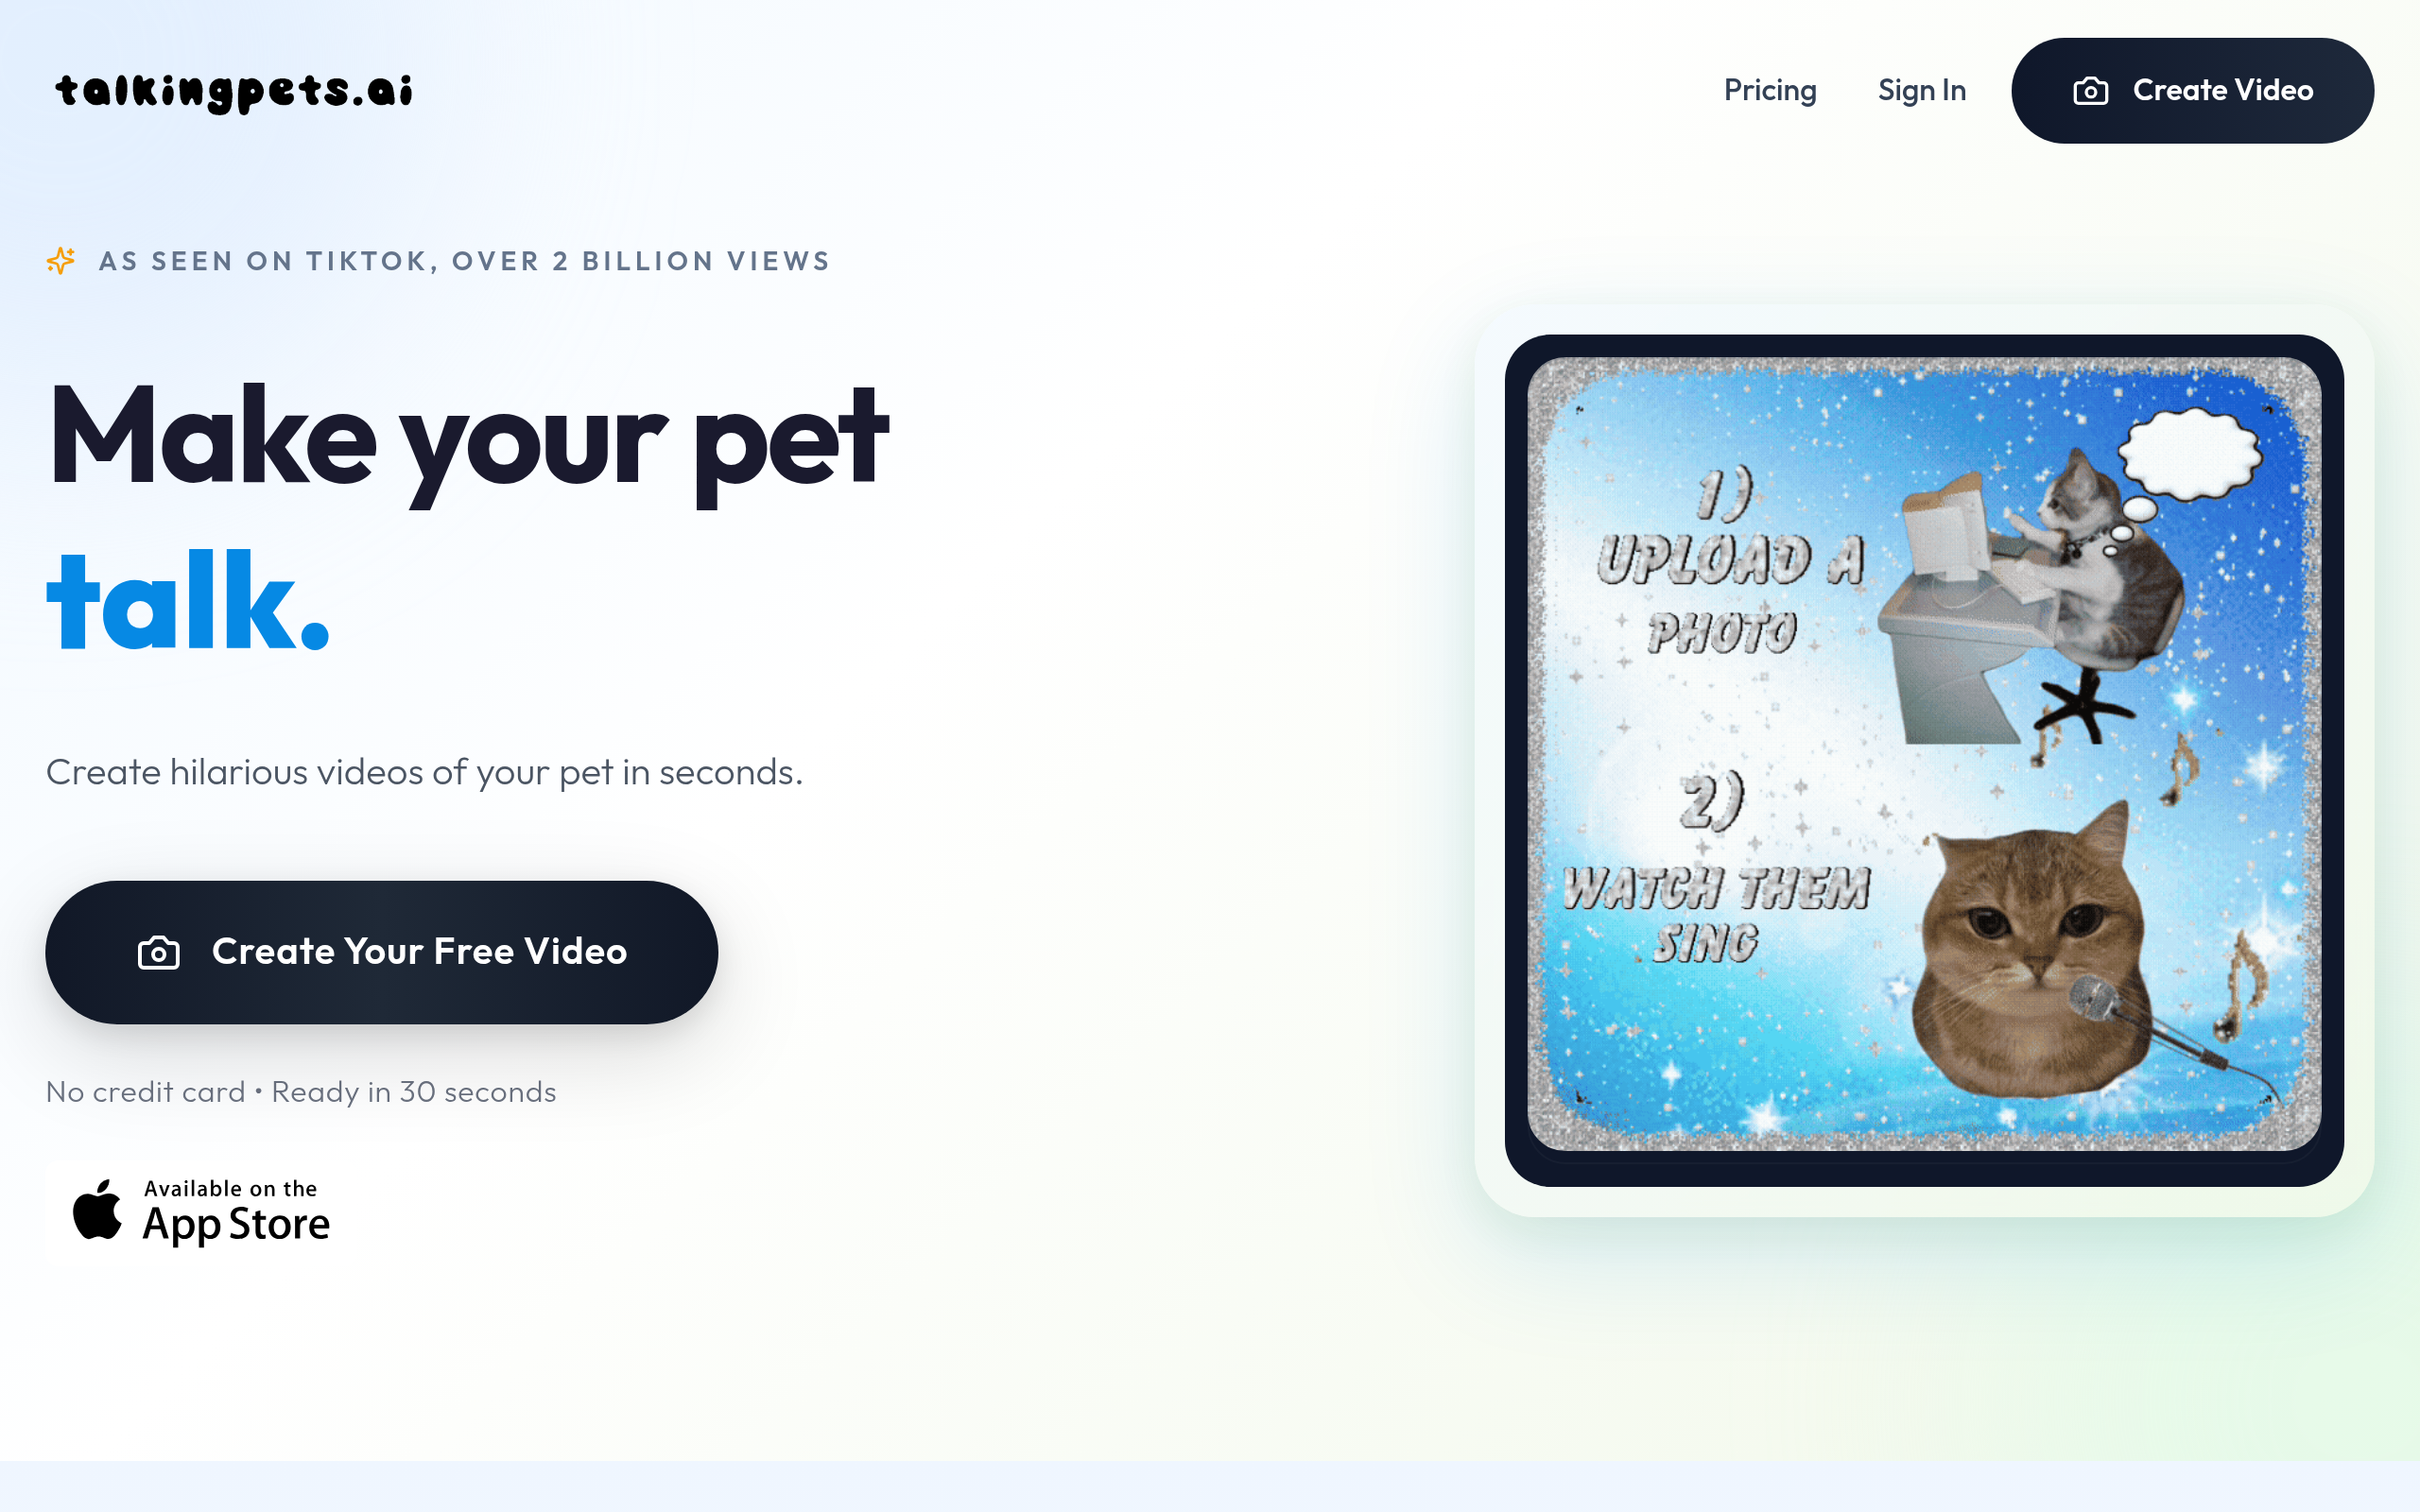
TalkingPets.ai
TalkingPets.ai是专注于宠物拟人化内容生成的AI工具平台,核心定位是为宠物爱好者提供趣味化的宠物创意内容制作能力。平台支持宠物照片拟人化说话视频生成、宠物专属性格文案创作、宠物跨场景形象生成三大核心功能,面向宠物饲养者、宠物内容创作者、宠物行业运营人员等用户群体,可用于社交媒体宠物内容创作、宠物纪念内容制作、宠物品牌营销素材生产等多个场景,帮助用户将宠物日常素材转化为有故事感的创意内容。
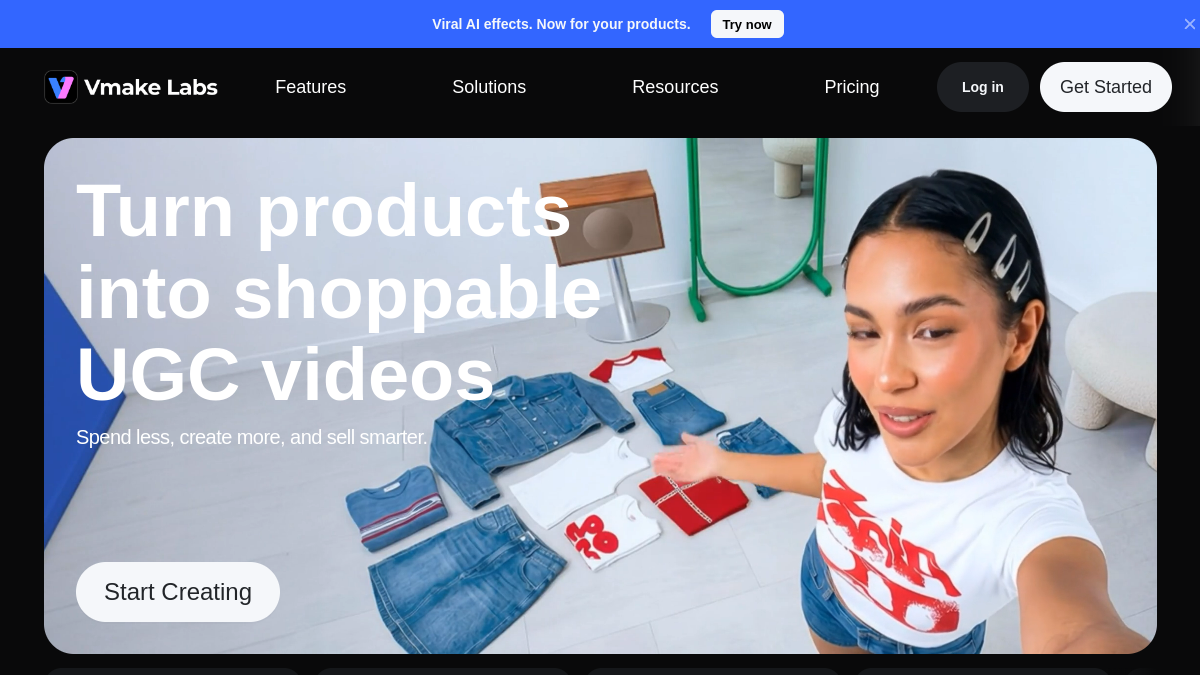
Vmake
Vmake是聚焦于音视频及多媒体内容创作的AI工具平台,核心定位是为内容创作者提供智能化的多媒体生产解决方案。平台支持AI视频生成、图片智能处理、音频内容创作三类核心功能,适配短视频制作、新媒体运营、电商内容产出、教学课件制作等多个场景,面向内容创作者、运营人员、电商从业者、教育工作者等多类用户,无需复杂的专业剪辑或设计技能,即可通过AI能力降低内容生产门槛,提升内容制作效率。
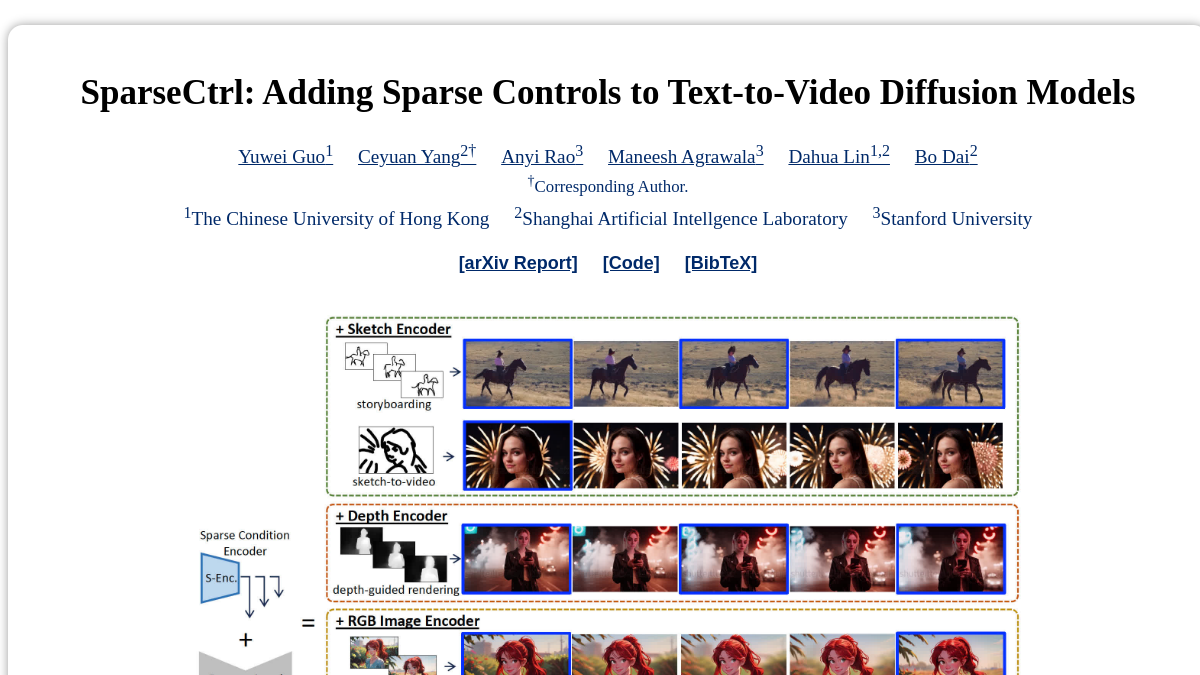
SparseCtrl
SparseCtrl是面向文本到视频生成场景开发的控制增强技术项目,核心定位是降低视频生成的结构控制门槛,无需改动预训练文本到视频模型即可实现精准内容引导。其核心功能包括多类型稀疏信号支持,可适配草图、深度图、单张RGB图像等不同输入形式;轻量条件编码机制,通过独立编码器处理稀疏控制信号,不破坏原有模型的生成能力;多场景适配能力,支持故事板转视频、关键帧动画生成、帧插值等不同创作需求。目标用户覆盖AI视频创作者、动画制作人员、影视前期策划人员、AI技术研究者等群体,可应用于短视频内容制作、动画分镜落地、影视概念片生成、学术技术验证等多个场景。
TrailBlazer
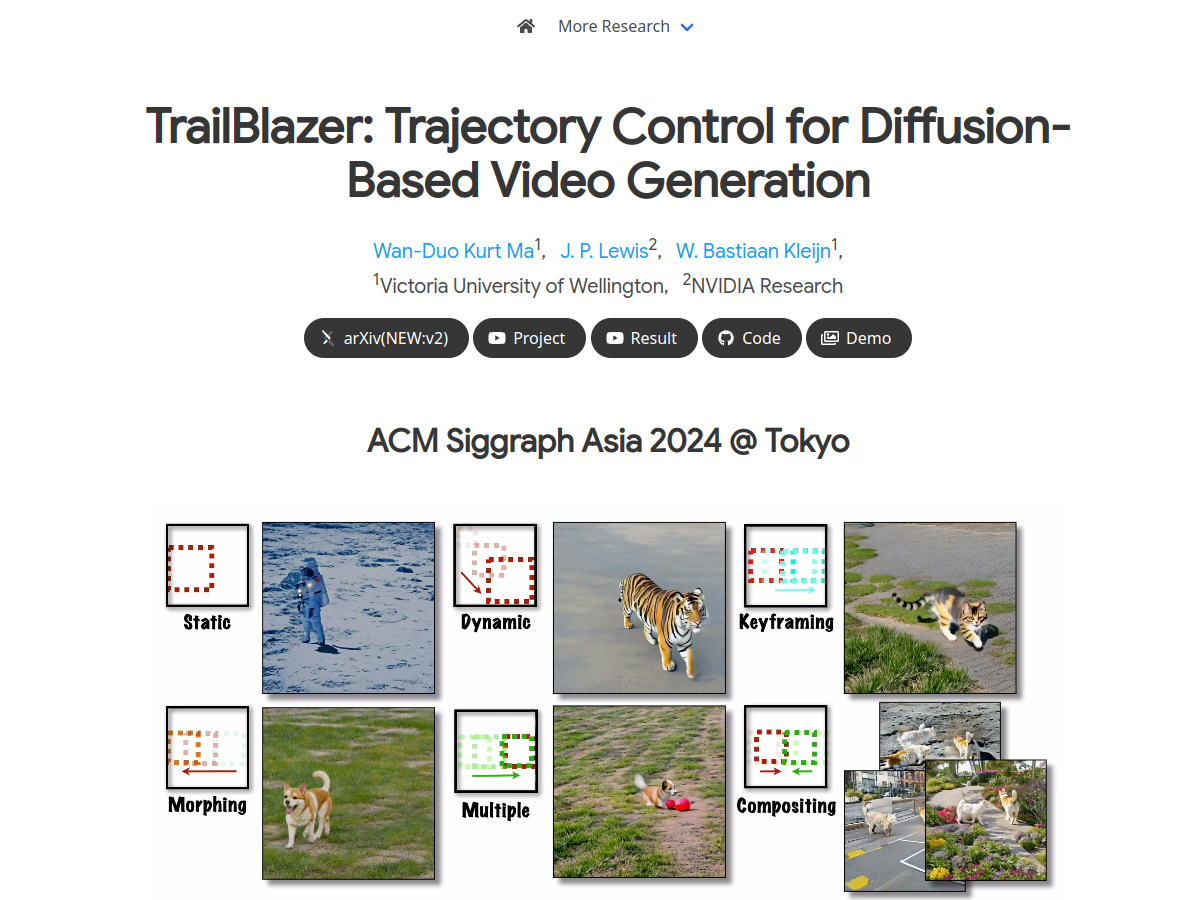
TrailBlazer是一款基于扩散模型的轨迹可控视频生成工具,核心定位是帮助用户在无需额外训练模型的前提下,通过轨迹引导实现定制化视频生成。核心功能包括:其一,边界框轨迹引导,用户仅需绘制简单的边界框即可控制视频中主体的移动路径;其二,时空注意力地图编辑,支持对视频的空间布局和时间序列上的注意力权重进行调整;其三,关键帧+提示词联动控制,可同时通过关键帧边界框和文本提示设置主体的轨迹与外观特征。该工具面向AI视频创作者、动画设计师、内容运营人员、学术研究人员等群体,适用于创意短视频制作、动画分镜生成、动态广告设计、视频生成技术研究等多种场景,可降低轨迹可控视频的制作门槛。
Generative Rendering:2D mesh
Generative Rendering:2D mesh是一款结合3D网格可控性与扩散模型生成能力的在线生成工具,核心定位是解决现有文本生成视频可控性不足的问题。其核心功能包括支持低保真动画3D网格输入生成高保真时序一致视频、可通过调整资产动作与相机路径控制视频内容、将网格对应信息注入文本生成模型各阶段保证生成质量。目标用户覆盖CG创作者、AI生成内容研究者、动画制作从业者、游戏内容开发者、新媒体内容创作者等,可应用于动画初稿制作、3D内容风格化渲染、创意短视频生成、游戏过场动画快速制作、学术研究效果验证等多种场景。
DDLE.DEV
DDLE.DEV是一款面向网站运营、产品推广等领域的AI驱动网站演示视频生成工具,核心定位是帮助用户快速生成带有AI语音讲解和数字人出镜的交互式网站演示内容。其核心功能包括:支持对目标网站进行全屏操作录制,同步生成自然的AI解说语音和匹配的数字人出镜画面;生成的演示内容可直接生成分享链接,无需用户下载本地文件即可传播;演示内容支持类视频通话的交互展示形式,观看者可直观看到网站操作流程。该工具面向产品经理、市场推广人员、独立开发者、SaaS运营人员、客服人员、教育工作者等群体,适用于产品功能对外宣讲、新用户操作引导、客户问题可视化解答、网站功能迭代说明等多个场景,无需复杂的视频剪辑技能即可完成专业演示内容制作。

MotionDirector
MotionDirector是由ShowLab团队推出的文本到视频生成技术演示平台,核心定位为视频内容创作领域的动作自定义生成工具。平台支持双路径LoRA架构训练,可实现视频外观与运动特征的解耦学习;内置去偏置时间损失算法,降低外观属性对时间训练目标的干扰;支持单图动画生成、跨视频动效迁移等场景。目标用户覆盖AI视频研发人员、创意内容创作者、影视动画设计师等群体,可用于短视频动效制作、实验性艺术创作、AI生成视频技术调研等多个场景。
MotionCtrl
MotionCtrl是一个统一灵活的视频生成控制工具,核心定位是为AI视频生成流程提供精准的运动管控能力。核心功能包括相机运动独立控制、物体运动轨迹引导、多视频生成模型兼容适配三类。工具面向AIGC内容创作者、视频后期制作人员、计算机视觉研究人员等群体,可应用于影视分镜动态预览、动画场景运动设计、AI视频生成效果调优等场景,帮助用户在无需手动逐帧调整的前提下,生成符合运动预期的AI视频内容。

Visla
Visla是一款AI辅助视频创作平台,面向个人创作者与企业团队提供全流程视频制作服务,核心支持AI一键生成视频、文稿式视频编辑、多端高清录制三类核心功能。平台可覆盖短视频制作、企业内训课程录制、产品宣传视频产出、自媒体内容剪辑等多种场景,用户无需复杂的视频编辑基础即可完成从创意到成片的全链路操作,帮助用户降低视频制作的技术门槛与时间成本。

Dream Machine AI.online
Dream Machine AI.online是由Luma AI驱动的AI视频生成平台,核心定位是将文字、图片素材转化为符合物理规则的高一致性视频内容。平台搭载先进的变换模型,支持文本生成视频、图片生成视频、视频风格迁移三类核心功能,可快速输出带有复杂时空运动效果的视频片段。目标用户覆盖视频创作者、内容运营人员、新媒体从业者、影视前期策划人员、广告设计人员、学生创意创作者等群体,适用于短视频内容制作、广告样片快速产出、影视分镜头可视化、创意短片拍摄参考、自媒体内容迭代、课程辅助素材制作等多个场景,可帮助用户降低视频制作的时间与人力成本,提升内容产出效率。

Rendora
Rendora是一个基于3D AI技术的视频创作平台,核心定位是帮助用户通过文本内容直接生成3D视频内容,无需传统视频拍摄的复杂流程。平台支持AI 3D化身生成、多场景模板调用、文本驱动动作匹配三大核心功能,面向内容创作者、企业营销人员、教育从业者等群体,可用于制作产品宣传视频、在线课程内容、虚拟发布会片段、品牌虚拟人短视频等多种类型的内容,降低3D视频制作的技术门槛与成本投入。
寻光视频创作平台
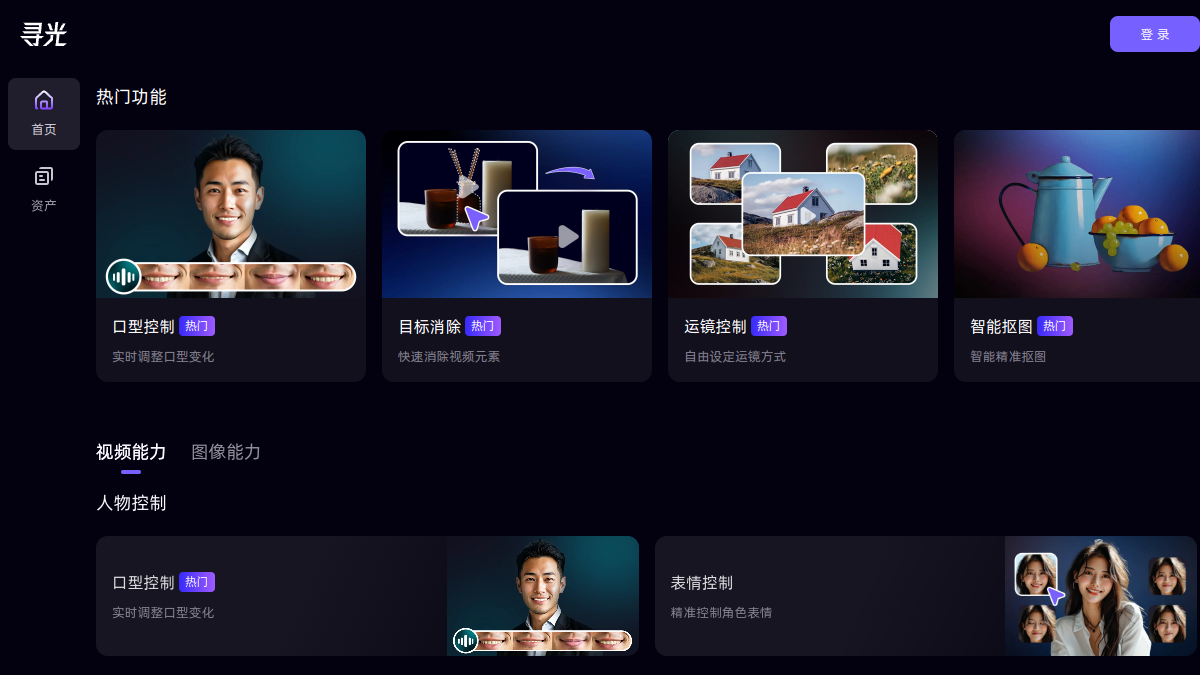
寻光视频创作平台是搭载人工智能技术的在线视频创作服务,聚焦为用户提供智能化的视频创作全链路支持。平台核心功能包含AI剧本生成与分镜转化、自定义角色库搭建与管理、AI视觉素材自动生成、一站式视频内容剪辑编辑,可满足不同创作者从创意构思到成片输出的全流程需求。目标用户覆盖短视频创作者、自媒体运营者、影视行业从业者、企业宣传人员、学生创作群体等,适用于短剧情脚本创作、产品宣传视频制作、课程配套视频开发、个人创意短片制作等多种场景,助力用户降低视频制作的技术门槛与时间成本。
VideoAI work
VideoAI work是一款基于人工智能技术的视频创作服务平台,核心定位是为不同创作能力的用户提供全流程视频制作解决方案。平台核心功能包含文本生成视频、视频风格转换、AI视频剪辑三类,可实现从创意到成品的一站式制作。目标用户覆盖内容创作者、新媒体运营人员、企业营销人员、教育从业者等群体,适用于短视频内容产出、品牌宣传片制作、课程视频优化、创意广告设计等多类场景,帮助用户降低视频制作的技术门槛,提升内容产出效率。
来画
来画是集多项创作工具于一体的智能设计平台,核心定位是为不同行业用户提供低门槛的数字内容创作解决方案。核心功能包含AI数字人口播视频生成、在线平面设计、多类型视频编辑三大模块,同时配套千万级正版商用素材库,支持无代码制作动画短视频。目标用户覆盖新媒体运营、企业市场人员、教育工作者、内容创作者等群体,可满足短视频制作、营销物料设计、课程课件制作、品牌宣传内容产出等多种场景需求,降低专业内容创作的技术门槛与制作成本。
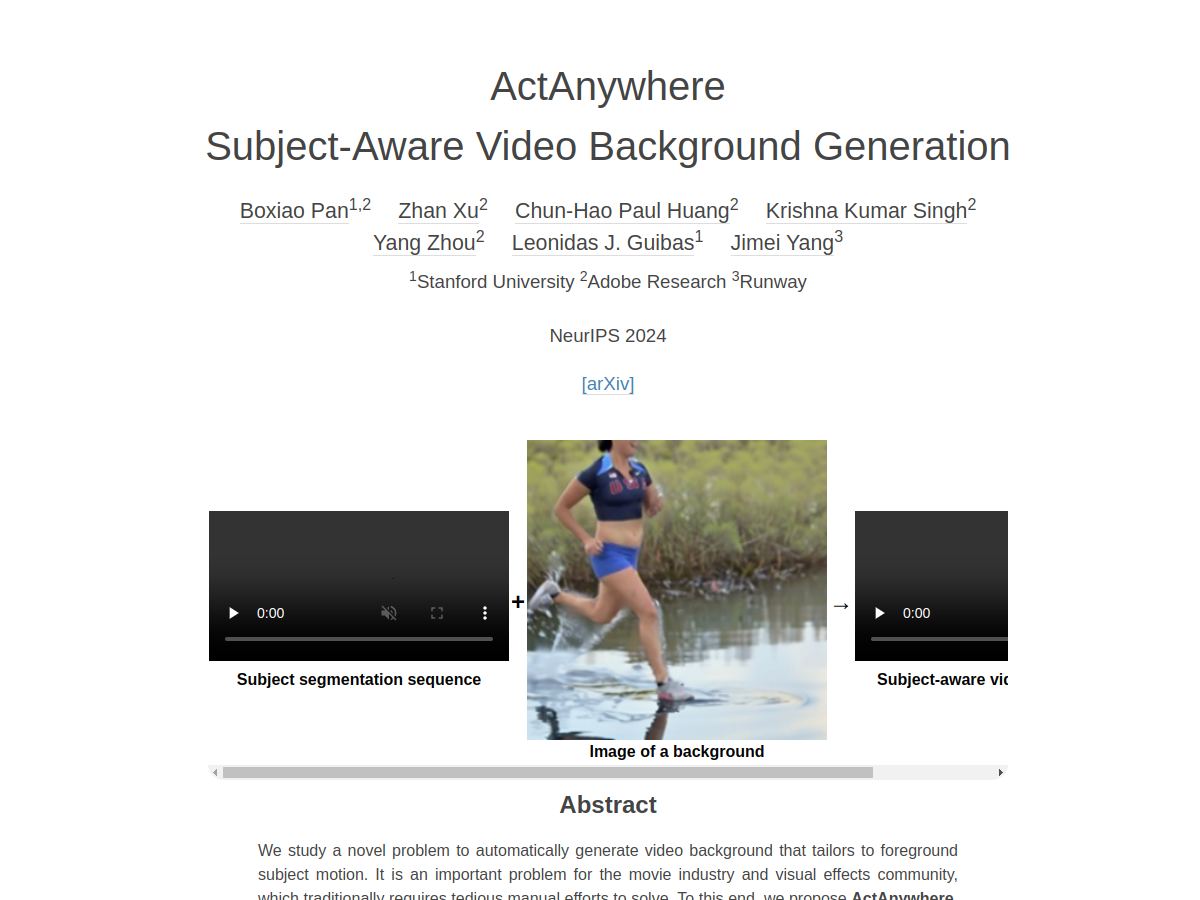
ActAnywhere
ActAnywhere是一款专注于视频背景智能生成的AI工具,核心定位是基于前景主体特征生成匹配度高的动态视频背景。其核心功能包括:支持自定义前景分割序列输入,可根据输入的主体运动片段识别运动轨迹与外观特征;支持参考场景图像作为生成条件,生成符合创作者风格要求的背景内容;可输出连贯的完整视频,实现前景与背景的自然交互效果。目标用户覆盖影视创作者、动画设计师、短视频制作者、AI内容研发人员等,适用场景包括影视短片背景制作、动画场景补全、短视频内容二次创作、AI生成视频的效果优化等,能够帮助创作者降低实景拍摄与后期抠图合成的工作量。
faceless.video
Faceless.video是聚焦TikTok生态的AI自动化视频内容创作工具,核心定位是帮助用户无需出镜即可完成短视频内容的生产、优化与分发。其核心功能包括AI脚本自动生成、无真人出镜视频拼接、TikTok账号定时批量发布,主要面向不想露脸的内容创作者、跨境电商运营人员、海外营销从业者等,可应用于日常账号内容更新、产品推广视频批量制作、多账号矩阵内容运维等场景,帮助用户降低内容生产的时间与人力成本。

Assistive Video
Assistive Video是一款AI视频生成工具,核心定位是帮助用户将文本创意或静态图像转化为动态视频内容,无需复杂的视频剪辑技能。核心功能包括文本生成视频、图像生成视频、积分灵活兑换三类,支持用户快速产出符合需求的视频素材。该工具面向内容创作者、营销运营人员、教育工作者、设计从业者等群体,适用于制作短视频素材、营销宣传物料、教学演示片段、创意概念展示等多个场景,目前处于α测试阶段,功能还在持续优化迭代中。