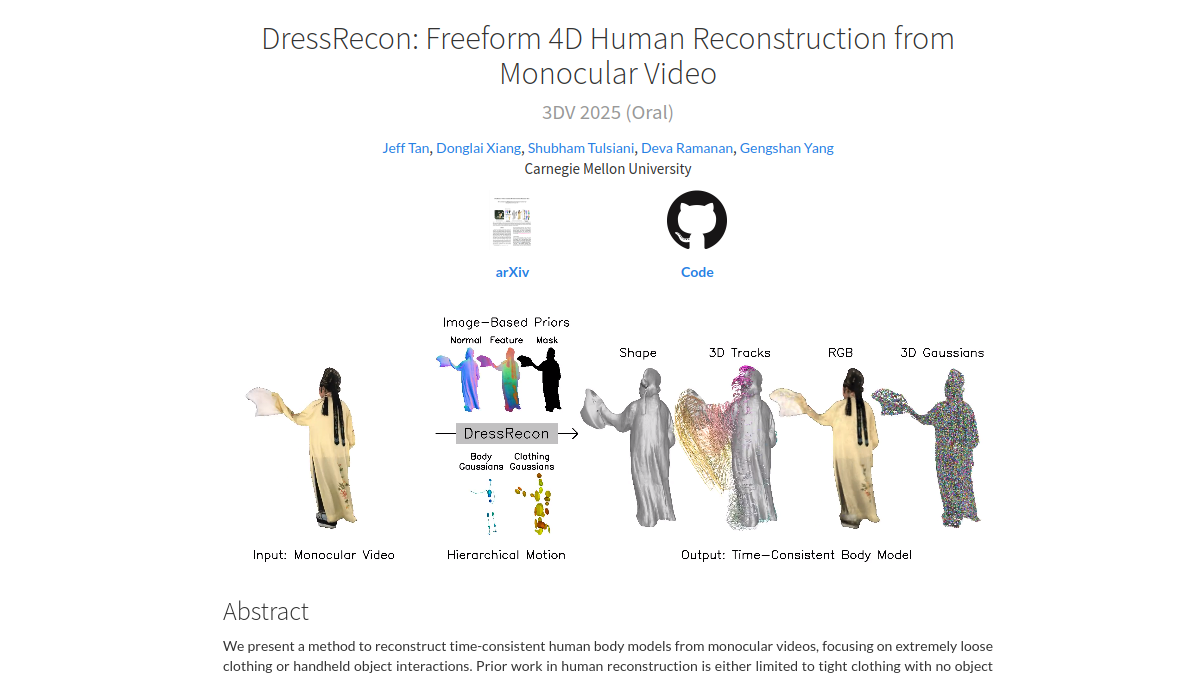
DressRecon是专注于单目视频4D人体模型重建的技术项目站点,核心定位是解决宽松服装、手持物体交互等复杂场景下的人体动态重建难题。核心功能包括时间一致的4D人体模型生成、身体与服装变形分离建模、高保真3D几何细节捕捉,支持重建结果导出为网格或3D高斯格式。目标用户覆盖计算机视觉研究人员、三维动画制作人员、虚拟数字人开发人员、动作捕捉技术从业者。使用场景包含复杂服装的动态效果研究、虚拟人物的动作数据采集、影视动画的角色动作还原、人体交互行为的三维分析等。
- 运营状态
- 正常运营
- 地址
- jefftan969.github.io
- 定价模式
- DressRecon属于开源技术项目,所
- 是否开源
- 闭源
- 适合人群
- 计算机视觉研究人员、三维动画制作人员、虚拟数字人开发人员、动作捕捉技术从业者
- 收录时间
- 2026/6/14
- 访问量
- 0 次
编辑点评
这个站点面向的是有4D人体重建需求的技术从业者,核心优势是解决了传统重建技术在宽松服装、物体交互场景下的精度不足问题。不同于通用的单目三维重建工具,它专门针对复杂服装形变做了技术优化,引入了身体与服装变形分离的机制,既保留了人体动作的准确性,也能还原服装的动态细节,对于需要处理非紧身服饰动态场景的用户来说,是很有参考价值的技术方案。站点提供了完整的技术说明、使用指引与相关数据集链接,用户可以快速复现重建效果,也可以基于现有技术做二次开发,适配不同的应用场景。在同类技术方案中,它在复杂服装场景下的重建保真度处于行业前列,适合对重建精度有较高要求的科研与开发场景使用。
核心功能
使用指南
- 1
打开DressRecon站点,查看项目说明文档,了解技术适用的视频格式、分辨率、内容要求,提前准备符合要求的单目人体动态视频素材。
- 2
参照文档中的指引,准备运行环境,安装项目所需的依赖库与预训练模型文件,完成基础运行环境的配置工作。
- 3
上传预处理好的单目视频,设置重建的分辨率、是否分离服装变形、导出格式等参数,启动模型重建任务等待处理完成。
- 4
任务完成后预览生成的4D人体模型,可逐帧查看动作连贯性、服装细节还原效果,确认是否符合预期,若有偏差可调整参数重新运行。
- 5
根据后续使用需求,选择导出网格模型或3D高斯格式的结果,将文件下载到本地,导入对应的三维软件或开发工具中进行后续处理。
优势与不足
优点5 项
"支持宽松服装、手持物体交互等复杂场景的4D人体重建,适配更多非理想拍摄场景"
"可分离身体与服装变形层,支持单独调整两类参数,便于后续的内容编辑与二次开发"
"重建结果支持网格、3D高斯两种导出格式,适配三维建模、实时渲染等不同下游需求"
"引入多模态图像先验优化,可捕捉服装的细微褶皱与动态过渡效果,提升几何保真度"
"生成的4D模型具备时间一致性,避免不同帧之间的模型抖动、错位问题"
不足4 项
"仅支持单目单人体视频的重建,无法处理多人同框或多视角输入的场景"
"对运行设备的算力要求较高,普通消费级显卡处理长视频时耗时较长"
"没有可视化操作界面,需要用户具备一定的代码运行与环境配置能力才能使用"
"免费提供的预训练模型适配场景有限,特定极端服装场景需要用户自行微调模型"
定价说明
DressRecon属于开源技术项目,所有核心代码、预训练模型、使用文档均免费对外开放,无功能使用限制,用户可自行下载部署使用,也可基于项目进行二次开发。项目不设置付费版本,相关技术支持主要通过开源社区的Issue渠道反馈,没有官方付费技术服务。适合有一定技术能力的个人研究者、小团队用户使用,若需要商业化定制开发,可联系项目作者沟通合作。
价格和授权政策可能变化,请以官网最新信息为准
适合人群与场景
- 计算机视觉研究人员
4D人体重建方向科研
- 三维动画制作人员
角色动作素材采集
- 虚拟数字人开发人员
动态模型构建
- 动作捕捉技术从业者
低成本动捕方案落地
- 服装动力学研究人员
服饰动态效果分析
- 影视特效制作人员
实拍角色三维还原
- 体感游戏开发人员
用户动作识别建模
- 人体运动分析研究者
动作数据三维化处理
常见问题
深度了解
在4D人体重建领域,复杂服装形变、物体交互场景始终是精度提升的难点,传统重建技术往往在紧身服饰、无遮挡场景下表现较好,一旦遇到宽松长袍、裙摆、手持物体等场景,就容易出现姿态识别错误、服装细节丢失、模型时间一致性差等问题。DressRecon作为专门针对这类复杂场景优化的重建方案,通过结合通用人体先验与测试时的“骨骼袋”变形拟合,有效提升了复杂场景下的重建保真度。
DressRecon的核心技术逻辑是通过神经隐式模型将身体基础变形与服装独立变形分离,既保证了人体动作数据的准确性,也能完整还原服装的褶皱、摆动等动态细节,同时引入人体姿态、表面法线、光流三类多模态先验进行优化,捕捉更细微的几何特征。用户使用时只需要输入普通单目相机拍摄的动态视频,即可生成时间一致的4D人体模型,支持导出为传统网格格式用于三维编辑,也可导出为3D高斯格式实现高质量实时渲染。
对于计算机视觉方向的研究人员,DressRecon可以作为基础方案开展4D重建相关的科研实验,减少从零开发的工作量;对于动画制作、虚拟数字人开发人员,DressRecon可以实现低成本的动态人体素材采集,无需专业动捕设备即可获得包含服装细节的动作模型;对于服装动力学研究人员,衣身分离的特性可以帮助其单独分析服装的动态形变规律,提升研究效率。目前项目完全开源,所有代码与预训练模型均可免费获取,用户可根据自身需求进行部署与二次开发。
Ready to try
准备好体验 DressRecon 了吗?
点击下方按钮在新标签页打开官网,开始探索它的全部功能。
相关工具
腾讯混元3D
免费腾讯混元3D是腾讯推出的AI 3D内容生成平台,核心定位为降低3D内容创作的技术门槛。平台支持文本生成3D模型、图像生成3D模型、3D模型精细编辑三大核心功能,面向3D设计师、游戏开发者、动画制作人员、高校设计专业学生、文创从业者、元宇宙内容创作者等群体,可应用于游戏场景搭建、动画角色制作、文创产品设计、虚拟场景构建、教学实训演示等多个场景,无需用户掌握复杂的3D建模软件操作逻辑,即可快速生成符合需求的3D内容素材。
SketchUp
SketchUp是一款面向多领域的3D建模工具,核心定位为轻量化、易上手的三维设计平台。核心功能包含直观的推拉式建模工具,用户仅需通过简单的点击拖拽即可完成基础几何体到复杂空间结构的搭建;内置海量3D模型库,涵盖家具、建材、植物、设备等多类常用组件,可直接调用减少重复建模工作量;支持多格式文件导出与跨软件协作,适配CAD、3D打印、渲染工具等不同环节的需求。目标用户覆盖建筑设计师、室内设计师、景观规划师、机械工程师、高校设计类学生等群体,适用于方案草图构思、深化设计建模、项目方案展示、3D打印原型制作、课程作业设计等多个场景。
Tripo3D
免费Tripo3D是专注于AI驱动3D内容创作的在线平台,核心定位是降低3D模型制作的技术门槛,为内容创作者提供高效的3D资产生成解决方案。平台核心功能包括文本生成3D模型、单图转3D模型、智能纹理生成,支持游戏开发者、3D设计师、元宇宙内容创作者、动画制作人员、工业设计人员等群体使用,可应用于游戏原型开发、虚拟场景搭建、3D打印原型设计、动画内容制作、电商3D商品展示等多种场景,帮助用户减少传统3D建模的时间成本,提升内容生产效率。

书生·天际LandMark
书生·天际LandMark是基于NeRF技术打造的实景三维大模型服务平台,核心定位是为城市级三维场景构建与应用提供技术支撑。平台支持100平方公里范围的4K高清实景三维模型训练,可实现大场景实时渲染输出,还支持对三维场景进行自由编辑调整。目标用户覆盖城市规划从业者、建筑设计人员、VR内容开发者、高校科研人员、数字孪生项目建设方等群体,可应用于城市规划方案推演、建筑项目效果预览、VR城市场景制作、数字孪生城市搭建、历史城市风貌复原等多个场景。
Imagine 3D
免费Imagine 3D是Luma AI推出的AI驱动文字生成3D模型工具,核心定位是降低3D内容创作门槛,无需专业建模基础即可生成三维资产。核心功能包括文本prompt生成3D模型、内置模型编辑调整、多格式导出适配主流创作工具。目标用户覆盖3D设计师、游戏开发者、广告创意人员、数字艺术家、新媒体创作者等群体,可应用于游戏资产制作、广告场景搭建、元宇宙内容创作、3D打印原型设计、影视道具概念设计等多个场景,帮助用户减少传统建模的时间成本,快速落地创意想法。
捏Ta
免费捏Ta是专注于AI虚拟形象创作的在线平台,核心定位为低门槛3D虚拟角色生成工具。平台支持文本生成虚拟形象、自定义调整外观参数、一键导出多格式模型三大核心功能,面向虚拟主播、游戏开发者、内容创作者、二次元爱好者等用户群体,可应用于直播虚拟形象搭建、游戏NPC角色创作、短视频内容虚拟角色制作、个人社交平台虚拟头像制作等多种场景,无需专业3D建模基础即可完成符合需求的虚拟角色创作。
Stable Zero123
免费Stable Zero123是Stability AI推出的视图条件3D生成模型官方介绍页面,核心定位为面向研究与非商业场景的3D生成技术落地载体。核心功能包括技术原理详解、开源获取路径指引、训练效率对比呈现,目标用户覆盖3D内容创作者、AI研究人员、计算机视觉领域开发者、文创行业从业者,可用于单视图生成多视角3D对象、学术研究技术复现、文创项目3D素材快速生成等场景,帮助用户降低3D内容生产的技术门槛,提升3D生成模型的训练与落地效率。
Meshy
免费Meshy是一款聚焦3D内容生产领域的AI工具平台,核心为用户提供智能3D模型生成、智能纹理生成、多格式导出三大核心能力,支持文字 prompt 驱动生成、2D图片转3D两类生产路径,可覆盖游戏开发、建筑可视化、动画制作、3D打印等多个领域的3D资产生产需求,目标用户包含3D创作者、游戏开发人员、建筑设计师、动画制作师等群体,能够帮助用户缩短3D资产的生产周期,降低传统3D创作对专业建模技能的要求,适配不同场景下的3D内容产出需求。
你是 DressRecon 的开发者或团队吗?
认领后可编辑工具信息、获取真实点击数据,并在页面上展示官方认证徽章。
访问第三方工具时,请注意账号、隐私与支付安全
用户评论
0· 0 条