SRE工具
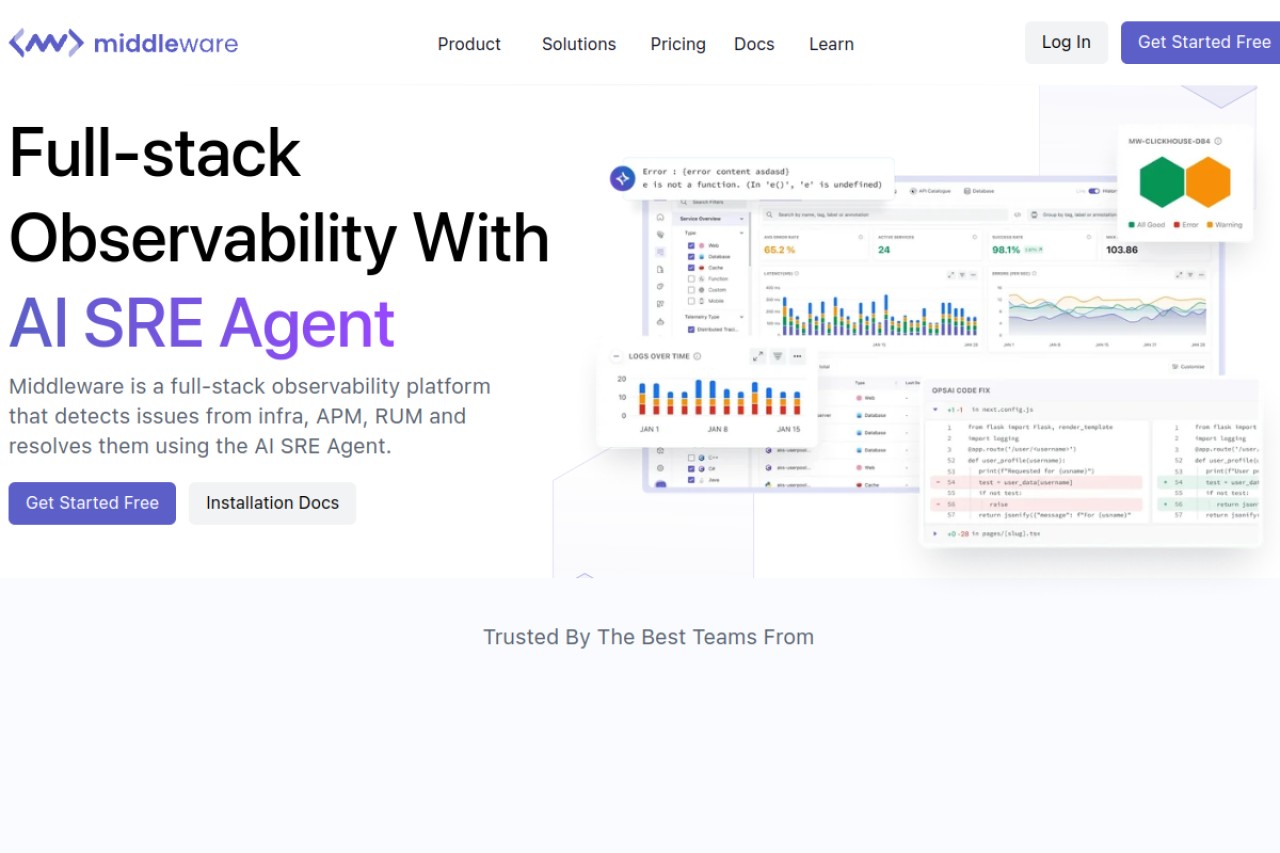
middleware.io
Middleware是面向云原生场景的可观测性监控平台,核心定位是为云架构下的系统运维、开发团队提供全链路监控与问题诊断能力。其核心功能包含多维度资源监控、全链路故障溯源、实时异常告警,可覆盖从底层基础设施到上层用户体验的全栈观测需求。目标用户包含企业运维工程师、后端开发人员、SRE团队、云架构师等,适用于云服务性能调优、线上故障快速排查、系统容量评估、业务稳定性巡检等多种场景,帮助用户建立完善的云架构观测体系。

kubeha.com
KubeHA是一款依托生成式AI构建的Kubernetes自动化警报恢复服务平台,核心定位是帮助企业和开发运维团队处理Kubernetes集群运行中的各类警报事件,实现自动化诊断与恢复。平台可自动解析集群警报信息,结合AI能力生成并执行恢复方案,减少人工处理工作量,降低警报带来的运营压力。核心功能包括自动化警报诊断、AI生成恢复方案、自动执行恢复操作、警报历史归档分析、多集群接入管理等,适合拥有Kubernetes集群的企业开发运维团队、云服务服务商、容器技术研究人员等使用,可应用于日常集群运维、突发警报处理、非工作时间集群监控等多种场景。

struct.ai
Struct是一款面向工程运维场景的AI轮值助手,核心定位为自动执行工程告警根因分析,帮助运维团队降低人工排查告警的工作量。该产品支持自动接入告警信息、多维度分析告警关联关系、生成可落地的根因结论与处理建议,支持对接主流监控系统与运维工具链。目标用户包含企业运维团队、SRE工程师、DevOps开发人员、云服务运营人员等,适用场景覆盖日常告警轮值处理、突发生产故障排查、夜间非工作时段告警响应、月度告警根因复盘分析等。
predictops.com
PredictOPs是一个基于生成式人工智能技术的AIOps平台,面向企业IT运营团队提供高级运营管理与预测分析服务。平台整合了AI驱动的异常检测、根因分析、预测性故障预警、自动化运维编排、运营报表生成等核心功能,可帮助企业打通不同IT系统的数据壁垒,从海量运营数据中提取有效决策信息。目标用户涵盖企业IT运维团队、DevOps开发人员、SRE站点可靠性工程师、IT运营经理、企业架构师以及金融科技领域的运维负责人,适用于大规模分布式系统日常运维、业务高峰前系统稳定性保障、历史运维问题复盘分析、新系统上线前风险评估等多种场景。

keephq.dev
Keephq是面向IT运维场景的开源AIOps平台,核心定位是帮助团队在复杂IT环境下高效处理告警信息,降低故障响应延迟。平台核心功能包括:告警信息自动丰富、可自定义的告警处理工作流、多源告警统一单视图展示,支持90余种主流运维工具的集成对接。目标用户覆盖SRE人员、运维工程师、研发团队、企业IT部门、初创公司技术团队等,可应用于日常运维告警降噪、故障根因快速定位、跨团队运维流程协同、多系统运维数据聚合等场景,帮助团队优化告警处理效率,减少无效告警干扰。
rcaiapp.com
RCAi是面向技术运维领域的AI根因分析工具,核心定位是帮助技术团队快速完成故障的根因分析输出。核心功能包括故障时间线智能解析、标准化RCA报告自动生成、主流运维告警平台对接,面向SRE、值班工程师、运维负责人、技术支撑团队等用户,可应用于线上故障复盘、运维流程优化、故障案例沉淀、跨团队故障同步等场景,减少人工梳理故障信息、撰写分析报告的时间投入,提升故障复盘的整体效率。

drdroid.io
Doctor Droid是一款专注于生产环境故障排查的AI代理工具,核心定位是帮助企业技术团队快速定位并解决线上系统运行异常。该工具支持对接现有开发运维工具栈,可自主拉取系统日志、监控指标、链路追踪等多源数据,结合企业自定义的系统架构、历史故障知识库等上下文信息,输出可落地的故障排查路径与解决方案。其目标用户涵盖企业运维工程师、后端开发人员、SRE团队、技术负责人等,适用于线上服务突发异常排查、系统性能瓶颈定位、日常运维巡检、故障复盘分析、新成员运维技能培训等多个场景,帮助团队减少生产故障的持续影响时长,降低运维工作的人工投入成本。
metoro.io
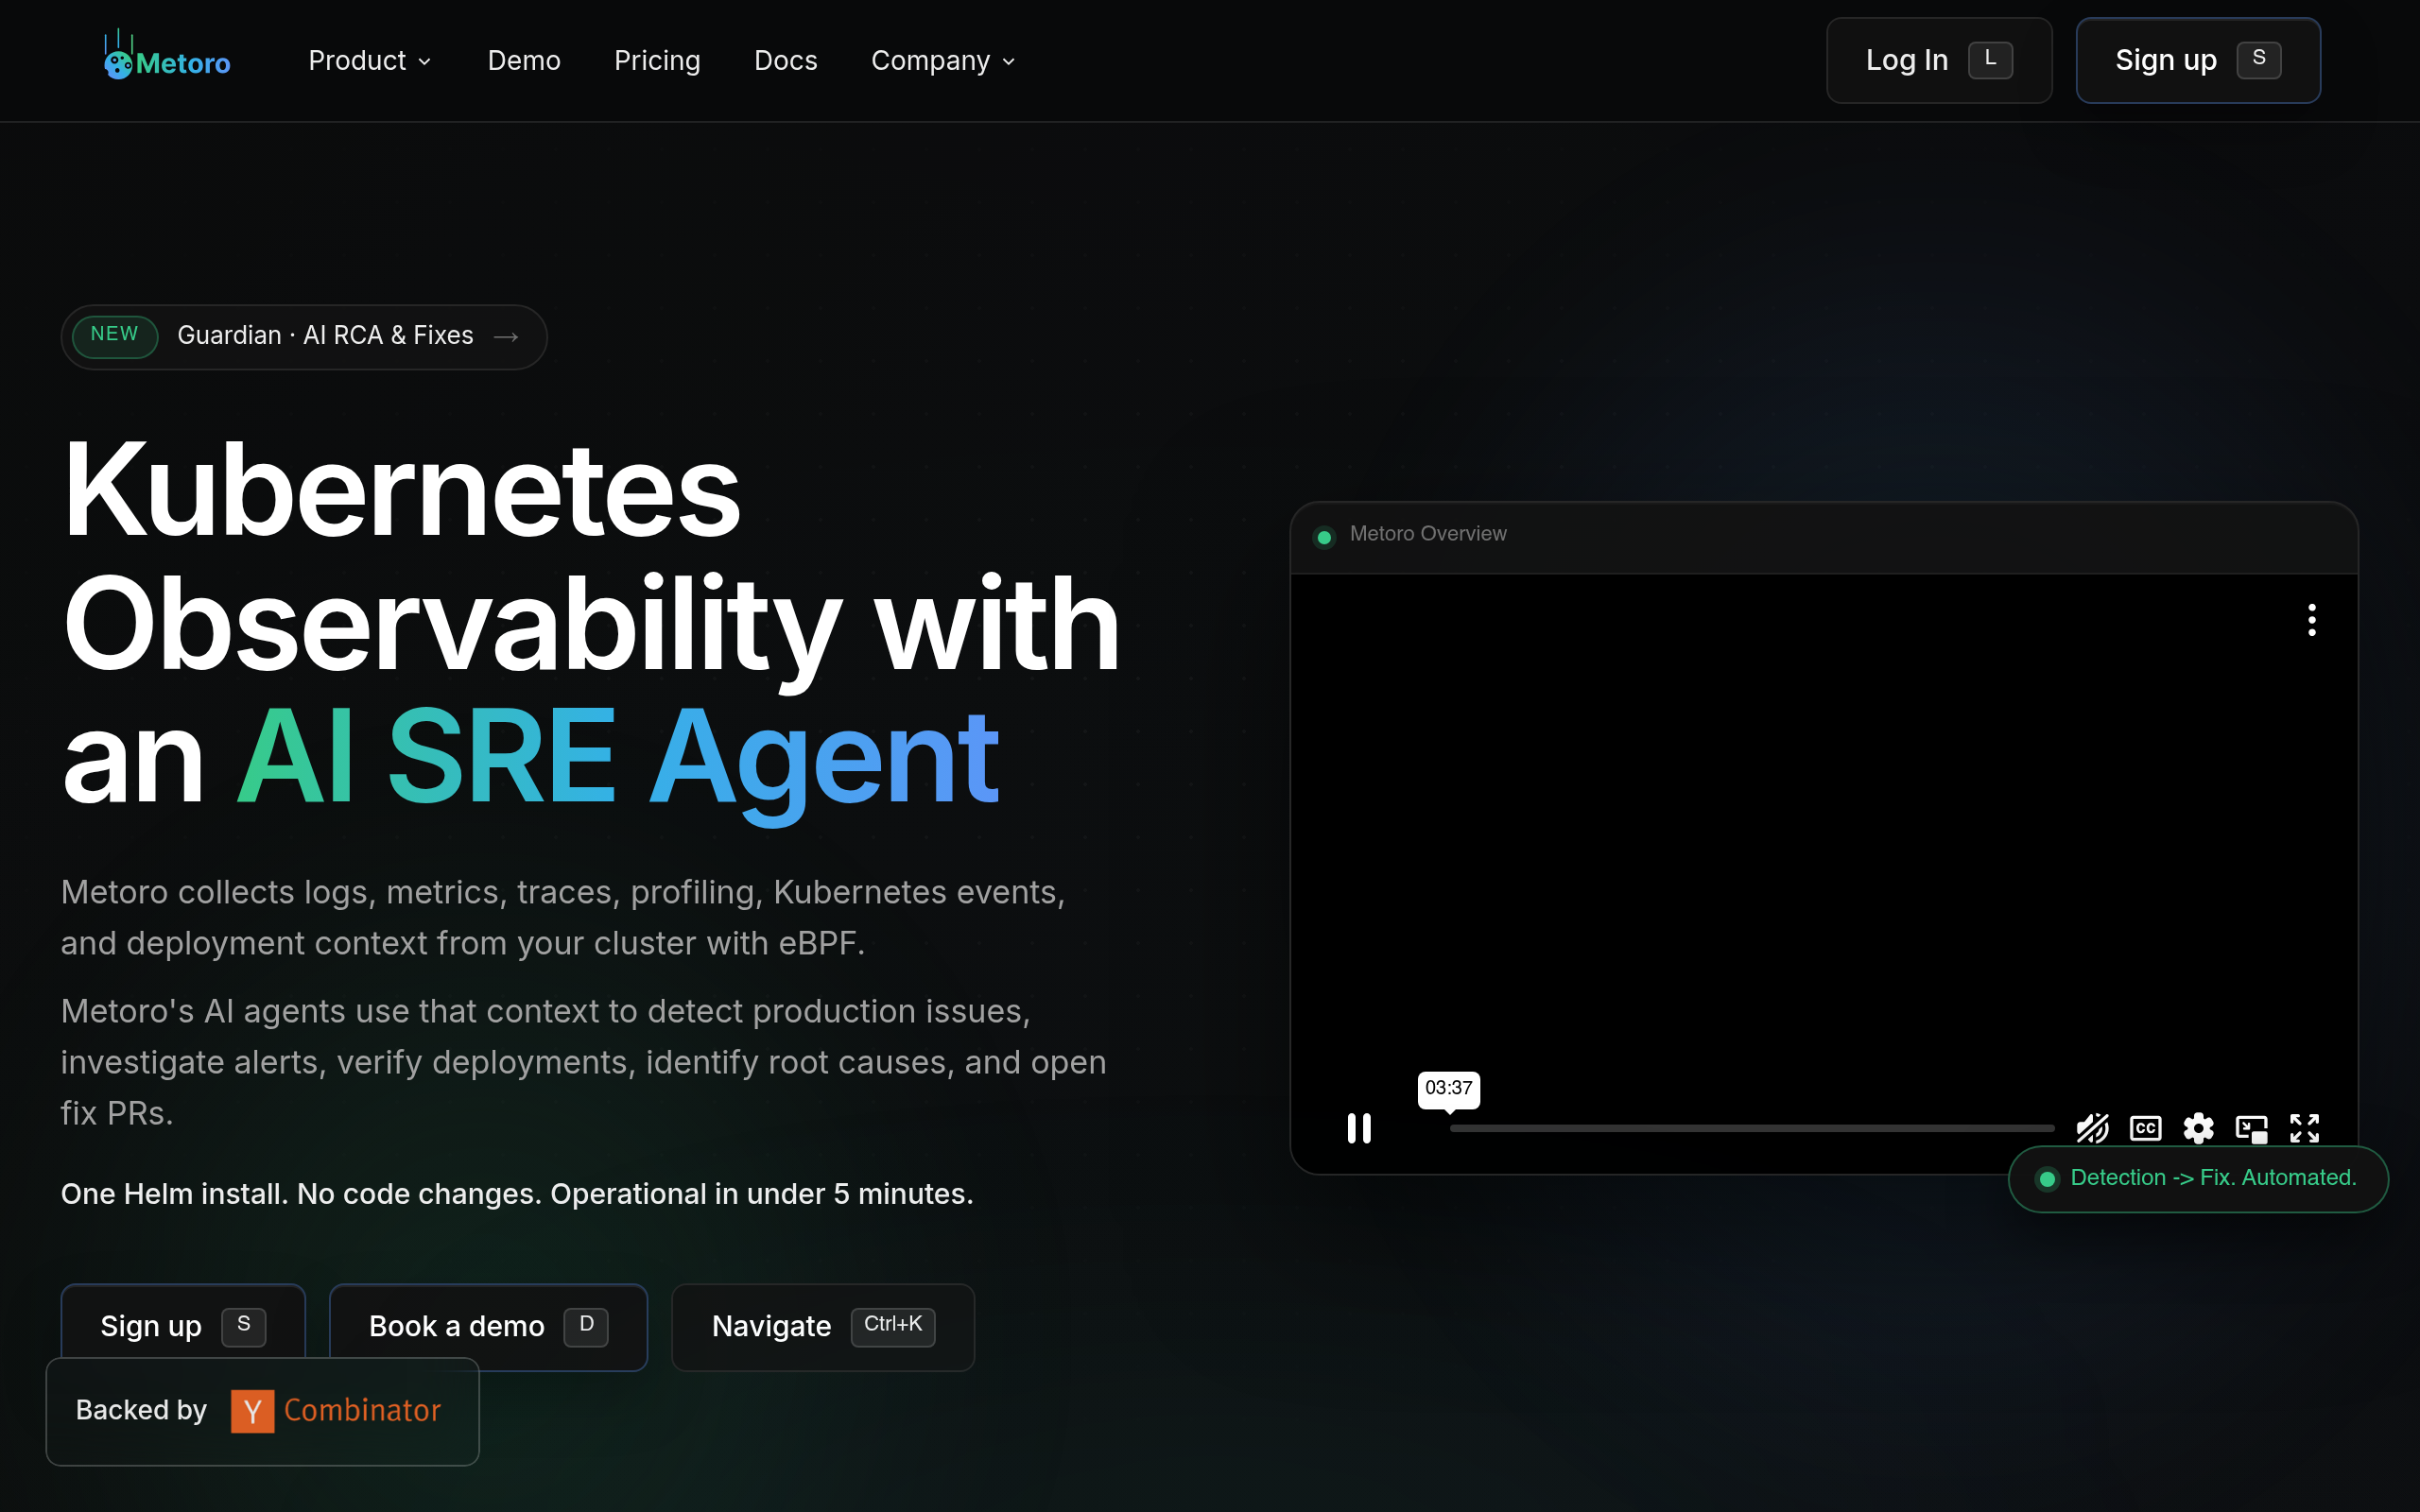
Metoro是一款基于AI技术的云原生运维服务工具,核心定位是为企业部署环节提供全流程的智能化校验与问题处理支持。核心功能包括自动化部署校验、异常问题智能检测、根因分析以及修复方案推荐,支持在1分钟内完成部署且无需修改现有业务代码。目标用户覆盖云原生运维工程师、DevOps团队、后端开发人员、技术负责人等群体,可应用于K8s集群上线前校验、生产环境部署风险排查、业务故障快速定位、日常运维效率优化等多种场景,帮助团队降低部署故障发生率,缩短问题处理周期。
reflexslo.io
Reflex是一款面向Kubernetes运维场景的自动化运维工具,核心定位是基于服务级别目标(SLO)和智能信任阶梯机制,实现Kubernetes运行时故障的提前识别与自动修复。核心功能包括SLO驱动的故障感知体系,可对接现有监控数据源匹配异常指标;智能信任阶梯修复机制,按风险等级递进执行修复动作避免误操作;全链路可追溯的运维审计日志,记录每一次自动修复的触发原因、执行步骤和结果。目标用户覆盖Kubernetes集群管理员、云原生运维工程师、SRE工程师、企业级DevOps团队成员,适用于集群日常巡检、高峰流量期间故障快速响应、非工作时段无人值守运维、应用迭代上线后稳定性保障等多个场景,减少运维人员手动处理重复故障的工作量,降低集群故障对业务的影响时长。
sonarly.com
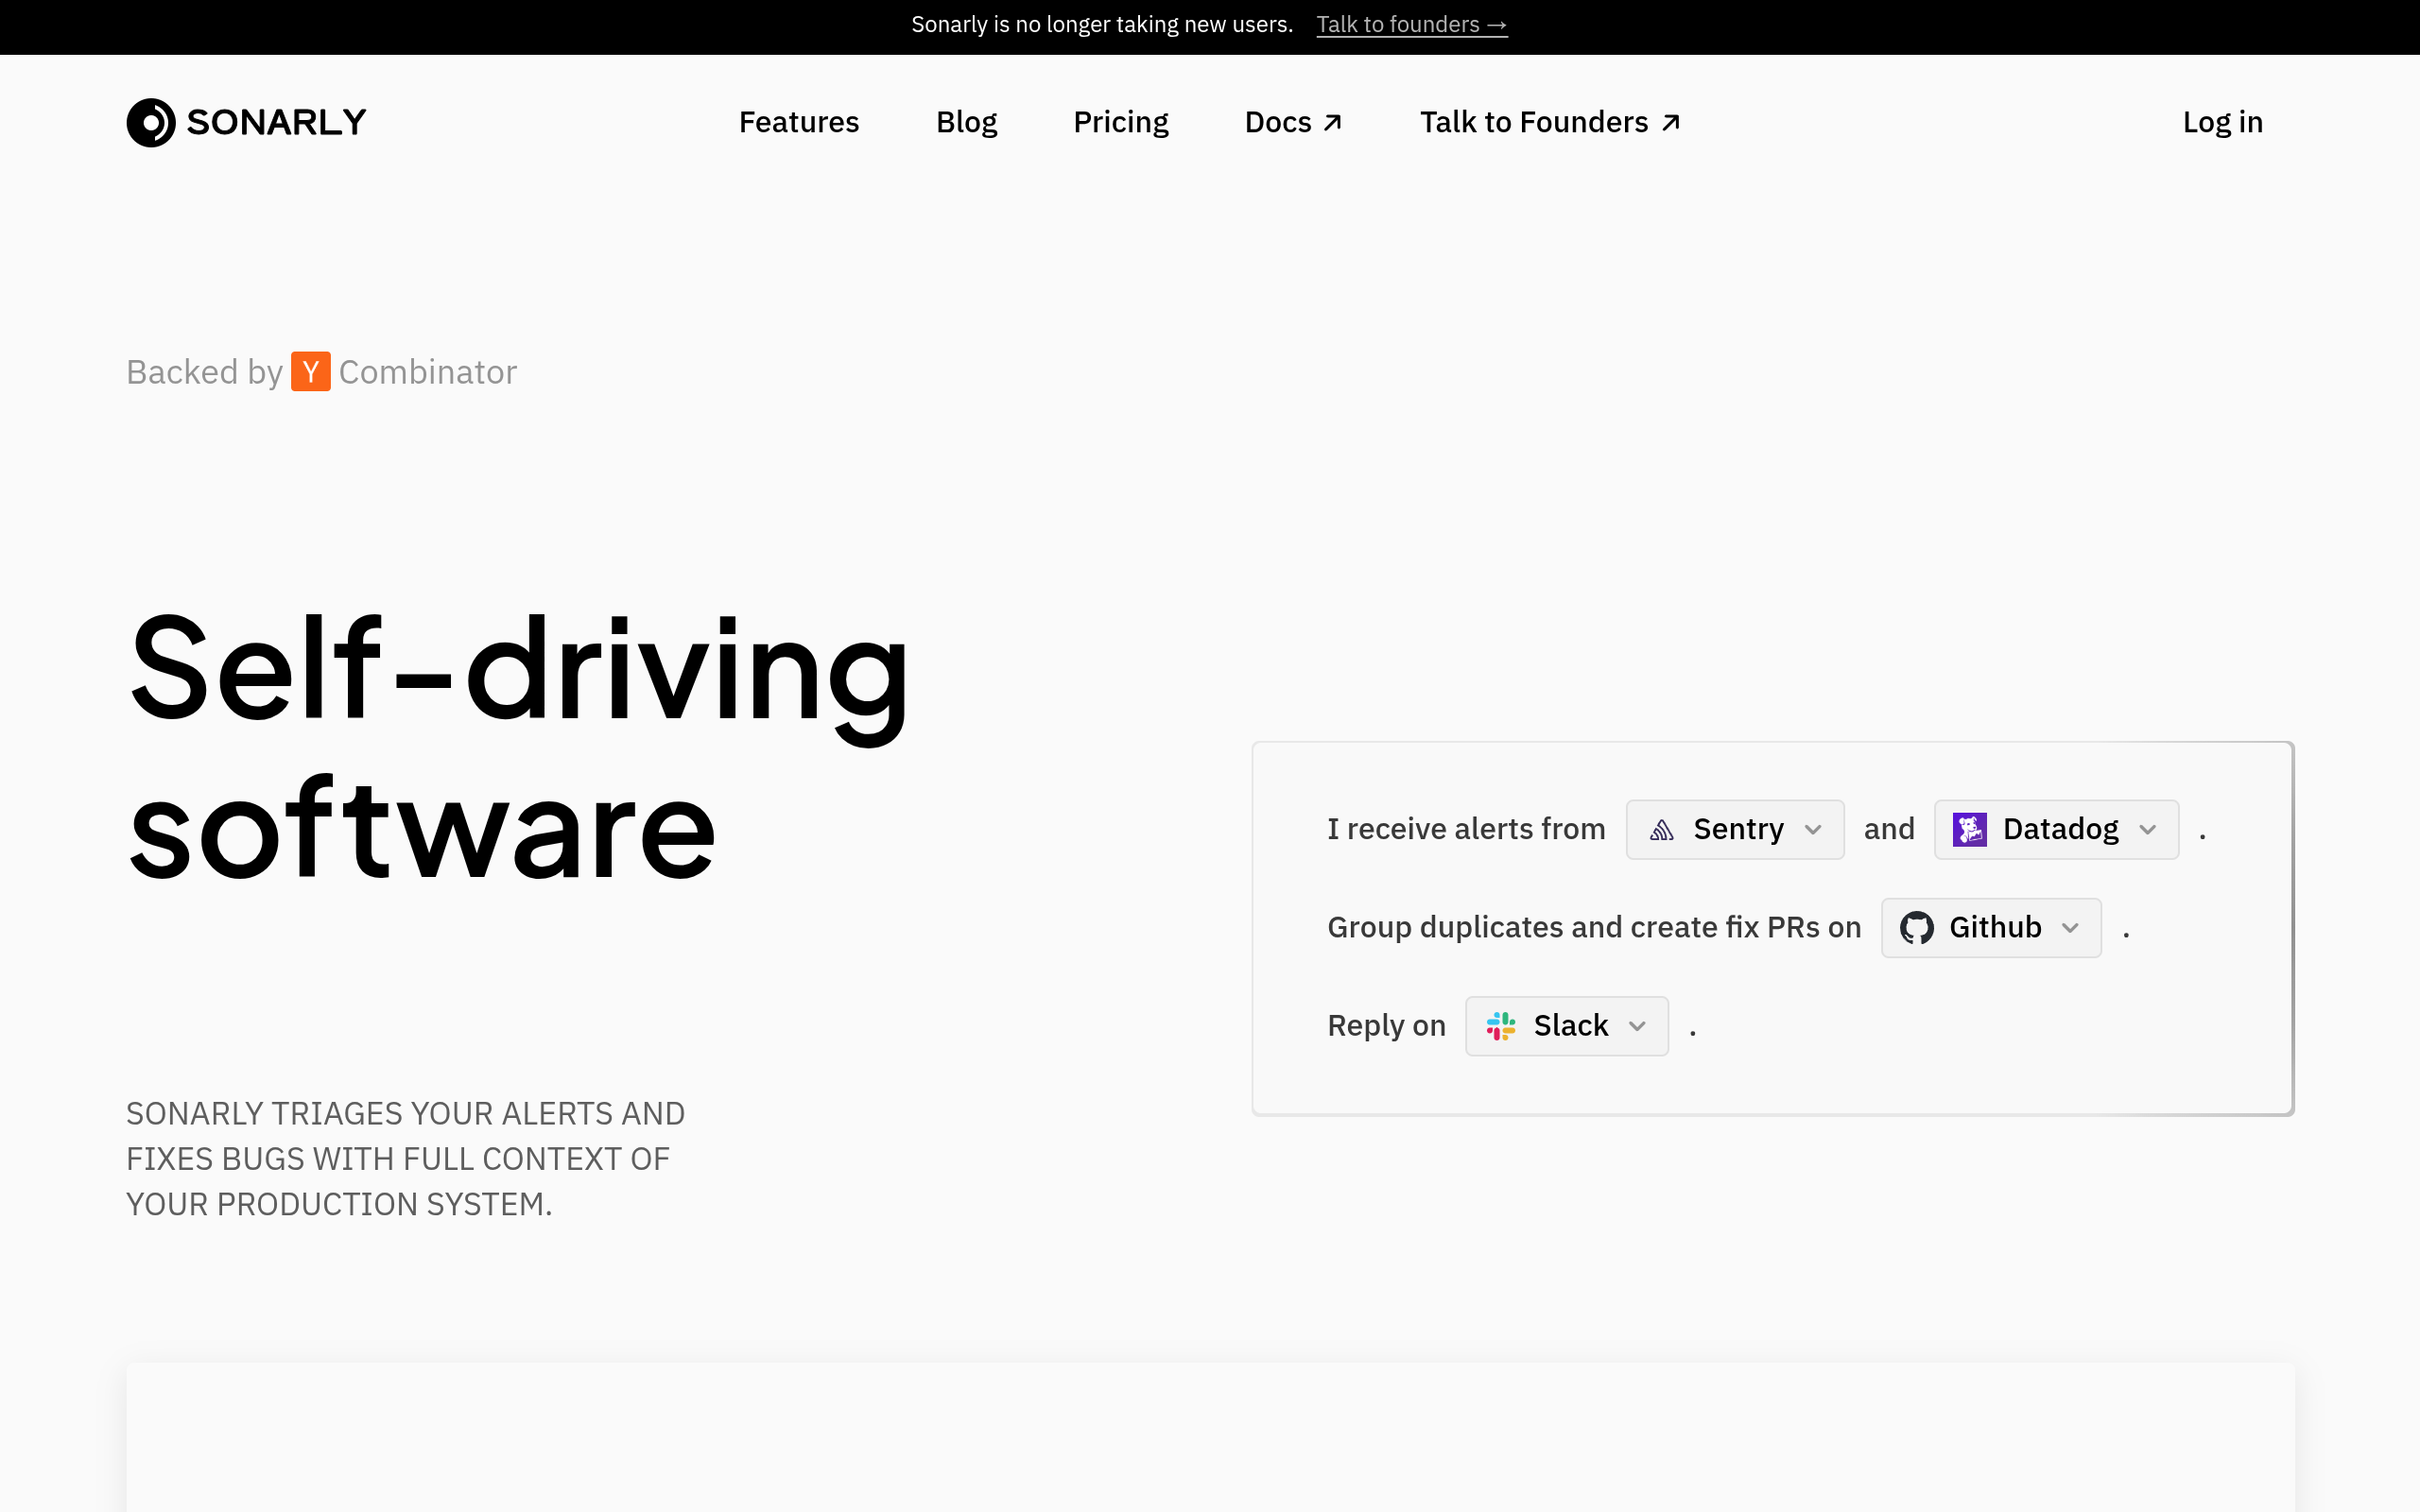
Sonarly是一款基于人工智能技术的运维效率提升平台,核心定位为自动化处理生产系统告警与故障问题的智能工具。平台可自动识别告警优先级并进行分类处理,能够结合生产系统全上下文信息定位并修复代码层面的BUG,还可实现常见运维事故的自动响应与闭环解决。目标用户覆盖互联网企业运维团队、后端开发人员、SRE工程师、技术保障部门负责人等,适用于日常生产环境告警批量处理、线上故障快速定位修复、系统迭代上线后异常排查、高并发时段运维压力分流等多个场景,帮助团队降低人工运维成本,缩短故障响应与处理时长。
saneops.in
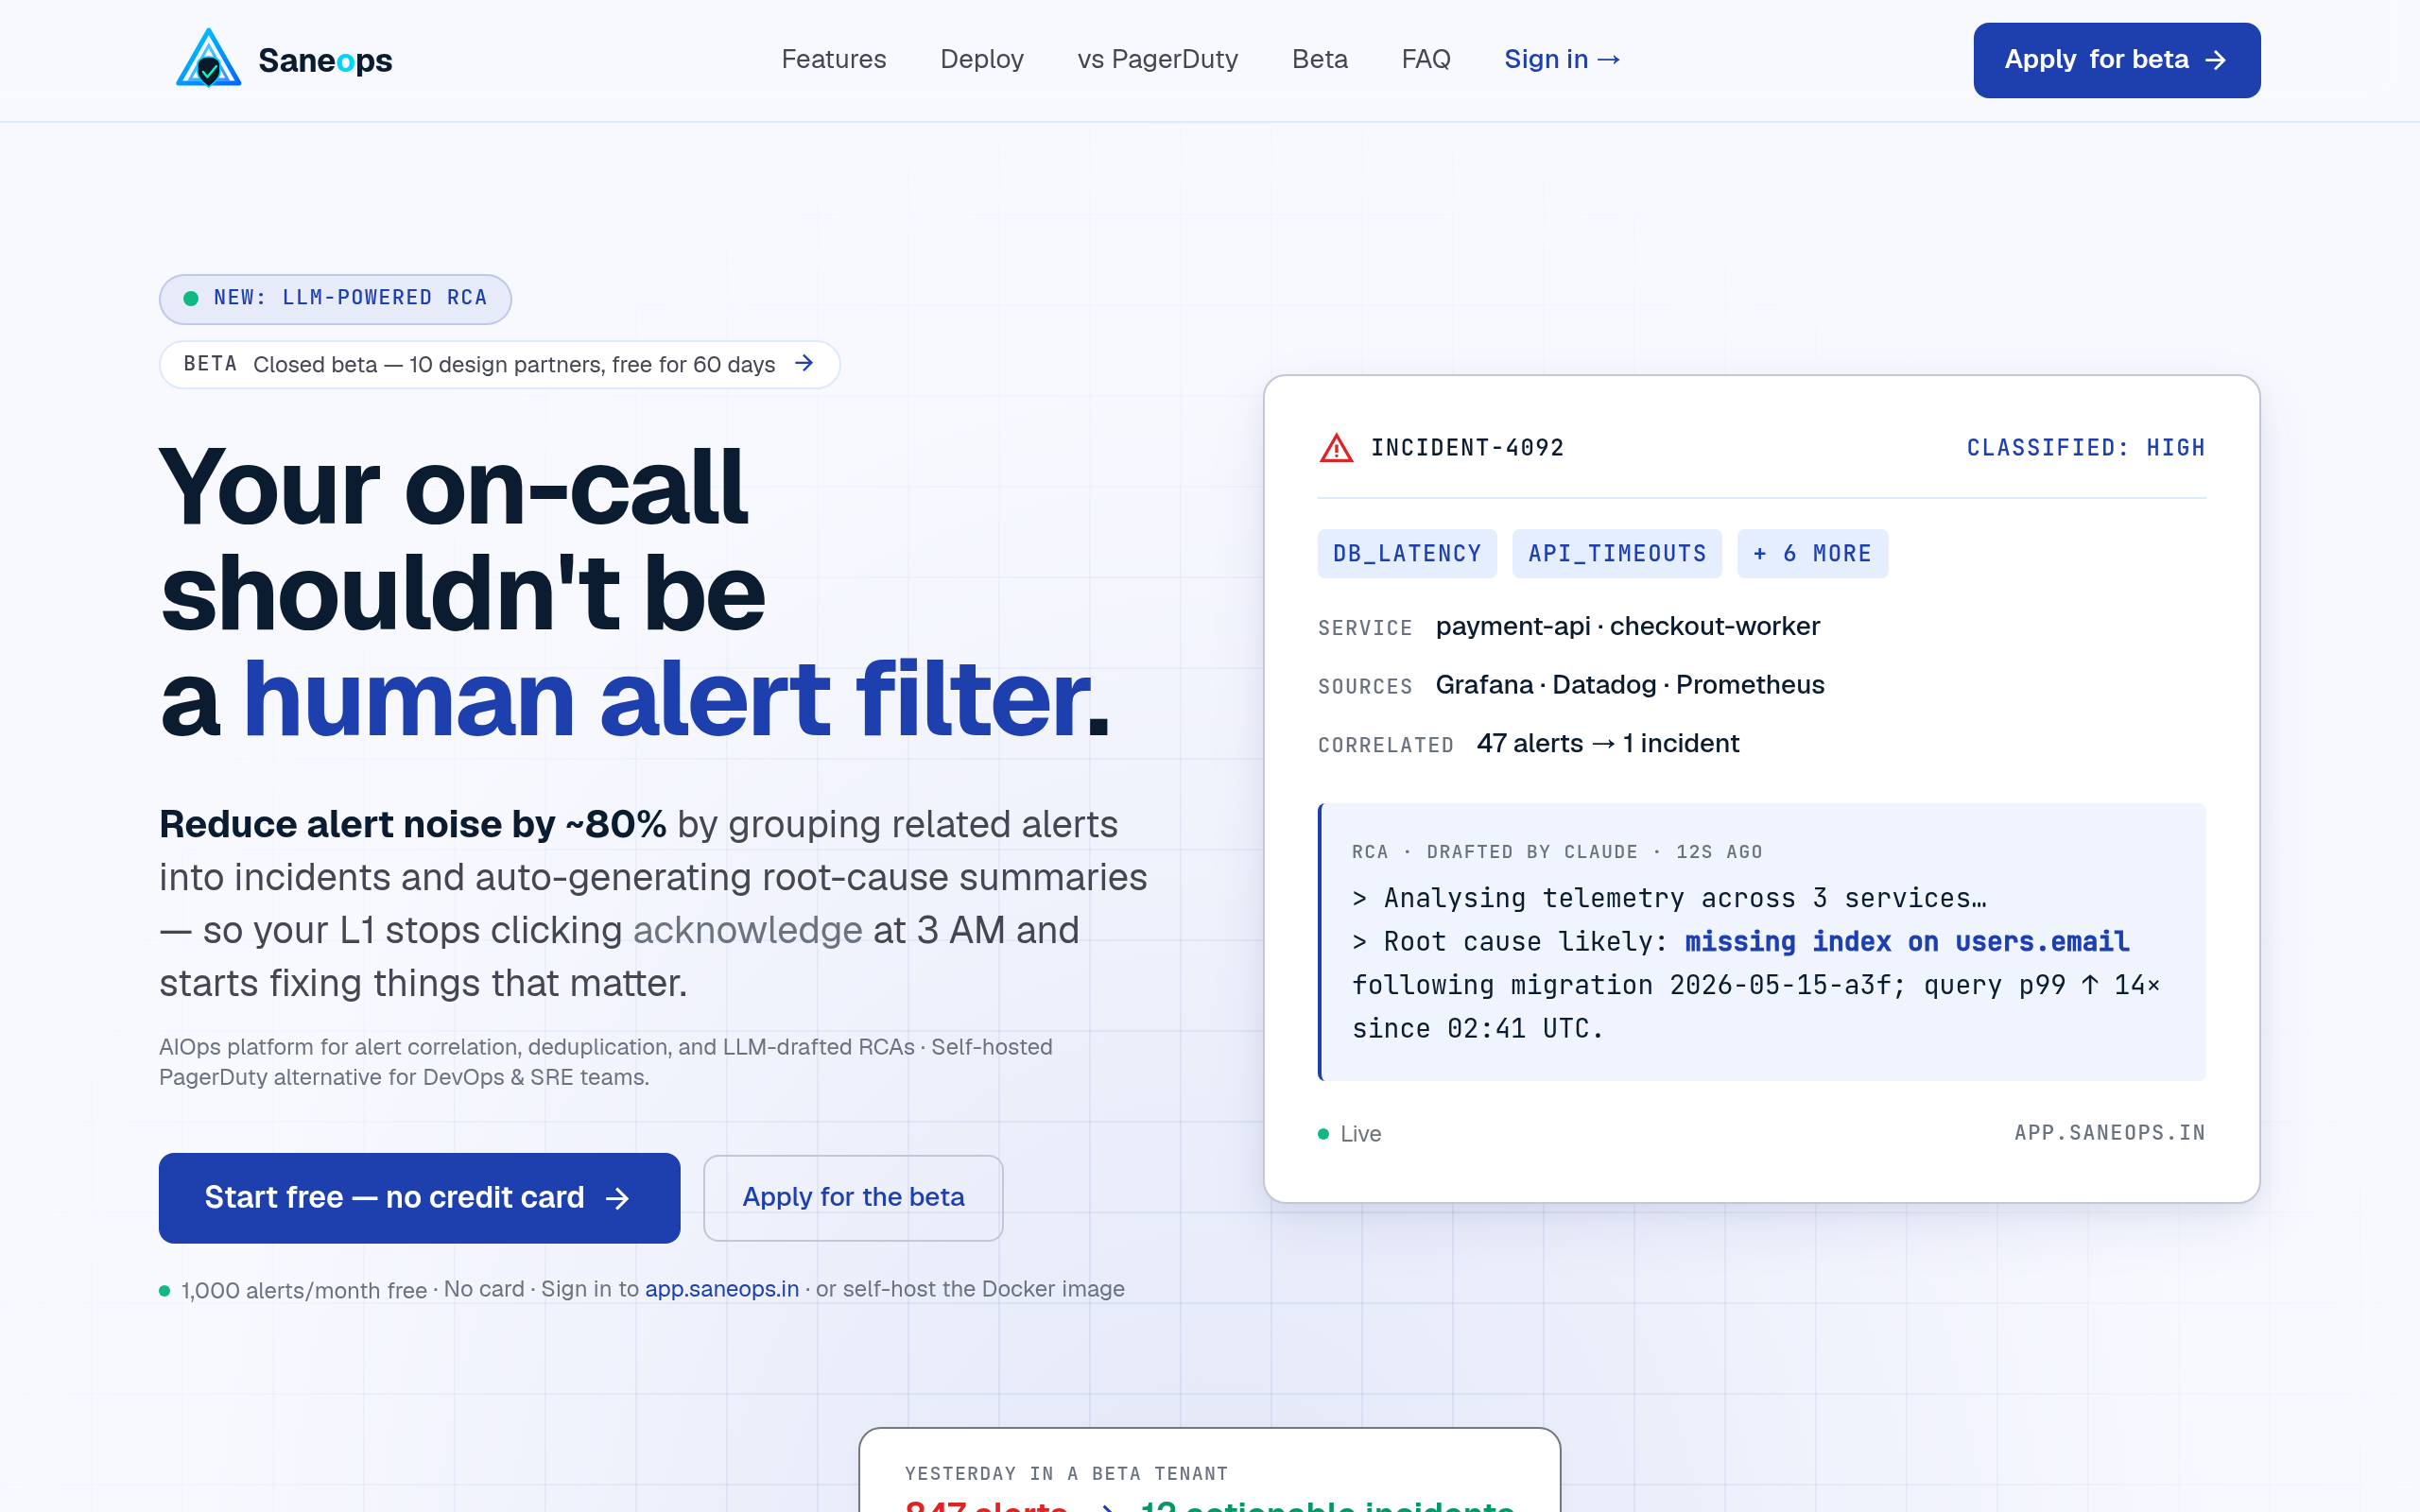
Saneops 是一款支持自托管的一体化 AIOps 运维管理平台,核心作用是帮助运维团队整合多来源告警信息、降低无效告警干扰、提升故障排查效率。平台支持对接Grafana、Datadog、PagerDuty等主流运维工具,可自动完成告警关联与去重,还能借助大语言模型生成故障根因分析初稿,能够将需要人工处理的告警量级降低约80%。主要面向企业运维团队、SRE工程师、DevOps从业者,适用于日常系统告警管理、线上故障快速响应、运维流程优化等场景。

smallhours.dev
Small Hours是面向开发者群体的AI运维辅助工具,核心定位是为技术团队提供自动化系统故障根因分析能力,降低系统故障恢复时长。其核心功能包括24小时不间断的系统异常监控跟踪、多语言多框架的代码上下文适配、与现有运维工具链的无缝对接。目标用户覆盖后端开发、运维工程师、SRE团队、技术负责人等技术从业者,可应用于线上服务故障排查、日常系统巡检、新版本上线风险评估、历史故障复盘等多个技术场景,帮助技术团队优化运维流程,减少人工排查故障的时间消耗。
k8sgpt.ai
K8sGPT是一款面向Kubernetes集群的智能运维分析工具,核心定位是结合SRE领域经验与大语言模型能力,帮助用户定位、诊断集群运行过程中出现的各类问题。核心功能包括集群异常自动扫描、根因智能分析、安全漏洞联动检测,同时支持自定义分析规则适配不同集群架构。目标用户覆盖Kubernetes运维工程师、云原生开发人员、DevOps团队、安全运维人员等,可应用于日常集群巡检、故障应急排查、上线前配置校验、安全漏洞批量排查等多个场景,帮助降低集群运维的技术门槛,提升问题处理效率。