AI训练数据
clickworker.com
clickworker.com是基于众包模式的全球化数据服务平台,核心定位是为企业及机构提供AI训练相关的定制化数据解决方案。平台汇聚全球超600万名注册创作者与数据处理人员,可支持多语言、多场景的数据标注、分类、采集服务,同时提供SEO内容创作、市场调研、数据核验等多元化数据类服务。目标用户覆盖AI研发企业、互联网公司、市场营销团队、学术研究机构等,适用于AI模型训练前期的数据准备阶段、企业内容营销的文本产出环节、新产品上市前的消费者需求调研场景、数据库信息的批量核验与整理场景等。
labelyourdata.com
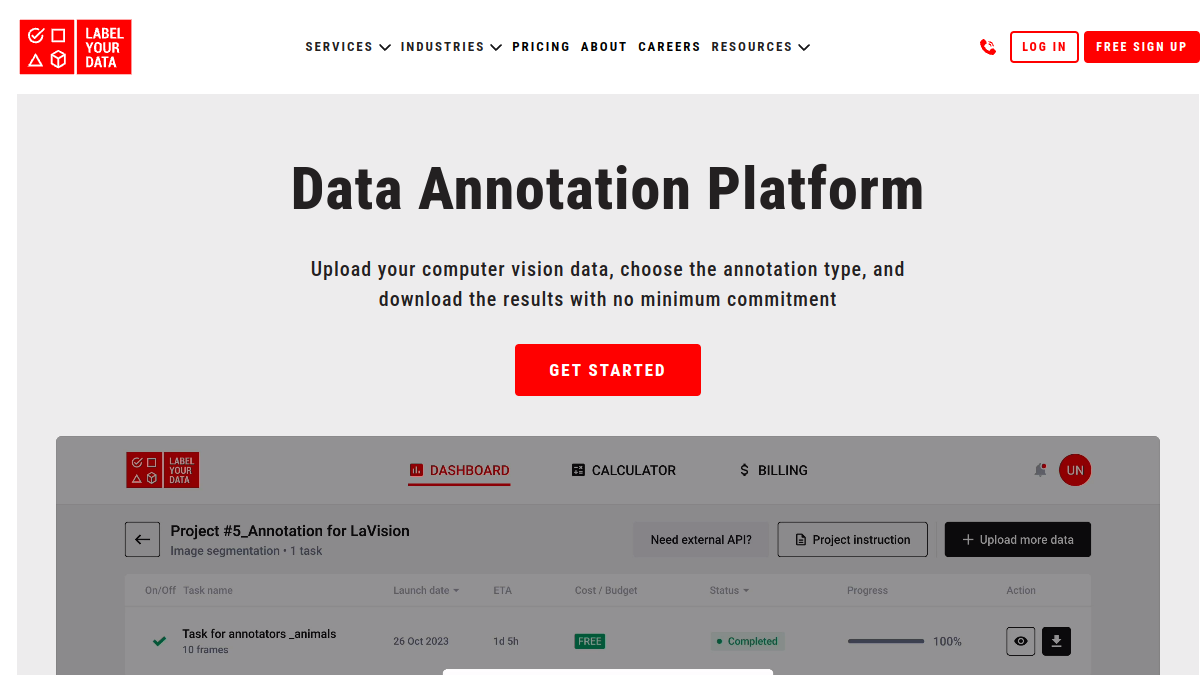
Data Annotation Platform是Label Your Data推出的端到端数据标注解决方案,核心定位是为AI研发相关团队提供标准化、可自定义的数据标注服务。平台支持计算机视觉多类型标注任务,内置成本计算器与标注指令生成工具,可实现标注流程全链路管理。服务对象覆盖AI项目经理、机器学习工程师、AI初创团队、高校科研人员、数据集运营人员、AI算法测试人员等群体,可应用于自动驾驶模型训练数据标注、安防监控图像标注、医疗影像识别数据集构建、零售商品识别数据预处理等多个场景,无需最低合作门槛即可按需使用。

opentrain.ai
OpenTrain AI是面向人工智能领域的第三方服务平台,主打连接人工智能企业与全球认证的AI数据专家,提供托管标注服务匹配与交易撮合功能,支持不同需求规模的AI项目数据处理需求。平台核心业务涵盖数据标注服务供需对接、标注专家资质认证、项目托管交付,以及项目进度全流程管控。目标用户包括需要定制化数据处理服务的AI算法团队、创业公司,拥有标注技能希望承接项目的独立数据专家,以及需要批量数据处理的AI研究机构。可应用于计算机视觉模型训练数据集构建、自然语言处理语料标注、多模态AI数据整理等多种开发场景。

innovatiana.com
Innovatiana是专注于人工智能领域的数据标注外包服务提供商,核心定位是为AI开发团队提供可溯源、高质量的标注数据解决方案。平台拥有自主招聘培训的专属标注团队,拒绝众包模式,可提供多语种项目对接管理、定制化标注方案设计、全流程数据安全防护三类核心服务。目标用户覆盖AI算法研发企业、自动驾驶技术团队、计算机视觉项目开发组、自然语言处理研究机构等群体,可满足自动驾驶场景数据标注、智能语音语料标注、图像识别数据集制作、多语言文本分类标注等多场景的标注需求,帮助需求方降低标注团队搭建成本,保障标注数据质量稳定性。

datavlab.ai
DataVLab是专注于为多个行业提供人工智能数据标注服务的平台,核心业务覆盖文本、图像、视频多模态数据标注,支持定制化标注需求开发,对接算法训练全流程。平台提供标注工具部署、标注团队管理、数据质量校验等服务,可满足不同规模的人工智能模型训练数据需求。目标用户包括人工智能算法团队、自动驾驶研发企业、计算机视觉创业项目、自然语言处理研究机构等,适用于模型训练数据准备、已有数据集清洗校正、定制化数据采集标注等场景。

incribo.com
AuroraAI是Incribo旗下的多模态AI训练数据生成平台,核心定位是为各类AI模型研发团队提供合规、高质量的训练数据支撑。平台支持语音、图像、3D模型等多类型数据生成,支持用户自定义数据生成维度与参数,同时保障用户对生成数据的完整所有权。目标用户覆盖AI研发团队、内容创作机构、学术研究人员等群体,可满足语音合成模型训练、图像识别算法优化、3D人物建模数据集搭建、景观设计样本扩充等多场景的数据需求,帮助研发团队降低数据采集与标注成本,提升模型训练效率。
basic.ai
BasicAI Cloud是一个AI驱动的训练数据标注与管理平台,面向人工智能研发团队提供数据处理支撑服务。平台提供多种类型数据标注工具,支持团队协同作业与项目全流程管理,可帮助用户完成训练数据的标注、审核、存储与导出全链路工作。核心功能包含多模态数据标注、团队权限管理、数据版本管理、标注质量审核以及项目进度追踪,适合计算机视觉、自然语言处理等领域的AI研发团队、高校科研团队在模型训练前期的数据准备阶段使用,也支持个人研究者处理中小型数据标注项目。
labelstud.io
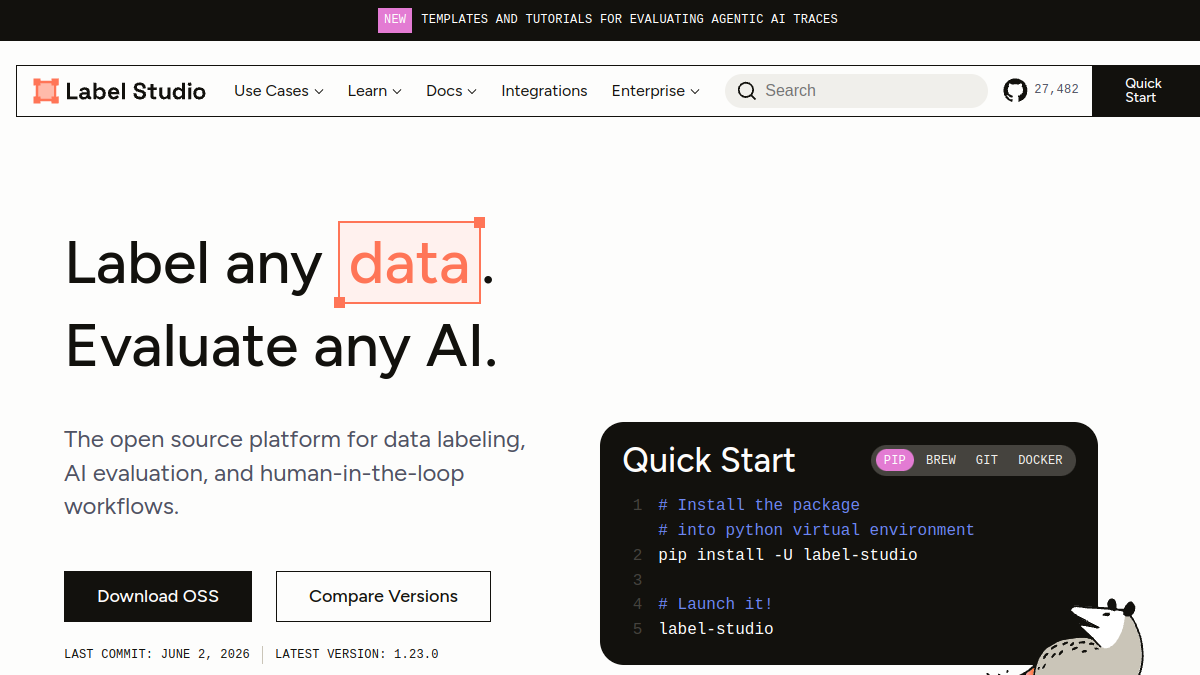
Label Studio是一款灵活的开源数据标注平台,核心定位是为AI模型训练提供多类型数据标注解决方案,覆盖计算机视觉、自然语言处理、语音、视频等多个AI技术领域。平台支持图像分类、对象检测、语义分割、文本命名实体识别、音频说话人分割等数十种标注类型,适配不同场景的数据标注需求。同时支持本地部署、云端部署两种部署方式,满足个人开发者、小型AI团队、企业级研发部门的不同使用要求,可用于AI项目训练数据准备、标注任务团队协作、标注结果质量校验等多个场景,帮助用户完成标准化的训练数据集构建工作。

annotate.my.canva.site
Annotate是面向生成式AI研发场景的小批量高质量数据标注服务平台,核心围绕数据标注准确率提升、标注流程效率优化、AI偏见风险降低三大方向展开服务,具备视频标注、代码数据标注、多语言任务标注等核心能力。平台服务目标用户覆盖AI算法研发团队、企业AI项目负责人、计算机视觉研发人员、自然语言处理工程师等群体,可应用于监控视频AI训练数据制作、建筑施工场景智能分析数据集搭建、体育赛事AI分析数据标注、多语言大模型训练语料处理、代码生成类AI模型训练数据准备等多个场景,帮助企业解决AI模型训练阶段的数据质量不达标的问题。
peopleforai.com
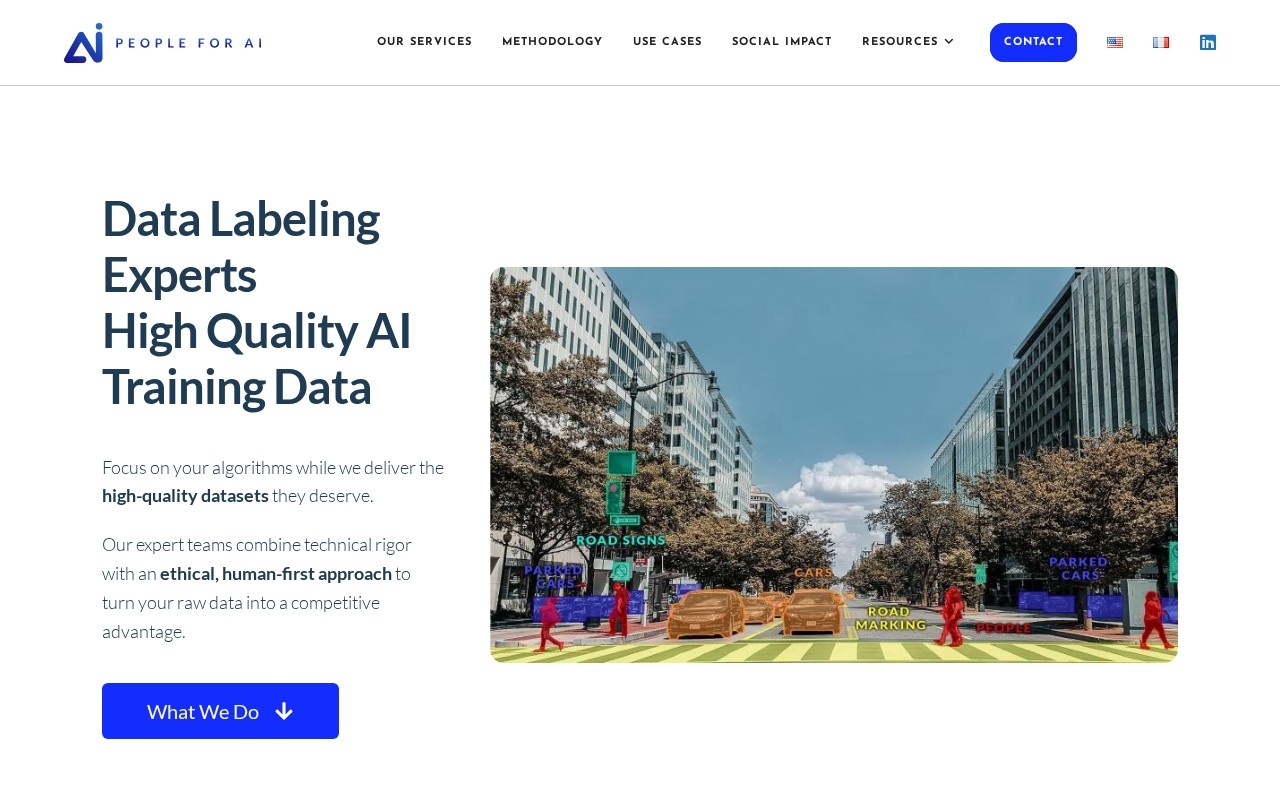
People for AI是专注于AI训练数据服务的平台,核心为全球AI研发团队提供全流程数据处理解决方案。平台核心功能包含多类型数据标注服务、算法辅助调优、数据清洗治理、自定义标注规则配置、标注质量全流程管控。目标用户覆盖AI算法研发团队、自动驾驶企业、NLP技术开发团队、计算机视觉项目团队、智慧医疗研发机构等。可应用于自动驾驶感知模型训练、智能客服语义识别模型训练、医学影像辅助诊断模型训练、安防监控图像识别模型开发等多种AI项目落地场景,助力提升AI模型训练的精度与效率。

syntheticaidata.com
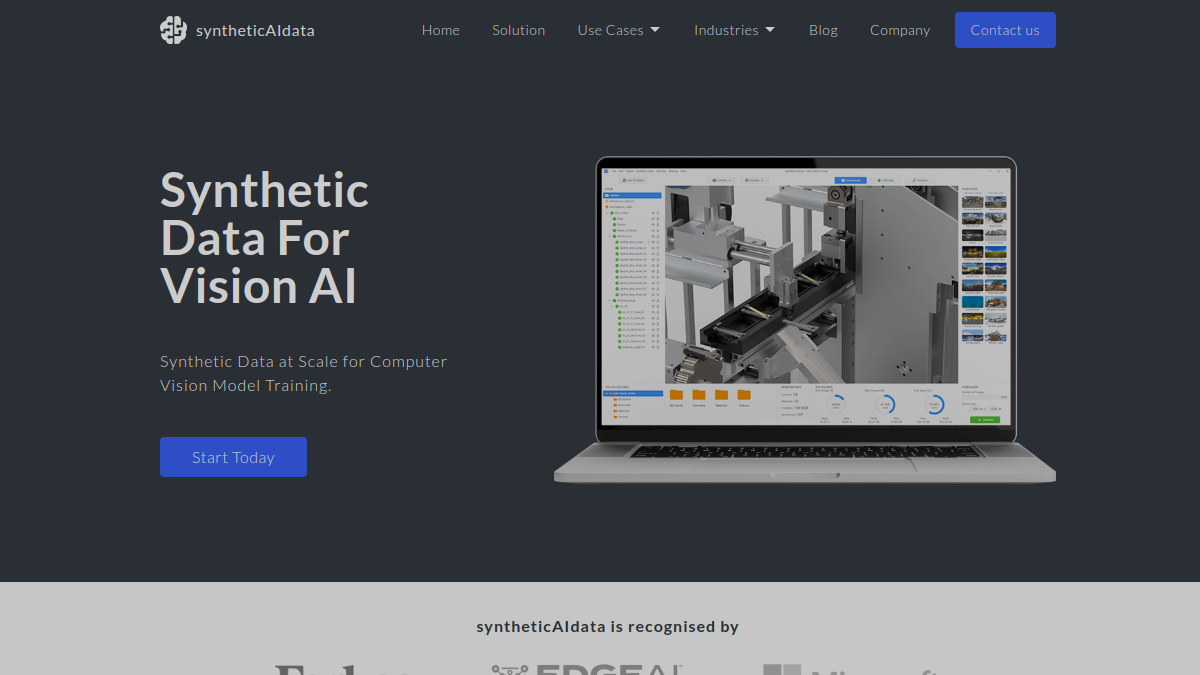
SyntheticAIdata是专注于合成AI训练数据生成的服务平台,核心定位是为视觉AI开发场景提供低成本、高标注精度的大规模数据集解决方案。平台支持3D资产导入生成多样化合成图像、多类型标注自动生成、自定义数据分布调整三大核心功能,面向计算机视觉算法工程师、AI创业团队研发人员、高校人工智能领域研究者,可应用于图像分类模型训练、目标检测算法迭代、图像分割模型优化等多种场景,帮助用户降低真实数据采集标注的成本,缩短AI模型开发周期。
grably.us
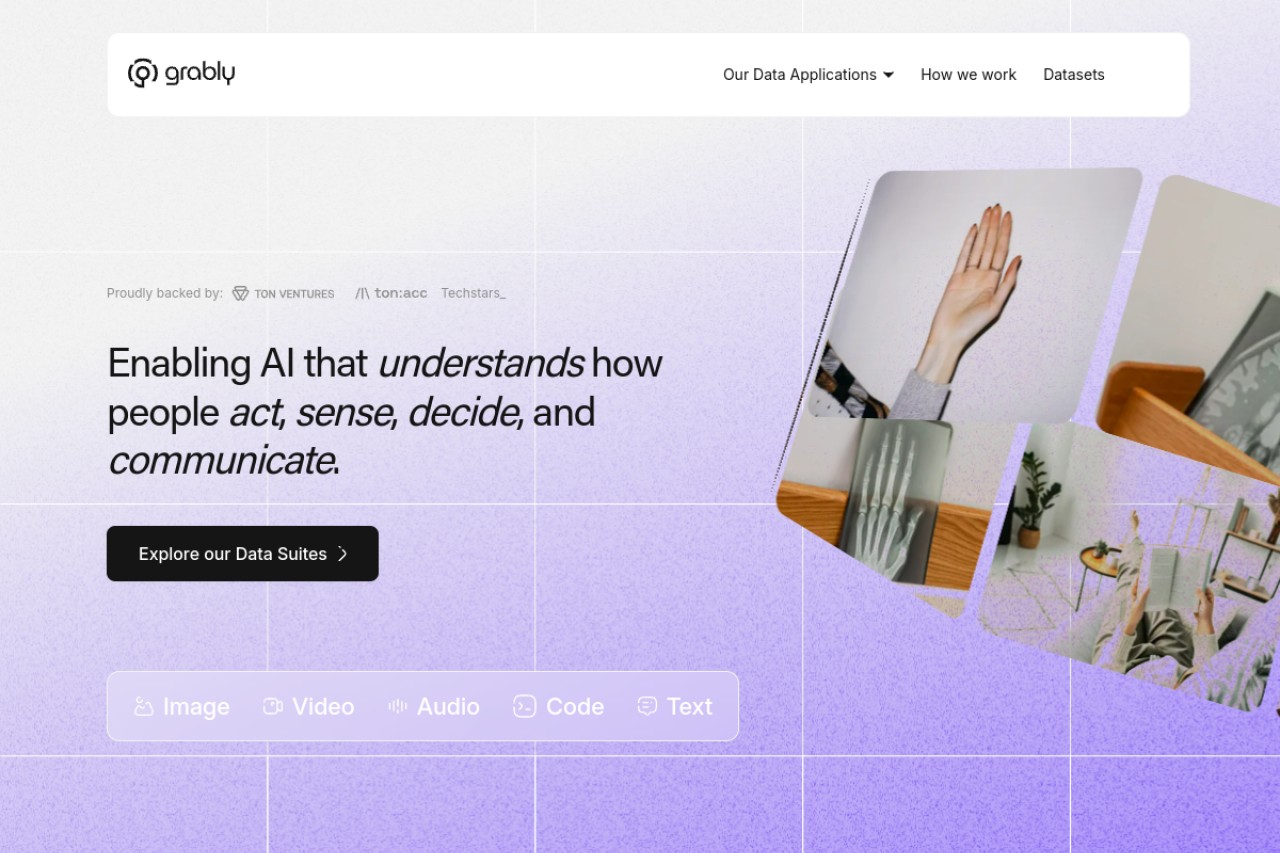
Grably是一个连接数据提供者与人工智能企业的数据交易平台,核心定位为帮助个人和机构出售自有数据,同时为AI研发企业提供多样化的训练数据集。平台支持多种类型数据的上架定价,提供交易撮合与版权保护服务,目标用户涵盖拥有数据资源的个人创作者、中小机构,以及需要训练数据的AI开发团队。使用场景包括个人出售公开的行为数据、机构开放自有行业数据集变现、AI企业采购定制化训练数据、研究者获取实验数据支撑项目开发等。
firecrawl.link
Firecrawl是一款面向大语言模型开发场景的网页数据爬取转换工具,核心定位是将任意公开网站内容转换为适配LLM使用的标准化结构化数据。它支持单页抓取和整站深度爬取,可自动清理网页无效内容、提取核心信息并输出多种适配格式,帮助开发人员快速获取训练数据、构建基于网页内容的大语言模型应用。目标用户包括大语言模型应用开发者、AI训练数据整理人员、内容调研人员、RAG系统开发人员等,适合用于构建AI知识库、训练自定义大模型、整理行业公开资料、开发网页内容问答系统等场景。

scale.com
Scale 是专注于AI训练数据服务的平台,核心定位是为各领域AI开发团队提供标注精准、场景覆盖全面的训练数据支持。平台支持多模态数据标注、自定义数据集生成、标注质量全流程管控三大核心功能,目标用户覆盖自动驾驶研发团队、AR/VR内容开发团队、机器人技术开发企业、通用大模型训练团队等AI相关从业者,可应用于自动驾驶感知模型训练、AR/VR空间交互模型优化、机器人动作识别算法迭代、多模态大模型微调等多个AI开发场景,帮助团队降低数据处理成本,提升AI模型训练效率。

foreverps.github.io
LiveFood是面向计算机视觉、食品计算领域研究人员推出的美食视频数据集服务平台,核心定位是提供标准化标注的美食类视频数据资源与配套算法参考方案。平台目前收录超5100条覆盖食材、烹饪、呈现、食用四大类别的美食视频,所有内容均经过专业人员标注与双重校验,同时提供自研全局原型编码(GPE)模型作为增量学习场景的算法参考。目标用户包括高校计算机相关专业师生、AI企业食品场景算法开发人员、食品科学领域研究人员,可满足美食动作识别模型训练、食品计算领域算法迭代、增量学习任务基准测试等多场景使用需求。
PIXTA AI是面向全球AI开发领域的AI/ML训练数据服务平台,核心为人工智能模型训练提供高质量的标注与采集解决方案。平台支持图像、视频、文本、音频多类型数据标注服务,可根据不同项目需求提供定制化数据采集方案,拥有成熟的项目管理流程与标注人员储备,目标用户涵盖AI算法研发团队、自动驾驶企业、智慧安防厂商、内容审核平台等领域从业者,适用于计算机视觉模型训练、自然语言处理模型优化、多模态模型数据集搭建、自动驾驶场景数据扩充等多个AI开发核心场景,可帮助用户降低数据处理环节的时间与人力投入,加快AI模型迭代效率。
genesis-embodied-ai.github.io
Genesis AI是面向机器人学、具身AI与物理AI领域的物理仿真平台,核心定位是为相关研发场景提供高拟真度的物理模拟与数据生成支持。平台搭载自研通用物理引擎,可实现多类型材料与物理现象的模拟,同时内置真实感渲染系统与生成数据引擎,支持自然语言转多模态数据的需求。平台适配Python开发习惯,目标用户覆盖机器人研发工程师、具身AI研究者、高校相关专业师生、仿真技术开发人员等,可应用于机器人运动测试、具身智能模型训练、物理场景仿真实验、AI训练数据集生成等场景,帮助用户降低物理实验成本,提升研发测试效率。

bespokelabs.ai
Bespoke Labs是聚焦人工智能领域定制化数据集服务的平台,由前Google DeepMind员工与德克萨斯大学奥斯汀分校研究人员联合创立,核心定位是为AI模型训练提供高质量数据支撑方案。平台推出Minicheck、Evalchemy、Curator三类工具,分别覆盖数据校验、数据集评估、数据全生命周期管理场景,可帮助AI研发团队降低数据准备阶段的成本,提升模型微调的准确性。目标用户包括AI算法工程师、大模型研发团队、高校AI研究人员、垂直领域AI应用开发者,适用于大语言模型微调、垂直领域模型训练、AI研究实验数据集构建、商业AI产品落地前的数据准备等场景。


objaverse.allenai.org
Objaverse是艾伦人工智能研究院推出的大规模标注3D物体数据集平台,核心为全球研究者、开发者提供标准化、多维度标注的3D资源。平台收录超80万个标注3D物体,每个对象配备名称、描述、标签、来源等元数据,覆盖静态模型、动画角色、可分解组件、室内外场景等多种类型,适配不同研究与开发需求。目标用户包括3D生成算法研究者、计算机视觉开发者、AI训练从业者、游戏内容创作者、元宇宙场景搭建人员、机器人研发工程师等,可用于3D生成模型训练、2D实例分割数据增强、开放词汇具身AI研发、多模态模型鲁棒性测试、3D内容原型制作等多个场景,降低3D相关研发的资源采集与标注成本。

luel.ai
Luel是Luel AI推出的双边市场平台,核心定位是搭建AI训练音视频数据集供需对接桥梁,服务于AI研发团队与数据贡献者两端用户。平台核心功能包含音视频训练数据按需定制服务,支持AI团队发布明确的数据标注、采集需求,同时支持贡献者根据自身能力承接对应任务,还内置数据集质量校验工具,可对采集到的音视频内容进行合规性、标注准确率自动核验,保障数据集符合训练标准。目标用户覆盖AI算法研发团队、语音识别模型开发人员、音视频内容创作者、数据标注从业者等,使用场景包括语音助手模型训练数据集筹备、多模态大模型语音模块数据补充、小语种语音识别数据集搭建、声纹识别模型训练数据采集等,可有效降低AI团队数据获取成本,提升数据贡献者收益转化效率。

appen.com
Appen是专注于人工智能训练数据服务的企业平台,核心定位是为AI研发团队提供全链路数据解决方案,助力AI模型性能提升。平台核心功能包括多模态数据标注服务、全球范围定制化数据采集、多语言本地化数据处理三类。目标用户覆盖人工智能研发企业、自动驾驶技术团队、智能语音开发厂商、大语言模型训练团队等。使用场景包含自动驾驶场景下的图像、点云数据标注,智能语音助手的语料采集与转写标注,大语言模型的预训练数据清洗、对齐标注,跨境AI产品的多语言文本数据处理等环节。

blog.salesforceairesearch.com
MINT-1T是Salesforce AI研究院推出的开源多模态数据集项目官网,核心定位是为多模态大模型训练提供大规模、高质量的多源图文训练数据。网站公开了数据集的规模参数、构建流程、过滤标准与合规说明,支持开发者下载使用规范、获取数据访问权限,还提供了基于该数据集训练的模型测试结果参考。目标用户包括AI领域的科研人员、大模型研发工程师、多模态算法研究者、高校计算机相关专业师生以及AI创业团队的技术人员,可应用于多模态大模型预训练、图文跨模态检索算法优化、多模态理解能力 benchmark 构建、低资源多模态任务迁移学习等场景。

superannotate.com
SuperAnnotate是面向AI开发场景的端到端数据标注、版本控制与管理平台,核心定位是为AI研发团队提供高质量训练数据生产全链路支持。平台支持图像、视频、文本多模态数据标注,内置标注质量校验、项目流程管理、AI辅助标注自动化功能,可帮助团队缩短AI模型训练数据准备周期。目标用户覆盖AI算法研发团队、数据标注服务商、自动驾驶研发企业、医疗影像AI开发团队、NLP产品研发团队等,适用于计算机视觉模型训练数据标注、大语言模型微调数据集构建、AI项目全流程数据资产管控等场景。
gair-nlp.github.io
MathPile是面向数学领域的大规模公开语料库项目,核心定位为高可信度的高质量数学文本数据集合,总标记量约95亿,内容覆盖K-12到研究生阶段及数学竞赛相关内容。核心功能包括多来源数学内容整合收录、分级内容适配、规范授权支持。其数据来源覆盖教科书、讲座笔记、arXiv、维基百科、ProofWiki、StackExchange及公开数学类网页。目标用户涵盖数学领域研究者、大中小学数学教研人员、AI大模型训练从业者、数学竞赛备赛人员、数学科普内容创作者、数学专业学生。可应用于大模型数学能力训练、数学教研内容参考、数学知识库搭建、数学竞赛资料整理等场景。
useocular.com
Ocular AI是专注于将非结构化数据转换为AI可用结构化数据集的数据工厂平台,面向需要构建AI训练数据的开发团队与企业用户提供一站式数据处理服务。平台支持多类型非结构化数据接入,可自动化完成数据标注、清洗、格式化等流程,帮助用户快速产出符合训练要求的标准化数据集,解决AI模型开发过程中数据预处理成本高、效率低的问题。常见使用场景包括计算机视觉模型训练数据准备、自然语言处理非结构化文本整理、多模态AI数据集构建等。