非结构化数据处理
unfig.com
Unfig是面向多行业的非结构化数据提取处理平台,核心定位是将各类非标准化的文档、图像内容转化为可复用的结构化数据。平台支持自定义数据提取规则,可适配物流单据、办公文档、发票凭证等多种文件类型,提取完成后支持对接企业现有业务系统实现数据同步。目标用户覆盖物流从业者、企业行政人员、财务人员、数据运营人员、小型企业管理者、研发人员等,可应用于物流单据信息录入、企业档案数字化整理、财务发票批量核验、业务数据批量统计等多种场景,帮助用户减少手动录入数据的工作量,降低数据整理的出错概率。
mdlr.app
MDLR是面向AEC行业的AI驱动项目管理平台,核心定位是帮助建筑、工程、施工领域从业者整理项目中的非结构化数据,打通项目各环节信息流转。平台依托AI技术实现非结构化数据的自动识别、分类与结构化处理,支持项目文档自动归档、进度数据自动同步、跨角色信息协作等功能,可解决AEC行业项目中数据分散、整理耗时、信息不对称等问题。目标用户覆盖建筑设计机构、工程施工企业、项目监理团队等,适合大型基建项目、商业建筑项目、住宅开发项目等全周期管理场景使用。

cinnamon.ai
Cinnamon AI是一家聚焦企业业务AI解决方案的服务商,核心专注于文档智能分析与业务流程自动化领域。该平台依托自研深度学习模型,为企业提供非结构化文档数据处理、关键信息提取、自动化工作流搭建等服务,帮助企业降低人工处理成本,提升业务处理效率。核心功能涵盖文档智能理解、企业级RPA流程自动化、数据提取标注平台、文档分类整理、敏感信息识别等,面向存在大量非结构化文档处理需求的企业,可应用于金融、供应链、人力资源、法务等多个领域的文档处理场景,解决人工处理文档效率低、错误率高的问题。

indicodata.ai
Indico Data是基于人工智能技术搭建的非结构化数据处理与决策自动化平台,面向企业用户提供从数据提取到分析落地的全流程数据处理服务。平台可针对文本、图像、文档等多种非结构化数据进行智能解析,提取核心业务信息,自动生成数据见解,帮助企业将分散的非结构化数据转化为可分析的结构化资产,支持企业基于数据做出业务决策。核心功能包含智能文档解析、情感与主题分析、自定义模型训练、数据可视化导出、API集成对接等,适用于金融、法律、制造业、零售等多个行业的日常数据处理场景。
corpus-x.com
Corpus-X是面向企业用户的定制化AI解决方案服务平台,核心提供企业私有AI搜索、VizGPT数据分析可视化等定制化AI服务,同时支持私有数据安全部署、第三方工具对接整合。平台可针对不同行业企业的业务需求,搭建适配企业自有数据体系的AI应用,帮助企业梳理内部数据资产,挖掘数据业务价值。目标用户包括中大型企业数据部门、互联网产品研发团队、传统行业数字化转型部门等,适合企业搭建内部私有AI搜索系统、处理大规模非结构化数据分析、生成可视化分析报告等业务场景。
solaracloud.ai
Solaracloud是面向企业与开发者的AI业务自动化和数据赋能平台,可帮助用户将非结构化业务数据转化为可分析利用的结构化信息,搭建自定义自动化工作流,降低人工处理数据的成本。平台支持多源数据接入、自动化处理、结果可视化输出等核心能力,适合有数据处理需求、业务流程优化需求的团队与个人使用,可应用在企业内容管理、客户数据分析、供应链信息整理等多种业务场景。

linguamatics.com
Linguamatics是面向医疗保健与生命科学领域,提供人工智能驱动语言处理和文本挖掘解决方案的服务商,核心定位为非结构化医疗文本智能化处理平台。平台支持医疗文献信息抽取、电子病历深度解析、药物研发文献关联、临床研究数据整合、合规审查文本校验五大核心功能,可覆盖从药物早期研发到上市后全流程的文本处理需求,目标用户包括医药企业、医疗机构、生物科技公司、CRO机构、学术科研院所、医疗监管部门等,适合药物靶点筛选、临床研究数据分析、不良反应信号挖掘、医疗合规资料审核、医学科研文献综述等多个场景使用。

dataku.ai
Dataku是专注于非结构化数据提取的AI工具平台,核心定位是帮助用户将分散的文档、文本内容转化为可直接使用的结构化数据。核心功能包含多格式文档智能解析、自定义场景提取模板、批量数据导出对接三大模块,面向人力资源、市场运营、金融风控、客户服务等多个领域的从业者,可应用于简历信息批量整理、用户评论情感与要素提取、金融合同关键条款识别、客户反馈信息分类统计等工作场景,降低人工数据整理的时间成本,提升数据处理的一致性。

nanonets.com
Nanonets是专注于文档处理自动化的AI平台,核心服务是将各类非结构化数据转化为结构化信息,帮助企业降低人工处理成本、提升数据流转效率。平台支持图片、PDF、扫描件等多格式文档的数据提取,可自定义提取字段并适配不同行业的文档模板,还提供API接口与企业现有系统对接。其目标用户覆盖金融、物流、医疗、零售等多个行业的运营、财务、数据处理岗位人员,可应用于发票报销审核、物流单据信息录入、医疗病历数据结构化、供应链订单信息整理等多种业务场景。
weka.io
WEKA是面向多云与本地部署环境的统一数据管理平台,核心定位是为AI训练、生命科学研究、媒体内容制作等下一代工作负载提供全链路数据支撑服务。平台具备分布式并行数据处理能力,可实现PB级数据的低延迟访问与调度;内置AI推理优化引擎,能降低大模型训练过程中的数据IO开销;支持多云存储统一纳管,用户无需切换平台即可管理不同云服务商与本地服务器中的数据资源。目标用户覆盖科技企业研发团队、科研机构数据部门、媒体制作团队、医疗研究机构等群体,可满足AI大模型训练、基因测序数据分析、4K/8K视频渲染、工业仿真数据处理、遥感影像解析等多场景的数据管理需求。

BEWAI IDP是专注于智能文档处理的AI解决方案平台,核心以RAD-LAD快速自适应学习文档分析技术为支撑,面向有大量文档处理需求的企业及机构,提供非结构化文档数据的自动化处理服务。平台支持无预设模板识别多类型行业文档,可完成文档自动分类、数据提取、内容校验全流程处理,适用于金融机构处理贷款申请材料、保险机构处理理赔单据、政务部门处理民生办事档案、企业处理财务票据等场景,帮助用户降低人工处理文档的人力成本,减少人为失误,提升文档处理的整体效率。

vastdata.com
VAST Data Platform 是面向深度学习与人工智能场景打造的数据平台,采用数据密集计算架构,提供完整的软件基础设施,可支撑深度数据分析、深度学习模型训练等工作。平台支持PB级非结构化数据的统一存储与管理,适配视频、音频、文本等多类型数据集的处理需求,同时兼容渲染资产存储、AI训练数据供给等多元场景,主要面向AI算法研发人员、大数据工程师、影视渲染从业者、企业IT架构师等用户,可满足AI模型训练数据集管理、非结构化数据集中存储、大规模数据实时分析、异构算力资源协同等多种业务需求。

mixpeek.com
MixPeek是基于多模态AI技术的智能文件管理与搜索服务平台,核心定位是为开发者和企业提供可嵌入的文件智能处理能力。平台支持百余种格式文件的内容提取、语义索引与自然语言搜索功能,同时提供标准化API接口便于第三方系统集成。目标用户涵盖企业开发者、SaaS平台运营方、内容管理团队、数据分析师等群体,可应用于企业内部知识库搭建、CMS系统搜索能力升级、云存储平台内容检索优化、客户服务知识库快速查询等多个场景,帮助用户突破传统文件管理中仅支持文件名、标签检索的限制,实现基于文件实际内容的精准查找。

fetchfoxai.com
FetchFox 是一款基于人工智能技术的网页数据抓取工具,以Chrome浏览器插件为载体,支持用户通过自然语言指令完成网页数据提取工作。其核心功能包括AI驱动的非结构化文本提取、复杂网页结构自动解析、反爬机制绕过适配,主要面向有网页数据收集需求的职场人士、研究人员、创业者等群体,适用于潜在客户列表搭建、行业研究数据采集、细分市场调研、竞品信息汇总等多种场景,无需用户掌握专业爬虫开发技能,即可完成多类型网页的数据提取任务。
cohere.com
Cohere是面向企业服务的大语言模型开发平台,核心定位是帮助企业依托先进大语言模型技术优化业务流程、挖掘数据价值。平台支持自定义企业专属大语言模型,可对企业内部多来源非结构化数据完成语义解析与信息提取,同时提供低代码部署接口,适配企业现有办公系统与业务工具。目标用户覆盖企业技术开发团队、业务运营部门、数据管理团队等,可应用于内部智能客服搭建、批量文档信息提取、业务流程自动化落地等多个场景,助力企业将分散的文本、语音等数据转化为可落地的决策参考信息,降低AI技术落地的技术门槛。
getmarkup.com
Markup是一款开源的文档标注工具,核心定位为帮助用户将非结构化的文档内容转换为规范化的结构化数据。它支持多种类型文档的自定义标注任务,可根据用户需求设置标注规则,支持团队协作完成标注项目,适配不同领域的数据整理需求。核心功能包含自定义标注 schema 配置、团队协作标注、数据集导出、版本管理、模型辅助标注等,目标用户覆盖人工智能算法团队、数据处理公司、学术研究人员、独立开发者等,适用于大语言模型训练数据整理、计算机视觉数据集标注、学术研究数据预处理、企业非结构化文档归档等多种场景。

autoform.ai
AutoForm是一款依托AI技术的文件处理与表单自动填写服务平台,核心定位是将杂乱无章的各类非结构化文件,转换为规范统一的结构化数据,并自动完成表单内容填充。平台支持多种格式的文件上传识别,可提取关键信息并匹配对应表单字段,帮助用户减少手动整理数据和填写表单的工作量。目标用户涵盖企业行政人员、财务人员、人力资源从业者、自由职业者、跨境电商从业者以及高校行政人员,适用于批量处理报销单据、招聘简历整理、海关申报表单填写等多种办公场景。

extend.app
Extend 是面向现代企业打造的智能数据提取与流程自动化工具,核心定位是帮助企业处理多类型非结构化数据,构建端到端的数字化工作流。核心功能包括多格式非结构化数据智能提取、自定义业务规则与AI能力结合的工作流搭建、内置置信度校验与人机协同审核机制。目标用户覆盖企业数据运营人员、流程自动化搭建者、合规风控团队、财务行政岗等,可应用于财务发票批量识别录入、客户邮件信息自动归类归档、纸质文书数字化解析入库、跨系统数据同步校验等场景,帮助企业降低人工数据处理成本,减少人为操作误差。
imaginary.dev
Imaginary Programming 是一款基于大型语言模型的 TypeScript 开发辅助工具,核心定位是帮助开发者通过自然语言驱动的方式生成代码逻辑,降低重复性功能开发的工作量。该工具支持自动补全 TypeScript 函数实现、自然语言转结构化数据处理、前端交互逻辑快速生成三大核心功能,面向全栈开发者、前端工程师、后端开发人员等群体,可应用于快速搭建 MVP 产品原型、批量处理非结构化文本数据、补全业务逻辑代码片段等多个开发场景,帮助开发者减少手动编码的重复劳动,提升项目开发效率。
textraction.ai
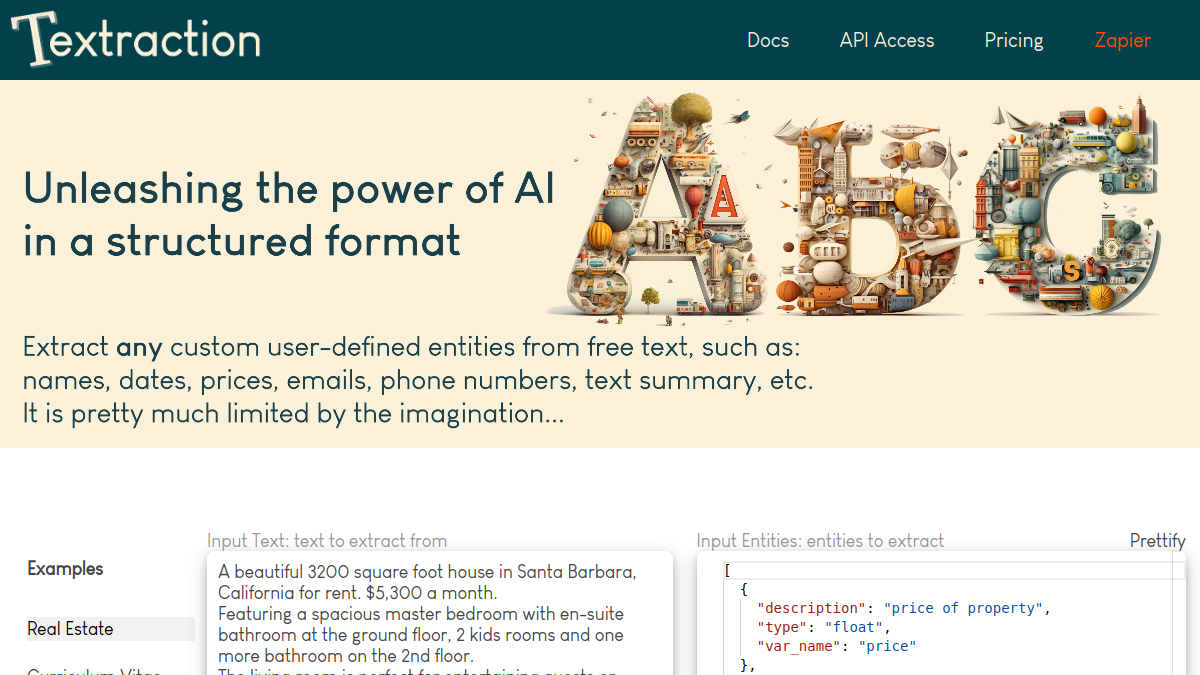
Textraction是一款专注于自然语言文本到结构化表格转换的AI工具,核心定位是帮助用户将非结构化文本内容快速转化为规整的可编辑表格。核心功能包括自定义实体提取、多语言文本识别、多场景结构化输出,支持用户通过自然语言描述需要提取的字段,无需复杂的规则配置即可完成转换。目标用户覆盖职场办公人员、数据处理从业者、行业业务专员等群体,可应用于简历信息整理、客户咨询记录归类、房产信息汇总、金融单据信息提取、产品清单整理、采购订单信息录入等多个场景,降低非结构化文本转结构化数据的操作门槛。

nuclia.com
Nuclia是专注于非结构化数据处理的AI搜索引擎平台,核心定位是帮助用户对多源异构的非结构化数据实现统一检索与智能问答。核心功能包括跨格式非结构化数据自动解析、自然语言语义检索、生成式回答输出以及可嵌入API接口。目标用户覆盖企业数据管理人员、开发者、内容创作者、学术研究人员、媒体从业者等群体,可应用于企业内部知识库搭建、多模态内容素材检索、产品问答系统嵌入、学术文献深度挖掘等多种场景,解决传统关键词搜索无法匹配语义、跨格式数据难以统一检索的问题。

vectorize.io
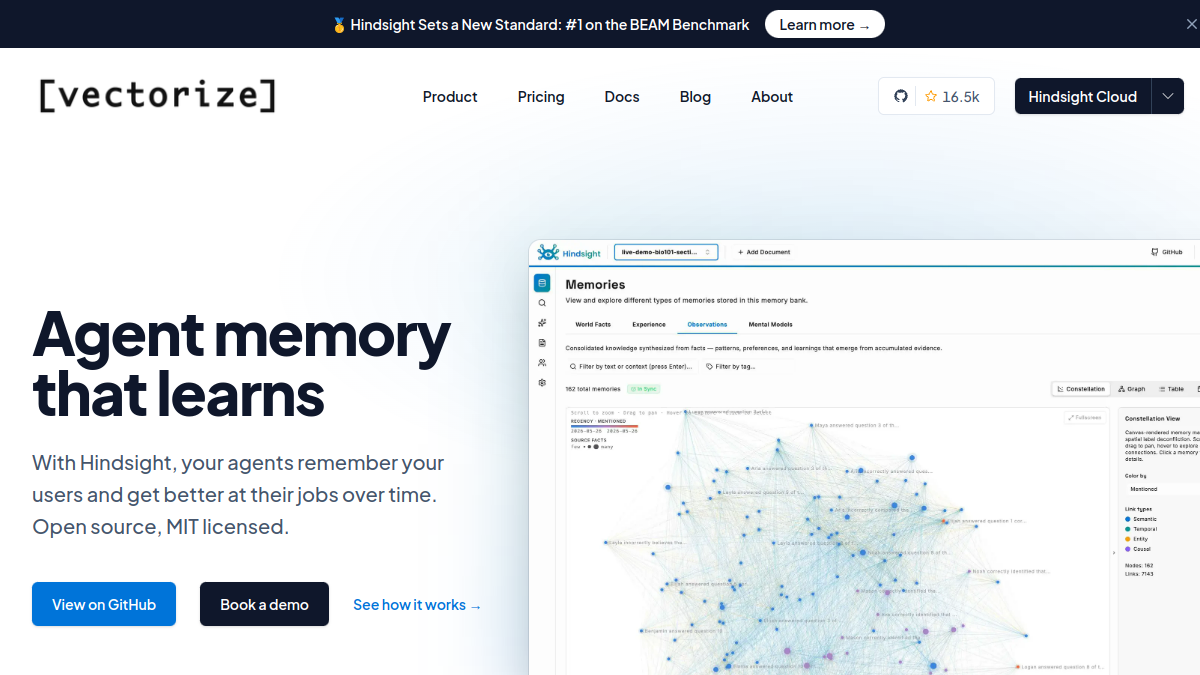
Vectorize是专注于将非结构化数据转化为优化向量搜索索引的平台,专为检索增强生成(RAG)场景设计。核心功能包括多数据源一键接入、向量索引自动优化、RAG pipeline一站式搭建,可对接内容管理系统、文件系统、CRM、协作工具等多种主流数据源,目标用户覆盖企业AI开发团队、数据工程团队、产品研发团队,适用于企业知识库搭建、智能客服语义检索、AI辅助创作素材匹配、内部文档快速查询等场景,帮助用户降低AI应用落地的技术门槛,打造高效的生产力辅助系统与创新客户交互体验。
useocular.com
Ocular AI是专注于将非结构化数据转换为AI可用结构化数据集的数据工厂平台,面向需要构建AI训练数据的开发团队与企业用户提供一站式数据处理服务。平台支持多类型非结构化数据接入,可自动化完成数据标注、清洗、格式化等流程,帮助用户快速产出符合训练要求的标准化数据集,解决AI模型开发过程中数据预处理成本高、效率低的问题。常见使用场景包括计算机视觉模型训练数据准备、自然语言处理非结构化文本整理、多模态AI数据集构建等。