大模型评估
alibaba-nlp.github.io
WebWalker是由阿里巴巴集团通义实验室开发的多智能体框架,核心定位是评估大型语言模型在网页遍历任务中的表现,可模拟人类浏览网页的行为逻辑,通过探索与评估相结合的范式系统提取高质量网页数据,支持深入挖掘多层级网页信息,可帮助研究人员优化大模型信息检索能力,适用场景包括大模型开放域问答能力优化、多步骤信息检索场景模拟、网页数据结构化提取研究等,目标用户覆盖大模型研发人员、自然语言处理研究者、信息检索领域从业者等群体。

humanloop.com
Humanloop是专注于大语言模型生产级应用搭建与全生命周期管理的协作平台,核心定位为降低AI应用从原型落地到生产环境的门槛,提升上线后运行的稳定性与效果。平台支持多模型适配管理、提示词全流程迭代优化、多角色协同开发、运行数据实时监控等核心功能,目标用户覆盖AI应用开发者、产品经理、运营人员、企业技术团队等。适用于企业搭建智能客服系统、开发智能营销内容生成工具、构建企业内部知识库问答机器人、上线AI代码辅助开发工具等多元场景,可帮助团队缩短AI应用开发周期,降低运维阶段的效果波动风险。
respan.ai
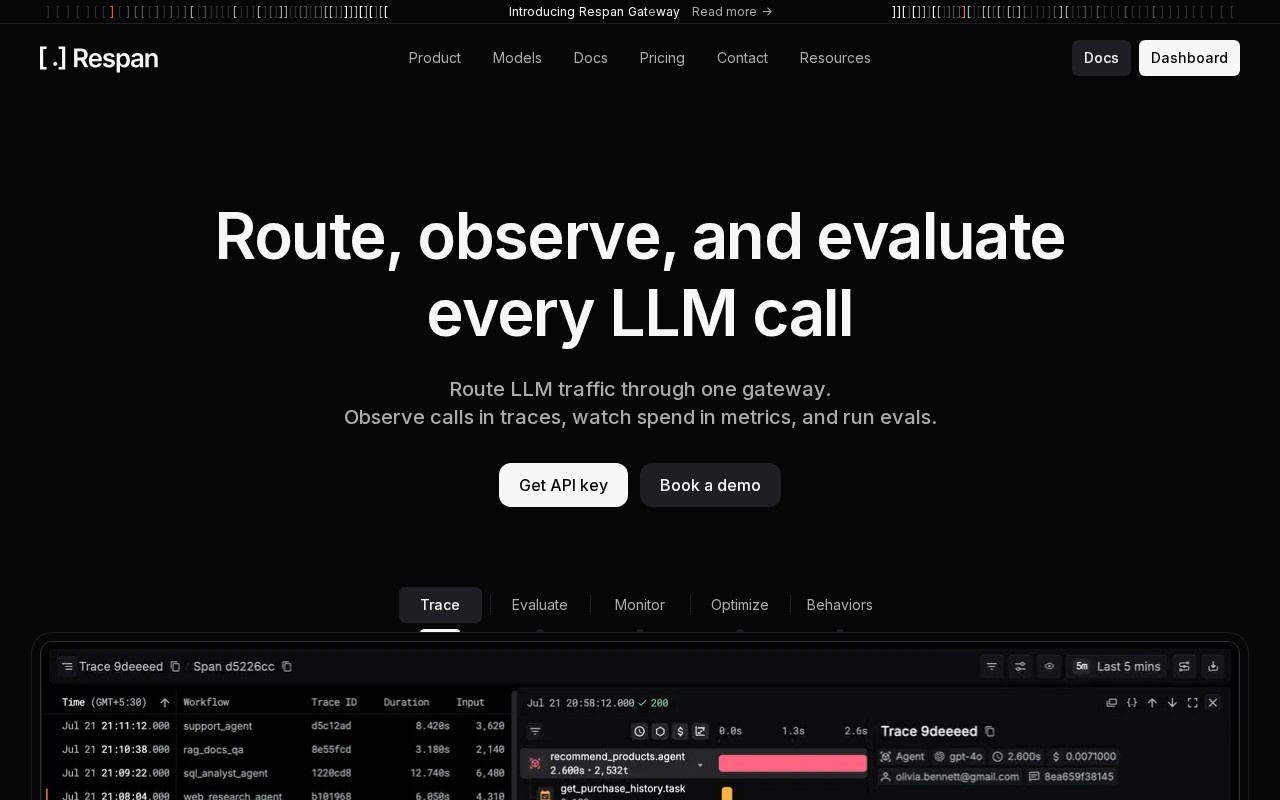
Respan是面向AI开发团队的统一大语言模型工程平台,提供从模型调用到效果优化的全链路工具支撑。平台核心功能包含AI网关路由、模型可观测性监控、大语言模型输出评估、自动提示词优化等服务,帮助开发团队降低大语言模型应用的工程落地复杂度。该平台面向AI应用开发工程师、产品研究团队、企业AI项目组等用户,适用于大语言模型应用开发调试、线上运行问题排查、提示词效果迭代、多模型统一管理等开发场景。
gorilla.cs.berkeley.edu
Berkeley Function-Calling Leaderboard是由加州大学伯克利分校Gorilla团队开发的大语言模型函数调用能力专业评估平台,核心定位是为AI研发领域提供标准化的函数调用性能基准。平台支持多维度模型性能对比、真实场景测试数据集下载、测试场景自定义配置、动态排名更新、能力维度细分评分五大核心功能,面向大语言模型研发人员、AI工具开发者、学术研究人员、AI产品经理、编程工具使用者、AI教育从业者等群体,可用于模型选型参考、研发效果验证、学术研究基准参考、产品技术选型等场景,帮助相关从业者客观了解不同大模型在工具调用、函数执行场景下的实际表现。

prompttools.readthedocs.io
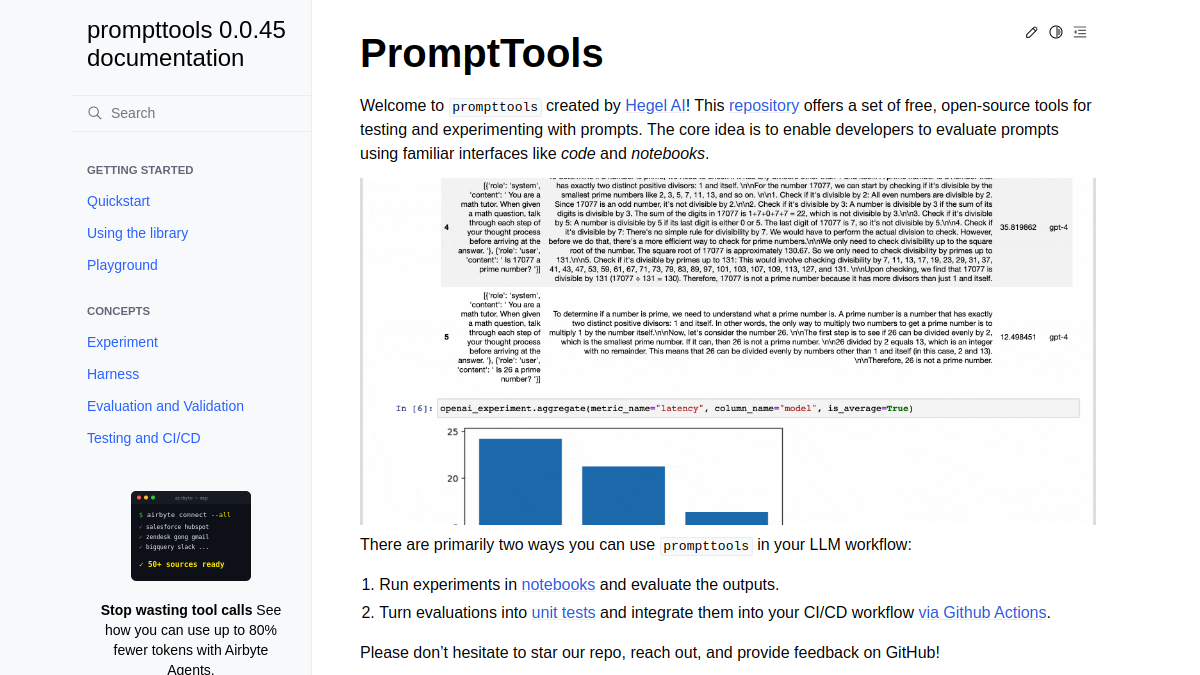
PromptTools是面向大语言模型应用开发者的开源提示词测试与评估工具集,核心定位为帮助开发者在本地环境完成提示词效果验证、模型输出质量评估、测试用例自动化落地。核心功能包括多框架提示词批量对比测试、可自定义的输出质量评估规则、CI/CD工作流原生集成能力,支持开发者在Jupyter Notebook、Python脚本等熟悉的开发界面中完成全流程测试,适用于大模型应用开发阶段的提示词调优、多模型选型、上线前质量校验等场景,有效降低大模型输出不稳定带来的应用风险。

athina.ai
Athina AI是专注于LLM全生命周期运维的观测与评估平台,核心面向生产环境下大语言模型应用的开发与运维人员,提供幻觉检测、性能诊断、自定义评估三大核心能力。平台可对接多种主流LLM接口,帮助用户实时监控生产环境中模型的输出合规性,快速定位异常输出的根因,同时支持多维度对比不同模型的运行表现,适配对话机器人、内容生成、智能客服、RAG检索增强生成等多种LLM落地场景,帮助团队降低模型运维成本,提升LLM应用的落地稳定性。