
AI 工具目录
全站 27,549 款收录工具,按分类浏览,支持定价模式、开源与国内可达性筛选。
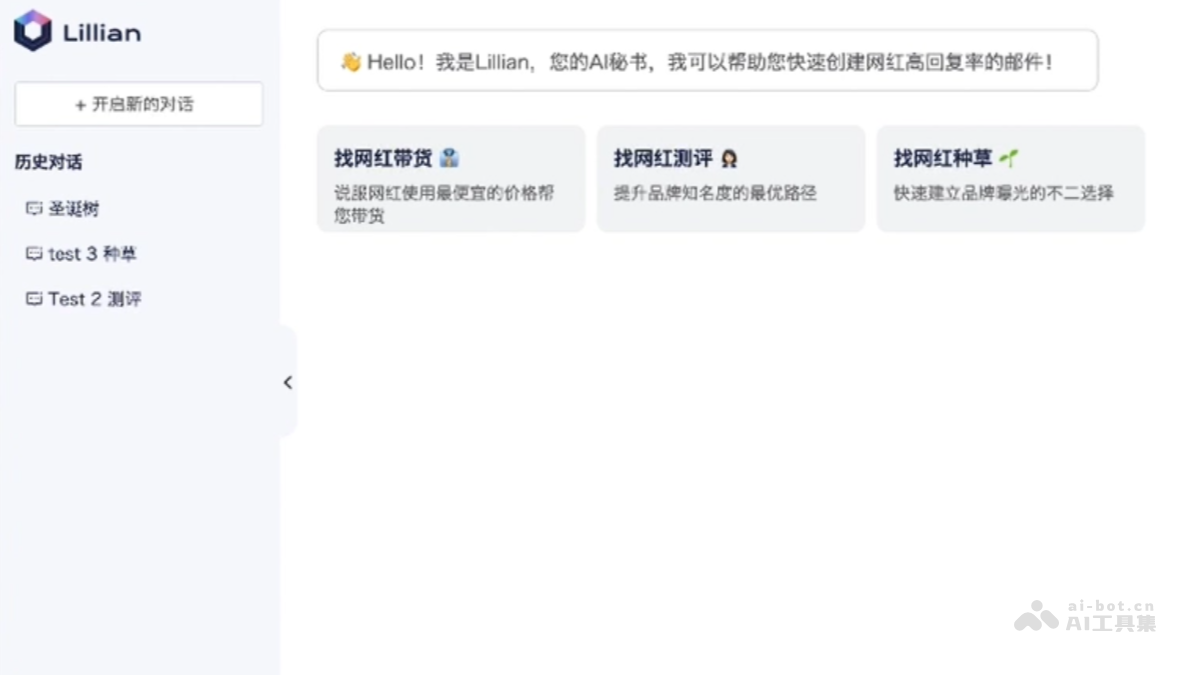
Lillian是Scrumball团队推出的AI网红营销助手,基于AI技术为品牌提供高效、精准的网红合作解决方案。Lillian能在短时间内完成网红发现、分析与管理,解决传统网红营销效率低、决策盲目和投资回报不明等问题。
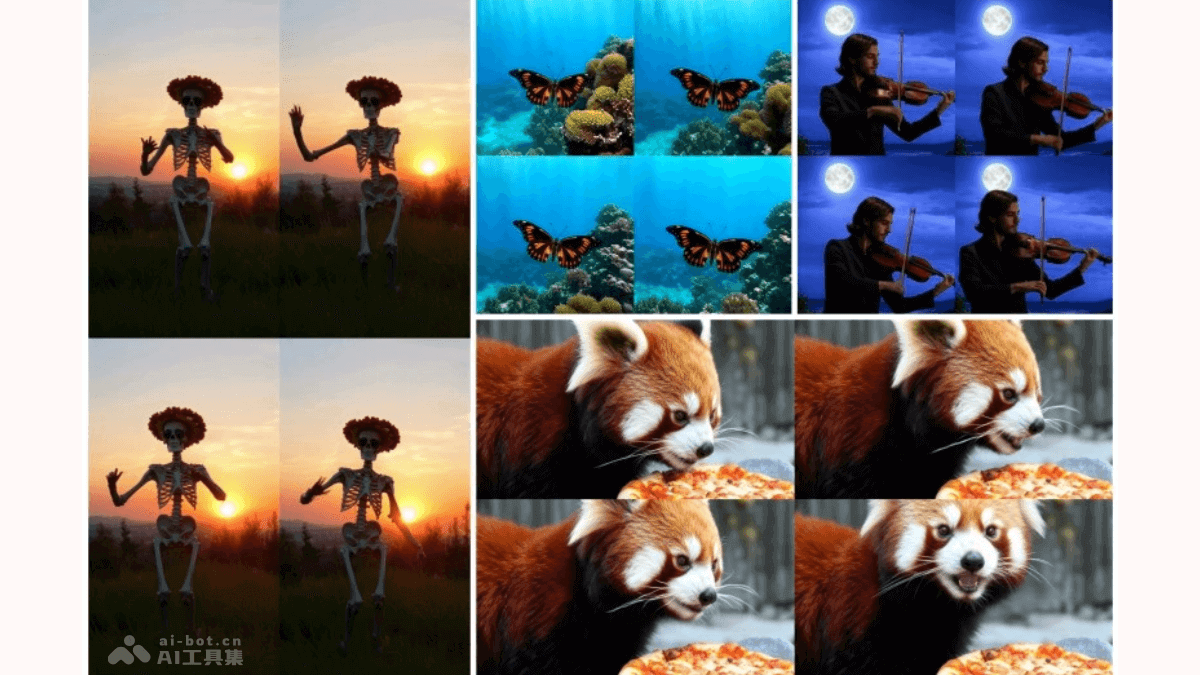
ContentV是字节跳动开源的80亿参数文生视频模型框架。将Stable Diffusion 3.5 Large的2D-VAE替换为3D-VAE并引入3D位置编码,使图像模型快速获得视频生成能力。
MultiTalk 是中山大学深圳校区、美团和香港科技大学联合推出的新型音频驱动多人对话视频生成框架。框架根据多声道音频输入、参考图像和文本提示,生成包含人物互动且口型与音频一致的视频。
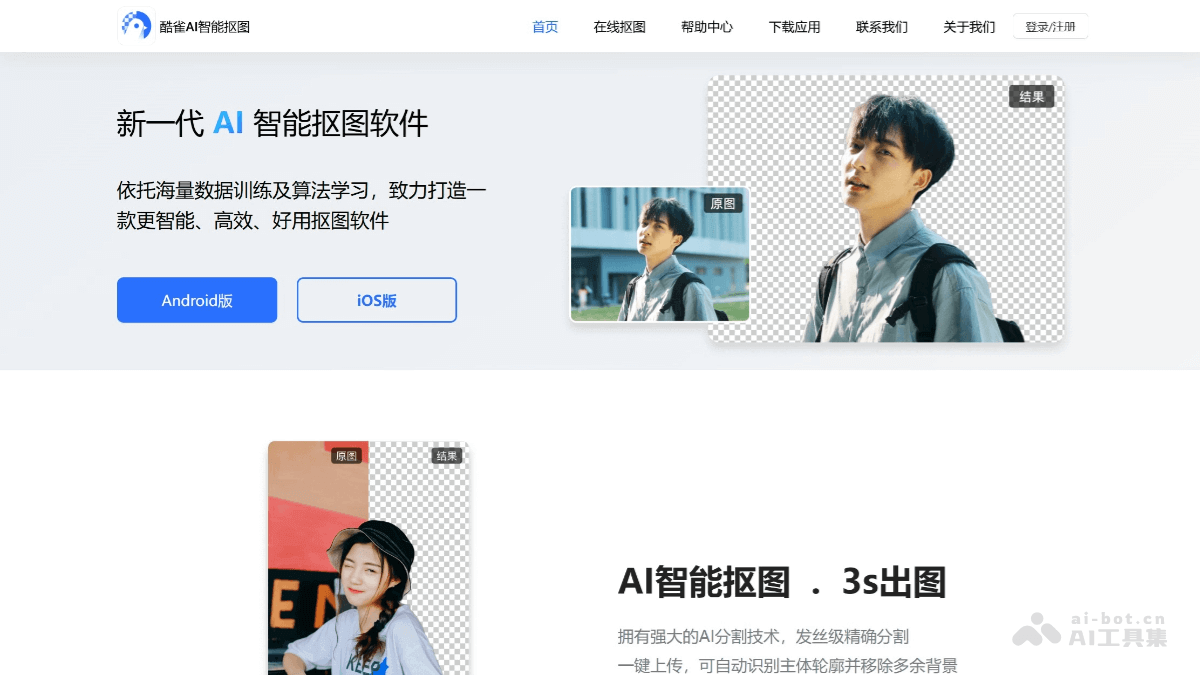
酷雀AI智能抠图是高效便捷的AI图片处理工具。基于先进的AI技术,能快速精准地识别图片中的主体自动去除背景,实现精细化抠图。支持人像、物品或者复杂场景,保留细节如发丝等。
MoonCast 是零样本AI播客生成项目,从纯文本源合成自然的播客风格语音。通过长上下文语言模型和大规模语音数据训练,能生成几分钟长的播客音频,支持中文和英文。
OpenAudio S1是Fish Audio推出的文本转语音(TTS)模型,基于超过200万小时的音频数据训练,支持13种语言。采用双自回归(Dual-AR)架构和强化学习与人类反馈(RLHF)技术,生成的声音高度自然、流畅,几乎与人类配音无异。
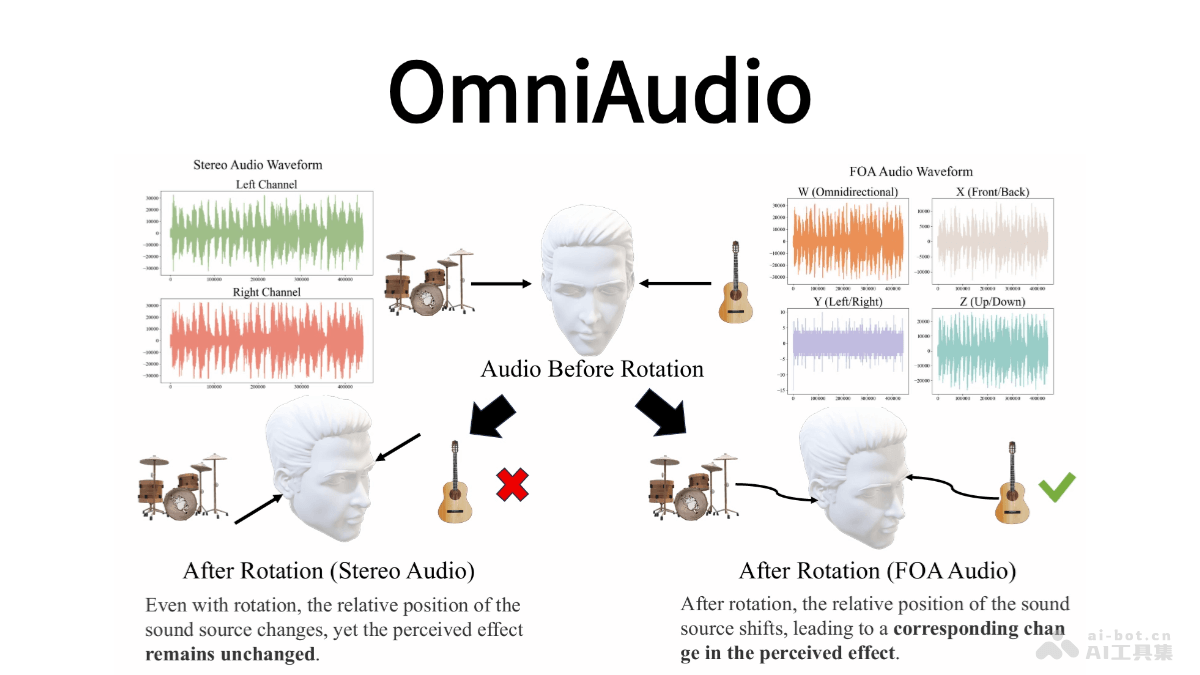
OmniAudio 是阿里巴巴通义实验室语音团队推出的从360°视频生成空间音频(FOA)的技术。为虚拟现实和沉浸式娱乐提供更真实的音频体验。通过构建大规模数据集Sphere360,包含超过10.3万个视频片段,涵盖288种音频事件,总时长288小时,为模型训练提供了丰富资源。
Mobvoi MCP Server 是出门问问推出的一站式集成各项 AI 能力的工具,Mobvoi MCP Server集成语音生成、声音克隆、图片驱动数字人、视频配音等多项多模态 AI 能力。用户只需简单输入文本,能灵活调用功能。
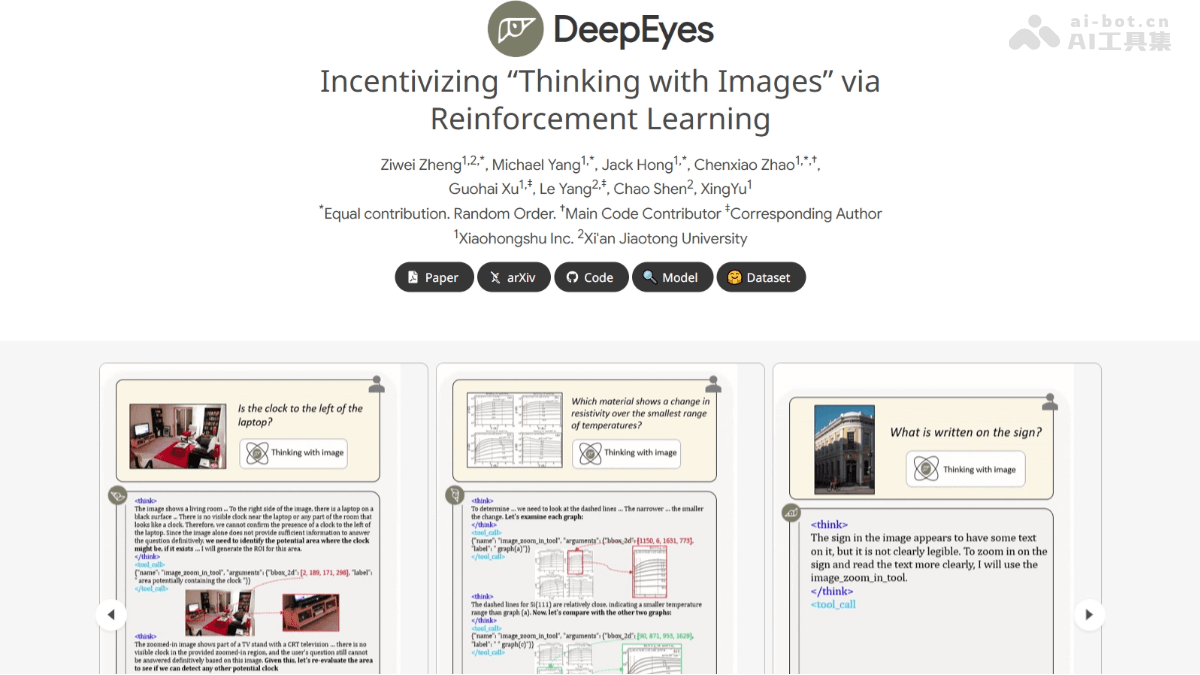
DeepEyes 是小红书团队和西安交通大学联合推出的多模态深度思考模型。基于端到端强化学习,实现类似 OpenAI o3 的“用图思考”能力,无需依赖监督微调(SFT)。DeepEyes 在推理过程中动态调用图像工具,如裁剪和缩放,增强对细节的感知与理解。
Olovka AI 是专为学生设计的AI学习辅助平台,帮助学生更高效地撰写学术论文提升学习效果。核心功能包括AI写作辅助、智能写作建议、互动式学习以及实时聊天与研究辅助。
EVI 3是Hume AI推出的全新语音语言模型,模型能同时处理文本和语音标记,实现自然、富有表现力的语音交互。模型支持高度个性化,根据用户提示生成任何声音和个性,实时调节情感和说话风格。
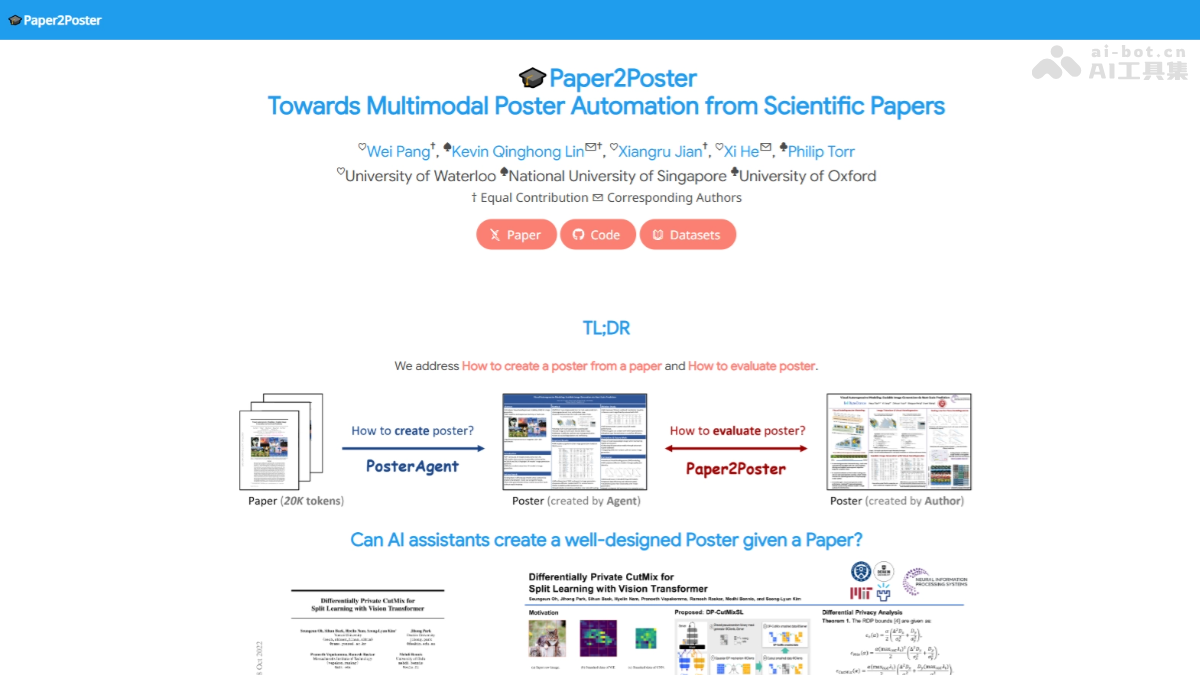
Paper2Poster是加拿大滑铁卢大学、新加坡国立大学等机构推出的创新学术框架,基于多模态自动化技术从科学论文生成海报。Paper2Poster推出PosterAgent,一个自顶向下的多智能体系统,支持将长篇论文内容压缩转化为结构化的视觉海报。
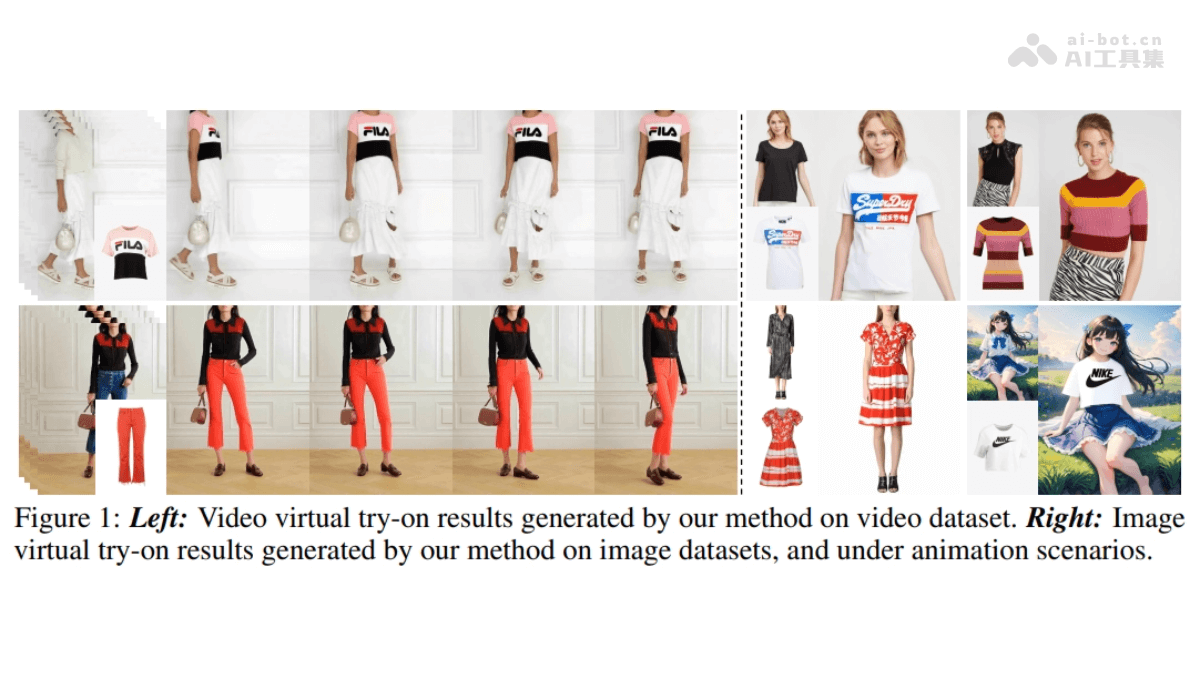
MagicTryOn是浙江大学计算机科学与技术学院、vivo移动通信等机构推出的基于视频扩散Transformer的视频虚拟试穿框架。框架替换传统的U-Net架构为更具表现力的扩散Transformer(DiT),结合全自注意力机制,实现视频的时空一致性建模。
DeepLearning.AI平台上推出“MCP: Build Rich-Context AI Apps with Anthropic”的在线课程。课程由Anthropic和DeepLearning.AI合作开发,Elie Schoppik讲授,属于中级水平,总时长为1小时38分钟,包含11个视频课程和7个代码示例。
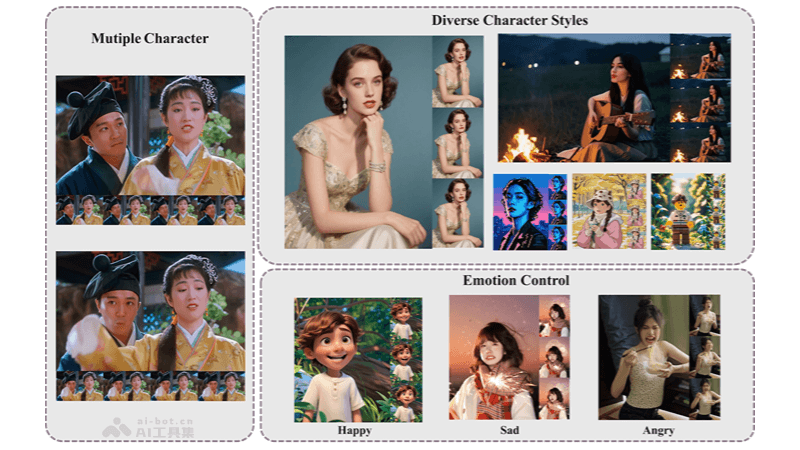
HunyuanVideo-Avatar是腾讯混元团队与腾讯音乐天琴实验室联合研发的语音数字人模型,基于多模态扩散Transformer架构,能生成动态、情感可控以及多角色对话视频。模型具有角色图像注入模块,可消除训练与推理间的条件不匹配,确保角色一致性。
Unmute 是 Kyutai 推出的低延迟语音交互系统,专注于低延迟语音转文字(Speech-to-Text)和文字转语音(Text-to-Speech)。Unmute 基于先进的 AI 模型,为用户提供实时、高效的语音交互体验。
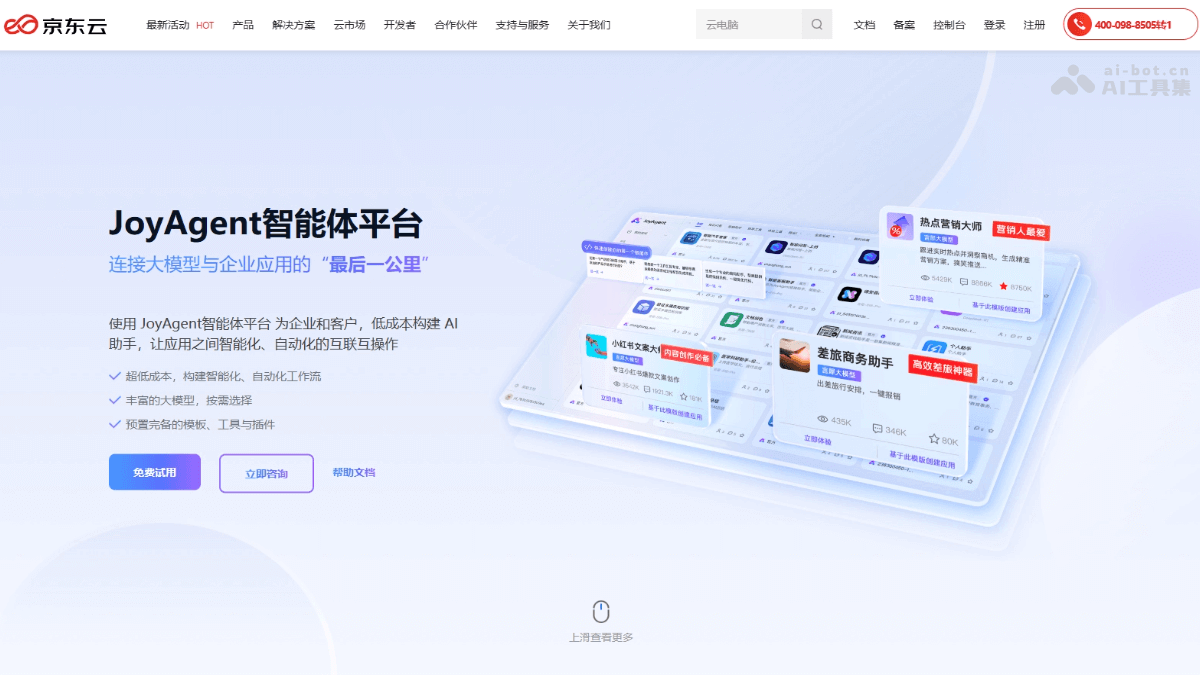
JoyAgent智能体平台是京东云推出的企业级一站式AI智能体搭建与发布平台。平台聚合大模型、知识库、插件和工作流等能力,支持低代码开发,用户无需复杂编程用自然语言快速构建基于大语言模型(LLM)的AI智能体。
Largo是基于AI技术加速影视内容开发的创新平台。平台分析海量影视数据(包括超过40万部电影和电视剧、95万名演员、5.9万个剧本等),为影视制作提供数据驱动的洞察和决策支持。
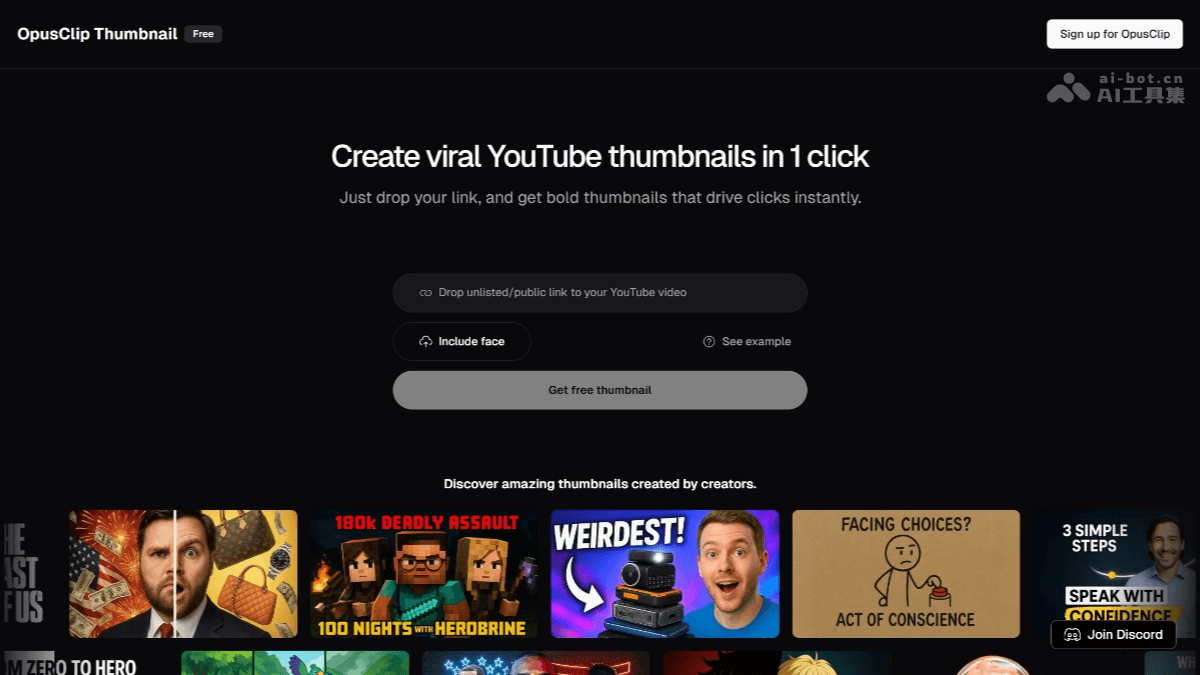
OpusClip Thumbnail 是 OpusClip 团队推出的免费的 AI 缩略图生成工具,专为 YouTube 创作者设计,用于快速生成视频缩略图。用户只需粘贴视频链接,AI 会自动分析内容并生成多个高表现力的缩略图选项。
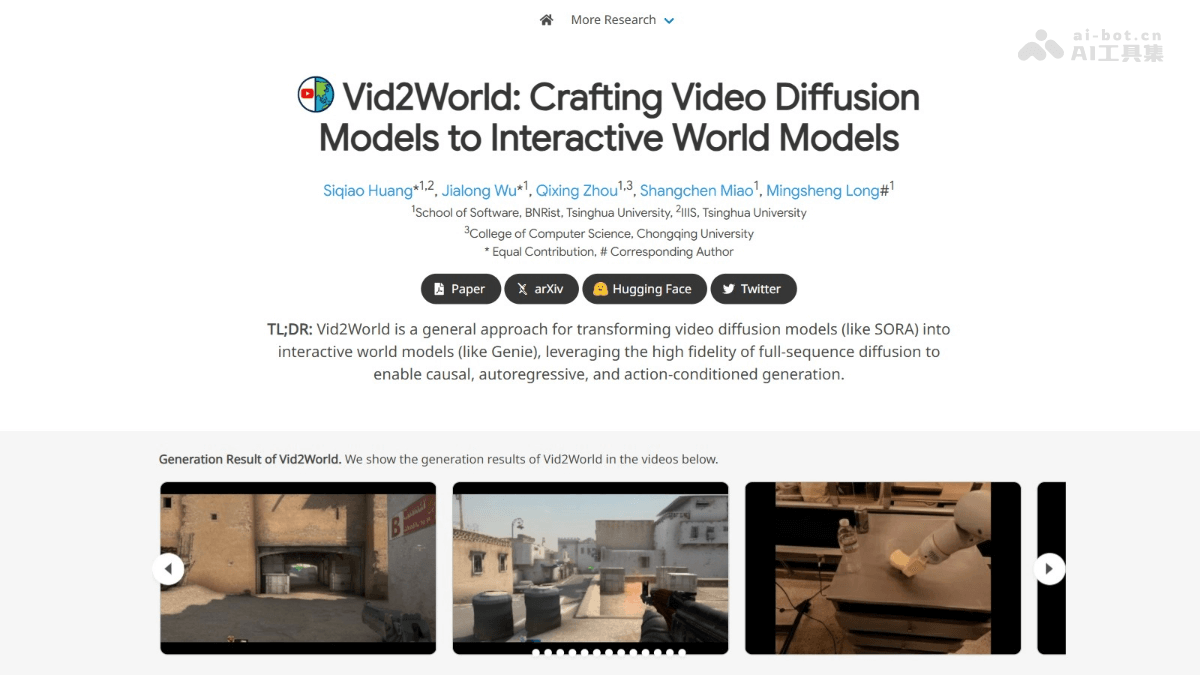
Vid2World是清华大学联合重庆大学推出的创新框架,支持将全序列、非因果的被动视频扩散模型(VDM)转换为自回归、交互式、动作条件化的世界模型。模型基于视频扩散因果化和因果动作引导两大核心技术,解决传统VDM在因果生成和动作条件化方面的不足。
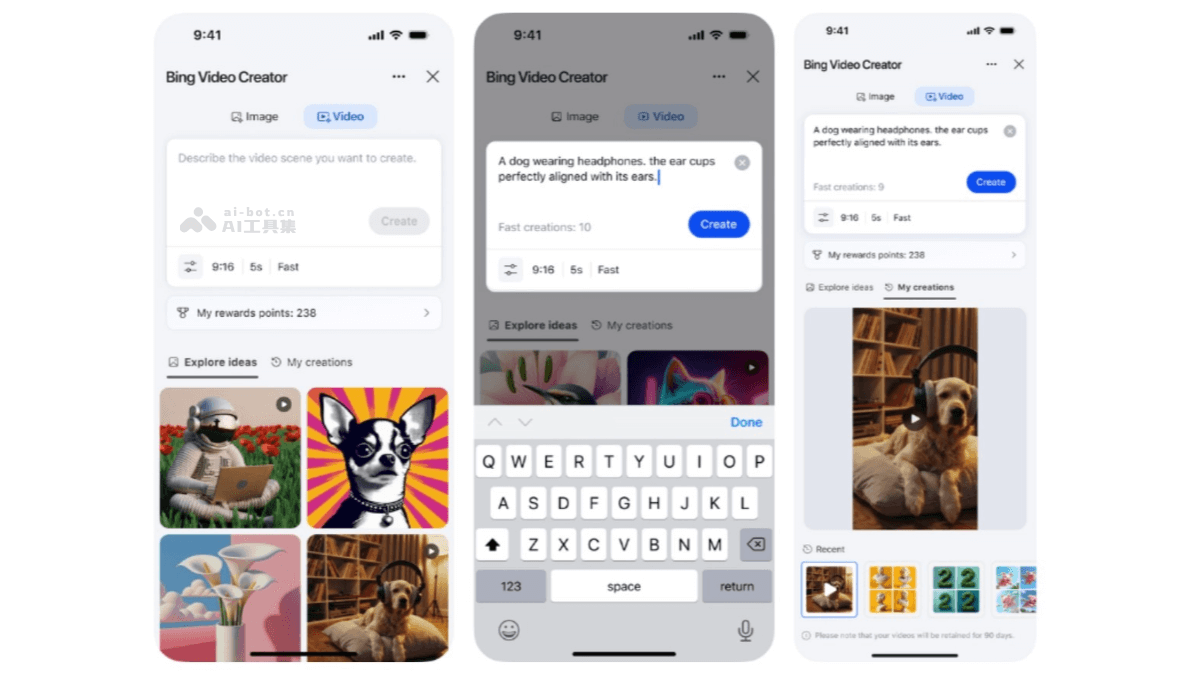
Bing Video Creator 是微软推出AI视频生成工具。由OpenAI的Sora模型提供支持,能根据用户输入的文本描述快速生成视频内容。用户只需在Bing移动应用中输入详细的场景描述,包括主体、动作、环境等信息,系统会在短时间内生成对应的视频。
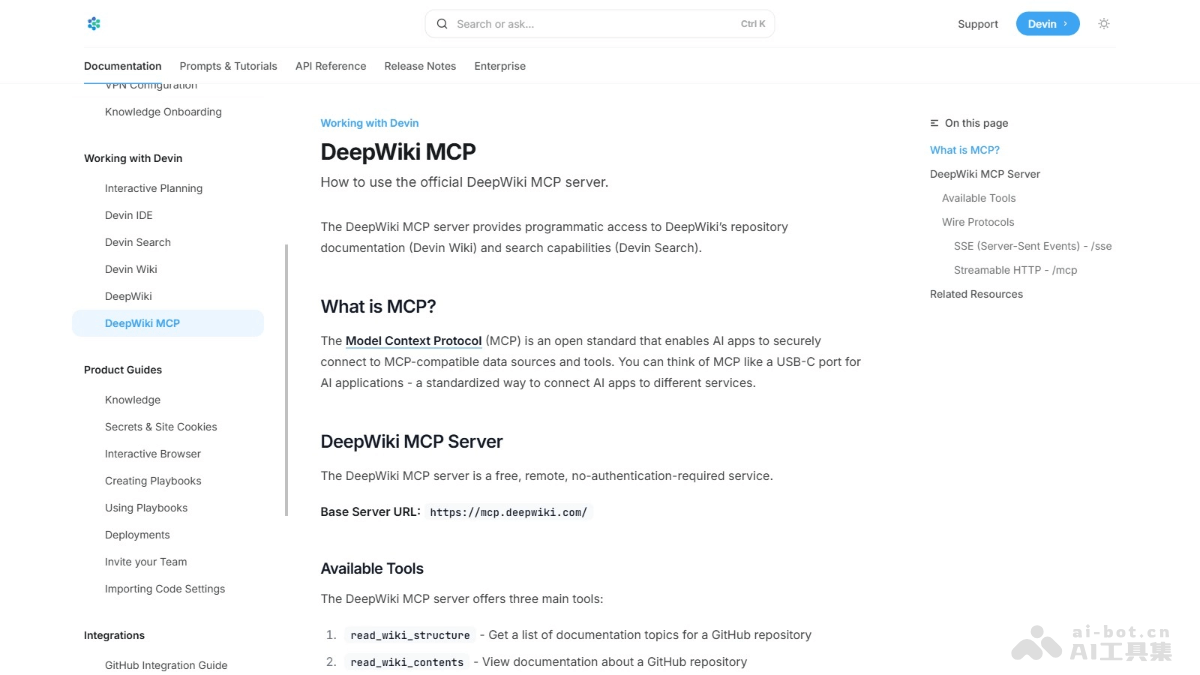
DeepWiki MCP 是Cognition Labs推出的远程服务器,基于开放标准的 Model Context Protocol(MCP)。DeepWiki MCP为 AI 应用提供访问和搜索 GitHub 代码库文档的能力。
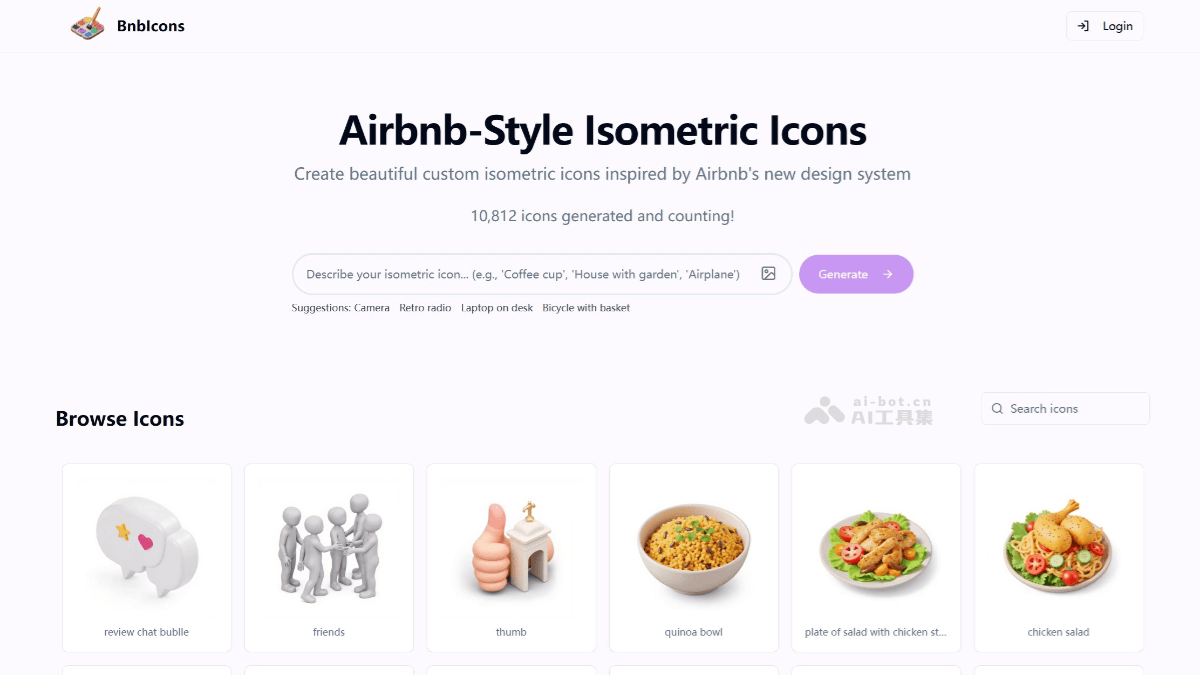
BnbIcons是AI驱动的图标生成工具,能创建类似Airbnb风格的等轴测图标。用户只需输入文字描述或上传参考图片,AI能生成符合要求的图标。提供464+个预制图标,涵盖多种类别和风格,可快速找到所需图标。
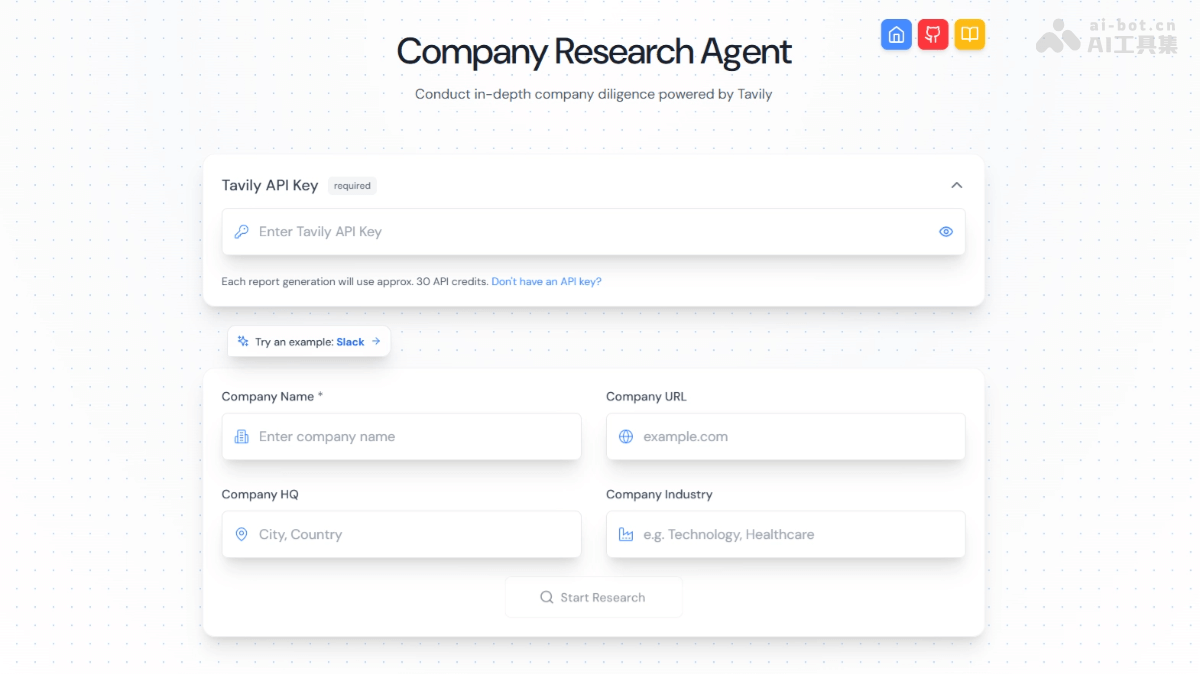
Company Research Agent是基于多智能体框架的公司研究工具,支持一键自动生成全面的公司研究报告。工具从公司网站、新闻文章、财务报告和行业分析等多源数据中收集信息,基于Gemini 2.0 Flash和GPT-4.1-mini等模型进行高语境研究综合及精确的报告格式化和编辑。
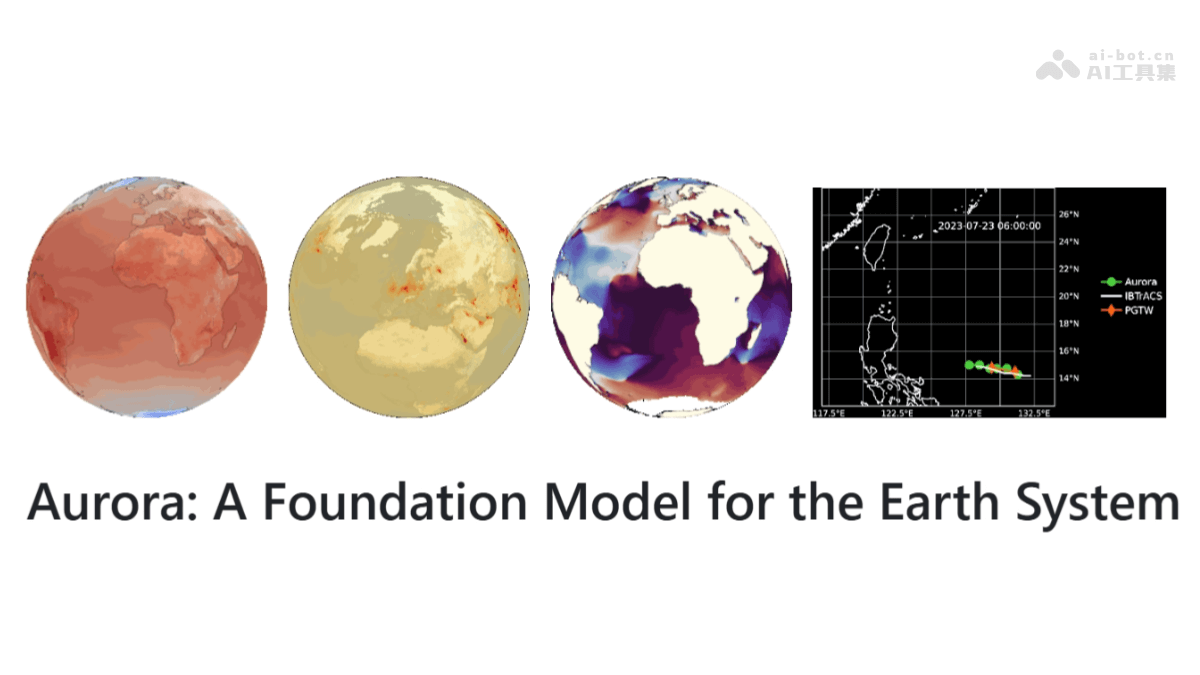
Aurora是微软研究院推出的13亿参数的大气基础模型,基于从海量大气数据中提取有价值信息,用在预测全球天气模式、空气污染和海洋波浪等大气过程。模型用预训练和微调的架构,处理不同分辨率和压力水平的数据。
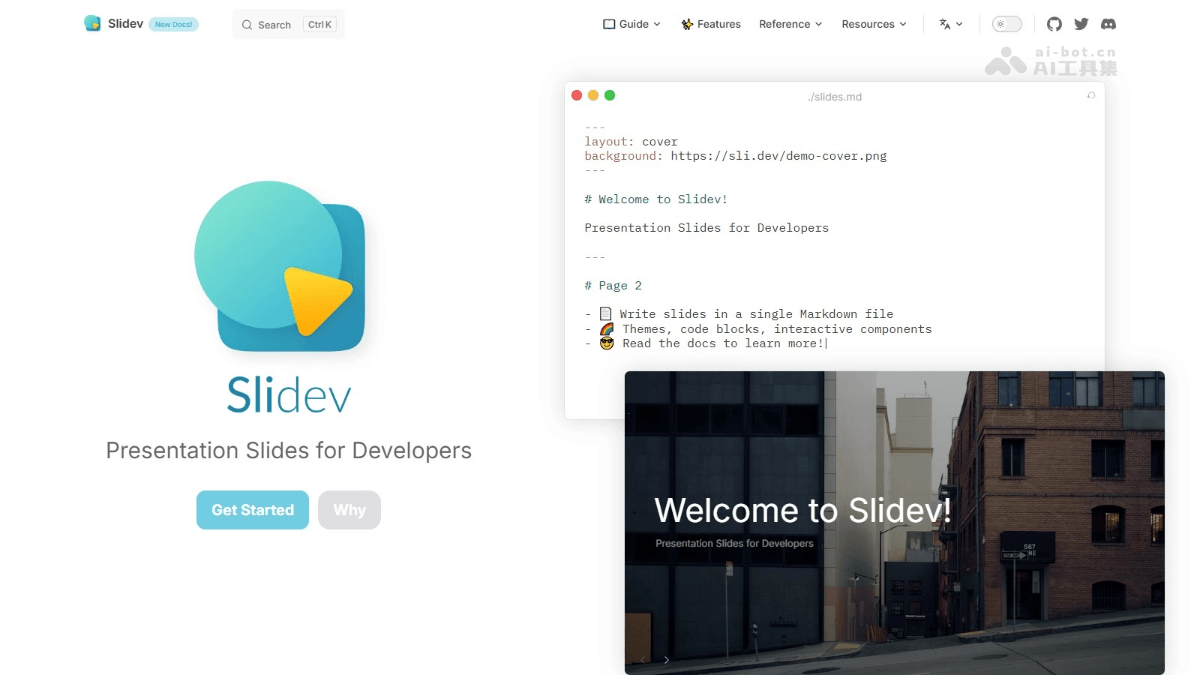
Slidev 是开源的幻灯片制作工具,基于 Markdown + Vue 技术栈实现。工具支持用简单的 Markdown 语法创建幻灯片,支持代码高亮、实时编码演示、数学公式渲染、图表生成等功能,提供丰富的主题和样式选项。
RelightVid是上海 AI Lab、复旦大学、上海交通大学、浙江大学、斯坦福大学和香港中文大学推出用在视频重照明的时序一致性扩散模型,支持根据文本提示、背景视频或HDR环境贴图对输入视频进行细粒度和一致的场景编辑,支持全场景重照明和前景保留重照明。
DMind是DMind研究机构发布的专为Web3领域优化的大型语言模型。针对区块链、去中心化金融和智能合约等场景深度优化,使用Web3数据微调采用RLHF技术对齐。
Gemma 3n 是谷歌 I/O 开发者大会推出的端侧多模态 AI 模型。基于 Gemini Nano 架构,采用逐层嵌入技术,将内存占用压缩至 2-4B 参数模型水平。模型参数量分别为 5B 和 8B,内存占用仅相当于 2B 和 4B 模型。
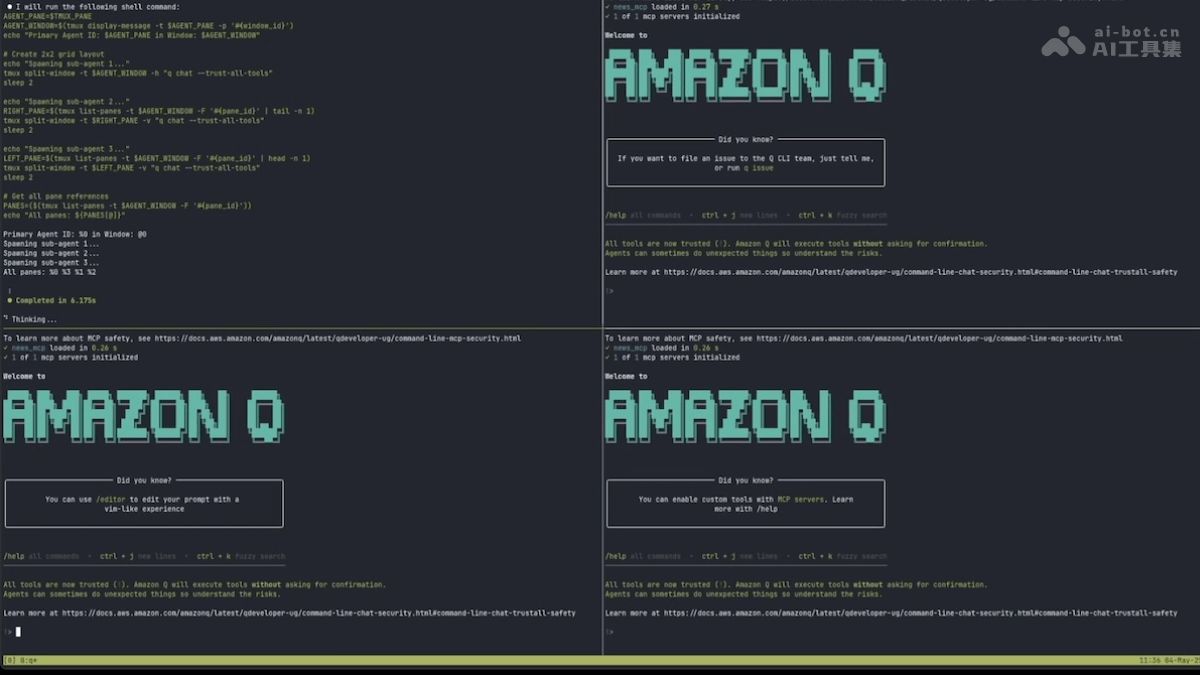
News Agents基于终端的新闻聚合与摘要系统。基于Amazon Q CLI作为 Agent 框架,用Model Context Protocol (MCP)解析RSS新闻源,借助tmux实现终端分割和多任务监控。
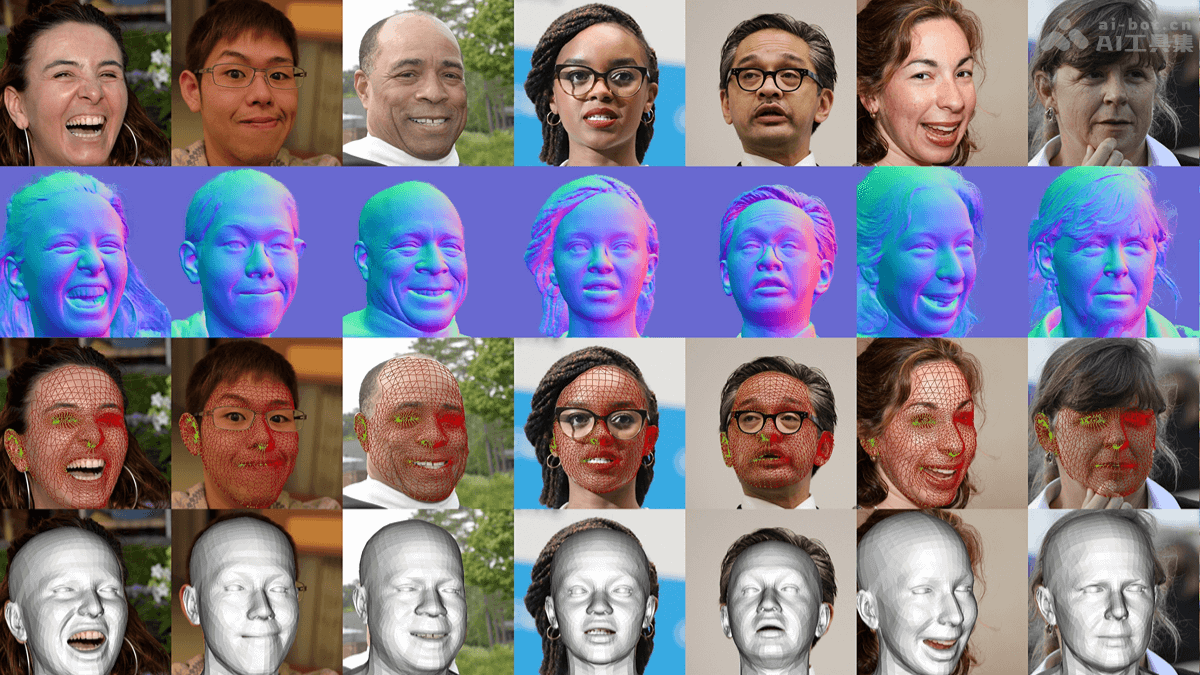
Pixel3DMM是慕尼黑工业大学、伦敦大学学院和Synthesia联合推出的单图像3D人脸重建框架。框架基于DINO基础模型,引入专门的预测头,从单张RGB图像中准确重建出3D人脸的几何结构。
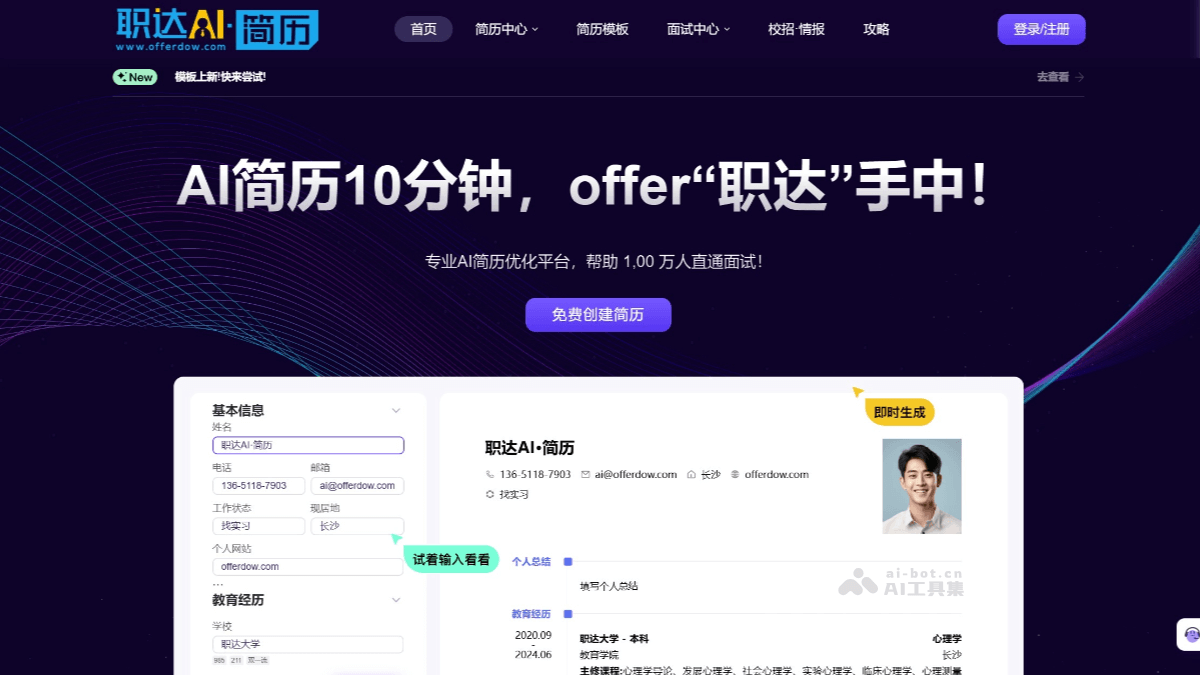
职达AI简历是高效便捷的智能简历优化平台。通过AI技术,为用户提供从简历生成到优化的全方位服务。用户只需输入基本信息和经历,平台能在短时间内生成专业个性化的简历。
Steamer-I2V 是百度 Steamer 团队推出的图像到视频生成模型,通过将静态图像转化为动态视频,展现出卓越的视觉生成能力。模型在 VBench 国际权威的视频生成评测中荣获榜首,精准的视觉控制、高清画质以及对中文语义的深刻理解脱颖而出。
Graphiti 是为动态环境设计的 AI 知识图谱生成框架,为 AI 智能体构建能查询、具有时间感知能力的知识网络。Graphiti 能实时摄取和处理结构化与非结构化数据,支持动态数据整合、状态推理与自动化,及混合检索。
Windows AI Foundry 是微软推出的全新的 AI 开发平台。Windows AI Foundry 基于整合 Windows Copilot Runtime 及新增功能,为 AI 开发者提供从模型选择、优化、微调到部署的全生命周期支持。
Bebop 是AI销售工具,专为中小企业设计,帮助用户快速找到潜在客户并提升销售效率。用户只需输入公司网站地址,Bebop 能在短时间内扫描市场,生成潜在客户名单,提供详细的情报分析,包括公司概况、决策者信息和市场定位等。
CrowdCore是AI驱动的网红营销助手,帮助品牌和营销团队高效地发现、筛选与全球各类社交平台上的网红建立合作关系。核心功能包括AI网红搜索与筛选、自动化外联与沟通、数据分析与效果追踪等。
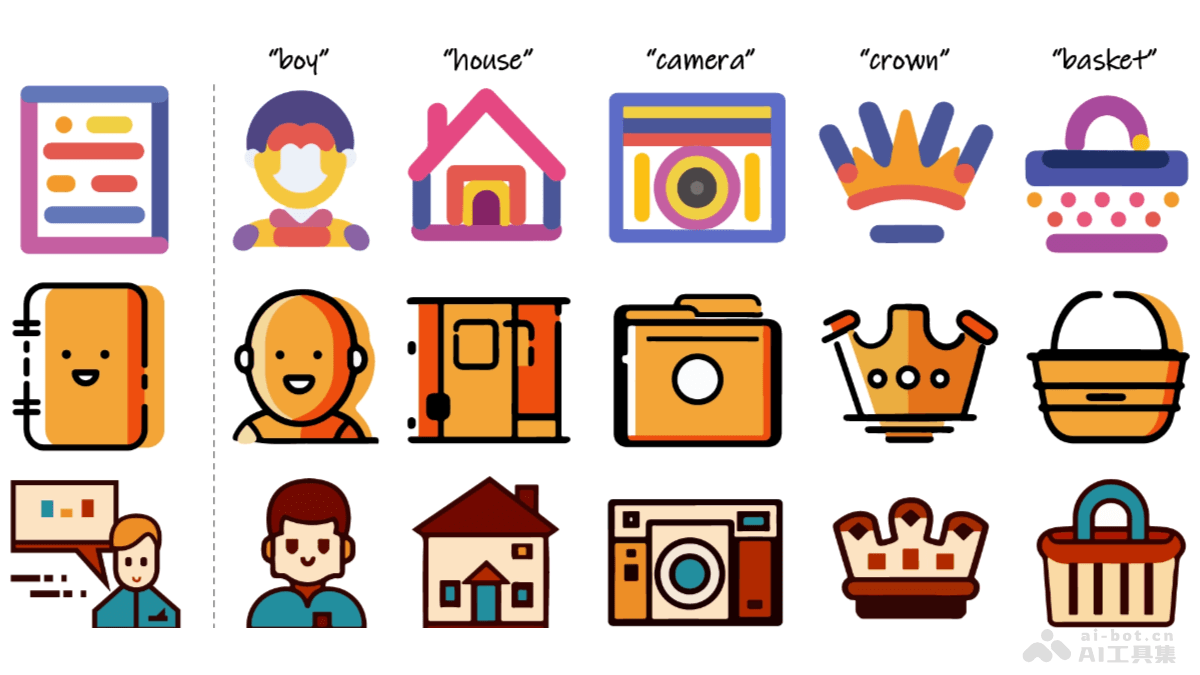
Custom-SVG 是Adobe和香港城市大学推出的两阶段风格的SVG定制生成框架,基于文本提示生成具有定制风格的高质量 SVG 图形。框架推出一种两阶段的生成流程,基于路径级表示的扩散模型学习 SVG 的结构和内容,从定制化的文本到图像(T2I)模型中提取风格信息,实现多样化的风格定制。
Skild Brain 是 Skild AI 推出的具身智能基础模型,成为多种机器人和任务的共享通用大脑。能适应不同的硬件和任务,具有强大的泛化能力。可以集成到任何类型的机器人中,能在复杂的环境中执行多种任务,如物体操纵、导航和视觉检查。
鱼鳞智慧脑图是AI思维导图工具。能将长文本、网页链接、PDF或Word文件中的信息快速转化为清晰的思维导图,提取关键内容并自动构建节点层级,节省手动整理时间。用户只需输入主题或相关内容,AI可智能生成结构化导图,助力高效思考与创意发散。
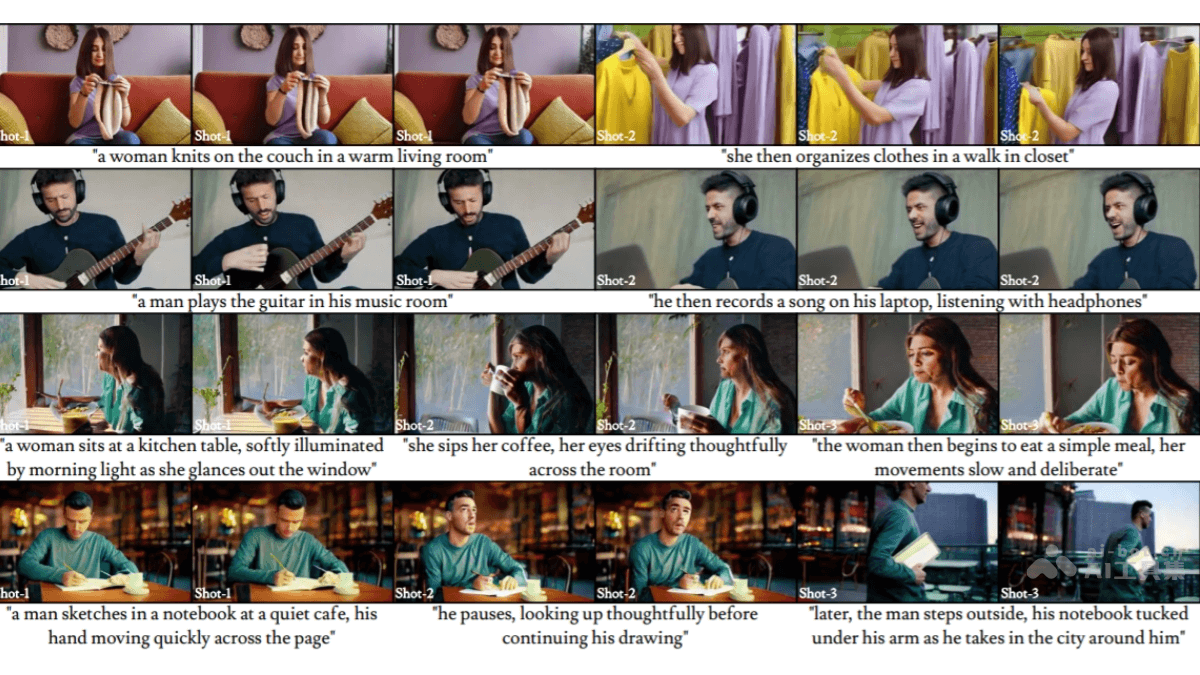
ShotAdapter是Adobe联合UIUC推出的用在文本到多镜头视频生成的框架,基于微调预训练的文本到视频模型,引入过渡标记和局部注意力掩码策略,实现对多镜头视频的生成。框架能确保角色在不同镜头中的身份一致性,支持用户用特定的文本提示控制镜头的数量、时长和内容。
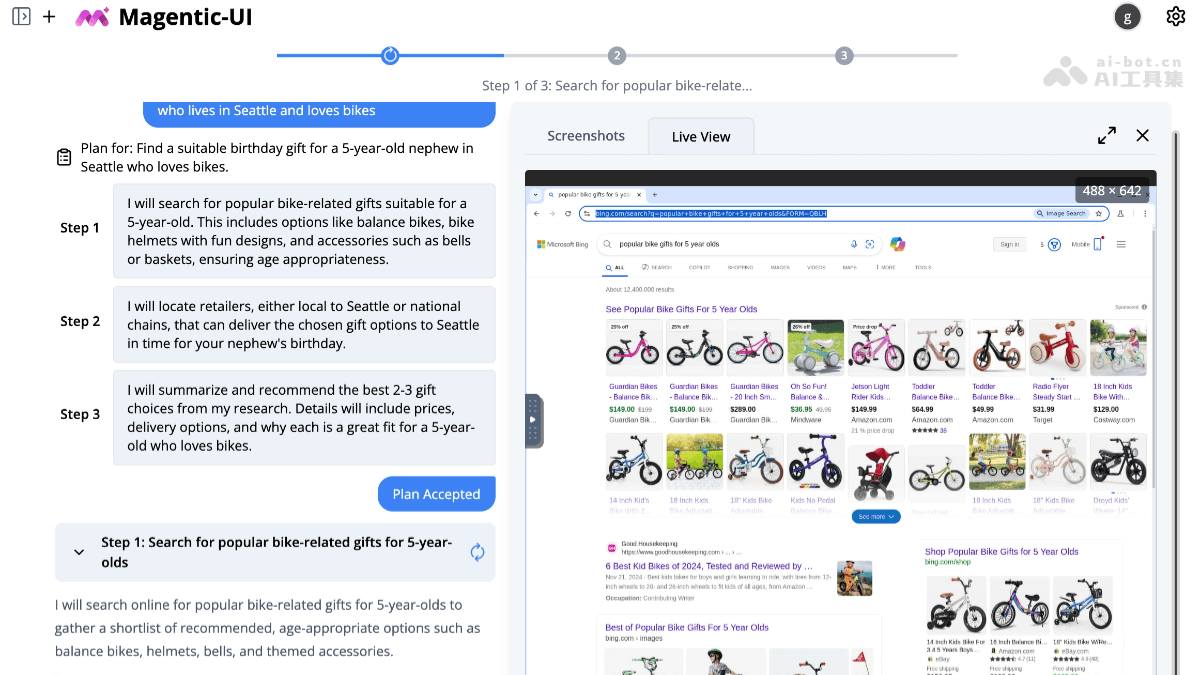
Magentic-UI 是微软推出的开源研究原型,用在探索人类参与的 AI Agent系统。Magentic-UI 是以人为中心的AI Agent,能与用户协作完成复杂的 Web 任务,如浏览网页、执行代码和处理文件。
OpenMemory MCP 是mem0推出的基于开放模型上下文协议(MCP)构建的开源工具,能解决 AI 工具记忆痛点,实现不同工具间共享上下文信息。OpenMemory MCP支持 100% 本地运行,数据存储在用户本地设备上,确保隐私和安全。
Pemo是AI驱动的文档管理工具。工具支持PDF、Epub、Word等多种格式文档的导入与管理,具备一键翻译、智能总结、思维导图生成等功能,帮助用户快速理解复杂文献,提升阅读效率。Pemo提供沉浸式阅读体验,用户自定义阅读模式、进行标注和笔记,方便记录灵感。
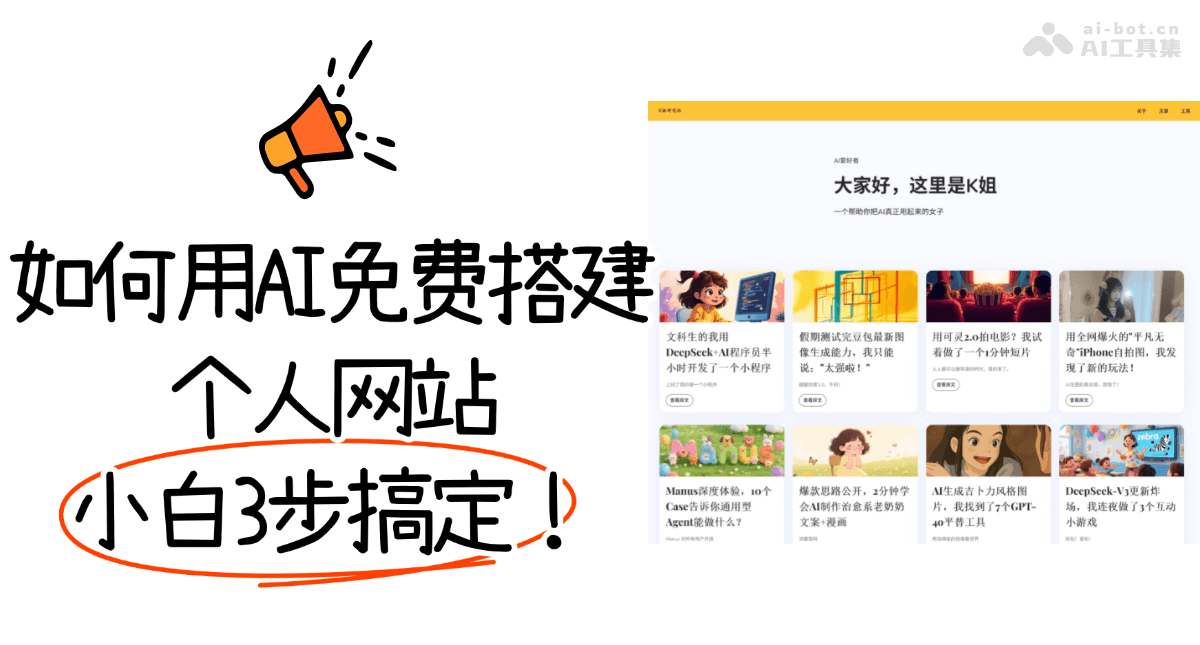
最近总是刷到一些超厉害的操作:像一句话生成诗朗诵网页、10分钟创建3D网页游戏、全自动整理电脑文件等等,看得我特别心动。这几天终于摸索出一些方法。 原来这些高效开发项目,都是通过AI来实现的。全程一行代码都不用写,我也成功上线了自己的个人站:
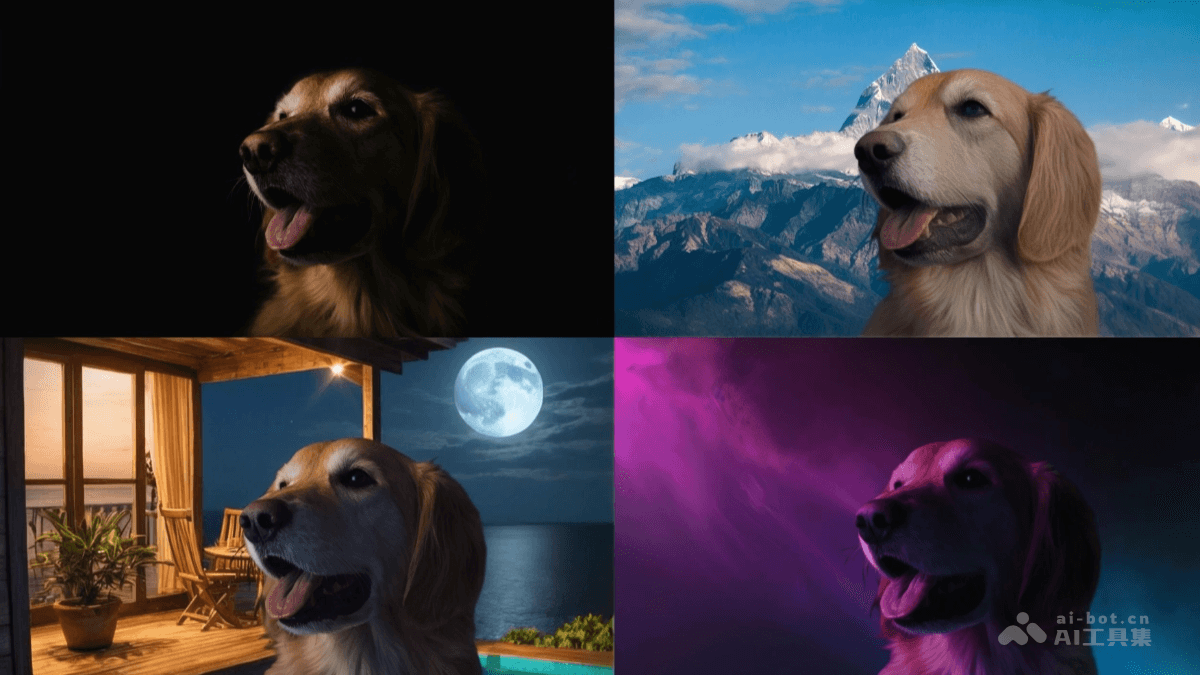
LBM(Latent Bridge Matching)是Jasper Research团队推出的新型图像到图像转换框架,基于在潜在空间中构建桥匹配实现快速高效的图像转换。LBM仅需单步推理完成任务,适用多种图像转换场景,如目标移除、重打光、深度和法线估计等。
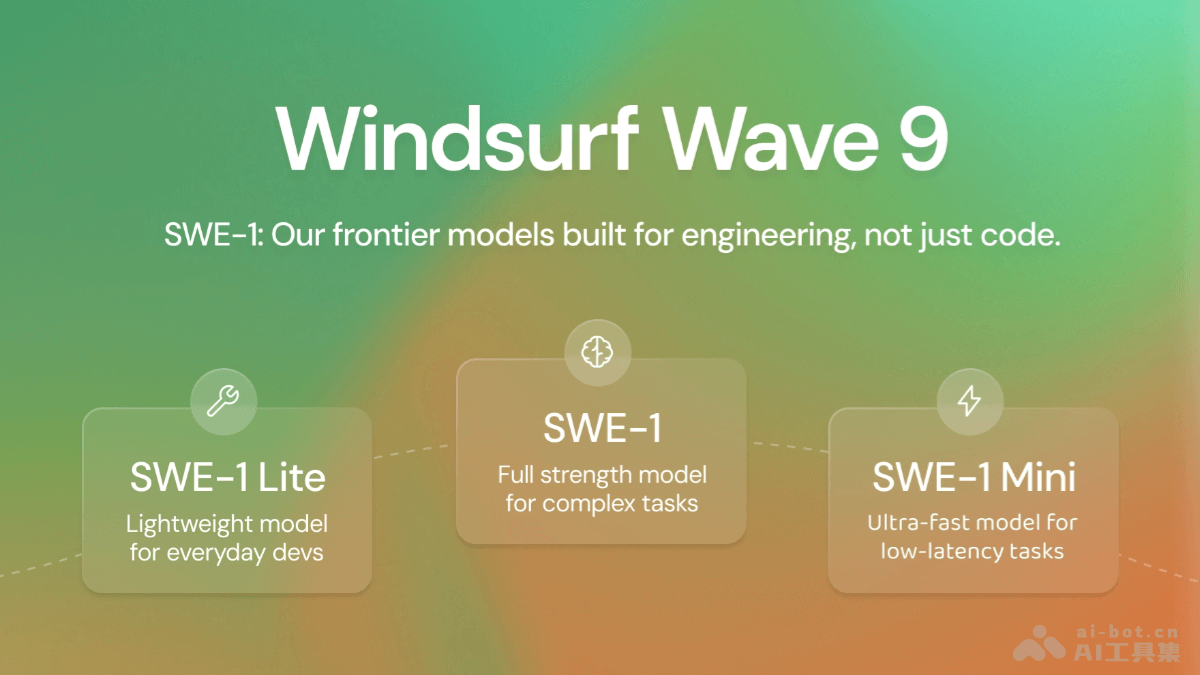
SWE-1是Windsurf团队推出的首个软件工程 AI 模型系列,专为整个软件开发流程优化,涵盖代码生成、测试、调试、资料查找等开发环节,提升开发效率和用户体验。
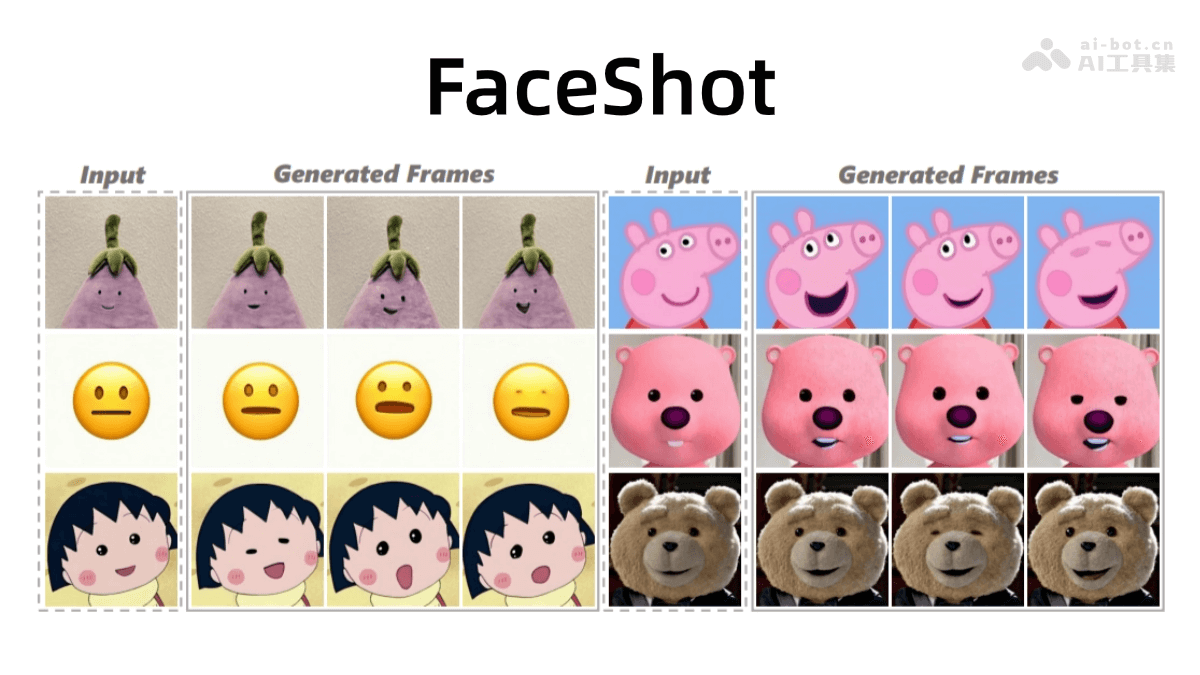
FaceShot是同济大学、上海 AI Lab和南京理工大学推出的新型无需训练的肖像动画生成框架。用外观引导的地标匹配模块和基于坐标的地标重定位模块,为各种角色生成精确且鲁棒的地标序列,基于潜在扩散模型的语义对应关系,跨越广泛的角色类型生成面部动作序列。